快速导读:提出V-REX,一种从零训练小型专家VLM的完整方案,通过专家级tokenisation、生成式预训练和图像自由引导(IFG),在兽医放射报告生成任务上以远小于通用基础模型的参数量超越其性能。
V-REX提出一个反直觉的命题:在兽医X光报告生成这类专家任务上,从零训练的小型VLM可以超越参数量大六倍的通用微调模型。论文的核心论点是,通用VLM的失败不在于“不够大”,而在于训练范式的错配——tokenisation冗余、预训练特征过于通用、推理时语言先验过强。V-REX通过专家级tokenisation、生成式图像预训练和IFG推理引导,系统性地纠正了这三个错配。
本文的贡献不仅是提出一个新模型,更是提供了一套从零训练专家VLM的完整最佳实践。它证明了在数据规模中等(15M样本)、算力有限(单张H100)的条件下,小型专家模型可以成为通用大模型的可行替代方案。这一结论对医疗影像、工业质检、农业遥感等专业领域具有直接的工程指导意义。
英文题目:V-REX: Efficient Specialist VLM Training for Veterinary X-Rays
论文出处:arXiv 每日论文精选 · arXiv:2608.20069
原始论文:PDF / 论文页面
这篇论文解决什么问题?
通用VLM在专家领域的失败并非偶然。以o3为例,在兽医X光报告生成任务上F1仅为0.2,这意味着它生成的报告与真实诊断的重合度极低。问题首先出在tokenisation上:通用tokeniser是为自然语言设计的,面对“左心室扩大”“肺泡型”“间质性”等专业术语,它倾向于将单词拆分为多个子词token,导致序列冗长、语义碎片化。论文报告,GPT 5.x的tokeniser将平均520字符的文本编码为106个token,而V-REX的专家tokenisation将其压缩至30.8个token。
更深层的问题是推理时的语言先验。通用VLM在预训练阶段接触了大量自然语言文本,形成了强烈的语言模式先验。在专家领域,这种先验反而成为负担:模型倾向于根据常见的报告模板“生成”答案,而不是根据图像内容“推理”答案。论文通过IFG消融实验证实了这一点:不加IFG时F1约0.36,加上IFG后提升至约0.39,说明模型确实存在“看图不充分”的问题。
微调路线的困境同样值得关注。PaliGemma LoRA微调的最高F1仅为0.13,远低于V-REX light的0.39。论文指出,LoRA微调相当于在一个巨大的参数空间中寻找低秩调整,对于专家领域的小数据量而言,这种搜索空间过于庞大,模型难以有效收敛。这解释了为什么“微调大模型”这条看似稳妥的路线在专家领域频频失效。
核心创新
- 从零训练专家VLM的完整最佳实践方案,仅需单张H100和中等规模数据
- 基于二值子空间量化的生成式图像预训练策略,提升数据利用率并降低聚类计算成本两个数量级
- 图像自由引导(IFG)推理技术,借鉴classifier-free guidance思想放大图像信号、抑制语言先验
- 专家级词级+BPE tokenisation,将平均文本长度从106 tokens压缩至30.8 tokens
- 多图像推理无需训练,通过token概率池化即可提升准确率
方法概览
V-REX采用全自回归统一架构:使用RAPTOR(DINO-CLIP混合)编码器提取冻结的图像token,先对量化后的图像token做生成式预训练,再自回归生成文本。文本采用词级+BPE的专家tokenisation(词表32768)。推理时使用IFG放大图像对token概率的贡献,支持多图像池化和Integrated Gradients可解释性。
- V-REX采用全自回归统一架构:图像token和文本token在同一个序列中处理,图像token按行排列在前,文本token在后。这种设计避免了跨模态注意力等复杂机制,使小模型也能高效训练。
- 视觉编码采用RAPTOR,一个基于DINO-CLIP混合对比学习的专有模型。RAPTOR提取的图像token被冻结,不参与梯度更新,V-REX仅通过线性嵌入层将这些token映射到模型空间。论文的图1显示,使用RAPTOR嵌入比使用VetDINO或纯线性嵌入效果显著更好。
- 生成式预训练是V-REX的核心创新之一。在正式文本训练之前,模型先自回归地预测量化后的图像token。这一阶段使用二值子空间量化(Binary Subspace Quantisation),通过投影加符号函数实现高效聚类,将聚类计算成本降低了两个数量级。预训练让模型先建立对图像内容的“理解”,再学习如何用语言描述。
- 专家级tokenisation采用词级加BPE的混合策略,词表大小为32768。专业术语如“cardiomegaly”被作为完整词元处理,而罕见词则通过BPE子词分解。这一策略将平均文本长度从106 tokens压缩至30.8 tokens,大幅降低了小模型的学习负担。
- IFG(Image-Free Guidance)是推理时的关键技术。它借鉴扩散模型中classifier-free guidance的思想,在推理时放大图像对token概率的贡献,抑制语言先验的影响。具体实现上,IFG通过对比“有图像条件”和“无图像条件”下的概率分布,对图像信号进行加权放大。
- 多图像推理无需额外训练。V-REX通过token概率池化实现多图像输入:对多张X光片的token概率进行聚合,提升预测准确率。论文报告多图像池化可将top-1准确率提升最高0.03。
- 可解释性通过Integrated Gradients实现。论文的图3展示了模型在预测“cardiac”时,Integrated Gradients高亮区域集中在心脏位置,证明模型确实在“看”正确的解剖结构。
- 训练采用schedule-free Adam优化器,无需手动调整学习率调度。这一选择简化了训练流程,使从零训练小模型更加实用。
逐图理解论文
失败案例:大模型的尴尬
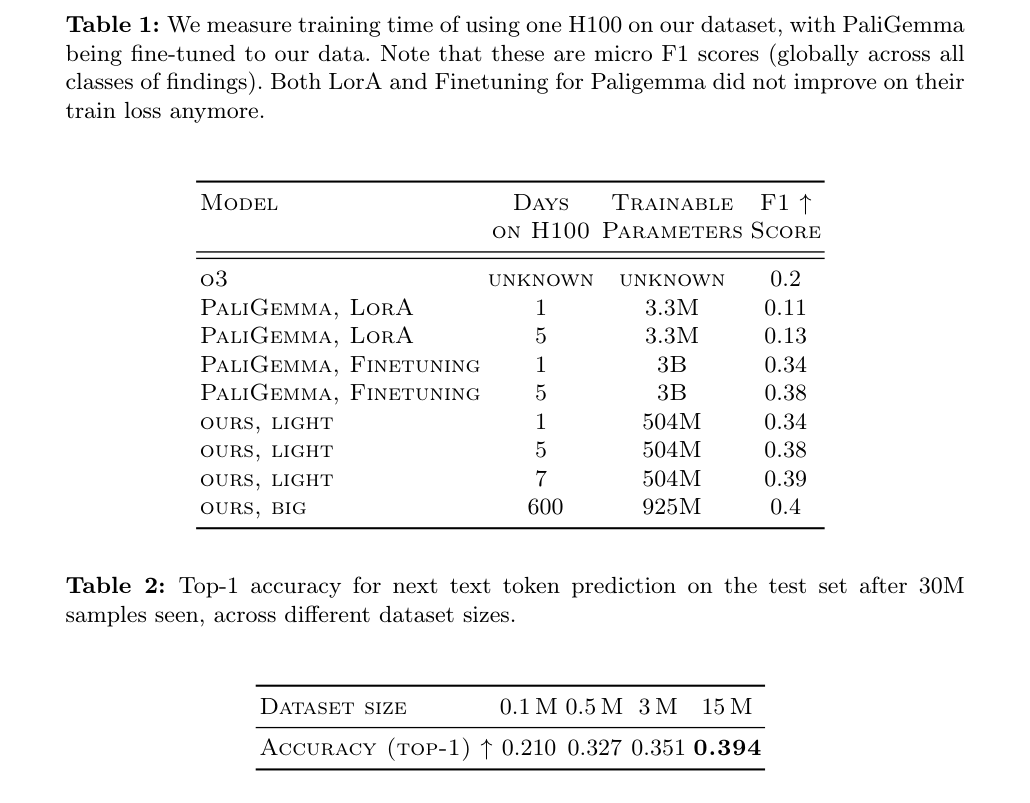
这是核心对比表。关注V-REX light(504M参数)与PaliGemma Finetuning(3B参数)的F1对比:参数量差6倍,F1却略高。同时注意PaliGemma LoRA的F1仅0.13,说明低秩微调在专家领域几乎无效。
研究缺口:从零训练 vs 微调
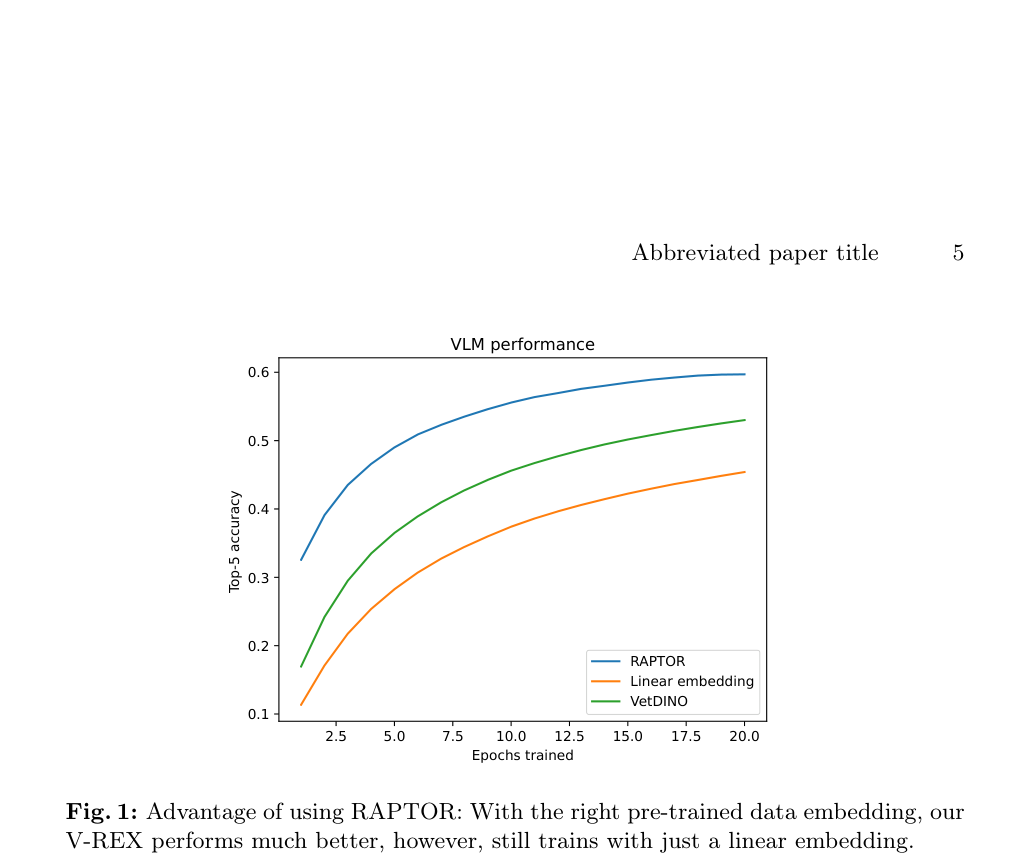
这张图对比了不同视觉嵌入方法的效果。重点观察RAPTOR嵌入相比VetDINO和线性嵌入的性能差距:RAPTOR的优势说明,预训练嵌入的质量对从零训练小模型至关重要,好的嵌入可以让模型在仅用线性投影的情况下就获得显著提升。
方法:先看图,再说话,最后强制看图
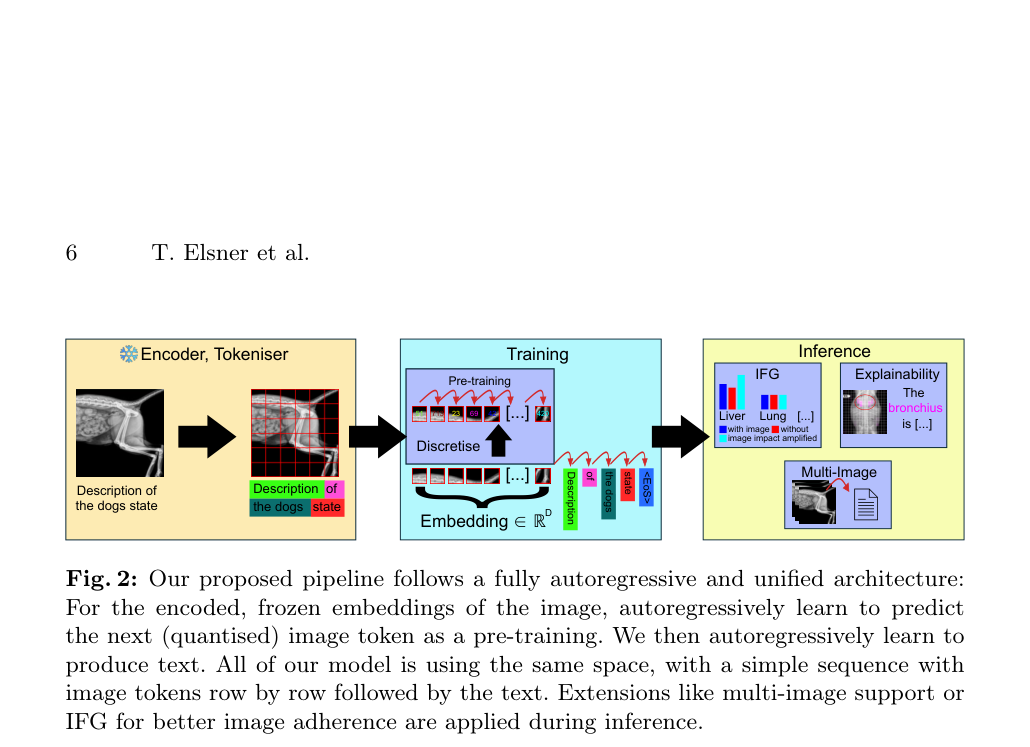
这是V-REX的完整pipeline示意图。注意图像token和文本token在同一个序列中的排列方式:图像token按行在前,文本token在后,全部通过自回归方式处理。生成式预训练阶段只预测图像token,正式训练阶段才加入文本token。
结论与意义
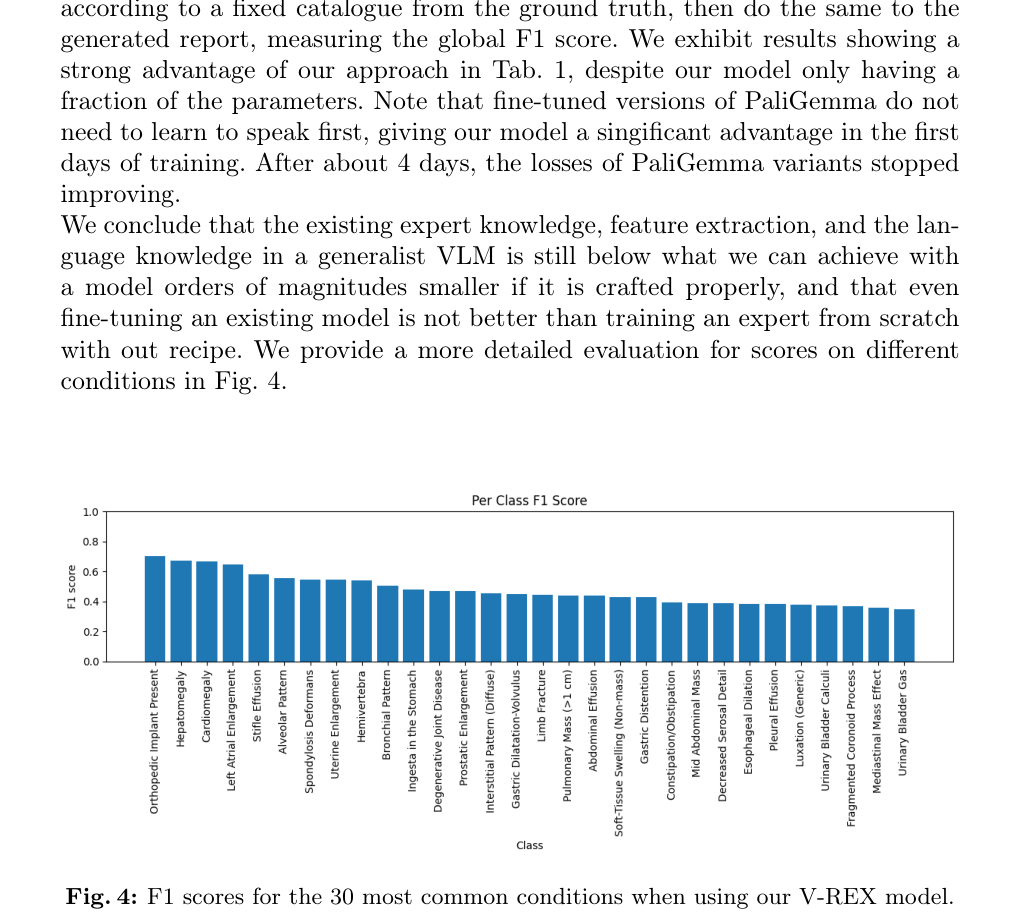
这张图展示了30种最常见疾病的F1分数分布。观察哪些疾病的F1较高、哪些较低,可以了解V-REX的优势和盲区。高F1的疾病通常是影像特征明显的,低F1的疾病可能依赖更多临床上下文。
实验如何设计?
- 数据集为兽医X光影像及对应放射报告,规模从0.1M到15M样本不等。评估采用F1分数(micro F1,全局跨所有findings类别)和top-1/top-5准确率。
- 基线对比包括:o3(通用大模型,零样本推理)、PaliGemma全量微调(3B参数,5天H100)、PaliGemma LoRA微调。V-REX light为504M参数,训练7天;V-REX big为925M参数,训练600天H100。
- 数据效率实验在0.1M、0.5M、3M、15M四个规模上进行,测量top-1准确率随数据规模的变化。
- 生成式预训练消融在3M子集上进行,对比无预训练与不同聚类中心数(512/4096/32768)的效果,预训练15个epoch。
- IFG消融对比不同放大系数(×1至×25)下的F1变化,确定最优引导强度区间。
- 失败实验包括:Multi-Token Prediction、输入输出嵌入共享、随机增强、dropout评估模式,这些方法在500M规模模型上均未带来提升。
关键结果与论文证据
- V-REX light(504M参数,7天H100)F1=0.39,超过PaliGemma全量微调(3B参数,5天)的F1=0.38,优势幅度有限但方向明确(第10页,表1)。
- V-REX big(925M参数,600天H100)F1=0.4,为所有方法最高,但相对light版本提升仅0.01,边际收益递减明显(第10页,表1)。
- o3的F1仅为0.2,PaliGemma LoRA微调最高F1仅0.13,说明通用大模型在零样本和低秩微调两种模式下均表现不佳(第10页,表1)。
- 数据规模从0.1M扩展到15M,top-1准确率从0.210提升至0.394,提升幅度接近翻倍,说明生成式预训练策略能有效利用更多数据(第10页,表2)。
- 生成式预训练(512聚类中心)将top-1从0.3769提升至0.3898,perplexity从14.81降至13.85,证明预训练确实改善了模型对图像内容的理解(第11页,表3)。
- IFG在×2至×6区间将F1从约0.36提升至约0.39,但×10和×25时F1下降,说明过度引导会损害性能,需要调参(第11页,图5)。
- 多图像token概率池化可提升top-1准确率最高0.03,且无需额外训练,是一种零成本推理增强(第8页)。
- Integrated Gradients可视化显示模型在预测“cardiac”时聚焦于心脏区域,为IFG的有效性提供了定性证据(第8页,图3)。
阅读时需要注意
- RAPTOR编码器为专有模型,未公开权重和训练细节,影响完全复现。这是V-REX方法可复现性的最大障碍。
- V-REX big需要600天H100训练,计算成本极高,与论文“轻量级”的定位存在张力。实际上,V-REX light的7天训练才是真正实用的配置。
- 生成式预训练仅在3M子集上验证,未在完整15M数据上报告效果。更大数据规模下预训练的收益是否持续,尚不清楚。
- IFG在较大放大系数(×10、×25)时F1下降,说明该技术对超参数敏感,实际部署需要仔细调参。
- F1评估依赖o3提取findings,存在评估器偏差风险。如果o3本身对某些findings的提取不准确,会直接影响所有模型的F1分数。
- Multi-Token Prediction在500M规模模型上无效,论文推测需要更大模型才能受益,但未提供验证。
关联工作
- PaliGemma作为微调基线,代表了当前“通用VLM+领域微调”的主流范式。V-REX与它的对比,本质上是“从零训练专家模型”与“微调通用模型”两条路线的对决。
- RAPTOR基于Vet-DINO架构,后者是兽医影像领域的自监督视觉模型。RAPTOR通过DINO-CLIP混合对比学习目标,在Vet-DINO基础上进一步提升了嵌入质量。
- LLaVA(7B参数)和Flamingo代表了两种不同的VLM架构范式:LLaVA采用线性投影连接视觉编码器和LLM,Flamingo采用交叉注意力。V-REX的全自回归统一架构与两者都不同,更接近GPT式的序列建模。
- VisorGPT和BEiT是图像预训练的相关工作:VisorGPT采用GPT式自回归图像生成预训练,BEiT采用BERT式掩码图像建模。V-REX的生成式预训练与VisorGPT思路相近,但针对VLM任务做了适配。
- classifier-free guidance最初用于扩散模型,通过对比有条件和无条件生成的差异来放大控制信号。V-REX将这一思想迁移到VLM推理中,是跨领域技术迁移的一个有趣案例。