R2-WAM:世界动作模型需要怎样的视觉表征
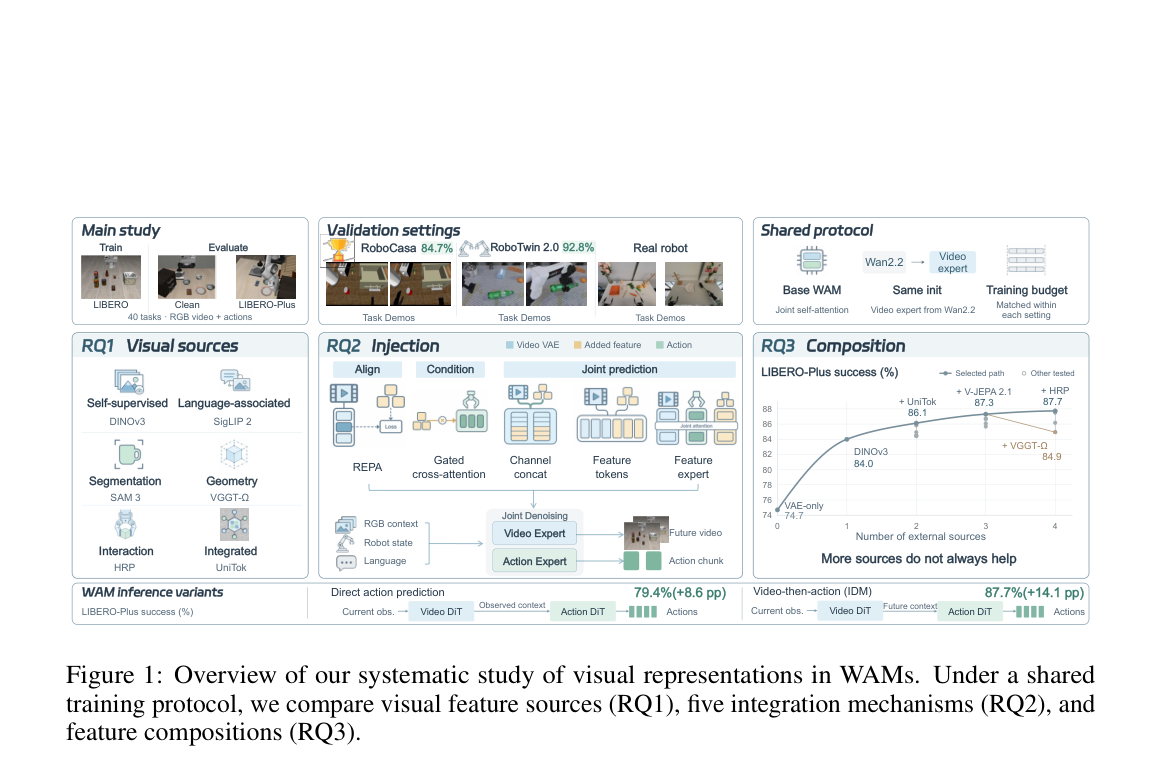
在共享训练协议下比较十三种视觉来源、五种注入机制与多源组合,得到以通用表征和通道拼接为核心的 Representation Recipe,并实例化为 R2-WAM。
Mind the Temporal Gap:检视驾驶视频中的时序理解缺口
在受控自车运动任务上,现成视频语言模型提示表现不稳且常有类别崩塌,而轻量 LoRA 与特征探针能恢复强运动判别,说明线索常在内部却未可靠进入语言通路。
SimVTA:用仿真对齐驾驶世界模型的视频与轨迹
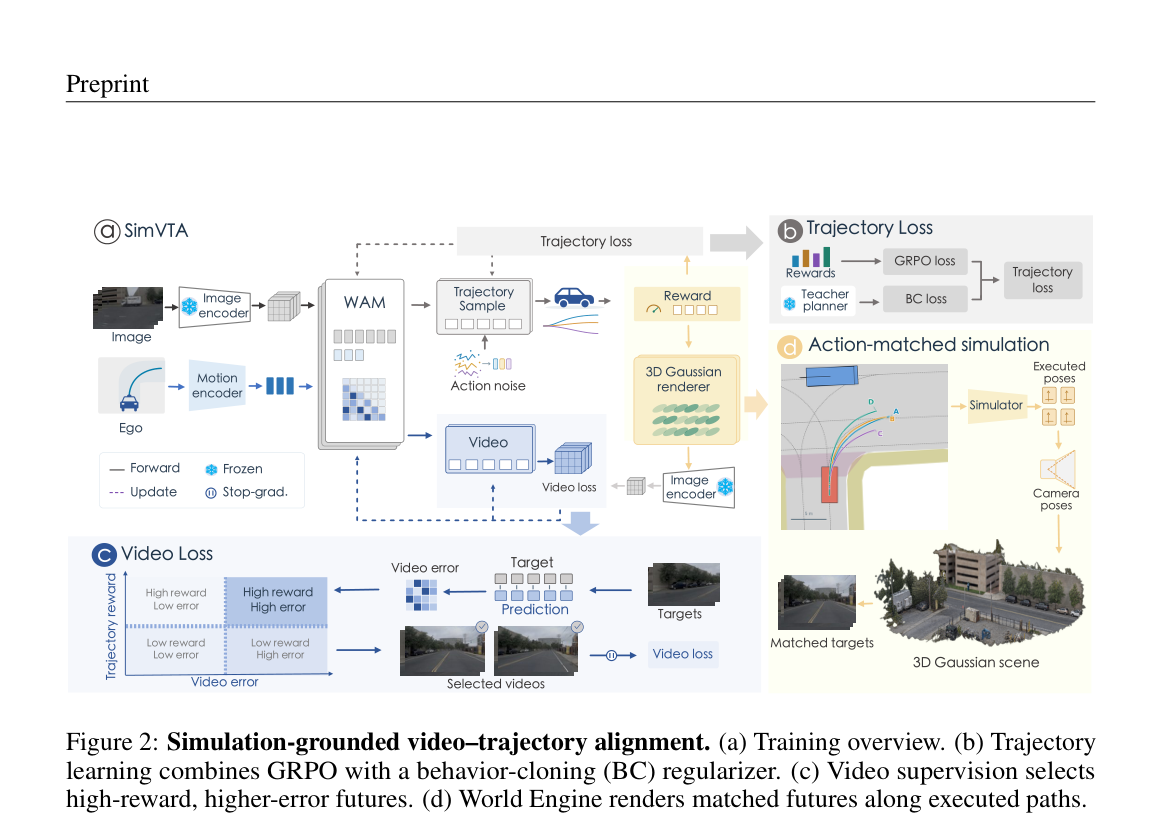
SimVTA 用 World Engine 沿当前策略候选轨迹渲染匹配未来视频,把轨迹 GRPO 与高误差视频监督接到共享表征上,弥补驾驶日志只覆盖已记录动作的缺口。
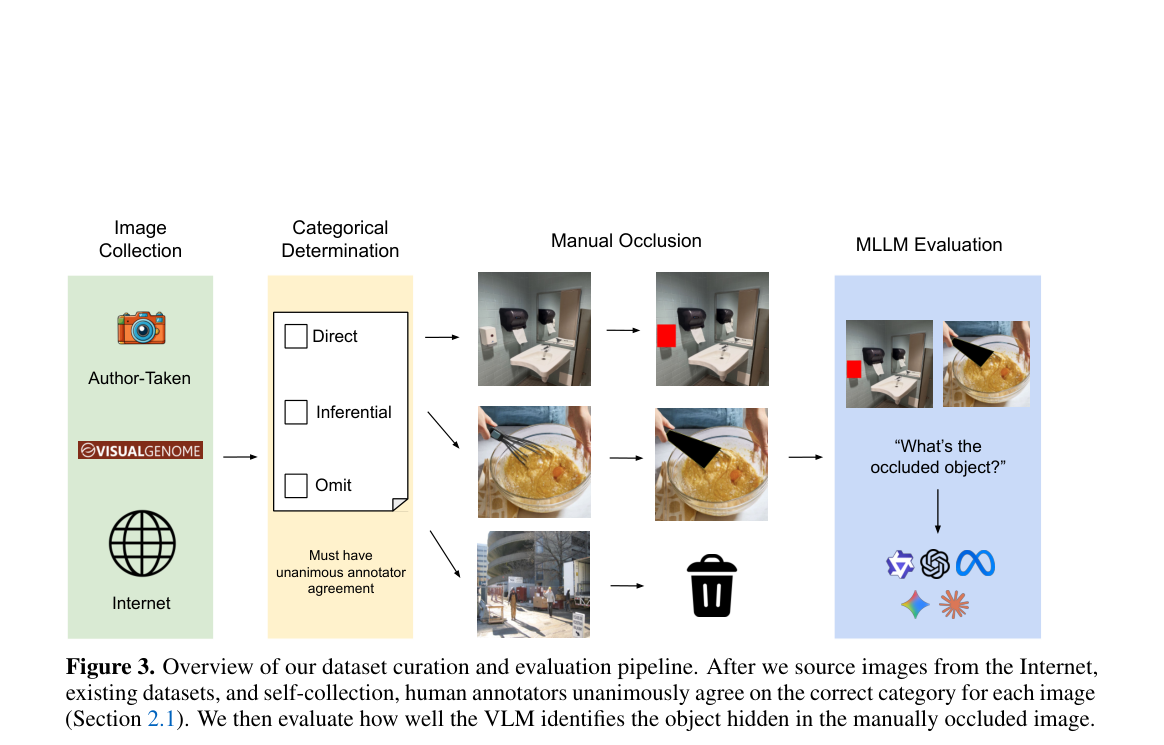
SpatialASM:内化主动心智化以增强空间推理
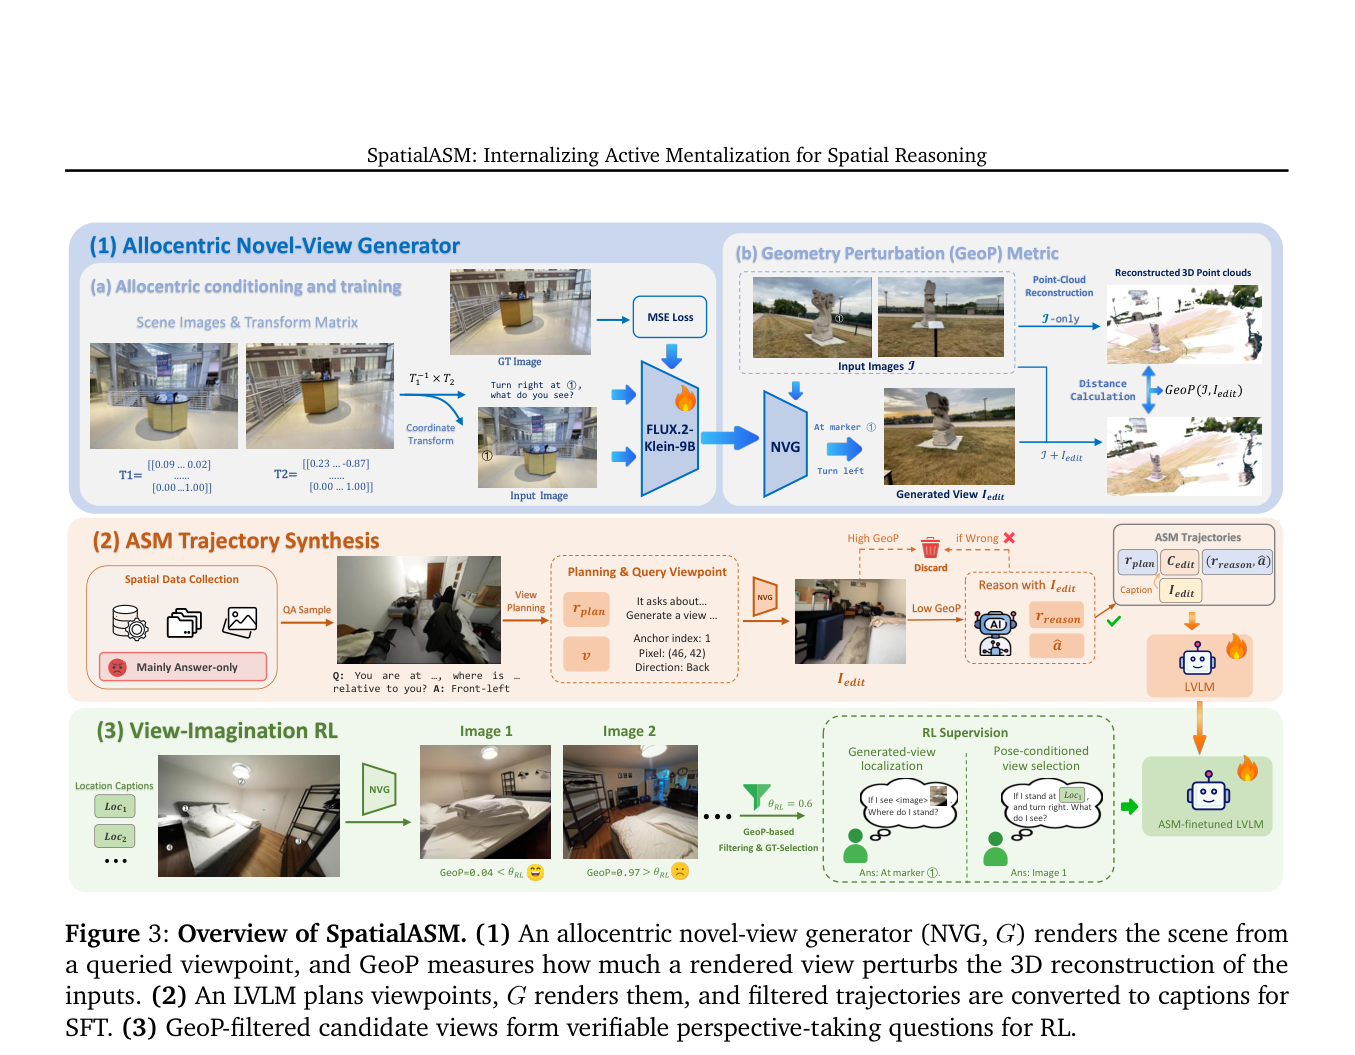
SpatialASM 提出了一种通过训练时空间模拟将主动空间心智化(ASM)内化到大型视觉语言模型(LVLMs)中的可扩展框架,利用自心参考新视角生成器(NVG)和几何扰动(GeoP)过滤机制,生成显式推理轨迹用于 SFT 和可验证视角任务用于 RL,从而在多个空间推理基准上显著提升性能。