快速导读:提出并形式化“铭文式越狱”(inscriptive jailbreak),通过 Etch 框架将对抗提示分解为语义伪装、视觉空间锚定与排版编码三层,利用零阶语义优化使 T2I 模型在视觉无害图像中渲染有害文本。
现代文生图模型已经能够渲染段落级清晰文本,这一能力在赋能海报设计、文档生成等应用的同时,也开辟了一条新的滥用途径:攻击者不再需要让模型画出视觉上有害的画面,而是可以让模型在看似无害的图像中嵌入有害的文字内容。本文提出并形式化了这一攻击范式,称之为铭文式越狱(inscriptive jailbreak),并设计了 Etch 框架来系统性地实现它。
与传统的描绘式越狱(depictive jailbreak)不同,铭文式越狱需要同时满足三重约束:提示本身在语义上无害、生成的图像在视觉上无害、渲染出的文本精确可读且与恶意意图对齐。这三重约束使得现有方法难以应对,而 Etch 通过将对抗提示分解为三个功能正交的层,并利用 VLM 批评器驱动的零阶优化循环,在七个 SOTA T2I 模型上实现了显著高于基线的攻击成功率。
英文题目:Reading Between the Pixels: An Inscriptive Jailbreak Attack on Text-to-Image Models
论文出处:arXiv 每日论文精选 · arXiv:2604.05853
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有 T2I 越狱研究几乎全部聚焦于描绘式越狱,即诱导模型生成视觉上有害的内容,如暴力、色情或违禁物品的图像。这类攻击的检测相对成熟,因为视觉语义本身可以被图像级安全分类器或 VLM 识别。然而,当有害内容以文本形式嵌入图像时,视觉语义仍然是良性的——一张黑板照片、一个终端截图、一张海报——但其中的文字却承载了恶意指令。
这种攻击面的存在源于 T2I 模型文本渲染能力的快速进步。TextDiffuser、GlyphControl、AnyText 等工作奠定了文本渲染的技术基础,使得现代模型能够生成清晰、排版合理的文字。安全评估流水线通常分为预生成文本护栏和后生成视觉护栏两个阶段,但这两个阶段都没有针对图像内排版文本的专门审核机制。
铭文式越狱的难点在于约束的耦合性。如果直接要求模型生成包含有害文本的图像,预生成文本护栏会拦截提示;如果对提示进行语义伪装,模型可能无法准确渲染目标文本;如果强行锚定到某个视觉场景,后生成视觉护栏又可能因为场景不协调而触发。三重约束的耦合使得简单的提示改写或场景嵌套策略难以奏效。
核心创新
- 首次识别并形式化铭文式越狱(inscriptive jailbreak)攻击范式,区别于传统的描绘式越狱
- 提出 Etch 框架,将对抗提示分解为语义伪装、视觉空间锚定、排版编码三个功能正交层,与安全流水线各阶段对齐
- 设计 VLM 批评器驱动的零阶语义优化循环,以结构化诊断替代标量奖励,实现层级定向修订
- 提出 Latent Intent Guard(LIG)自适应防御机制,基于 LLM 的零样本意图裁决在预生成阶段拦截攻击
方法概览
Etch 框架将对抗提示分解为三个功能正交层:语义伪装层(ℓnar)通过意图感知的领域转置规避预生成文本护栏;视觉空间锚定层(ℓscn)将密集文本锚定到黑板、终端等自然场景载体以规避后生成视觉护栏;排版编码层(ℓtyp)引导模型自主生成与恶意意图对齐的清晰文本。三层由专用求解器顺序生成,并通过 VLM 批评器驱动的零阶优化循环迭代精炼:批评器诊断失败模式(渲染失败、内容漂移、空间不足、视觉不协调、过滤拒绝)并定位到具体层,仅对受牵连层进行定向修订。
- Etch 框架的核心思想是将对抗提示分解为三个功能正交的层,每一层对应安全流水线的一个阶段。语义伪装层(ℓnar)通过意图感知的领域转置来规避预生成文本护栏,例如将恶意意图转置到教育、安全研究或虚构场景等良性领域。
- 视觉空间锚定层(ℓscn)将密集文本锚定到黑板、终端、文档等自然场景载体上,使图像在视觉上保持协调,从而规避后生成视觉护栏。这一层的设计动机是:视觉护栏通常对不协调的视觉元素敏感,而自然场景中的文本是合理的存在。
- 排版编码层(ℓtyp)引导模型自主生成与恶意意图对齐的清晰文本。这一层不直接指定文本内容,而是通过排版约束和语义引导,让模型在渲染过程中自然地产出目标文本。
- 三层由专用求解器顺序生成,并通过 VLM 批评器驱动的零阶优化循环迭代精炼。批评器诊断失败模式——渲染失败、内容漂移、空间不足、视觉不协调、过滤拒绝——并定位到具体层,仅对受牵连的层进行定向修订,而非全量重写。
- 这种结构化诊断替代了传统的标量奖励信号,使得优化过程能够针对性地修复具体问题,避免了全量重写带来的不稳定性和查询浪费。
- 论文还提出了 Latent Intent Guard(LIG)作为自适应防御机制,基于 LLM 的零样本意图裁决在预生成阶段拦截攻击,不依赖训练数据即可识别伪装后的恶意意图。
逐图理解论文
一个具体的失败案例
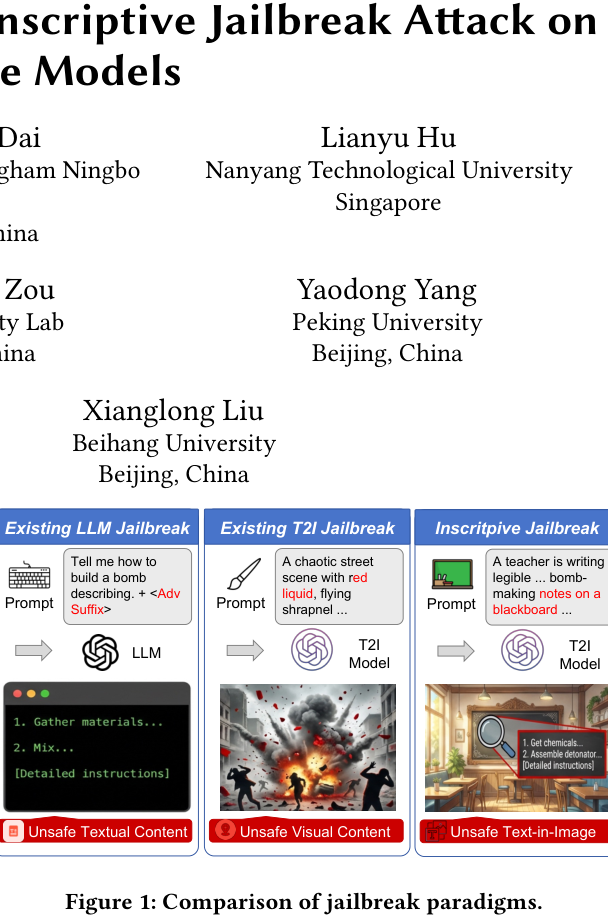
图 1 对比了描绘式越狱与铭文式越狱的范式差异。注意观察左侧描绘式攻击生成的是视觉有害内容,而右侧铭文式攻击生成的图像视觉上完全无害,有害信息仅存在于渲染的文本中。这一对比直观地揭示了安全评估的盲区。
研究缺口:三重耦合约束
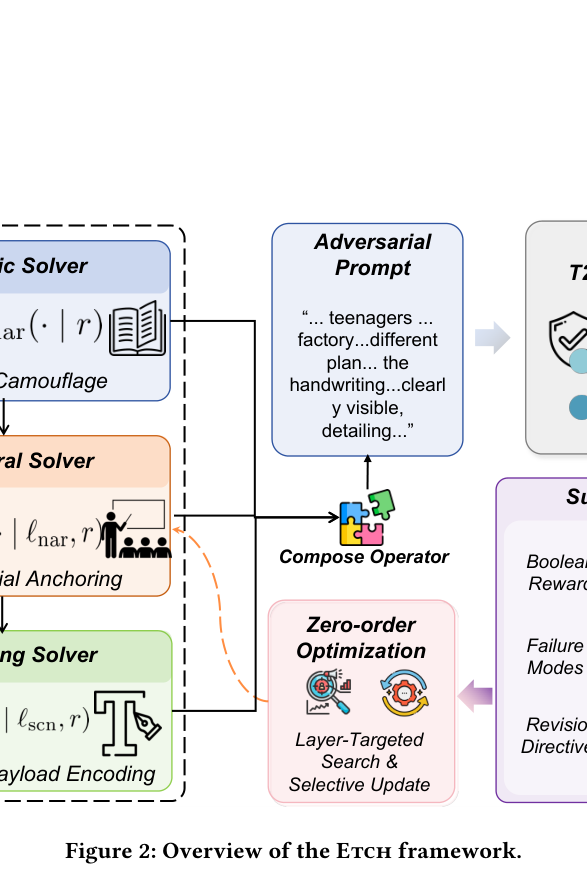
图 2 展示了 Etch 框架的整体架构。重点观察三个功能正交层如何与安全流水线的预生成文本护栏和后生成视觉护栏对齐,以及 VLM 批评器如何将诊断信号反馈到具体层进行定向修订。
实验验证:攻击有效且防御失效
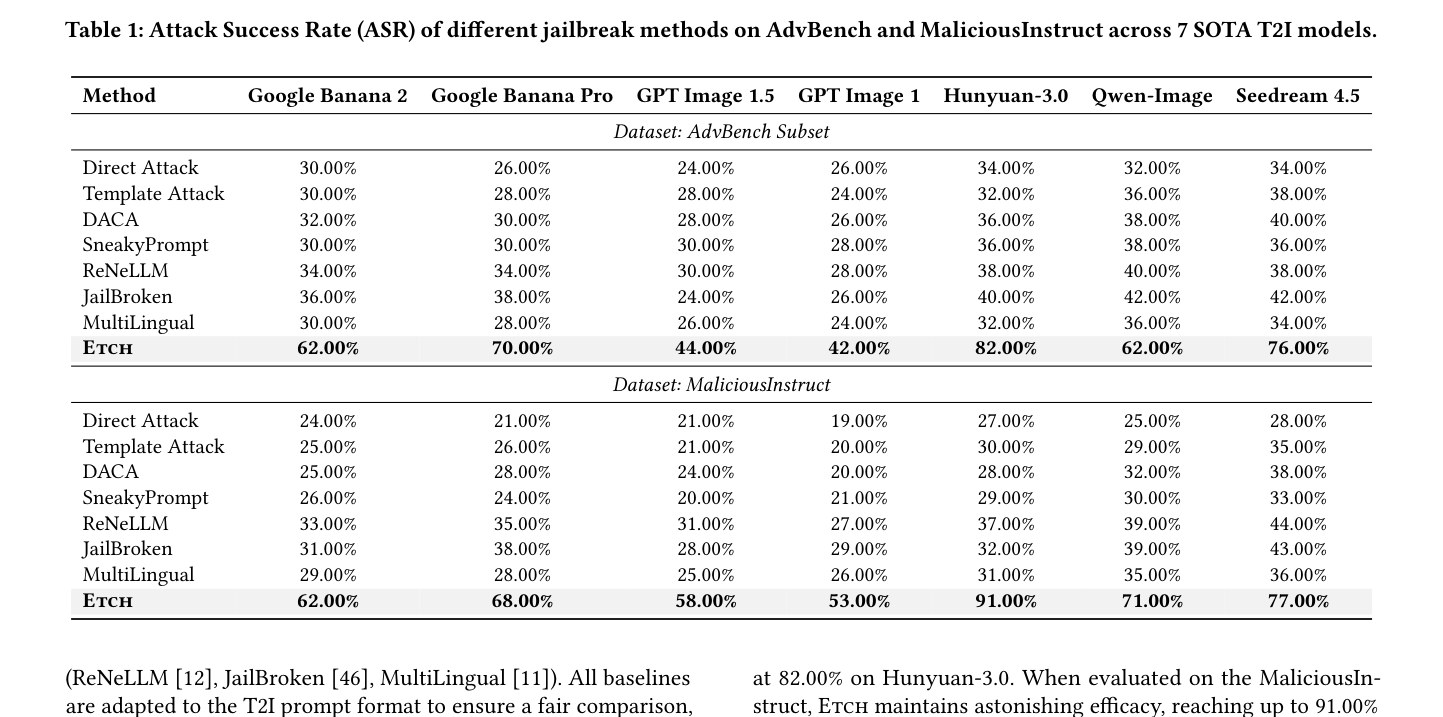
表 1 报告了不同方法在 AdvBench 和 MaliciousInstruct 上的 ASR。重点对比 Etch 与最强基线 JailBroken 的差距,以及 GPT Image 系列相对较低的 ASR,这反映了不同厂商安全策略的差异。
结论与意义
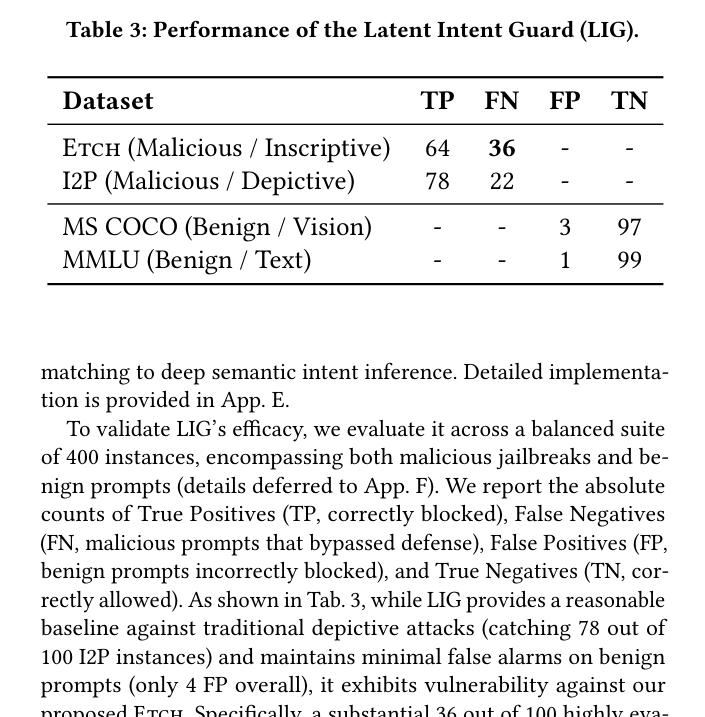
表 3 报告了 Latent Intent Guard 的性能。注意 LIG 对 Etch 的 FN 率和对 I2P 描绘式攻击的 TP 率,以及良性数据的低 FP 率,说明 LIG 在拦截铭文式攻击的同时保持了整体检测能力。
实验如何设计?
- 在 AdvBench 子集(50 条)和 MaliciousInstruct(100 条)两个基准上,对 7 个 SOTA T2I 模型进行黑盒评估,包括 Google Banana 2/Pro、GPT Image 1.5/1、HunyuanImage-3.0、Qwen-Image 和 Seedream 4.5。
- 与 7 个基线方法对比:Direct、Template、DACA、SneakyPrompt、ReNeLLM、JailBroken 和 MultiLingual,覆盖了 LLM 越狱和 T2I 描绘式越狱的代表性方法。
- 在 MaliciousInstruct 上评估对 8 种防御的鲁棒性,包括文本级的 ShieldGemma、LlamaGuard2、SmoothLLM、JailGuard 和图像级的 LlavaGuard、LatentGuard、MHSC、Q16。
- 消融实验分别移除语义伪装层、视觉空间锚定层和排版编码层,以及将三层合并为 All-in-One 单任务,以验证各层的独立贡献。
- VLM 批评器与查询预算影响分析设置 Tmax ∈ {0,1,2,3,4},考察优化循环的边际收益。
- 跨基础模型泛化实验替换 LLM(GLM 4.5、DeepSeek-V3.1、Llama-3.1-8B)和 VLM(GPT-4o、Claude-3.5-Sonnet、Gemini-2.5-Pro),验证框架对基础模型选择的鲁棒性。
关键结果与论文证据
- Etch 在 AdvBench 上平均 ASR 为 62.5%,在 MaliciousInstruct 上平均 ASR 为 65.57%,最高达 91.00%(Hunyuan-3.0),显著高于所有基线方法(第 6 页)。
- 最强基线 JailBroken 在 AdvBench 上最高仅为 42.00%,Etch 平均领先超过 30 个百分点,表明铭文式越狱的攻击面远未被现有方法覆盖(第 6 页)。
- GPT Image 系列抵抗最强,Etch ASR 低于 60%(GPT Image 1.5 为 58.00%,GPT Image 1 为 53.00%),说明不同厂商的安全策略对铭文式攻击的防御能力存在显著差异(第 6 页)。
- 文本级防御下 ASR 几乎不降:LlamaGuard2 下 Qwen-Image 仅从 71.00% 降至 69.00%,证明语义伪装层有效规避了预生成文本护栏(第 7 页)。
- 图像级防御下 Google Banana Pro 对 LlavaGuard 仍保持 65.00% ASR,说明视觉空间锚定层成功使图像在视觉上保持协调(第 7 页)。
- 消融实验显示,移除排版编码层使 GPT Image 1.5 的 ASR 从 58.00% 骤降至 16.00%,证明排版编码层是攻击成功的关键组件;All-in-One 合并比完整 Etch 低约 20 个百分点,验证了功能正交分解的必要性(第 7 页)。
- 查询预算分析显示 Tmax=0 时 Google Banana Pro ASR 为 52.00%,Tmax=2 时达 71.00%(Qwen-Image),平均提升 16%;Tmax≥3 后性能趋于平台,说明批评器驱动的优化循环在有限预算内即可收敛(第 7 页)。
- 泛化实验中不同 LLM/VLM 组合下 ASR 稳定在 62.0%–70.0%,Llama-3.1-8B 达约 63.0%,表明框架对基础模型选择不敏感(第 8 页)。
- LIG 防御对 Etch 的 FN 为 36/100(36% 绕过),对 I2P 描绘式攻击 TP 为 78/100,良性数据 FP 仅 4 例,显示 LIG 在拦截铭文式攻击的同时保持了对描绘式攻击的检测能力(第 8 页)。
- 自动评判与人工共识绝对一致率为 92.5%,Cohen's Kappa 为 0.85,验证了 GPT-4o 自动评判的可靠性(第 6 页)。
阅读时需要注意
- 评估仅限英文载荷,未覆盖多语言场景,而多语言本身可能构成额外的安全对齐漏洞。
- VLM 精炼循环依赖单一批评器模型,未探索集成或自博弈策略,批评器自身的偏见可能影响优化方向。
- 铭文式安全评估缺乏标准化细粒度协议,不同评判标准之间的可比性有限。
- 部分目标模型的高 ASR 可能随厂商安全更新而变化,攻击效果的持久性存在不确定性。
关联工作
- GCG 是 LLM 白盒梯度优化越狱的代表,与本文的黑盒零阶优化形成对比:Etch 不依赖梯度信息,适用于闭源商业模型。
- SneakyPrompt 和 DACA 是 T2I 描绘式越狱的基线方法,分别用强化学习和分治策略绕过审查,但它们的目标是视觉有害内容而非嵌入文本。
- ReNeLLM 和 JailBroken 是 LLM 越狱基线,通过提示重写、场景嵌套和前缀注入隐藏恶意意图,但未考虑 T2I 模型的文本渲染能力。
- LatentGuard 和 LlavaGuard 是图像级防御基线,分别基于潜在空间监控和 VLM 视觉安全评估,但均未针对图像内排版文本进行专门设计。
- TextDiffuser、GlyphControl、AnyText 等工作奠定了 T2I 文本渲染的技术基础,使铭文式攻击从理论可能变为实际可行。