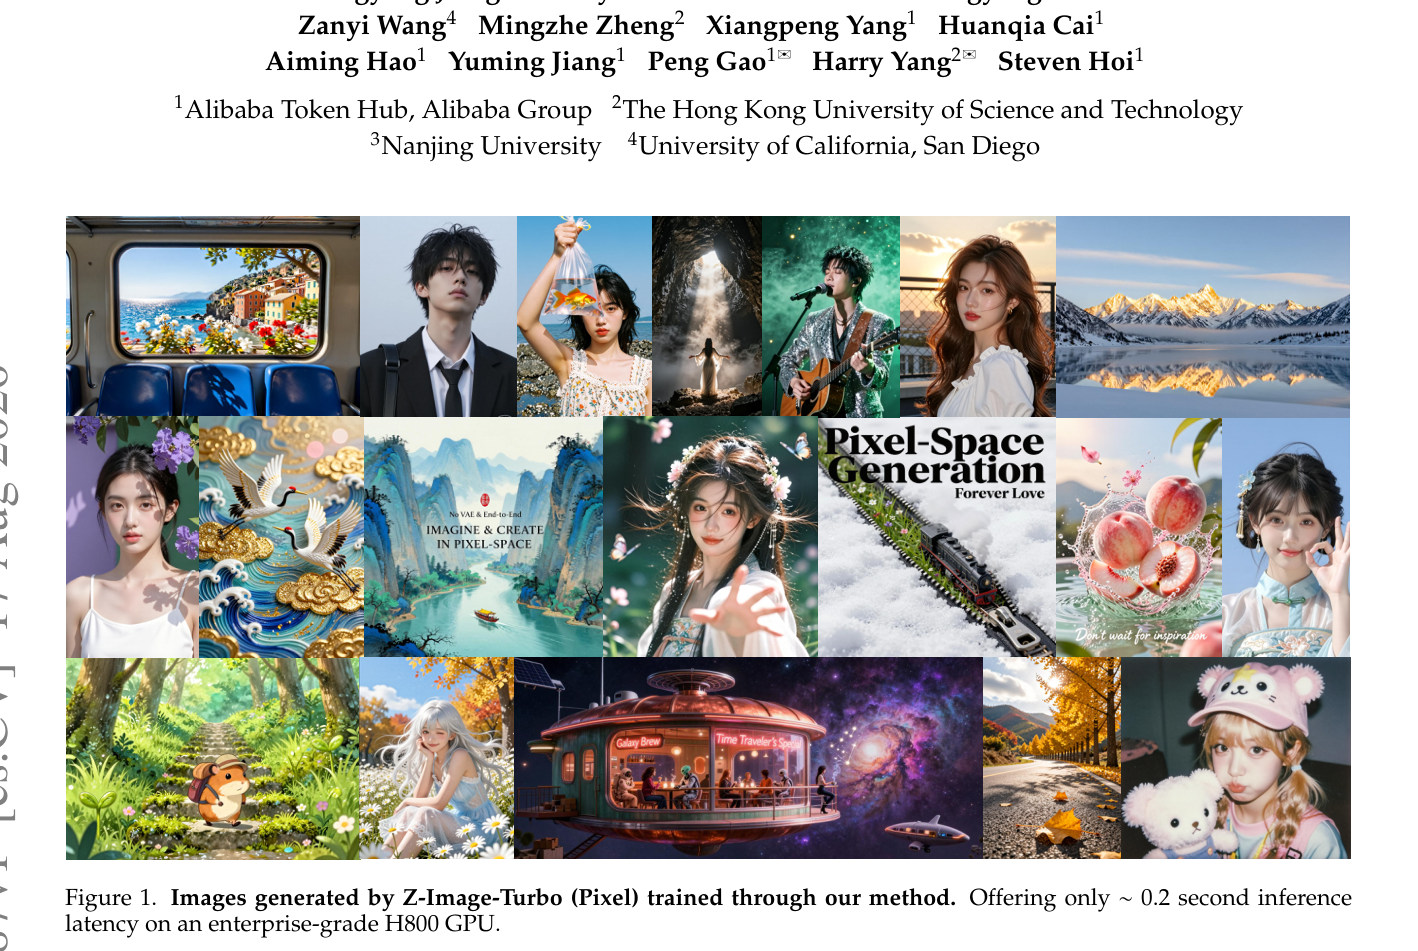
快速导读:本文通过大规模受控实验系统研究像素空间文生图扩散模型的训练配方,提出latent-to-pixel策略,使像素空间模型以3.18–4.75倍推理加速达到或超越latent-space模型性能。
本文针对像素空间文生图扩散模型的训练配方进行了系统性的经验研究。像素空间扩散模型直接在RGB图像上建模,避免了latent-space模型中VAE解码带来的细节丢失和额外延迟,但长期以来缺乏大规模文生图场景下的实用训练方案。
作者的核心贡献是提出latent-to-pixel迁移策略:先在latent space高效预训练获取生成先验,再在post-training阶段迁移到像素空间。通过系统消融权重初始化、训练数据组成、预测目标、decoder架构和噪声调度等关键设计,最终在Z-Image和FLUX2-klein两个模型家族上验证了该配方的有效性。
英文题目:An Empirical Study of Training Pixel-Space Text-to-Image Diffusion Models
论文出处:arXiv 每日论文精选 · arXiv:2608.16887
原始论文:PDF / 论文页面
这篇论文解决什么问题?
latent-space扩散模型已成为文生图的主流范式,但其依赖的VAE编码器-解码器存在重建瓶颈,会丢失高频细节,且推理时需要额外的解码步骤。像素空间扩散模型直接在RGB图像上建模,理论上可以避免这些问题,但现有研究多局限于小规模或类别条件设置。
本文首先通过受控实验揭示了一个关键现象:在相同的大规模预训练设置下,像素空间模型的收敛速度远慢于latent-space模型。Figure 2的评估曲线显示,latent-space模型在GenEval和DPG指标上始终领先,且收敛更快。Figure 3的定性样本也表明,latent-space模型能更早形成连贯的图像结构。
这一发现意味着直接从头训练像素空间模型并不经济。作者由此提出核心问题:能否利用latent-space预训练的先验知识,以较低成本获得高质量的像素空间模型?
核心创新
- 首次在相同大规模预训练设置下受控对比像素空间与latent-space扩散,揭示像素空间预训练收敛显著更慢
- 提出latent-to-pixel迁移策略,利用latent-space权重初始化加速像素空间收敛
- 发现self-generated数据与真实图像混合训练可兼顾快速适应与细节修正
- 系统比较decoder设计,确定DiP head在质量-效率权衡上最优
- 提出渐进式patch-size adaptation(ps16→ps32),以4倍token减少实现微小质量损失
- 结合像素空间step distillation,实现4.75倍端到端推理加速
方法概览
采用latent-to-pixel策略:先在latent space高效预训练获取生成先验,再在post-training阶段迁移到像素空间。系统研究权重初始化、训练数据组成、预测目标、decoder架构、噪声调度等关键设计,并结合渐进式patch-size adaptation与step distillation优化推理效率。
- latent-to-pixel迁移策略:先在latent space完成大规模预训练,再将权重迁移到像素空间进行post-training。Figure 4显示,使用latent-pretrained权重初始化的像素空间训练,收敛速度显著快于from scratch。
- 训练数据组成:Figure 6表明,使用源latent模型生成的self-generated数据可以大幅加速收敛,但Figure 7的定性对比显示,仅用self-generated数据会继承源模型的伪影(如文字排版错误)。混合真实图像与self-generated数据可获得最佳权衡。
- 预测目标选择:Figure 8显示,x-prediction在像素空间训练中整体优于v-prediction,收敛更快且最终性能更好。这与JiT的发现一致,即x-prediction对像素空间训练的稳定性至关重要。
- decoder架构对比:Table 1系统比较了JiT、DiP、PiT、Deco和VAE五种decoder设计。DiP以轻量卷积U-Net结构在质量-效率权衡上最优,而PiT虽然GenEval最高但参数量达2.25B,实际不可用。Figure 9显示JiT head存在明显的patch边界网格伪影,DiP则产生更平滑的空间过渡。
- 噪声尺度γ消融:Table 2显示γ=2时性能最优。Figure 10的定性对比表明,γ=1、4、8时会出现明显的色彩偏移,而γ=2产生更均衡的色彩表现。值得注意的是,从分辨率推导出的γ=8并非最优,说明该参数需要经验校准。
- 渐进式patch-size adaptation:Figure 11显示,从ps16逐步适应到ps32可以改善收敛和最终性能。Figure 12的定性对比表明,直接ps32训练会引入局部伪影,而ps16→ps32的渐进适应能保留细节。进一步适应到ps64则会重新引入伪影。
- 像素空间step distillation:结合Decoupled-DMD和DMDR方法,将像素空间模型的采样步数从100 NFE压缩到4 NFE,实现端到端推理加速。
- 系统级验证:在Z-Image和FLUX2-klein两个模型家族上验证配方的跨模型泛化性,Table 3汇总了像素空间与latent-space模型的benchmark对比。
逐图理解论文
失败案例:像素空间预训练为何不实用
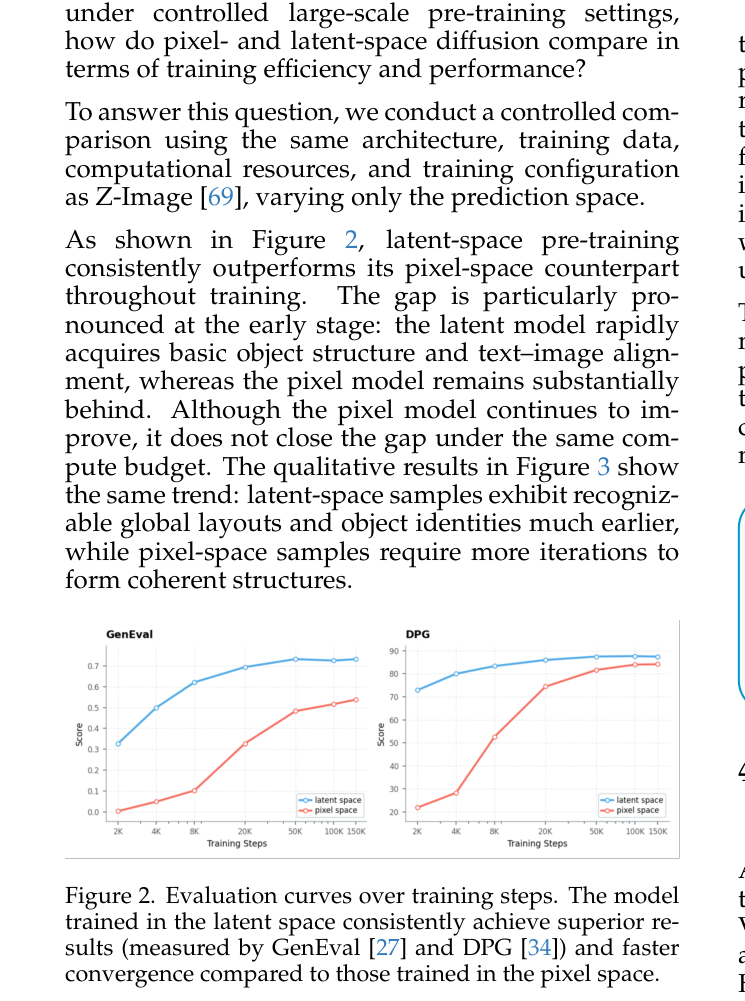
该图展示了latent-space与像素空间预训练的评估曲线对比。应重点观察两条曲线的收敛速度和最终性能差距,这直接支撑了论文的核心论点:像素空间预训练收敛显著更慢,因此需要latent-to-pixel迁移策略。
研究缺口与核心策略
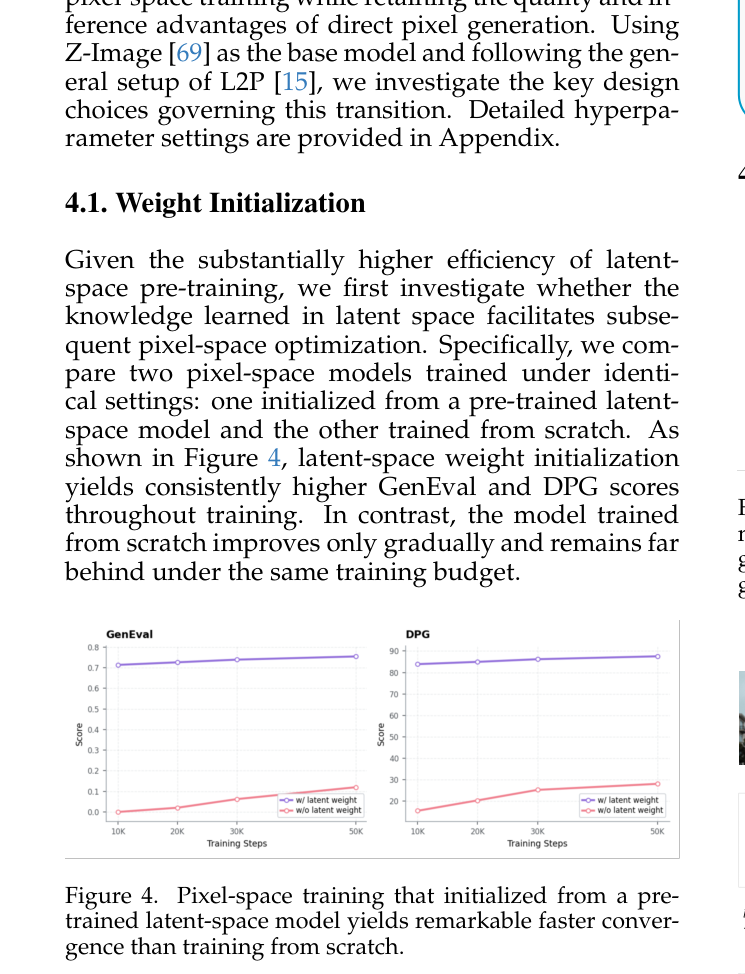
该图对比了latent-pretrained权重初始化与from scratch的收敛曲线。应关注初始化带来的早期收敛加速,这是latent-to-pixel策略有效性的直接证据。
关键设计选择:数据、预测目标与decoder
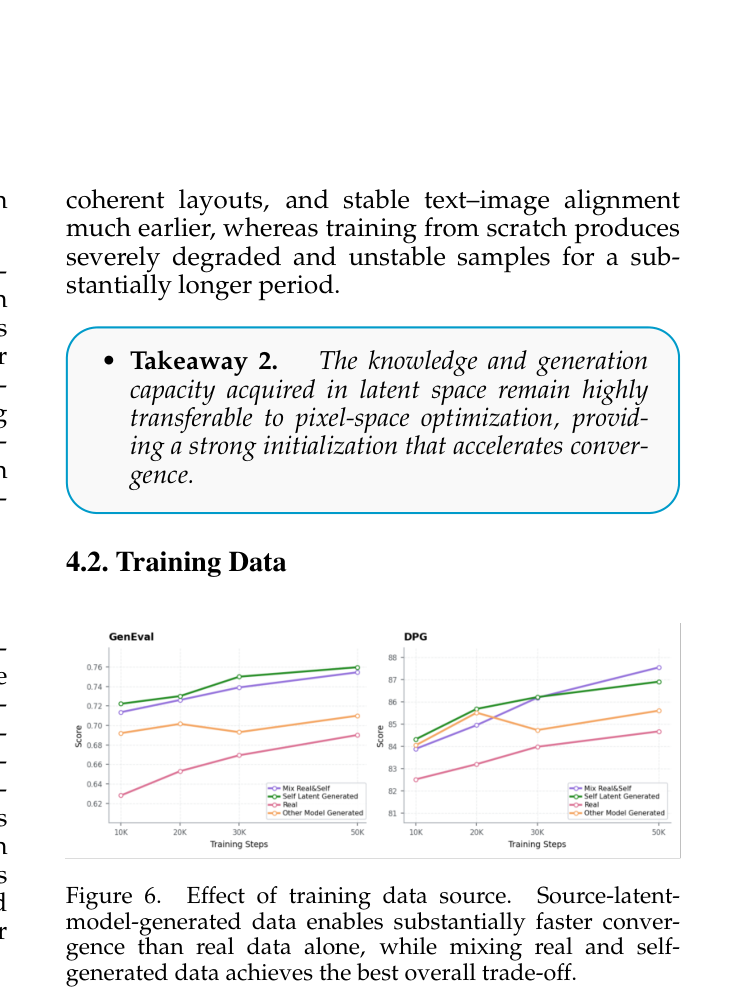
该图展示了不同训练数据来源对收敛速度的影响。应重点观察self-generated数据和混合数据相对于real data的收敛优势,这支撑了数据组成消融的结论。
推理优化:patch-size adaptation与step distillation
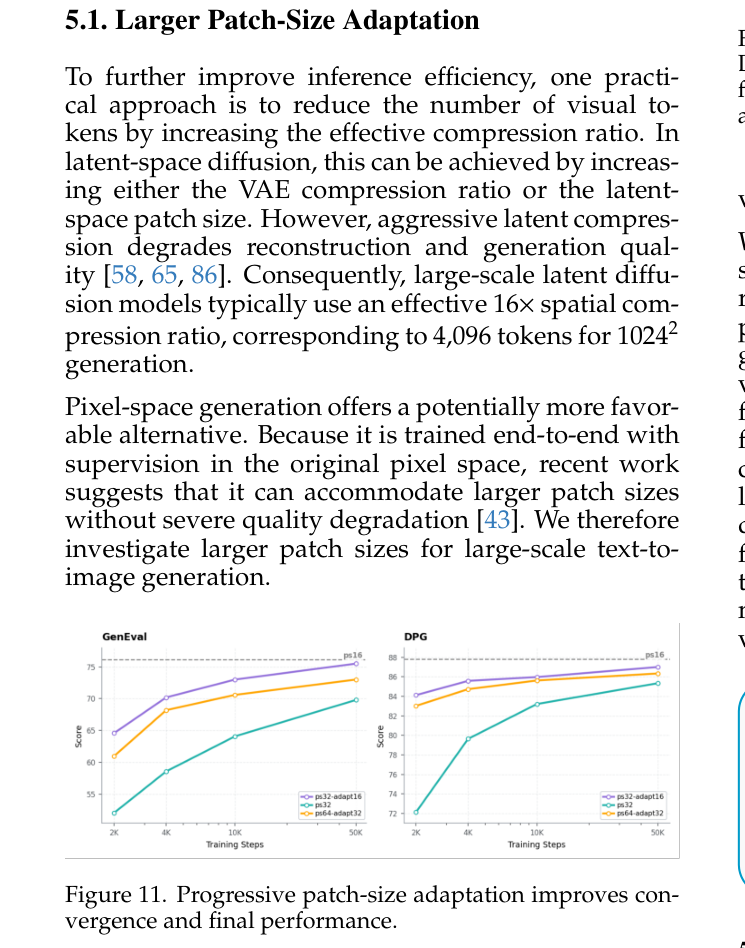
该图展示了渐进式patch-size adaptation的效果。应观察ps32-adapt16相对于直接ps32训练的性能提升,这支撑了渐进适应的必要性。
结论与意义
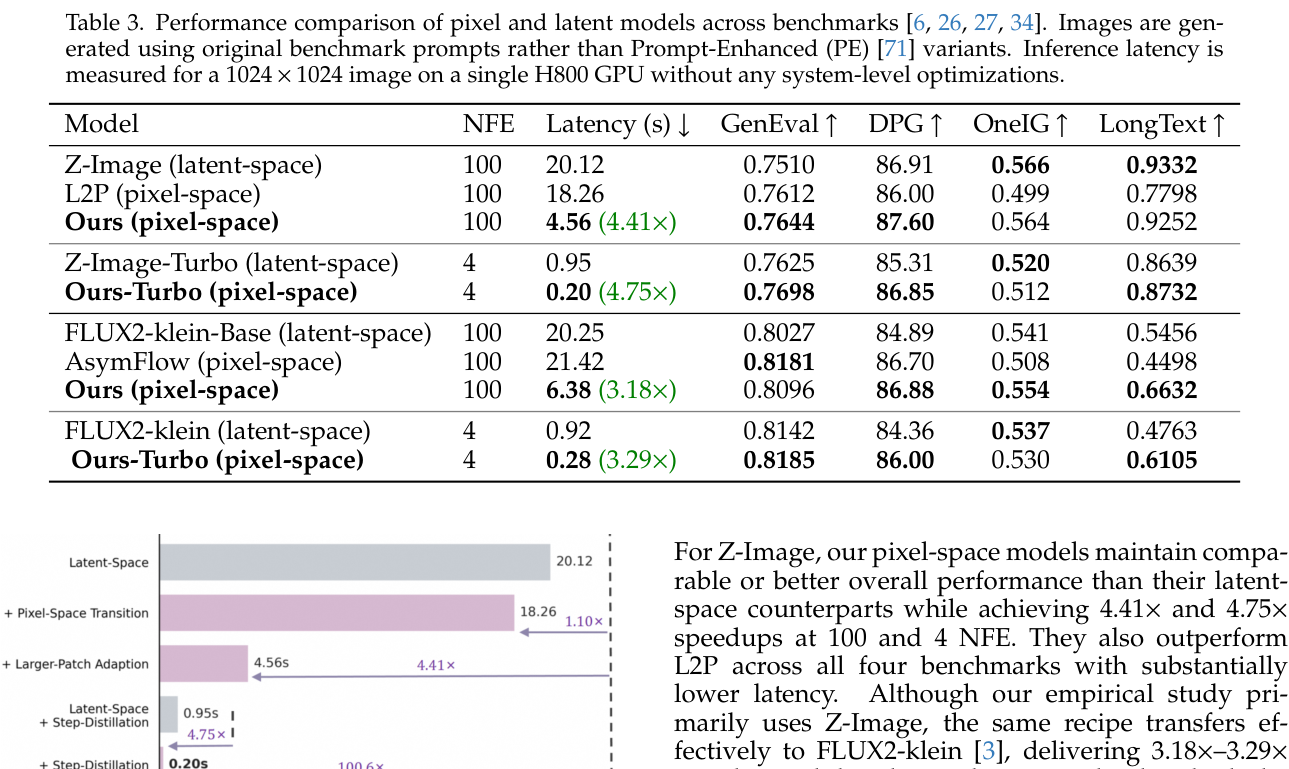
该表汇总了像素空间与latent-space模型在多个benchmark上的系统级对比。应关注像素空间模型在保持性能的同时实现的推理加速倍数,这是论文最终价值的核心证据。
实验如何设计?
- 大规模像素空间vs latent-space预训练受控对比(Sec. 3),使用GenEval和DPG作为主要评估指标。
- 权重初始化影响消融(Sec. 4.1):latent-pretrained vs from scratch。
- 训练数据来源消融(Sec. 4.2):real、self-generated、other-model、mixed四种数据组成。
- 预测目标对比(Sec. 4.3):x-prediction vs v-prediction。
- decoder架构对比(Sec. 4.4):JiT、DiP、PiT、Deco、VAE五种设计,在1024×1024分辨率、单张H800 GPU上测量延迟和GFLOPs。
- 噪声尺度γ消融(Sec. 4.5):γ∈{1,2,4,8}。
- patch-size adaptation实验(Sec. 5.1):ps16、ps32、ps32-adapt16、ps64-adapt32四种配置。
- step distillation实验(Sec. 5.2):结合Decoupled-DMD和DMDR。
关键结果与论文证据
- 像素空间预训练收敛显著慢于latent-space预训练(Figure 2,p.3),这构成了latent-to-pixel策略的核心动机。
- latent-pretrained权重初始化可大幅加速像素空间收敛(Figure 4,p.4),且能更早形成连贯图像结构(Figure 5,p.4)。
- self-generated数据加速收敛但继承源模型伪影,混合真实图像可修正细节(Figure 6-7,p.4)。
- x-prediction在像素空间训练中优于v-prediction(Figure 8,p.5)。
- DiP decoder在质量-效率权衡上最优,GenEval 0.7545,DPG 87.54,仅10.09M参数、6.02ms延迟(Table 1,p.6)。
- 噪声尺度γ=2最优(Table 2,p.6),γ=8虽由分辨率推导但并非最优,需经验校准。
- ps32-adapt16以1/4 token数达到与ps16相当的性能(Figure 11,p.7),但ps64-adapt32会引入局部伪影(Figure 12,p.7)。
- Z-Image像素空间100 NFE达到GenEval 0.7644、DPG 87.60,延迟4.56s(4.41×加速);4 NFE蒸馏版达到GenEval 0.7698、DPG 86.85,延迟0.20s(4.75×加速)(Table 3,p.8)。
- FLUX2-klein像素空间100 NFE达到GenEval 0.8096、DPG 86.88,延迟6.38s(3.18×加速);4 NFE蒸馏版达到GenEval 0.8185、DPG 86.00,延迟0.28s(3.29×加速)(Table 3,p.8)。
阅读时需要注意
- ps64-adapt32进一步压缩token会引入局部伪影并降低benchmark性能。
- 分辨率推导的噪声尺度γ=8并非最优,需经验校准,说明理论推导与实际情况存在差距。
- PiT decoder虽GenEval最高但参数量达2.25B,实际不可用。
- self-generated数据会继承源latent模型的伪影(如文字排版错误),需要混合真实图像来修正。
- 推理延迟测量未使用FlashAttention等系统级优化,实际部署延迟可能更低。
- benchmark评估使用原始prompt而非Prompt-Enhanced变体,与部分已发表结果不可直接比较。
- 论文arXiv编号为2608.16887,日期标注为2026年8月,部分引用文献亦为2026年arXiv预印本,需注意其同行评审状态。
关联工作
- L2P是此前的latent-to-pixel适配方法,本文在Z-Image上全面超越其benchmark性能且延迟更低(p.8)。
- AsymFlow是另一个latent-to-pixel方法,本文在FLUX2-klein上多数benchmark超越(p.8)。
- JiT提出x-prediction对像素空间训练稳定性的重要性,其linear head被本文作为decoder baseline(p.5)。
- DiP是轻量卷积U-Net decoder设计,本文采用其作为最优decoder head(p.5)。
- PixelDiT(PiT)是Transformer-based decoder head,本文对比中GenEval最高但计算开销过大(p.5)。
- Deco是频率解耦像素扩散decoder,本文对比中性能与效率均不占优(p.5)。