快速导读:提出首个相机控制视频生成质量评估基准CamWorldQA(720个生成视频)及三支路无参考质量评估模型CWQA,联合空间、时序与光流特征预测感知质量。
相机控制视频生成技术允许用户给定源视频和一条新的相机轨迹,生成跟随该轨迹运动的新视频。这项技术在影视制作、虚拟现实和具身智能中具有广泛应用前景,但生成结果常常出现轨迹跟随不准、视点不一致、时序闪烁和内容变形等问题。如何可靠地评估这些生成视频的感知质量,成为制约技术落地的关键瓶颈。
本文提出CamWorldQA,这是首个专门针对相机控制视频生成的质量评估基准,包含720个生成视频和18名评分者的主观MOS标注。在此基础上,作者设计了CWQA模型,采用空间、时序、光流三支路架构,显式建模相机诱导的运动信息,并通过分支门控自适应融合,在排序一致性上显著优于现有VQA方法。
英文题目:CamWorldQA: Perceptual Quality Assessment of Camera-Controlled World Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.18710
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视频质量评估方法主要面向自然视频或用户生成内容,其核心假设是视频中的运动来自场景本身的动态变化。然而在相机控制生成场景中,运动的主体是相机视点的变换,场景内容本身可能保持静止。这种运动来源的根本差异,使得传统VQA方法难以捕捉视点一致性、运动连贯性和内容保持等相机控制生成特有的感知特性。
以ReCamMaster、GEN3C、TrajectoryCrafter等为代表的生成方法,在轨迹跟随精度和视点一致性上表现参差不齐。论文中的MOS统计显示,六种生成方法的质量分存在明显分层:GEN3C得分最高,而Diffusion as Shader和TrajectoryCrafter得分明显偏低。这种差异说明,不同方法在相机控制生成任务上的能力差距是真实存在且可被感知的。
更关键的问题是,缺乏专用基准导致研究社区无法系统比较和优化生成方法。通用VQA模型在该任务上的表现如何?多模态大模型能否直接用于评估?这些问题在CamWorldQA出现之前都没有明确答案。
核心创新
- 构建首个相机控制视频生成质量评估数据集CamWorldQA:20个源视频×6条相机轨迹×6个生成模型=720个视频,含18人主观MOS标注
- 提出三支路无参考质量评估模型CWQA,显式引入光流支路刻画相机诱导运动,并设计分支门控自适应融合
- 系统基准测试传统VQA、学习型VQA及多模态大模型在相机控制生成视频上的表现
方法概览
CWQA采用三支路框架:空间支路(ResNet-50多层级外观特征)、时序支路(SlowFast高层动态特征)、光流支路(RAFT显式运动特征),经投影MLP映射到公共特征空间后,通过分支门控网络自适应加权,拼接后由质量回归头预测分数,采样位置预测取平均得到视频级质量。
- CWQA采用三支路并行架构。空间支路使用ResNet-50提取多层级外观特征,关注单帧内的纹理、结构和内容完整性。
- 时序支路使用SlowFast网络提取高层视频动态特征,捕捉帧间的运动模式和时序一致性。
- 光流支路使用RAFT估计连续帧间的光流,显式编码相机诱导的运动信息,这是CWQA区别于通用VQA方法的核心设计。
- 三个支路的特征分别通过投影MLP映射到公共特征空间,然后经过分支门控网络自适应加权融合。门控机制允许模型根据输入视频的特点动态调整各支路的贡献。
- 融合后的特征输入质量回归头预测分数,对多个采样位置的预测取平均得到视频级质量分数。
- CWQA以SimpleVQA为初始化基线,在其基础上扩展了光流支路和门控融合机制。
逐图理解论文
失败案例与直觉
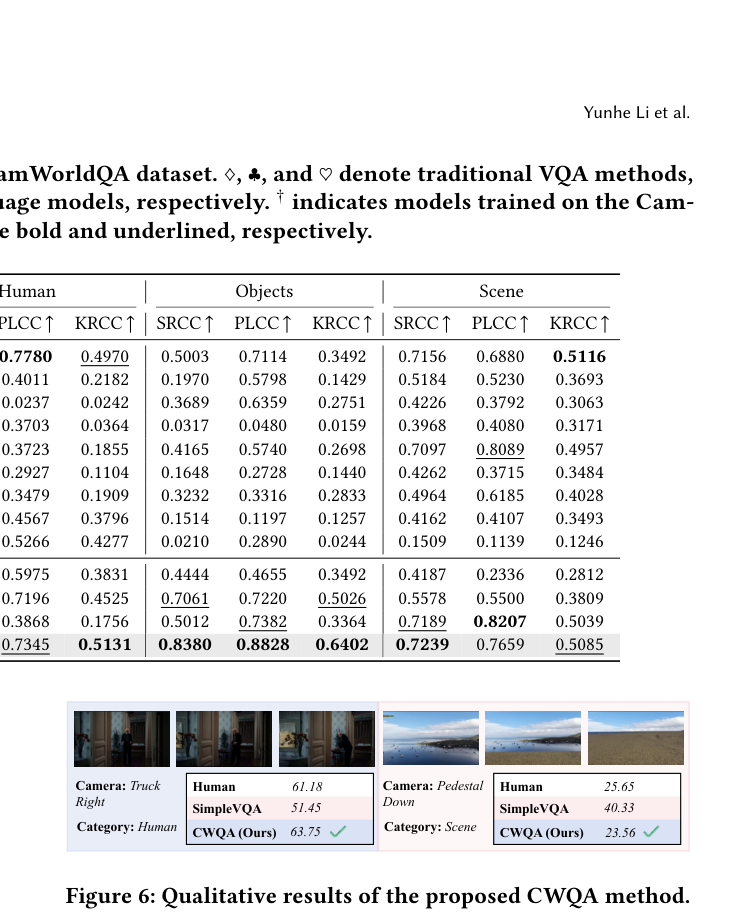
想象一下:你给模型一段静止的街景视频,让它模拟镜头向左平移。结果画面里建筑物的透视关系扭曲了,行人突然消失又出现,镜头运动还一顿一顿的。这些瑕疵在通用视频质量评估里可能根本不会被注意到,因为通用方法关心的是画面清晰不清晰、色彩好不好看,而不是视点变换是否合理、运动是否连贯。
研究空白
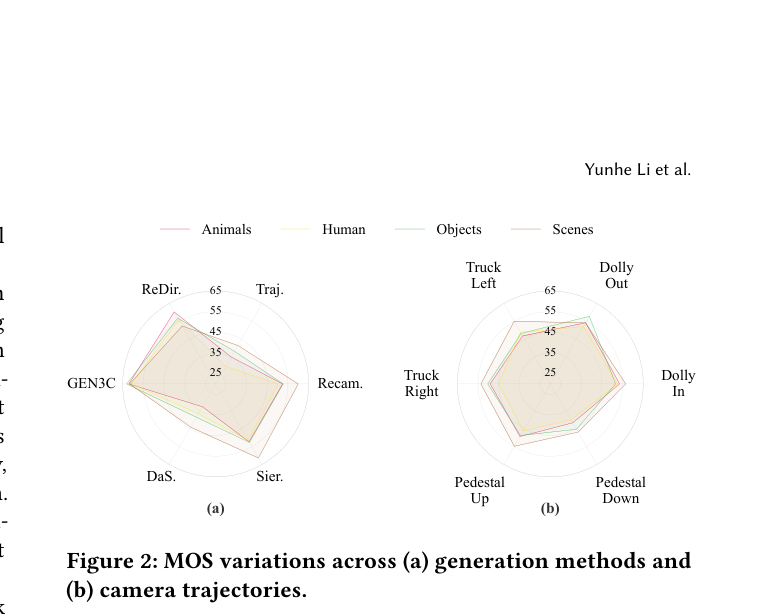
该图展示MOS在不同生成方法和相机轨迹上的变化。注意生成方法之间的MOS差异明显大于轨迹之间的差异,说明生成方法的选择对质量影响更大。
论文贡献
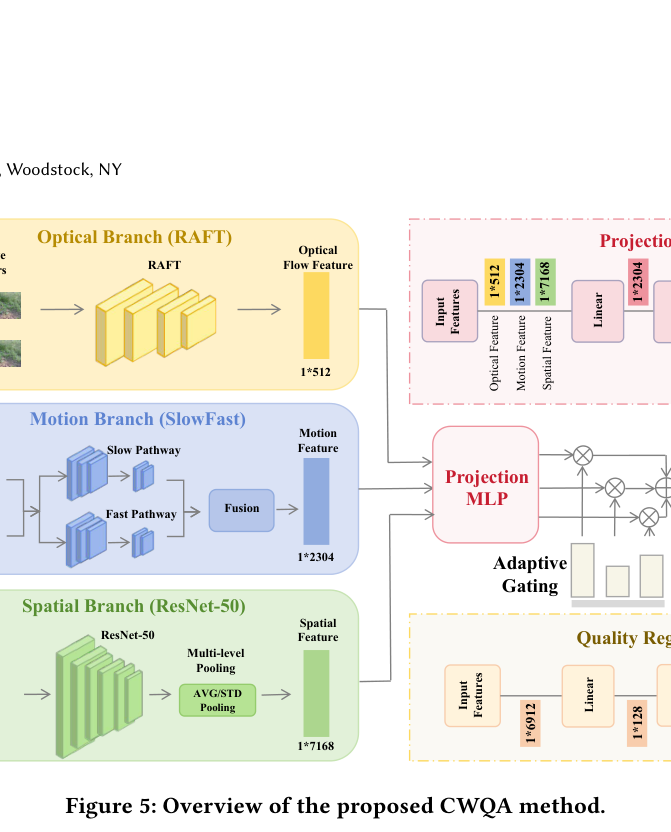
该图展示CWQA的三支路架构,包括空间支路、时序支路和光流支路,以及分支门控融合机制。重点观察光流支路如何显式编码运动信息。
验证与证据
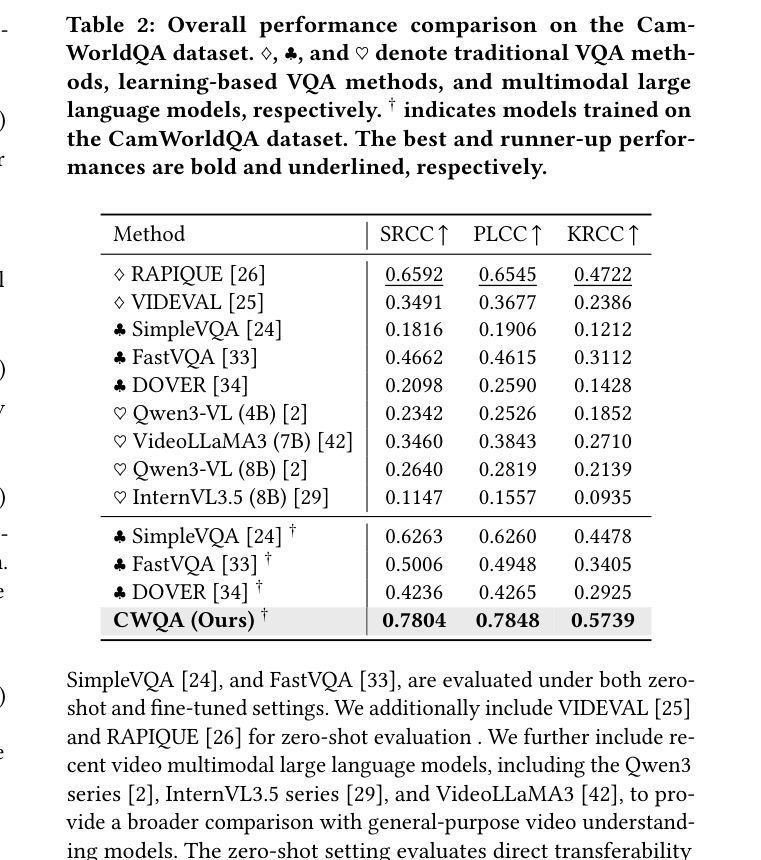
该表展示CWQA与所有基线方法的整体性能对比。注意CWQA在SRCC、PLCC、KRCC三个指标上均取得最优,且与最佳基线的差距明显。
实验如何设计?
- CamWorldQA数据集包含20个源视频,每个源视频对应6条基础相机轨迹(dolly in/out、truck left/right、pedestal up/down),由6种生成方法生成,共720个视频。
- 主观评分由18名评分者完成,采用MOS作为质量标签。
- 训练/测试按8:2比例划分,对比方法包括传统VQA(RAPIQUE、VIDEVAL)、学习型VQA(SimpleVQA、FastVQA、DOVER)以及多模态大模型(Qwen3-VL、VideoLLaMA3、InternVL3.5)。
- 评估指标包括SRCC、PLCC和KRCC,分别衡量排序一致性、线性相关性和秩相关性。
- 消融实验分别去除空间支路、时序支路和光流支路,验证各支路的贡献。
关键结果与论文证据
- CWQA在CamWorldQA上取得SRCC=0.7804、PLCC=0.7848、KRCC=0.5739,全面优于所有对比方法,最佳基线RAPIQUE的SRCC仅为0.6592(第5页)。
- 消融实验显示,去除光流支路导致SRCC从0.7804骤降至0.6263,是所有支路中贡献最大的(第6页)。
- 去除时序支路后SRCC降至0.7248,去除空间支路后SRCC降至0.7572,表明三支路各有贡献但光流支路最为关键(第6页)。
- 按内容类别分析,CWQA在Animals类别SRCC=0.8601、Objects类别SRCC=0.8380,四个类别均取得最优(第6页)。
- 零样本多模态大模型表现极差,InternVL3.5的SRCC仅为0.1147,说明直接使用MLLM评估该任务不可行(第5页)。
- 六种生成方法的MOS分两档:GEN3C(61.88)、ReDirector(56.31)、SierpinskiCam(54.49)、ReCamMaster(53.84)高于Diffusion as Shader(38.07)和TrajectoryCrafter(36.15)(第3页)。
阅读时需要注意
- 数据集规模有限,仅720个视频和18名评分者,源视频仅20个且均为近静态相机场景,泛化性有待验证。
- CWQA依赖预训练骨干(ResNet-50、SlowFast、RAFT)且骨干冻结,未进行端到端联合优化,可能限制性能上限。
- 仅覆盖6条基础相机轨迹,未涉及旋转、变焦等更复杂的相机运动类型。
- 训练/测试按生成视频级别划分,同一源视频的生成结果可能同时出现在训练和测试集,存在内容泄漏风险。
关联工作
- ReCamMaster是相机控制生成的代表性方法之一,也是CamWorldQA数据集的生成模型来源。
- TrajectoryCrafter基于深度先验实现单目视频的相机轨迹重定向,在MOS排名中垫底,说明其生成质量存在明显短板。
- GEN3C是3D感知的世界一致视频生成方法,在CamWorldQA的MOS排名中位列第一,表明3D感知有助于提升相机控制生成质量。
- SimpleVQA是CWQA的初始化基线和主要对比学习型VQA方法,CWQA在其基础上扩展了光流支路。
- RAPIQUE是零样本最佳基线,结合手工特征与深度特征,但在相机控制生成场景下仍与CWQA存在明显差距。