快速导读:提出S3D8 2.7比特权重格式与基于模型自生成数据的QAT蒸馏管线,将Llama 3.2 11B Vision压缩至3.7GB并在Arm CPU上高效推理。
Llama-Mobile 的核心问题是:视觉语言模型(VLM)要在移动端部署,内存与计算需求是硬约束,而激进的低比特量化又容易让模型性能崩坏。论文给出的答案是 S3D8——一种 2.68 bpp 的权重格式,配合完全基于模型自生成数据的 QAT 蒸馏管线,将 Llama 3.2 11B Vision Instruct 压缩到约 3.7 GB,并在 Arm CPU 上实现可用的推理速度。
这篇工作的独特之处在于它把量化格式设计和硬件解码路径当作同一个问题来处理。S3D8 不是单纯追求理论上的压缩率,而是让解码过程恰好落在 Arm 64-entry TBL 查表指令和 5 条 SIMD 逻辑指令的舒适区内。这种硬件协同设计的思路,是它区别于一般 PTQ 或 QAT 工作的关键。
英文题目:Llama-Mobile: Efficient 2.7-Bit Quantization of VLMs
论文出处:arXiv 每日论文精选 · arXiv:2608.21134
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLM 的参数量通常在 10B 级别,bfloat16 存储需要 20 GB 以上,远超移动设备内存。直接 casting 到 3.5 bpp 以下会导致严重的性能退化,这一点在论文 Figure 1 中非常直观:性能曲线在低比特区急剧下跌。
现有 PTQ 方法如 GPTQ 在 4-bit 以上表现尚可,但在 sub-3-bit 区间效果有限。QAT 更有效,但传统上依赖原始训练数据,而实际部署场景中往往拿不到这些数据。
论文指出的研究空白是:VLM 量化缺乏通用的合成数据方案,同时现有权重格式没有针对 Arm CPU 的 SIMD 解码路径进行协同设计。这两个问题必须一起解决,否则要么精度崩坏,要么解码开销吃掉压缩带来的带宽收益。
核心创新
- 提出S3D8格式:每3个权重共享5-bit质心索引与3个符号位,2.68 bpp,针对Arm 64-entry TBL查表与SIMD解码路径协同设计
- 提出无需原始训练数据的多模态QAT管线:用模型自身在ImageNet+随机提示上生成蒸馏目标
- 随机提示采样策略(模板、指令块、长度约束等)提升合成数据多样性,避免过拟合下游任务
- 提供Linux与Android上完整Arm CPU VLM推理实现,含融合反量化-矩阵乘kernel
方法概览
使用ImageNet图像与随机采样提示,由bfloat16教师模型生成响应构建合成多模态数据集;以KL散度蒸馏训练量化学生模型;权重采用S3D8格式(3权重共享5-bit质心索引+3个符号位,共8 bits),通过Arm TBL查表与5条SIMD逻辑指令解码为INT8。
- S3D8 格式:从 bfloat16 权重出发,按输出通道取绝对最大值作为 scale,缩放后先得到 channel-INT8 计算格式;再进一步压缩,提取符号位,将绝对值映射到 32 个质心之一,用 5-bit 索引存储。每 3 个权重共享 3 个符号位,总计 8 bits,即 2.68 bpp。
- 质心训练:32 个质心在单位正态分布的绝对值上训练,3 个符号位将同一组质心反射到 8 个 orthant 中,形成对称的码本结构。
- 合成数据管线:使用 ImageNet 图像与随机采样提示,由 bfloat16 教师模型生成响应,构建多模态蒸馏数据集。随机提示采样包含模板、指令块、长度约束等策略,目的是提升数据多样性,避免学生模型过拟合特定下游任务。
- QAT 训练:以 KL 散度作为蒸馏损失,用 straight-through estimator 处理量化不可导问题,训练量化学生模型。
- 解码路径:S3D8 位打包存储后,解码需要 5 条 SIMD 逻辑指令生成索引,再执行 3 次 TBL 查表,解码 48 个元素。channel scale 在累加之后应用,形成融合的反量化-矩阵乘 kernel。
- 实现覆盖:论文提供了 Linux 与 Android 上完整的 Arm CPU VLM 推理实现,包括融合 kernel 与端到端部署。
逐图理解论文
失败案例:低比特量化的崩坏
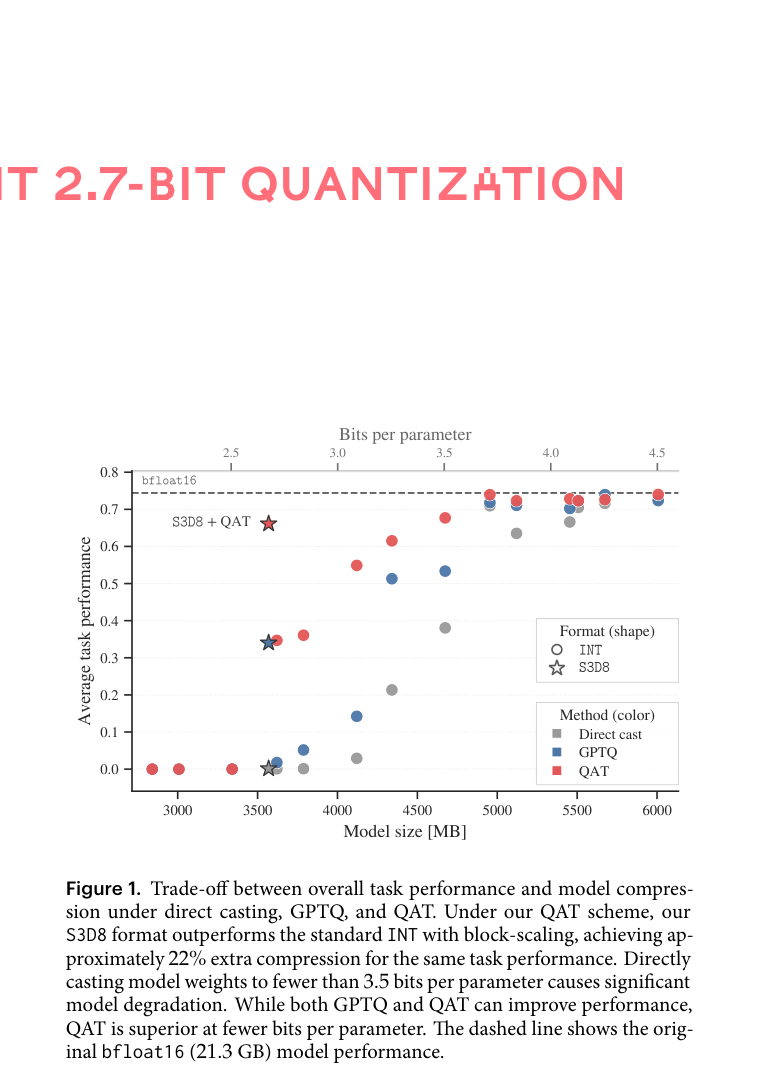
这张图是全文的核心论据:横轴是每参数量化比特数,纵轴是平均任务性能。重点看 2.7 bpp 附近,S3D8+QAT 的性能远高于同尺寸的 INT 格式,而 direct casting 在 3.5 bpp 以下已经崩坏。虚线是 bfloat16 基线,S3D8 与它的差距明显小于其他格式。
研究空白:数据与格式的双重困境
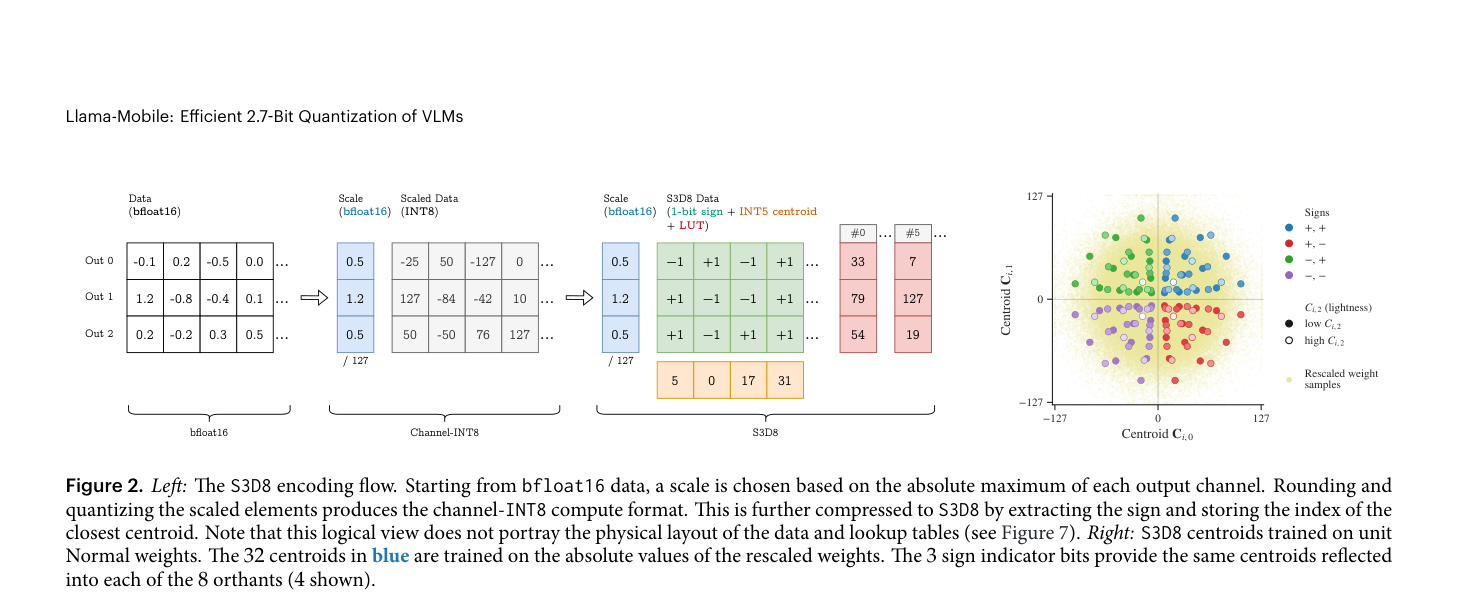
左图展示 S3D8 的编码流程:从 bfloat16 出发,按输出通道缩放得到 INT8 计算格式,再提取符号并映射到最近质心。右图展示 32 个质心在单位正态分布上的分布,3 个符号位将质心反射到 8 个 orthant。这张图帮助理解为什么 S3D8 能用 8 bits 存 3 个权重。
格式对比与硬件验证
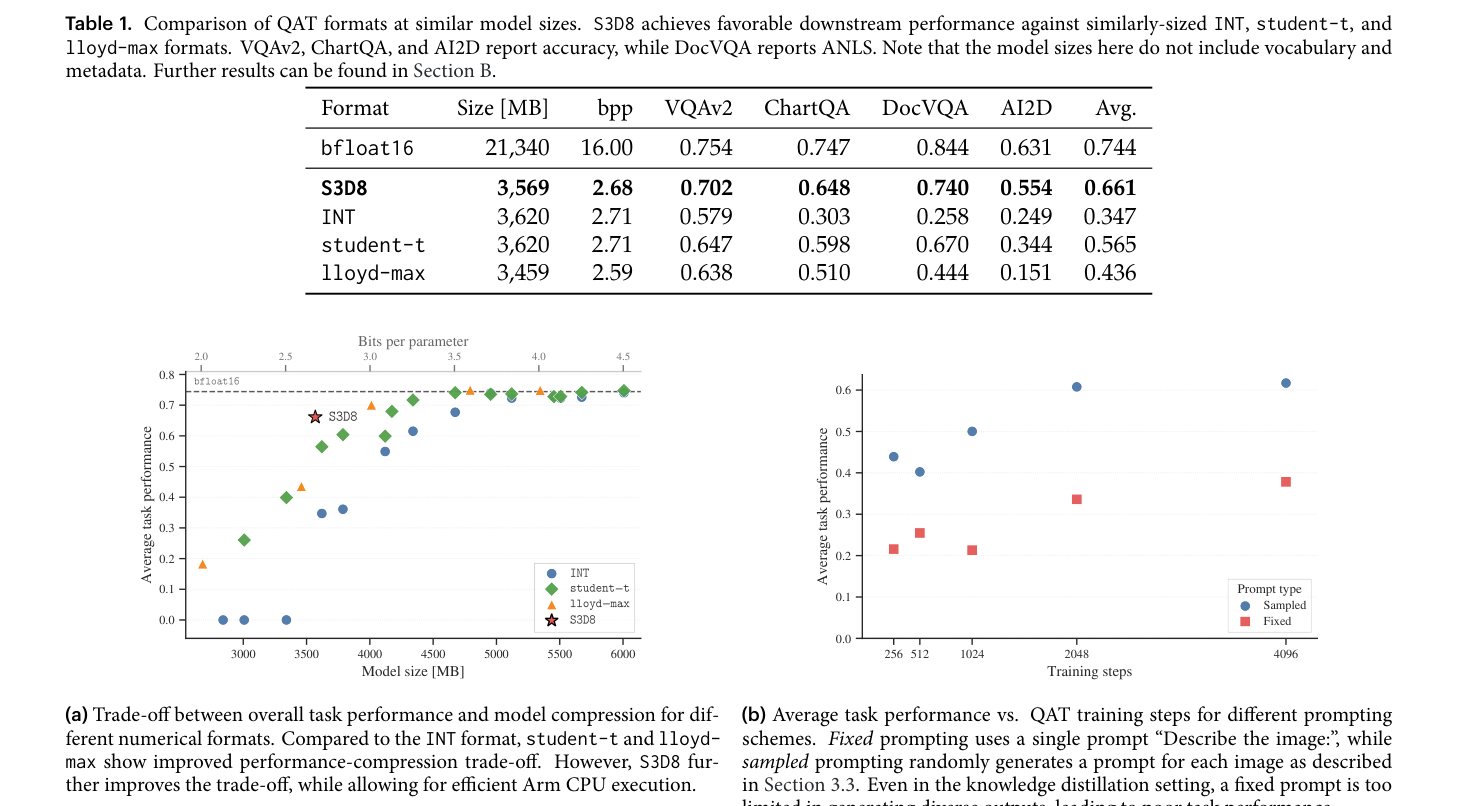
在相近模型尺寸下,S3D8 的 QAT 结果显著优于 INT、student-t 和 lloyd-max 三种标量格式。更关键的是硬件验证:在 Pixel 8a 上,S3D8 的反量化耗时比 INT8 拷贝还低,因为读取的数据量只有三分之一;融合的矩阵乘 kernel 吞吐也超过了 INT8。这说明格式设计和解码路径的协同确实生效了。
实验如何设计?
- 主实验在 Llama 3.2 11B Vision Instruct 上进行,对比 direct casting、GPTQ、QAT 三种量化流程。
- 格式对比:在相近模型尺寸下,对比 S3D8 与 INT、student-t、lloyd-max 三种标量量化格式的 QAT 结果。
- GPTQ 缩放消融:absmax 与 affine 两种参数化,K∈{4,6,8,12,16},group size∈{32,64,128}。
- QAT 层保持消融:语言模型输出投影(OP)与视觉编码器(VE)分别或同时保持 INT8,观察性能变化。
- 硬件基准:在 Pixel 8a(1 核与 5 核)和 Graviton4(96 核)上测量 S3D8→INT8 反量化带宽与矩阵乘吞吐,以及端到端解码 token/s。
关键结果与论文证据
- S3D8 QAT 在 2.68 bpp 下平均任务性能 0.661,相比 bfloat16 的 0.744 仅下降 0.083,显著优于同尺寸的 INT(0.347)、student-t(0.565)和 lloyd-max(0.436),见 Table 1(第 4 页)。
- 在约 2.7 bpp 时,S3D8+GPTQ 平均性能 0.340,而同速率 INT+GPTQ 仅 0.018,说明格式本身在低比特下保留了更多信息(第 4 页)。
- 训练 KL 损失与平均任务性能的 Spearman 相关系数为 -0.91,说明蒸馏目标与下游性能强相关(第 9 页)。
- QAT 消融显示:全 S3D8 平均 0.661;OP 保持 INT8 仍为 0.661;VE 保持 INT8 为 0.666;OP+VE 保持 INT8 为 0.667,说明瓶颈不在这些层(第 10 页)。
- Pixel 8a 5 核上,S3D8 反量化耗时 133μs(16.5 GB/s 读带宽),低于 INT8 copy 的 310μs,因为 S3D8 读取的数据量只有 INT8 的三分之一(第 4 页)。
- Pixel 8a 5 核矩阵乘(1,4096,14336):S3D8 融合 kernel 达 33.8 GMAC/s,超过 INT8 的 26.5 和 bfloat16 的 13.6(第 5 页)。
- 端到端解码:Pixel 8a 上 S3D8 为 3.8 tokens/s;Graviton4 上 S3D8 为 36.8 tokens/s,对比 INT8 的 26.4 tokens/s(第 5 页)。
- GPTQ 缩放消融显示 affine 参数化在低比特率下优于 absmax,而 absmax 在高比特率下持平或略优(第 8 页)。
阅读时需要注意
- 实验仅覆盖单一模型 Llama 3.2 11B Vision Instruct,泛化性未验证。
- S3D8 依赖 Arm 优化的 64-entry TBL 查表解码器,其他硬件架构需要专用 kernel 才能发挥优势。
- 评估仅使用 VQA 类基准的小型子集,缺乏更广泛的任务覆盖。
- 所有层使用统一量化格式,未探索混合精度方案。
- 提示与图像选择策略可能仍有优化空间。
关联工作
- GPTQ 作为强 PTQ 基线被对比,本文实现了覆盖 VLM 全部线性层的自定义 GPTQ。
- LLM-QAT 是数据无关的 QAT 方法,但未直接适用于多模态场景,本文将其扩展至 VLM。
- Gope et al. 探索了 Arm CPU 上的权重布局、码本与 SIMD kernel,llama.cpp 中有实现;本文采用类似技术但使用向量格式。
- Sherry 是 SIMD 友好的 1.25-bit 三值量化格式,代表极端低比特硬件协同设计方向。
- MXFP 与 NVFP4 是硬件协同设计的块浮点格式,DeepSeek V3 则将块缩放格式适配 GEMM 硬件 tile 尺寸。