快速导读:StateSight 是一个程序化生成的基准,通过三个受控空间重建任务(立方体展开图、遮挡方块塔、4邻域连通分量)评估视觉语言模型从单张图像恢复潜在空间状态的能力。
StateSight 的核心主张是:现有视觉语言模型基准把感知、OCR、领域知识和语言先验与空间推理混在一起,导致我们无法判断模型到底是'看懂了空间'还是'猜对了答案'。StateSight 通过程序化生成的三类任务——立方体展开图、遮挡方块塔、4邻域连通分量——把问题收窄到一个可验证的单一能力上:从单张图像重建生成该图像的潜在空间状态。
这篇论文的贡献不在于又报告了几个准确率数字,而在于它建立了一套可归因的诊断框架。因为生成器、渲染器、答案 oracle 和评分协议全部固定,模型每错一题,研究者都可以回到生成器的符号状态去定位失败发生在哪一步。
英文题目:StateSight: Benchmarking Latent Spatial-State Reconstruction in Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2608.20414
原始论文:PDF / 论文页面
这篇论文解决什么问题?
CLEVR 和 GQA 已经证明,用生成器控制数据可以暴露模型的组合推理弱点。BLINK 进一步显示,多模态大模型在人类觉得微不足道的核心视觉感知任务上表现糟糕。Mind the Gap 则在空间关系、导航和心理旋转等任务上发现了类似的人机差距。这些工作共同指向一个怀疑:模型可能从未真正构建起解决空间问题所需的内部结构。
但现有基准的问题在于,它们把太多能力搅在一起。一道题答错,可能是没看清图,可能是 OCR 出错,可能是领域知识缺失,也可能是语言先验压过了视觉证据。StateSight 的出发点就是把这个混杂拆开:如果渲染风格、答案类型、目标关系全部固定,那么剩下的变量就只有模型的空间重建能力本身。
StateSight 选择的三类任务各有针对性。立方体展开图考验平面到三维的面对应关系;遮挡方块塔考验从可见表面推断隐藏占位;连通分量考验对邻接拓扑的全局计数。三者共享同一个受控渲染风格,但分别指向空间推理的不同子能力。
核心创新
- 提出 StateSight 基准,固定完整数据生成过程(渲染风格、答案类型、目标关系、oracle 状态),实现条目级重建误差的直接分析
- 引入 StateSight-Steps 伴随数据集,提供生成器定义的确定性中间视觉状态,支持未来中间视觉监督实验
- 结合 30 人人类基线、可见推导分析和条目级人机难度分类,区分格式正确性与真实空间重建能力
方法概览
StateSight 包含 900 个程序化生成条目,均匀分布于三个任务族:立方体展开图对面推理、遮挡方块塔计数、4邻域连通分量计数。每个任务族定义潜在状态空间、渲染器、答案 oracle、提示模板和解析器,采用 exact-match 评分。另含 StateSight-Steps 伴随数据集,提供 3,600 张确定性中间视觉状态图像。
- 每个任务族都定义了完整的潜在状态空间、渲染器、答案 oracle、提示模板和解析器。这意味着每道题的正确答案不是人工标注的,而是从生成器的符号状态确定性计算出来的,消除了标注噪声。
- 评分采用 exact-match,即模型输出必须与 oracle 标签完全一致才算正确。这个选择刻意严格,因为对于计数类任务,接近正确往往意味着推理过程已经出错。
- StateSight 包含 900 个条目,三个任务族各 300 条,均匀分布。这个规模足以给出稳定的准确率估计,同时保持每个任务族的内部一致性。
- StateSight-Steps 是伴随数据集,提供 3,600 张生成器定义的确定性中间视觉状态图像。每张中间状态都对应同一个符号实例的某个生成步骤,因此可以被独立检查。这个设计直接回应了 MIRA 关于中间图像对推理必要性的发现。
- 人类基线采用 30 名成人参与者,每人完成 60 条目(每任务 20 条),使用与模型完全相同的 exact-match 协议。虽然样本量远小于模型评估,但它提供了一个描述性的参照点。
- 可见推导分析在每任务 30 条的匹配子集上进行,要求模型同时返回答案、推导和解释。研究者随后对 180 条响应进行错误编码,区分错误图像重建、错误推理程序、混合错误和虚构视觉事实。
逐图理解论文
一个具体失败
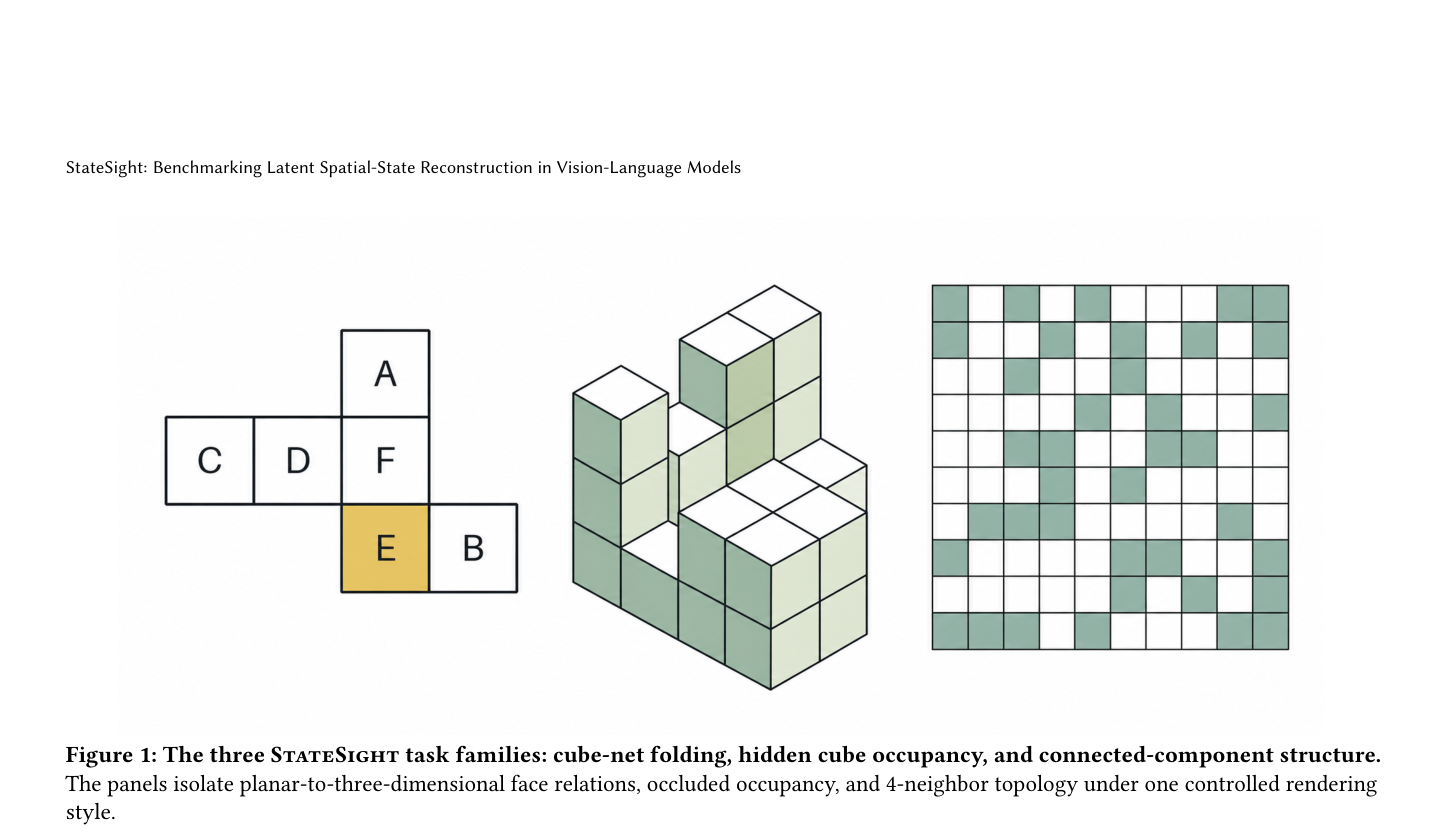
这张图展示三个任务族的视觉样式。注意它们共享同一渲染风格,但分别隔离了平面到三维的面对应、遮挡占位和邻接拓扑。观察时应该关注每个任务族如何把'潜在状态'映射为可见图像。
最强结论
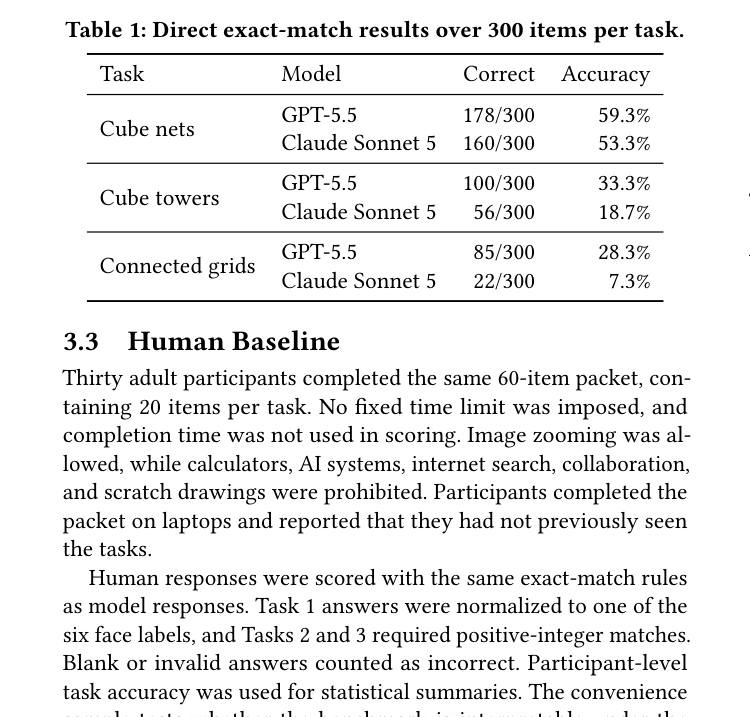
两个前沿模型在三个任务上全部远低于人类基线,而且失败的主要模式是错误图像重建而非推理错误。这说明问题不在'想不清楚',而在'看不明白'。模型在把像素转化为空间状态这一步就已经丢失了关键信息。
Figure 2: Four generator-defined intermediate visual states from one StateSight-Steps example
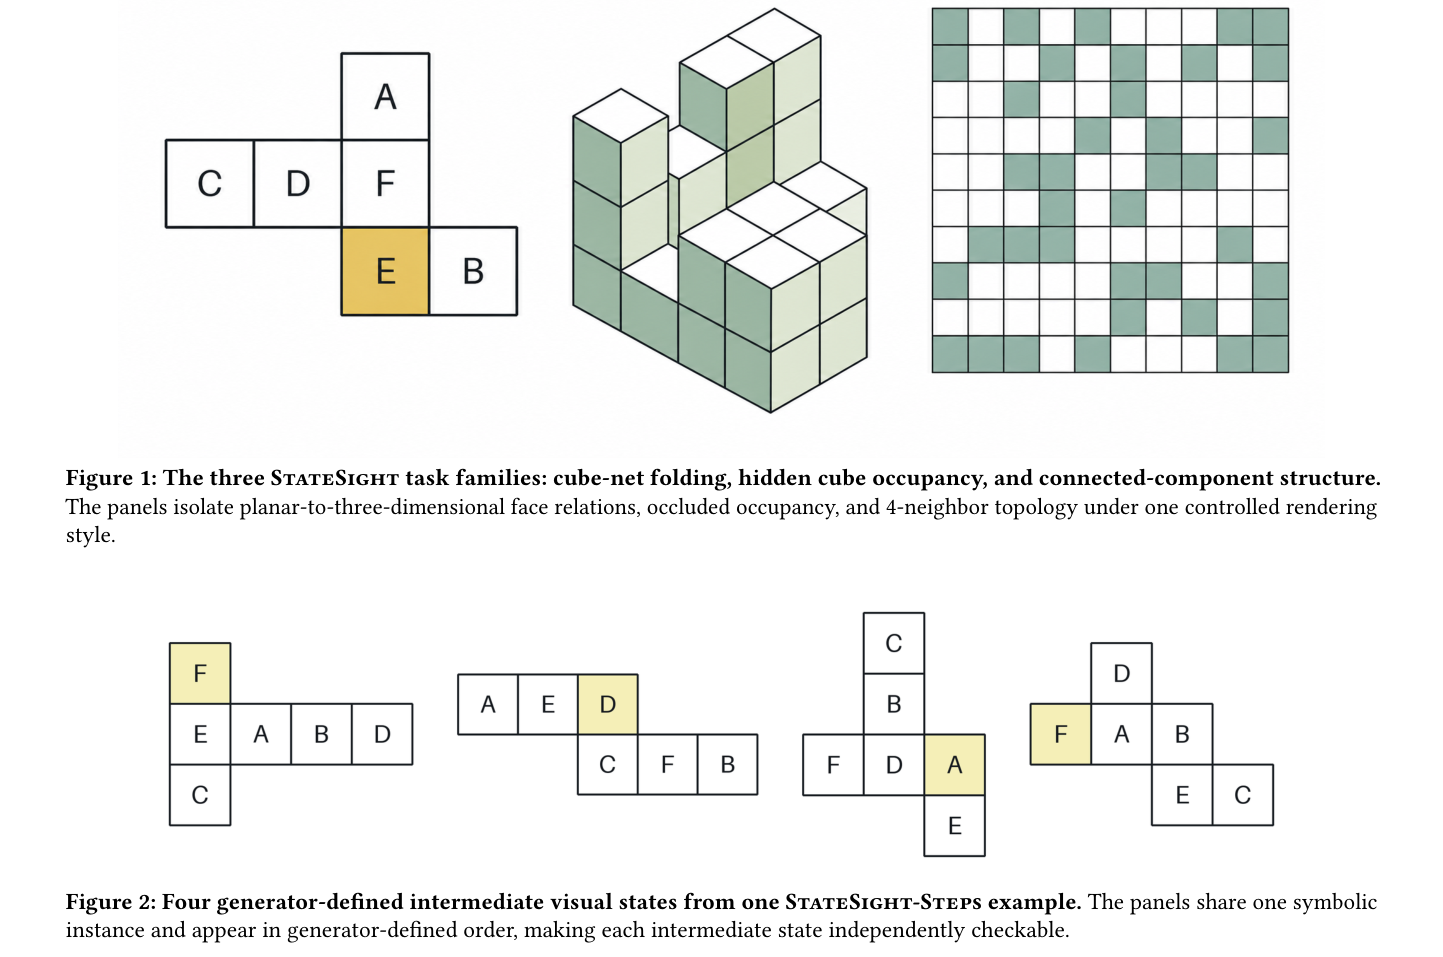
四个中间视觉状态来自同一个符号实例,按生成器定义的顺序排列。这张图说明 StateSight-Steps 的每个中间状态都可以独立检查,为未来的中间监督实验提供了确定性素材。
实验如何设计?
- 直接评估:GPT-5.5 与 Claude Sonnet 5 在三个任务族各 300 条目上做 answer-only 测试,这是主实验。
- 人类基线:30 名成人完成 60 条目的相同 exact-match 协议,用于人机差距的描述性比较。
- 可见推导分析:在每任务 30 条的匹配子集上要求模型输出答案、推导和解释,随后进行错误类别编码。
- 条目级分析:将 60 条人类子集按人类难度与模型结果交叉分类,识别'人类容易但模型失败'的条目类型。
- 不确定性报告:对 300 条目直接评估结果给出 Wilson 置信区间和 bootstrap 重采样区间,避免把点估计当成确定结论。
关键结果与论文证据
- GPT-5.5 的直接评估准确率在三个任务上分别为 59.3%、33.3% 和 28.3%,Claude Sonnet 5 为 53.3%、18.7% 和 7.3%(第 4 页)。两个模型都远未达到可靠空间推理的水平。
- 人类基线平均准确率为 80.8%、68.8% 和 64.3%(第 4 页)。即使是最强的模型在连通网格任务上也与人类有超过 35 个百分点的差距。
- GPT-5.5 与 Claude Sonnet 5 的配对差异为 +6.0、+14.7、+21.0 个百分点,bootstrap 区间均排除零(第 4 页)。这说明模型间的差距在任务难度增加时被放大。
- 在 180 条可见推导响应中,72 条被编码为错误图像重建,41 条为错误推理程序,只有 64 条完全正确(第 4 页)。错误图像重建是最主要的失败模式,说明模型在'看到'空间结构这一步就已经出错。
- 可见推导条件下 GPT-5.5 的准确率为 50.0%、30.0%、23.3%,Claude Sonnet 5 为 63.3%、16.7%、30.0%(第 4 页)。由于样本量和提示不同,这些数字不能与直接条件做统计比较,但提示了推导过程本身可能引入新的错误。
- 所有最终直接运行零格式错误(第 4 页)。这意味着模型的失败不是输出格式问题,而是实质性的空间推理失败。
- 条目级分析显示,人类与模型的失败模式并不完全重叠。存在一类条目人类觉得容易但模型系统性失败,这指向模型在特定空间子能力上的结构性缺陷,而非随机噪声。
阅读时需要注意
- 仅评估了两个专有模型,缺乏开源模型覆盖,结论的普适性受限。
- 人类基线是便利样本且条目数远少于模型评估,人机差距只能作为描述性比较,不能做统计推断。
- 三个任务族刻意窄化且使用生成图像,结论不能推广到自然图像中的空间推理。
- 可见推导响应不等同于隐藏的 chain-of-thought,不能作为模型内部因果过程的证据。
- StateSight-Steps 尚未通过实验验证其对性能的改善,目前只是一个未经验证的资源。
关联工作
- CLEVR 确立了生成器控制数据在诊断组合视觉推理中的价值,StateSight 继承了这一方法论但把焦点收窄到空间状态重建。
- MIRA 研究了中间图像对推理的必要性,直接启发了 StateSight-Steps 的设计。
- SpatialSense 和 Visual Spatial Reasoning 提供了自然图像上的空间关系测试,可以作为 StateSight 结论的外部验证。
- SugarCrepe 检查组合基准中的捷径,可用于验证 StateSight 的失败是否超出了受控渲染域。