快速导读:CFD 提出了一种边缘-云协同的长视频理解框架,通过离线构建双轨叙事索引(事件骨架与片段日志)和在线基于 Visual-Need Router 的按需帧检索,在显著降低视觉计算成本的同时保持竞争性准确率。
长视频理解在边缘设备上面临严格的计算和带宽预算约束。现有方法要么通过帧采样压缩视觉输入但丢失时间结构,要么依赖纯文本记忆但丧失细粒度视觉证据。CFD 框架通过边缘-云协同架构,将离线叙事索引与在线按需视觉验证分离,解决了这一视觉-文本二元性困境。
该框架的核心贡献在于提出 Visual-Need Router 门控模块,将视觉访问转化为显式的、查询条件化的成本。通过离线构建事件级故事骨架和片段级微观日志的双轨叙事索引,结合固定容量的视觉工作记忆,CFD 在 Video-MME 和 InfiniBench 基准上以极低的平均帧数实现了竞争性准确率。
英文题目:Caption-once, Frames-on-Demand: Visual-Need Routing for Budget-Aware Agentic Long Video Understanding
论文出处:arXiv 每日论文精选 · arXiv:2609.11899
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长视频理解的核心挑战在于如何在有限预算下同时保持时间结构完整性和视觉细节准确性。视觉压缩方法如帧采样或 token 压缩虽然减少了输入规模,但在长视频上容易丢失关键时间覆盖。文本转换方法将视频转化为语言记忆,提升了可扩展性,但无法保留颜色、文字等属性级感知证据。
现有智能体系统如 VideoLucy 和 VideoAgent 通常在查询时重新生成描述或密集回访原始帧,导致计算成本随交互深度增加。这种在线重新字幕化机制在边缘设备上不可行,因为每次查询都需要额外的视觉处理开销。
作者观察到语言记忆在承载长程时间结构方面优于密集帧,而像素对于属性级感知至关重要。这一视觉-文本二元性表明,理想系统应该能够根据查询类型动态选择推理路径,而非采用固定的视觉输入策略。
边缘-云分离架构为此提供了可能:边缘设备负责一次性的离线索引构建,云端负责查询时的推理和按需视觉验证。这种解耦设计将视觉成本从交互深度中解耦出来,使其成为可显式控制的超参数。
核心创新
- Visual-Need Router:一个基于查询类型的门控模块,将视觉访问转化为显式的、查询条件化的成本,仅在感知类问题(如外观、屏幕文字)触发帧检索,而在时间结构类问题中保持纯文本推理。
- Caption-once, Frames-on-Demand 框架:结合可复用的双轨叙事索引与固定容量的 FIFO 视觉工作记忆,将每查询的视觉成本暴露为显式超参数,而非交互深度的隐含结果。
- 离线-在线解耦:所有文本记忆在离线单次索引中生成并缓存,查询时仅通过纯文本操作组合缓存的描述,避免了在线重新字幕化(re-captioning)的视觉成本。
方法概览
CFD 框架包含三个部分:(1) 三层边缘-云记忆架构:离线生成事件级故事骨架(Event Memory)和片段级微观日志(Clip Memory),并维护一个固定容量的视觉工作记忆(Visual Working Memory);(2) 四个智能体角色:Captioning Agent(离线)、Answering Agent、Localization Agent 和 Visual-Need Router;(3) Story-First 推理循环:首先尝试基于事件记忆回答,若置信度不足则定位相关事件并注入片段细节,最后由 Router 决定是否需要提取原始帧进行多模态重推理。
- 三层边缘-云记忆架构:离线生成事件级故事骨架(Event Memory)和片段级微观日志(Clip Memory),并维护固定容量的视觉工作记忆(Visual Working Memory)作为 FIFO 队列存储原始帧。
- 四个智能体角色分工:Captioning Agent 负责离线单次字幕化,Answering Agent 执行 Story-First 推理循环,Localization Agent 定位相关事件,Visual-Need Router 决定是否需要提取原始帧。
- Story-First 推理循环:首先尝试基于事件记忆回答,若置信度不足则定位相关事件并注入片段细节,最后由 Router 决定是否需要多模态重推理。这种渐进式深入机制避免了不必要的视觉访问。
- Visual-Need Router 实现为基于查询类型的门控模块,将视觉访问转化为显式的、查询条件化的成本。仅在感知类问题(如外观、屏幕文字)触发帧检索,在时间结构类问题中保持纯文本推理。
- 双轨叙事索引设计:事件级骨架提供离散的时间结构记录,片段级日志保留微观动作细节。两者在离线单次索引中生成并缓存,查询时仅通过纯文本操作组合,避免在线重新字幕化。
- 固定容量视觉工作记忆:采用 FIFO 策略管理原始帧,将每查询的视觉成本暴露为显式超参数。这种设计使视觉预算成为可预测、可控制的系统参数,而非交互深度的隐含结果。
- 离线-在线解耦机制:所有文本记忆在离线单次索引中生成并缓存,查询时仅通过纯文本操作组合缓存的描述。这种设计彻底避免了在线重新字幕化的视觉成本,使系统适合边缘部署。
- 查询条件化路由策略:Router 根据查询类型动态决定视觉访问,将视觉成本从全局固定值转变为查询相关的显式成本。这种细粒度控制使系统能够在不同查询类型间优化准确性-效率权衡。
逐图理解论文
核心贡献
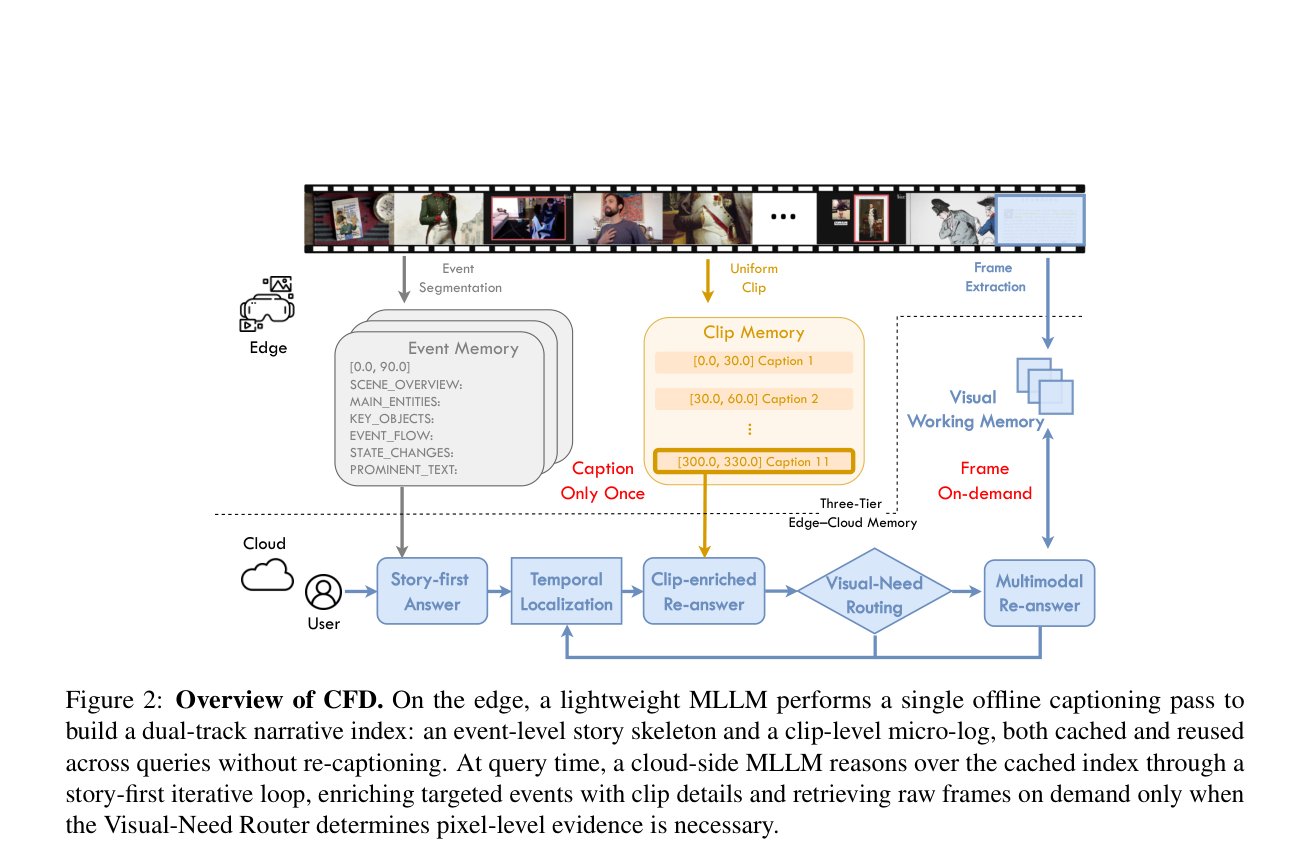
CFD 框架总览图,展示边缘-云协同架构。重点检查双轨叙事索引的构建过程、Story-First 推理循环的渐进式深入机制,以及 Visual-Need Router 在推理流程中的门控位置。
实验验证
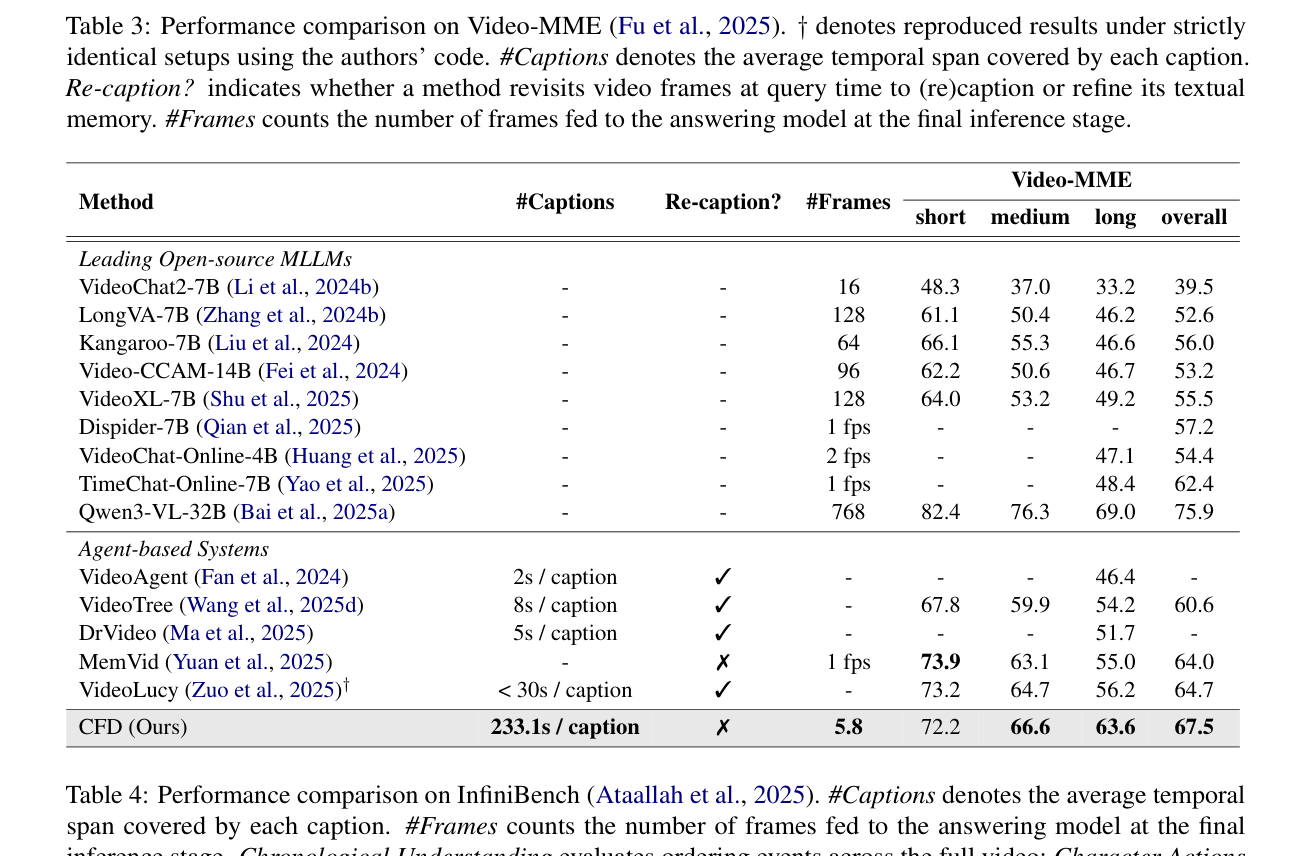
Video-MME 性能对比表,关注 #Frames 列和 Re-caption? 列。理解 CFD 如何以极低的帧数实现竞争性准确率,以及避免在线重新字幕化如何降低系统复杂度。
核心结论
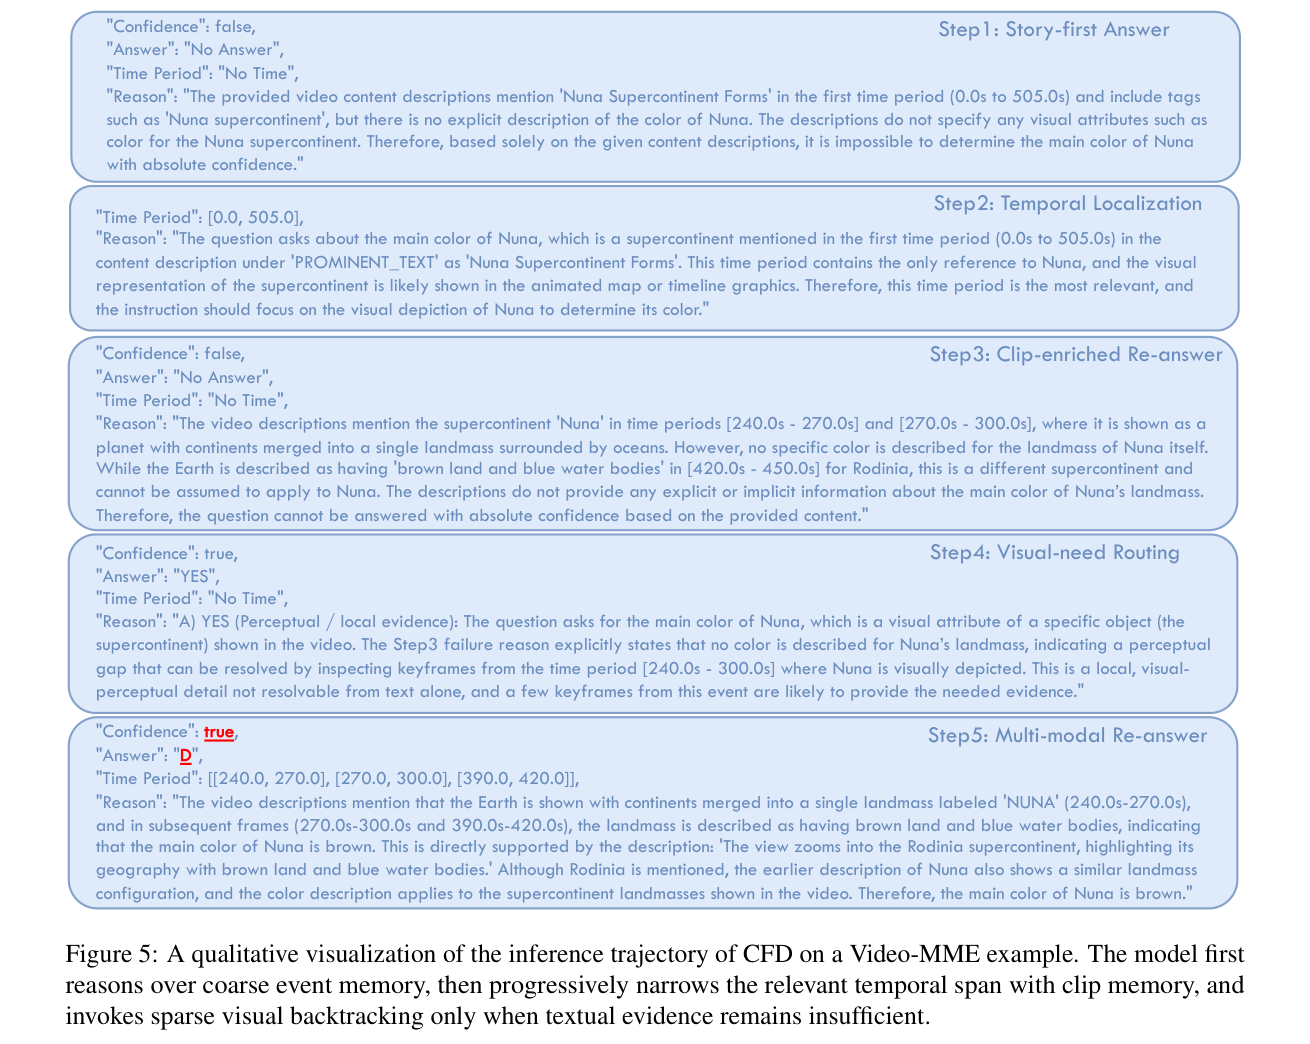
CFD 推理轨迹可视化,展示从粗粒度事件记忆到细粒度片段日志再到稀疏视觉回溯的渐进式深入过程。理解这种推理循环如何避免不必要的视觉访问,以及何时触发视觉回溯。
实验如何设计?
- 在 Video-MME 和 InfiniBench 基准上进行评估,对比开源 MLLM 和基于智能体的系统。Video-MME 包含短、中、长视频,InfiniBench 专注于时间结构理解任务。
- 消融研究分析了事件记忆、片段记忆、推理循环、帧预算和 Router 的贡献。通过逐步移除组件,量化各部分对最终性能的独立影响。
- 分析了不同字幕模型大小(2B, 8B, 32B)和视觉预算(Nfr, Nwm)对性能的影响。这种参数敏感性分析揭示了系统在不同硬件配置下的可扩展性。
- 进行了路由策略对比(无帧、Router、始终帧)和结果 Oracle 分析。Oracle 分析提供了经验上界,帮助理解 Router 决策的理论最优性。
- 在模拟的边缘-云分离环境下测试,使用 H200 GPU 进行离线字幕化和在线推理。成本核算包括离线字幕时间、在线服务时间、缓存内存大小和 GPU 能耗。
- 诊断性重跑实验比较了纯文本证据和按需像素的性能差异。这种配对比较直接验证了视觉回溯在特定任务类型上的边际贡献。
关键结果与论文证据
- CFD 在 Video-MME 上以平均 5.8 帧/问题实现 67.5 整体准确率,相比 Qwen3-VL-32B 的 768 帧/问题实现超过两个数量级的视觉成本降低(第 7 页)。
- 在 InfiniBench 时间顺序理解任务上,CFD 达到 55.10 分,超过 768 帧密集基线 Qwen3-VL 的 48.44 分,验证了事件级叙事骨架在时间结构任务上的优势(第 7 页)。
- Router 将在线帧数从 6.63 降低到 5.76(减少 13.1%),同时准确率从 67.2 提升到 67.5(+0.3 点),证明查询条件化路由在成本-准确性权衡上的有效性(第 9 页)。
- CFD 平均使用比全片段字幕少 66.3% 的片段字幕,表明 Story-First 推理循环能够有效避免不必要的细节注入(第 9 页)。
- 在 OCR 和空间感知任务上,按需像素将准确率从 76.98 提升到 82.73 和从 70.37 提升到 75.93,验证了视觉回溯在属性级感知任务上的必要性(第 20 页)。
- 事件记忆在直接回答模式下已能提供足够的全球语义证据,许多查询无需时间回溯或视觉证据检索即可正确回答(第 19 页)。
- 不同字幕模型大小对性能影响显著,8B 模型在成本-准确性权衡上表现最优,32B 模型虽准确率更高但离线成本增加(第 8 页)。
- 视觉预算设置存在最优区间,过低的帧数导致属性感知性能下降,过高的帧数则浪费计算资源(第 8 页)。
阅读时需要注意
- 框架性能受限于离线字幕质量;如果关键视觉细节未被捕获,纯文本回溯无法恢复。这种信息瓶颈在复杂场景或罕见物体上尤为明显。
- 稀疏视觉回溯可能遗漏短暂线索、小物体或细微运动。FIFO 视觉工作记忆的固定容量限制了系统对长程视觉依赖的处理能力。
- Visual-Need Router 目前是二分类零样本分类器,可能在边界查询上误路由。这种分类器缺乏查询间的上下文感知,可能影响路由决策的一致性。
- “边缘”定义指推理层级分离,而非移动端硬件;默认字幕模型(Qwen3-VL-8B)需要服务器级设备。这限制了框架在真正资源受限设备上的直接适用性。
- 事件分割依赖 TransNetV2,对连续第一人称视频(egocentric)效果不佳。这种分割方法在场景转换不明显的视频上可能产生不准确的事件边界。
关联工作
- VideoLucy (Zuo et al., 2025) 使用分层记忆但在线重新字幕化;CFD 通过缓存双轨记忆避免重新字幕化,将视觉成本从交互深度中解耦。
- VideoAgent (Fan et al., 2024) 密集字幕并回访帧;CFD 通过路由使用更少帧,将视觉访问转化为查询条件化成本。
- MemVid (Yuan et al., 2025) 避免重新字幕化但使用密集 1 fps 采样;CFD 使用按需稀疏帧,进一步降低视觉成本。
- Qwen3-VL (Bai et al., 2025a) 作为基线开源 MLLM 和 CFD 智能体的骨干模型,其 768 帧密集推理代表了准确性上限但成本过高。