快速导读:MiX 把微缩放反过来:每个元素自带相对指数、尾数在小组内共享,再与 MX 权重组合成无乘法器双格式脉动阵列,在约 4.5 bit 有效位宽上对齐或超过 NVFP4,并端到端加速视觉语言模型。
端侧视觉语言模型同时被两堵墙卡住:一边要反复搬运巨大权重,一边要为成千上万高分辨率视觉 token 维护 KV cache。只重量化权重的 W4A16 解不开激活与缓存;只靠 Focus 这类加速器去剪视觉 token,又把未压缩权重留在 FP16 脉动阵列里。Cornell Tech 的 MiX(Micro-Inverted-Scaling)把问题收成一件事:必须把整条 VLM 数据通路压到 sub-8-bit,而且要扛住视觉与文本之间差一个数量级的动态范围。
标准微缩放 MX 与工业格式 NVFP4 都把一块元素挂在同一个共享指数下。视觉离群一出现,共享指数被钉到最大值,周围正常幅度下溢成死区,注意力图直接毁掉——作者称为 microscaling collapse。MiX 把这个范式反过来:每个元素自己存相对指数,尾数在小组里共享。再配上 A-MiX 激活 × W-MX 权重的双格式推理,共享尾数可以从点积里提出去,处理单元变成移位累加而不是乘法器。论文被 MICRO 2026 接收,评测覆盖 Qwen2-VL、LLaVA-OneVision 与 MiniCPM-V。
英文题目:MiX: Micro-Inverted-Scaling for End-to-End Low-Bit Vision-Language Model Acceleration
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-19683.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现代 VLM 的三段式结构——Vision Encoder、Modality Projector、LLM backbone——在 prefill 就把连续视觉 token 和离散文本嵌拼在同一序列里。作者在 OCRBench 发票任务上剖析 Qwen2-VL-7B:图 1 里视觉通道均值 μv=0.312,文本 μt=0.0091,大约 34 倍;视觉 p99 到 2.07,文本只有 0.061。这个入口差距还会在中间注意力矩阵里放大。
图 2 显示两种交叉的离群拓扑:Q 和 K 是贯穿所有 token 的通道向尖峰,而且随层加深;V 则是早期 token 上的横向尖峰。一维块如果沿通道切,Q/K 的通道离群会把共享指数抬上天,背景 token 被量化成零。现有 LLM 量化(AWQ、SmoothQuant、SpinQuant、旋转量化)直接搬过来会遇到多模态阻抗失配:尺度要么裁掉视觉离群,要么让细粒度文本下溢。
加速器侧也有盲区。Focus 与 token-pruning 路线利用视觉冗余跳过激活,但不压缩权重。W4A16 则让 PE 继续养 16-bit 乘法或动态反缩放。MBQ、TLQ、Q-VLM、VEQ 等 VLM PTQ 多半只量化线性层,Table I 标明 projector 与 Vision Encoder / LLM 的 attention BMM(含 KV cache)仍是 FP16,整网无法下放到低比特端侧芯。
NVFP4 用 B=16 加 FP8 块尺度、FP32 张量尺度来换精度,硬件更重。MXFP4+ 把块最大指数改成扩展尾数,AMXFP4 用两个非对称 FP8 尺度,PE 随之变大。MicroScopiQ 从次要元素借比特,却换来不规则数据流和硅上乘法器。端侧要的是:位宽够低、格式扛离群、电路不要乘法器。
核心创新
- 把微缩放反过来:每元素相对指数 + 小组共享尾数,吸收块内极端动态范围,避免共享指数被离群值劫持。
- A-MiX × W-MX 双格式使尾数可因式分解,脉动阵列 PE 用移位累加代替乘法器,输出端单周期融合量化。
- 端到端覆盖视觉编码器、projector 与含 KV cache 的 attention BMM;4.5 bit 对齐或超过 NVFP4,PE 面积效率相对 NVFP4 提高 25%。
方法概览
Micro-Inverted-Scaling (MiX) 把 MX 范式取反:块内共享一份尾数,每个元素只存符号与相对指数差 Δe。Type 1 为 MiX-4.25b(B=32,对标 MXFP4);Type 2 为 MiX-4.5b(四组 b=8 子块独立共享尾数,对标 NVFP4)。自适应双格式把激活编成 A-MiX、权重量成 W-MX,共享尾数从块点积中提出,PE 变为移位累加。输出端融合 MiX/MX 量化器实现 Algorithm 1 的 ±1 指数精炼。注意力 Key 采用 SageAttention 的训练免费 K-smoothing,并在 decode 冻结 prefill 的静态 K-mean。
- MiX-4.25b(Type 1)对标 MXFP4 的 4.25 bit 有效位宽:块大小 B=32,块级 4-bit Emax 加 3-bit 共享尾数 mshared(隐含前导 1),每元素 1-bit 符号与 3-bit 相对指数差 Δe。反量化为 (-1)^s × (1.mshared)_2 × 2^(Emax-Δe),Δe=7 编码零。共享比特补齐到 8-bit 字段后,(8+128)/32=4.25 bit/元素。
- MiX-4.5b(Type 2)对标 NVFP4 的 4.5 bit:同一 Emax,但把 32 元素切成 K=4 个 b=8 子块,各带自己的 3-bit mshared,k。比特账是 4+4×3+32×4=144,正好 4.5 bit,并且不再需要张量级 FP32 尺度。图 4 把 NVFP4、MXINT4、MXFP4 与两种 MiX 的字段并排画清。
- Algorithm 1 先取块内最大幅度得到 Emax,再按最大值的尾数而不是均值或 MSE 来定 mshared,以保住离群。朴素 Δe=Emax-floor(log2|x|) 噪声大,于是在 {Δe-1, Δe, Δe+1} 里搜使重构误差最小的指数(指数精炼)。硬件量化器用 4-bit 尾数残差与 0.5 阈值把这步变成单周期比较,不必浮点迭代。
- 双格式矩阵乘把激活编成 A-MiX、权重量成 W-MX。式 (6) 把 (1.mshared)_2 与全局指数提出求和号,元素运算退化成把 MX 尾数按 Δe 右移再累加,最后做一次标量乘和指数相加。4.25b 的 PE 是 32 路移位加整数加法树再乘共享尾数;4.5b 把加法树拆成四个 8 路子树,各乘自己的 mshared,k。MXFP 变体只需在移位前把 FP4 指数加到 δe 上。
- 顶层是 output-stationary 脉动阵列:MX Memory 水平送权重块,MiX Memory 垂直送激活块,每 PE 一周期吞整块。累加经 Accumulator Memory 进融合 MiX/MX 量化器或 SFU,再写回片外 DRAM。量化器前端共享比较树与 rounder;MiX 路径做指数精炼和不对称零编码(回收 -0 给正数多一档动态范围),MX 路径用 EXPmax-EXPxi 做移位。注意力侧采用 SageAttention 的 K-smoothing:γ(K)=K-mean(K),softmax 对平移不变。decode 冻结 prefill 的逐通道静态均值,避免每步重读整条 Key cache。
逐图理解论文
失败直觉
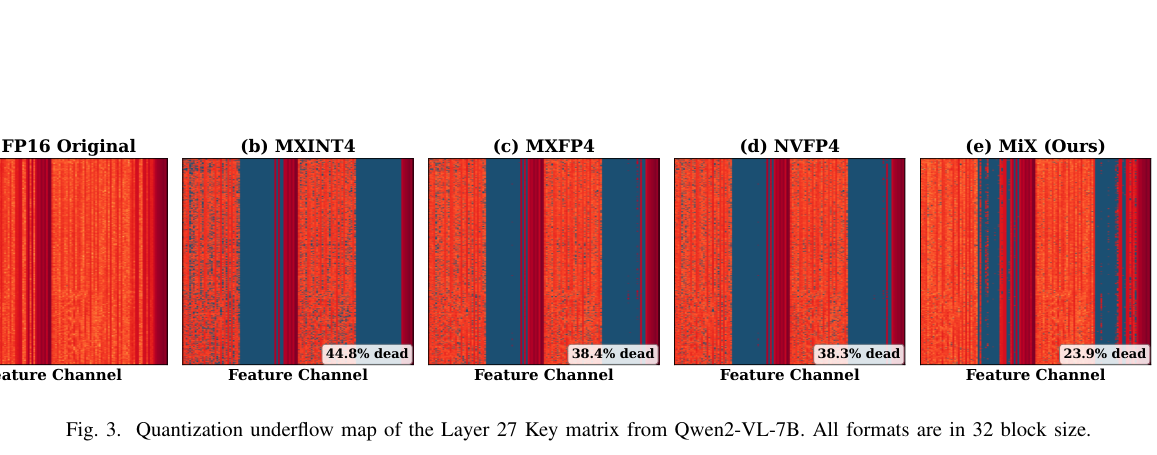
第 27 层 Key 的下溢地图,全部 B=32。FP16 几乎没有大片蓝带;MXINT4 / MXFP4 / NVFP4 的死区分别标 44.8%、38.4%、38.3%;MiX 收到 23.9%。深蓝是数学下溢,不是“不重要通道”。注意这里 NVFP4 也被改成 B=32,不能当成它默认 B=16 的结果。
研究缺口
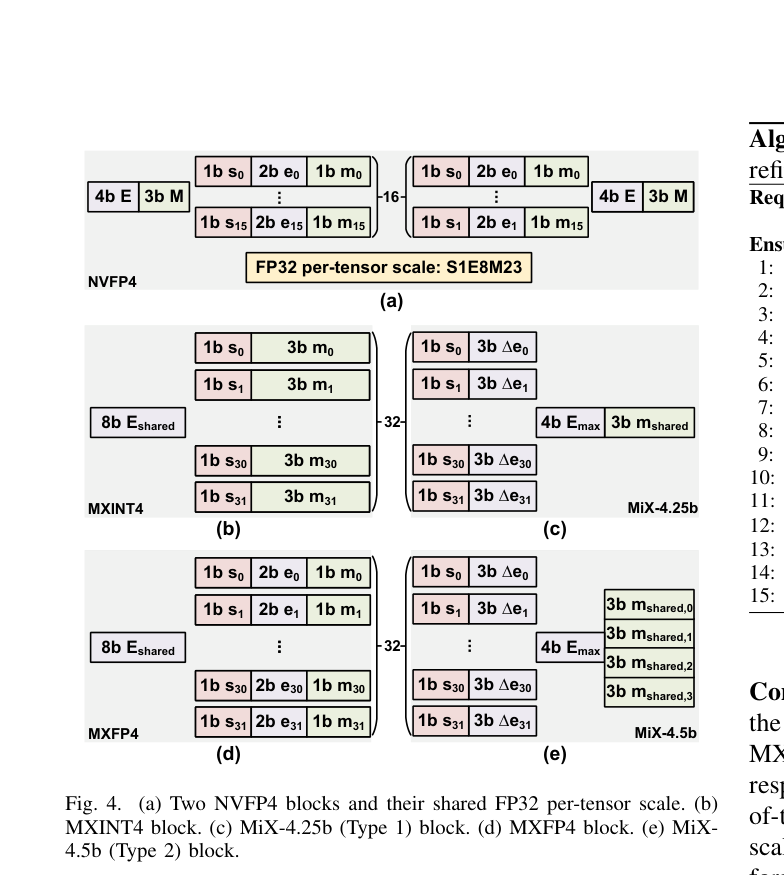
五种块的比特拼图。NVFP4 是 B=16 加黄条 FP32 张量尺度;MXINT4/MXFP4 是 8-bit 共享指数加每元素尾数或 E2M1;MiX-4.25b 把 4-bit Emax 与 3-bit mshared 放到块级,元素只留符号和 Δe;MiX-4.5b 再拆四个子组尾数。右侧 Algorithm 1 行号是邻栏。口诀:MX 共享指数,MiX 共享尾数。
关键机制
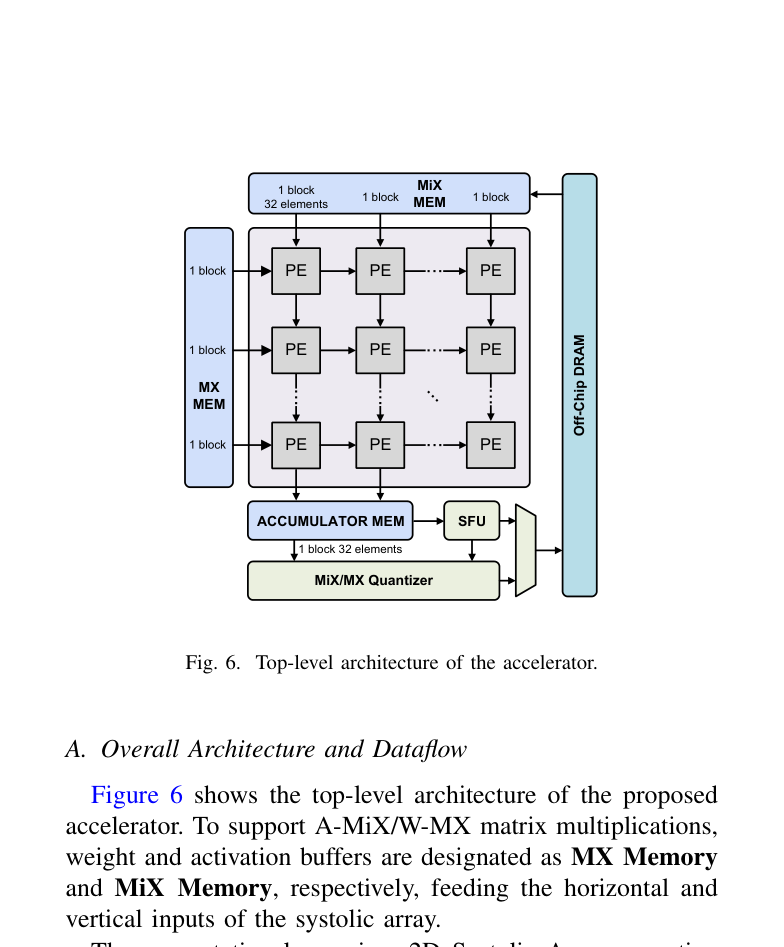
加速器顶层。MX MEM 水平送权重,MiX MEM 垂直送 32 元素激活块,PE 阵列 output-stationary,累加后进 SFU 或 MiX/MX Quantizer 再写 DRAM。3×3 阵列只是示意,评测是 4×4。这是 WordPress 特色图的首选:它画出双格式存储和端到端写回。
实验证据
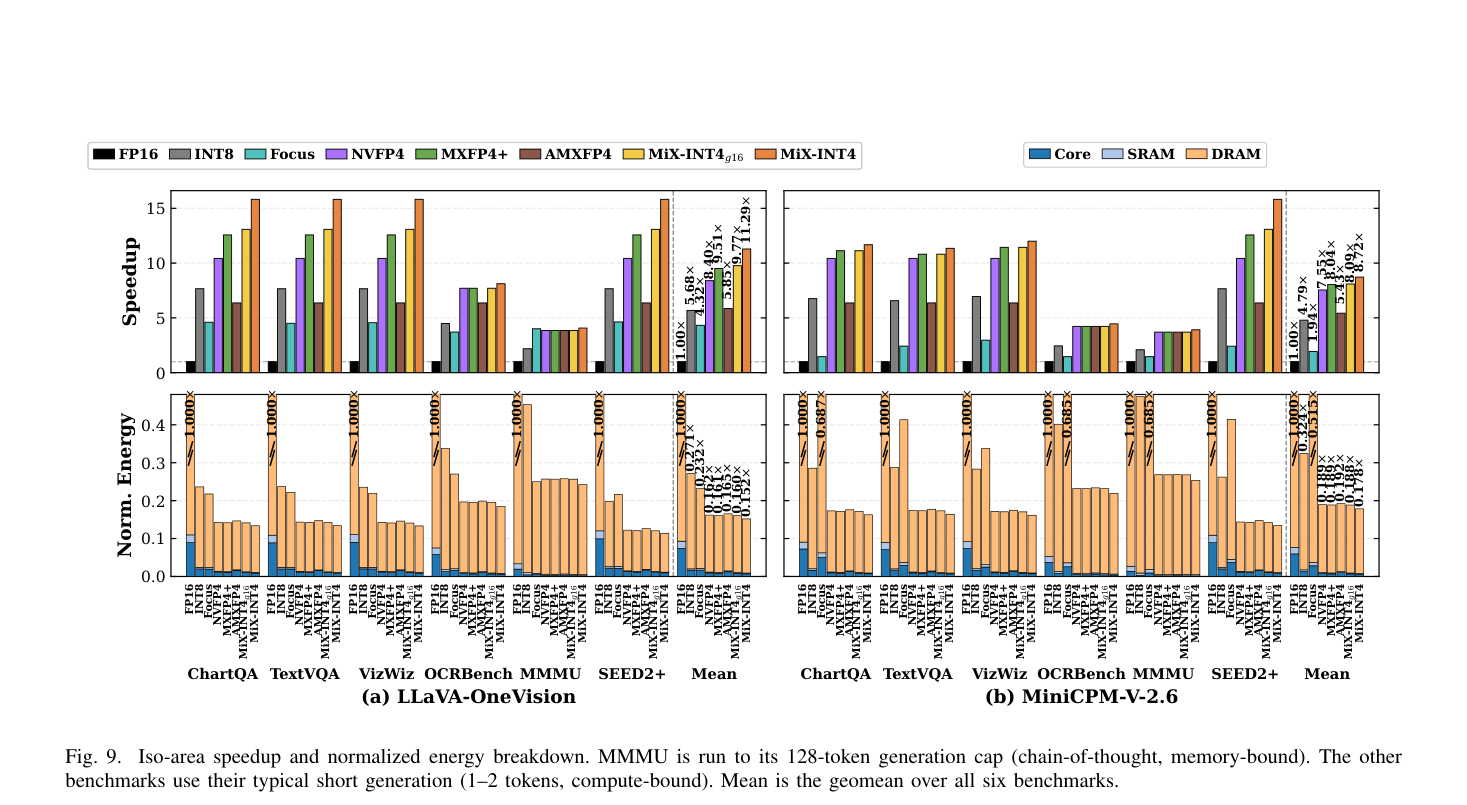
等面积加速与能量。上排柱是八种格式,下排堆叠 Core/SRAM/DRAM。MMMU 被 128 token 生成卡住所以柱高接近;短生成任务上黄橙(MiX)明显高于青色 Focus。读 Mean:LLaVA 上 MiX-INT4g16 9.77×、MiX-INT4 11.29×、Focus 4.32×;MiniCPM 上 Focus 只剩 1.94×。能量里 DRAM 最大。这是 iso-area,不是 Table VI 的 iso-throughput。
核心结论
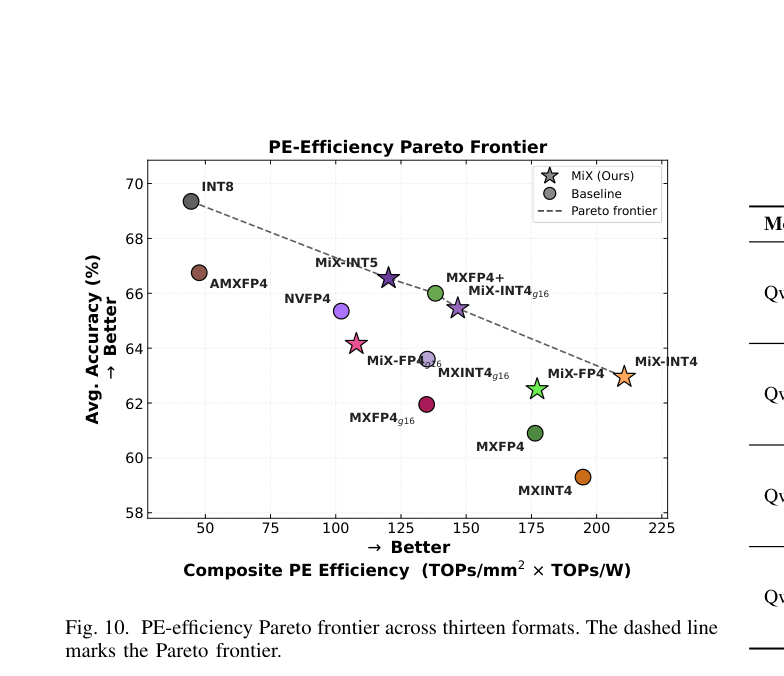
纵轴两模型六基准平均精度,横轴面积效率×功耗效率。INT8 与 AMXFP4 精度高但效率<50。高效区由 MiX 定义前沿:MiX-INT4g16 在 147 / 65.5%,NVFP4 在 102 / 65.3%,最右 MiX-INT4 到 211。MXFP4+ 约 138 / 66.0% 是唯一也碰到虚线的基线。右侧 Table VII 残栏不要当坐标读。
实验如何设计?
- 模型以 7B–8B 为端侧甜点:Qwen2-VL-7B、LLaVA-OneVision-7B、MiniCPM-V-2.6;另扫 Qwen2.5-VL 3B 到 72B,以及 Llama-3.1-8B、Mistral-7B-v0.3、Qwen2.5-7B/14B 四款纯文本 LLM。六项多模态基准覆盖推理(MMMU)、读字(OCRBench、TextVQA、ChartQA)与泛感知(VizWiz、SEED-Bench-2+)。VLM 校准用 128 张 COCO 图像,LLM 用 2048 段 Pile。
- 算法对照 MBQ、TLQ(Table II 带 *,取自先前工作,只重量化线性层)和 Focus 的默认稀疏配置。格式按有效位宽分两档:4.25b 的 MXINT4/MXFP4/MiX-INT4/MiX-FP4;4.5b 的 g16 变体、NVFP4、MXFP4+、AMXFP4。MiX-INT4g16 表示 MiX-4.5b 激活配 MXINT4g16 权重。
- 硬件:所有格式做成 iso-throughput 的 4×4、每 PE 32-wide、512 MAC/周期阵列(FP16 用 32×32 MAC 阵列归一到同一吞吐)。RTL 为 SystemVerilog,TSMC28HPC、500 MHz、Design Compiler;功耗用同一刺激的 SAIF。系统仿真给 288 KB 激活 SRAM、288 KB 权重 SRAM、128 KB 累加器,片外按 LPDDR5X。图 9 改为 iso-area:按面积节省加 PE、DRAM 周期仍受带宽限制。Focus 的加速叠到作者实现的 FP16 基线上。
关键结果与论文证据
- 没有 K-smoothing 时,所有 sub-8-bit 格式都会崩:Qwen2-VL 的 ChartQA 上 NVFP4 掉到 29.28%,MXFP4g16 掉到 0.0%。减去 token 均值后三款 VLM 精度被救回。Table III 显示静态 prefill K-mean 与动态全序列均值相差不到 1 个百分点,因此 decode 不必重读 Key cache。
- Table II:每个 MiX 变体都高于对应 MX 基线。Qwen2-VL 六任务均值上 MiX-INT4g16 为 69.3%,对 MXINT4g16 的 67.2%(+2.1 点),与 NVFP4 的 69.7% 持平;MiniCPM-V 上 66.8% 超过 NVFP4 的 64.9%(+1.9);LLaVA-OneVision 上 61.6% 对 61.0%。端到端的 MiX-INT5 达到 70.8% / 67.9% / 62.4%,明显高于只量化线性层、均值约 60–61.5% 的 MBQ/TLQ。
- Focus 在空间冗余基准上最多掉 3.8 点,但在字形几乎独一无二的读字任务上会删掉约 96% 视觉信号:LLaVA 与 MiniCPM 的 ChartQA 掉 21–40 点、OCRBench 掉 28–40 点,MiniCPM 六任务均值落到 53.2%(相对 FP16 -16.2 点)。MiX 在文档/图表上明显压过 Focus,空间冗余任务上也保持可比精度。
- MXFP4 意外弱于 MXINT4,原因是 OCP 的 floor 共享指数让大约 40% 的块最大值落到不可表示区间。改成 ceil 后 LLaVA 的 MXFP4g16 ChartQA 最多回升 10.9 点;即便如此 MiX-FP4-ceil 仍比 MXFP4-ceil 最多高 3.3 点,说明每元素指数的收益独立于这一修正。
- Table VI 只比计算单元:4.5b 档 MiX-INT4g16 面积 56125 µm²、功耗 31.8 mW,面积效率 9.1 TOPS/mm²、功耗效率 16.1 TOPS/W;NVFP4 为 7.3 与 14.0,即 +25% 与 +15%。AMXFP4 双 FP8 尺度把面积抬到 115380 µm²,效率掉到 4.4 / 10.7。4.25b 档 MiX-INT4 达到 11.0 TOPS/mm² 与 19.1 TOPS/W。Table V 全系统里 704 KB SRAM 占大部分面积与 56.9% 功耗,量化器只要 2540 µm²。
- 图 9 等面积几何平均:LLaVA 上 MiX-INT4g16 / MiX-INT4 为 9.77× / 11.29×,Focus 4.32×、NVFP4 8.40×;MiniCPM 上 8.09× / 8.72×,Focus 因只剩 64 个视觉 token 而掉到 1.94×。相对 FP16 能量约 0.160× / 0.152×(LLaVA)与 0.188× / 0.178×(MiniCPM)。相对 Focus,摘要给出的区间是最高 4.5× 加速、2.9× 节能。图 10 上 MiX-INT4g16 复合效率 147、精度 65.5%,压过 NVFP4 的 102 / 65.3%;MiX-INT4 把前沿拉到 211。
- Table VII:MiX-INT4g16 相对 FP16 的均值缺口随 Qwen2.5-VL 从 3B 的 8.0 点收到 72B 的 2.3 点,并在 7B 起超过 NVFP4。Table VIII 纯文本任务上 MiX 弱一些,推理平均落后 NVFP4 约 1.3–1.7 点,ARC-Challenge 可差 3–4 点,但 WinoGrande 上可领先(Llama-3.1-8B 最多 +3.8 点)。
阅读时需要注意
- 低比特本身救不了 Key 的通道偏置,必须叠加 K-smoothing;若 decode 动态更新均值,加速器还得重读、重量化整条 Key cache,所以作者改成静态 prefill 均值。
- 格式为“扛动态范围、略牺牲精度”而设计,纯文本推理上整体弱于 NVFP4,尤其是 ARC-Challenge。
- Focus 的 MMMU 只评单图子集;图 9 的等面积口径与 Table VI 的等吞吐综合不是同一件事,不能混读。
- 704 KB SRAM 主宰系统面积,PE 再省也改变不了存储主导;绝对 µm² / mW 绑定 TSMC28 与 Design Compiler,artifact 的 RTL 综合需要专有 EDA 与工艺库。
- MXFP4 必须按 ceil 修正后才有竞争力;文中凡写 MXFP4 均指 ceil。校准只有 128 张 COCO 图。代码与 RTL 以 Zenodo DOI 10.5281/zenodo.21530344 归档,软件 MIT,硬件复现仍依赖 Synopsys。
关联工作
- NVFP4 与 OCP MX 是工业块格式基线:共享指数换位宽,VLM 离群下会 microscaling collapse;MiX 对标其 4.25 / 4.5 bit 有效位宽,但把比特预算改花在每元素指数上。
- Focus 代表剪 token 的 VLM 加速器:在 LLaVA 的 729 视觉 token 上还有 4.32×,MiniCPM 的 64 token 重采样后几乎没冗余。MiX 攻击位宽和乘法器,与 token 数正交。
- MBQ、TLQ、Q-VLM、MQuant、VEQ 处理跨模态范围,但量化覆盖停在线性层,注意力与 projector 留 FP16,和 Table I 的端到端对照形成反差。
- MXFP4+、AMXFP4、MicroScopiQ、MicroMix 都在 MX 家族里加离群处理;它们提高精度的代价是更大 PE、混精度或更高平均位宽。MiX 走反方向:共享尾数换无乘法器移位阵列。
- SageAttention 的 K-smoothing 被借来做训练免费的注意力修复,并改成静态均值以适应 decode 访存。