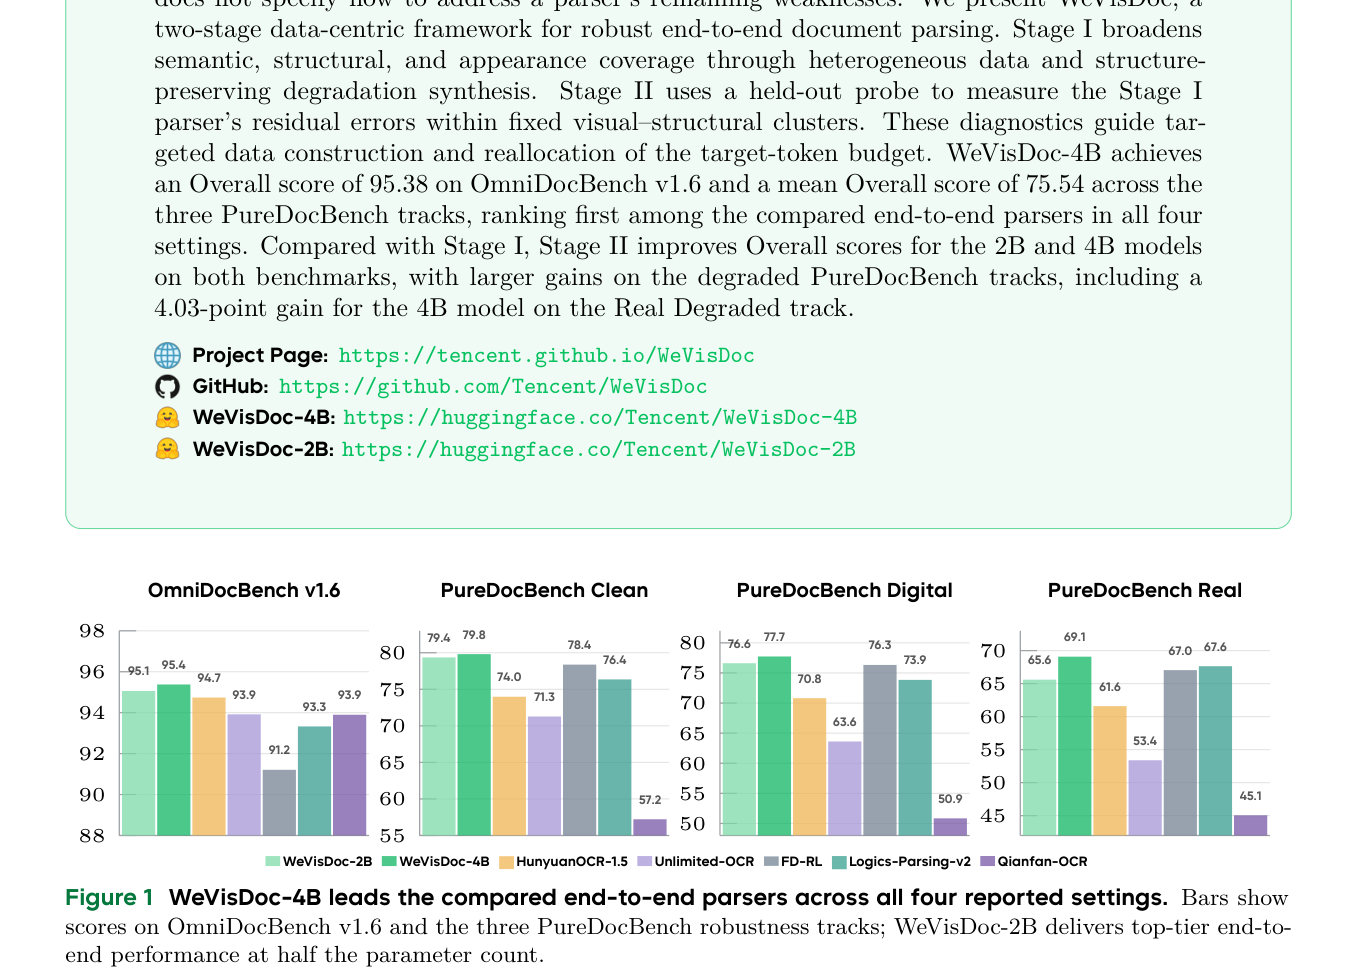
快速导读:微信视觉提出两阶段数据中心配方 WeVisDoc:先铺语义结构外观覆盖,再用留出探测诊断剩余错误并按固定目标 token 预算重分配;作者报告 WeVisDoc-4B 在 OmniDocBench v1.6 Overall 95.38、PureDocBench Avg3 75.54。
腾讯微信视觉(WeChat Vision)的 WeVisDoc 把端到端文档解析的训练数据当成可测量接口:不是把所有语料倒进一次训练,而是先建设语义、结构与外观覆盖,再针对 Stage I 解析器在固定视觉–结构簇上的剩余错误,决定补真实/合成数据还是加重已有支持的曝光。项目页 https://tencent.github.io/WeVisDoc ,代码 https://github.com/Tencent/WeVisDoc ,权重 WeVisDoc-2B / WeVisDoc-4B 在 Hugging Face。
作者报告:WeVisDoc-4B 在 OmniDocBench v1.6 上 Overall 为 95.38,在 PureDocBench 三条轨迹的平均 Overall(Avg3)为 75.54,在所比较的端到端解析器中四项设定均排名第一;同配方的 2B 模型 Overall 95.06、Avg3 73.86。相对 Stage I,完整 Stage II 协议在两个尺度都提升 Overall,退化轨迹增益更大,4B 在 Real Degraded 上作者报告 +4.03。这些数字来自论文表 2–4,且 Stage II 同时包含续训、难例、定向合成与重平衡,不能单独当成残差分配的因果效应。
英文题目:WeVisDoc: From Coverage to Capability for Robust End-to-End Document Parsing
论文出处:arXiv 每日论文精选 · arXiv:2609.20423
原始论文:PDF / 论文页面
这篇论文解决什么问题?
文档解析要把页面图像变成保留阅读顺序的结构化文本:正文走 Markdown,公式走 LaTeX,表格走 HTML。失败不只是认错字,还包括漏层级、读错栏、把非表区域表格化、在拍照弯曲页上丢掉可识别公式。OmniDocBench 覆盖异构自然页;PureDocBench 用同源 HTML 渲染出对齐的干净、数字退化与真实采集视图,用来把采集条件从内容本身拆开。
训练语料长期偏向常见文档类型和干净数字页。扩大收集、修复标注或做可控制合成,能拓宽经验支持;回放或重加权已有记录,改变的是曝光。对自回归解析器,作者用计入损失的目标 token 而不是记录条数来定义预算,因为长页与短裁剪的监督长度差一个数量级。
剩余误差本身也还不够当覆盖缺口的证据。它可能来自不可靠目标、低视觉可观测性、解码崩溃,或再补邻近样本也解决不了的模型上限。有效分配需要显式判断:相关训练支持到底缺不缺。流水线系统(MinerU、PaddleOCR-VL)和端到端专家(HunyuanOCR、Logics-Parsing、FD-RL)都在改架构或加 RL,但同骨干上如何把覆盖做成可诊断的能力,仍缺少分阶段协议。
WeVisDoc 的立场是:在 2B/4B 的 Qwen3-VL-Instruct 上冻结骨干、序列化与训练目标,只改数据建设与曝光接口。Stage I 回答“支持面够不够”,Stage II 回答“剩下的错该补数据还是加曝光”。
核心创新
- 把文档数据缩放拆成覆盖建设与能力感知 refinement,两阶段各自有独立的目标 token 预算。
- Stage I 用异构监督、可执行页面程序与来源条件化保结构退化,把语义支持与外观变体分开记账。
- Stage II 用不相交探测集做簇级残差诊断,经验证的难例、定向合成与有界重分配在同一固定预算下组合。
方法概览
WeVisDoc 在每个尺度固定 Qwen3-VL-Instruct 骨干、输出序列化与自回归目标。Stage I 约 4,000 万条记录:公开与内部页、定向爬取、可执行页面程序合成,以及按来源路径的保结构外观增强;三专家(MinerU2.5-Pro、PaddleOCR-VL-1.6、dots.mocr)一致性标注,源感知 token 份额平衡。Stage II 约 500 万条 refinement 池:留出 allocation probe 在冻结视觉–结构簇上测残差;训练池挖掘页级 NED 与文本/表/公式分量误差,审计标注错误、解码崩溃与低可观测性后才当难例;定向检索与页面程序补覆盖缺口;在固定 B2 token 预算下按残差重平衡,并冻结视觉编码器只更新语言模型。
- 任务与目标写在第 4–5 页。解析器对 yi 自回归,损失按监督目标长度归一化(式 3)。Stage I 从预训练 θ0 得到 θ1,预算 B1;Stage II 诊断 θ1 后在修订分布 q2 与预算 B2 上得到 θ2。Stage II 冻结视觉编码器,只更新语言模型。
- Stage I 池约 4,000 万条。来源包括公开 OCR 集、内部生产页、定向网页/PDF 爬取,以及可执行页面程序。训练前大约 40% 全页、25% 文本或混合区域、25% 孤立表、10% 孤立公式。语言覆盖简体、英文、繁体与混排;采集覆盖数字 PDF、扫描、手机拍照、截屏与屏幕翻拍。
- 图 2:收集页经 MinerU2.5-Pro、PaddleOCR-VL-1.6、dots.mocr 三专家标注,高一致进入可靠目标并按 Easy/Medium/Hard 分层;低一致走更强模型与人工复核。合成支路用语义 HTML/CSS 同时渲染图像并导出 Markdown、框、元素类、HTML 表与 LaTeX。外观增强按来源走纸张复制传输或几何光照翻拍,只有内容仍可读才保留原目标。源感知 token 份额用式 4–5 转成记录抽样概率,避免大库吞掉长尾。
- Stage II 池约 500 万条。图 5:训练池挖掘页级 NED 以及文本 NED、1−TEDS、1−CDM 与阅读顺序编辑;高误差先归因成标注错误、解码退化、低可观测性或真正能力失败,修复后不再当难例过采样。不相交的 allocation probe 用冻结 SigLIP2+结构元数据簇估计残差(式 8–9),再决定回放、补采还是定向页面程序。补进的样本重新编码到冻结簇心,按式 10–12 在固定 B2 下有界重平衡,并保留 Stage I 回放以减轻遗忘。
- 表 1:两侧共享 Fused AdamW、β1=0.9、β2=0.95、学习率 5×10⁻⁶、全局 batch 512、序列长度 8,192。Stage I 训 ViT+LLM,Stage II 只训 LLM。评测用附录系统提示与确定性解码,每个 checkpoint 三次推理取均值,不外挂重排或内容级后修。
逐图理解论文
研究缺口
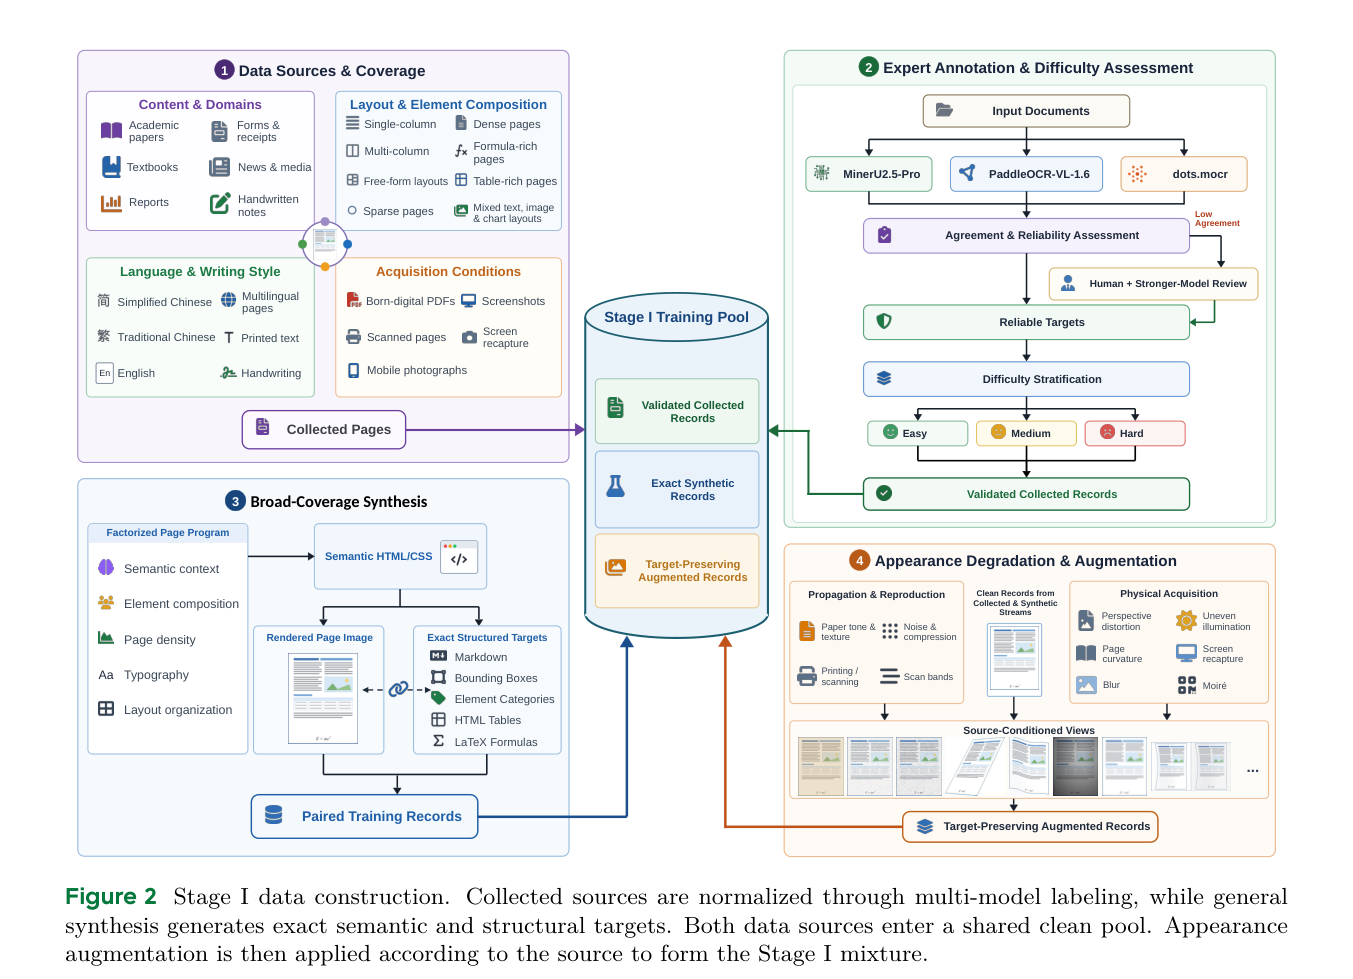
第 6 页 Figure 2,Stage I 数据建设总图,也是架构/特色图候选。左上覆盖维度(领域、版面、语言、采集)汇入 Collected Pages;右上三专家标注与难易分层;左下页面程序从语义 HTML 编译出图像与精确目标;右下按来源做保结构外观增强。中央圆柱是 Stage I 训练池:Validated Collected、Exact Synthetic、Target-Preserving Augmented。按 1→2 与 3 并行、再 4、最后入池的顺序读。
关键机制
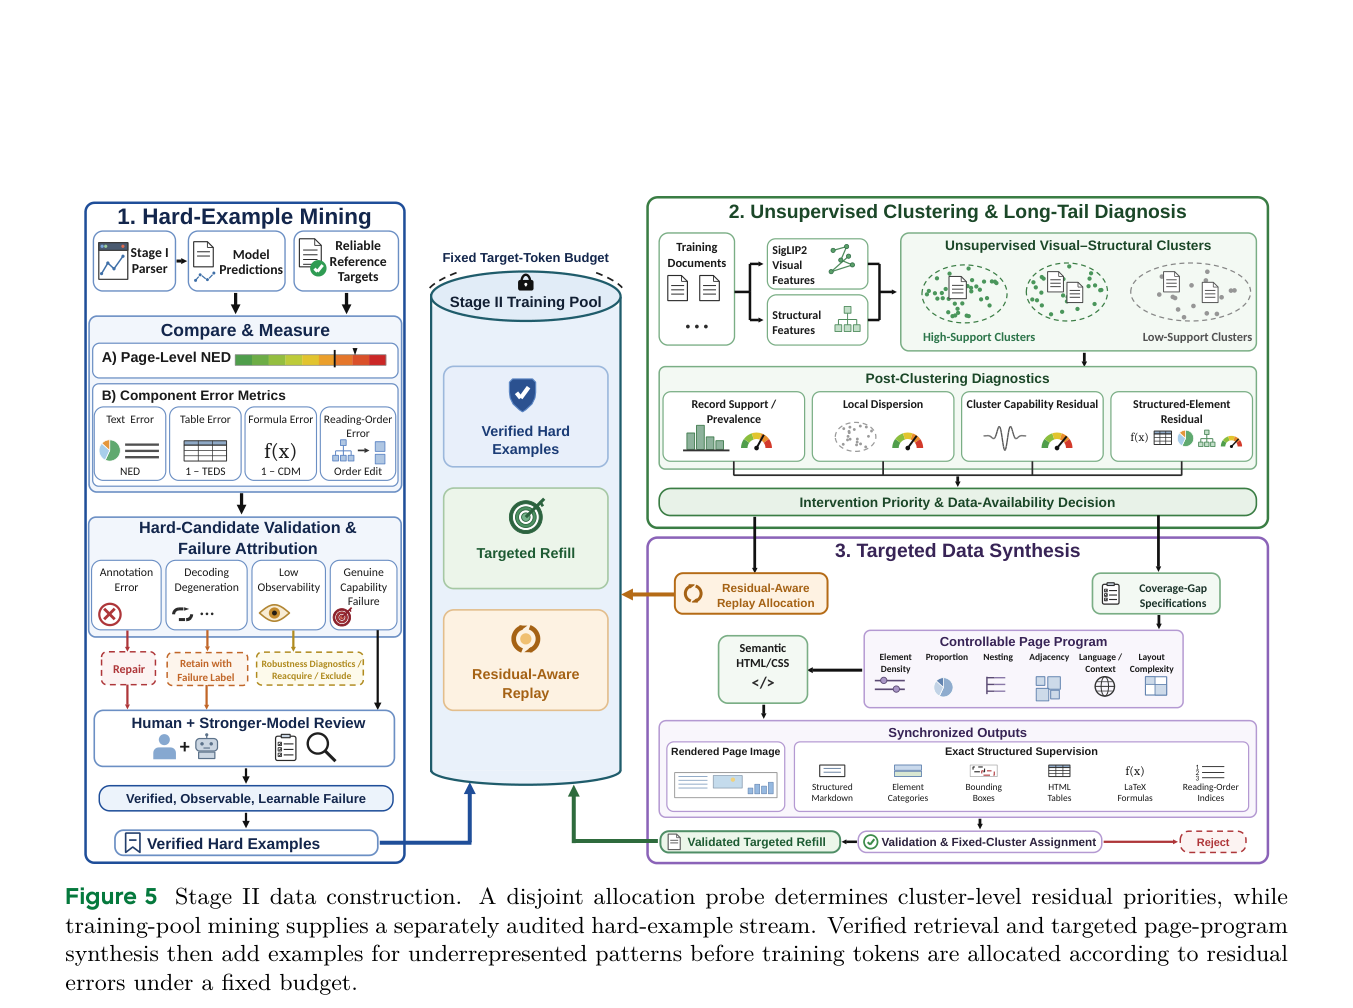
第 11 页 Figure 5,Stage II。左列难例挖掘:页级 NED 与分量误差,再归因标注/解码/可观测性/真失败,人机复核后才进 Verified Hard Examples。右上用 SigLIP2+结构特征做视觉结构簇与残差诊断;右下定向页面程序补覆盖缺口。中央锁头强调固定目标 token 预算,池内是难例、定向补灌与残差感知回放。不要把左列热力条读成基准分数。
核心结论
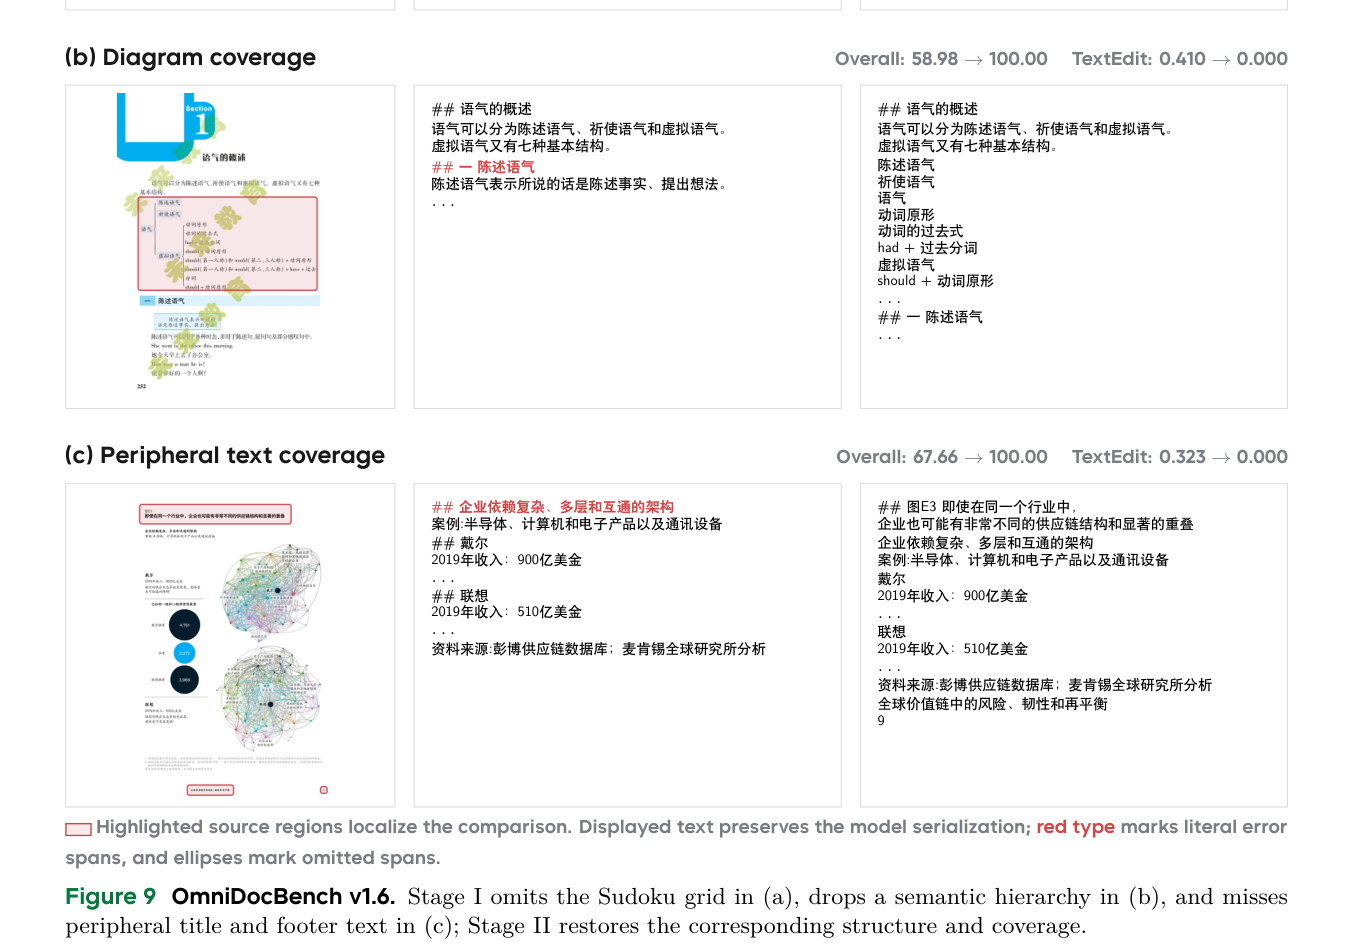
第 28 页 Figure 9 的下半裁切,只有 (b) Diagram coverage 与 (c) Peripheral text coverage,没有 (a) 数独。每行三列:源页、Stage I 序列化(红字/省略号标错漏)、Stage II 恢复。角标 Overall 58.98→100.00、TextEdit 0.410→0.000 等是单页示意。(a) 被错误裁进 figure-10-p028-01,不要用那张。
实验如何设计?
- OmniDocBench v1.6:1,651 页。对照分通用 VLM(含 Gemini 3 Pro、Ovis2.6、Qwen3-VL-235B)、流水线(MinerU2.5-Pro、PaddleOCR-VL-1.6 等)与端到端专家。带 * 的基线是作者用同一评测管线复跑,无标记行引自先前工作。
- PureDocBench:1,475 个 HTML/CSS 源页,10 域 66 子类;每源对齐 Clean、十种数字退化与四种物理/屏幕采集。作者引用该基准对 OmniDocBench v1.5 的审计(21,353 个评分块中 2,580 处确认标注错误)作为使用源派生真值的动机,并声明这不是 v1.6 错误率估计。
- 表 4 在 2B/4B 上比较 Stage I 广覆盖 checkpoint 与完整 Stage II 协议。作者明确这不是分量消融:续优化、残差分配、难例、定向添加与回放绑在一起。
- 定性:图 9 看 OmniDocBench 上 Stage I 掉层级/漏页边文字、Stage II 恢复;图 13 看公式页的输入、预测 Markdown 与渲染。附录还有 PureDocBench 三轨与表密集页。
关键结果与论文证据
- 表 2(第 18 页,作者报告):WeVisDoc-4B OmniDocBench v1.6 Overall 95.38,相对所比较端到端系列此前领先结果 +0.64;并在该系列领先 TextEdit 0.036、FormulaCDM 96.81、TableTEDS_S 95.34、ROEdit 0.125。2B 为 Overall 95.06。流水线里 PaddleOCR-VL-1.6 Overall 96.33 更高,但那是模块化系统,不是本文端到端对照主结论。
- 表 3(第 18–19 页,作者报告):4B Avg3 75.54,高于宽域 Qwen3.5-122B-A10B 的 74.11;Clean 79.81、Digital 77.74、Real 69.08(Real 较此前端到端领先 +1.44)。2B Avg3 73.86。从 2B 到 4B,三轨增益 0.45 / 1.12 / 3.48,容量主要帮在更强外观偏移。
- 表 4(第 20 页):2B OmniDocBench 93.50→95.06(+1.56),Avg3 72.12→73.86(+1.74);4B 94.22→95.38(+1.16),Avg3 73.19→75.54(+2.35)。Digital/Real 增益明显大于 Clean(4B Real +4.03,Clean 仅 +0.49)。作者强调这与 Stage II 针对分布尾部与采集偏移的设计一致,但未隔离单一干预。
- 图 1 柱形把四项设定放在一起:4B 在四个面板都是最深的绿柱;2B 在 OmniDocBench 与 Clean/Digital 接近 4B,在 Real 上低于 Logics-Parsing-v2 / Qianfan-OCR 的圆整柱。精确排序以表 2–3 为准。
- 图 9 裁切(第 28 页)展示 (b) 讲义层级与 (c) 页边标题/脚注:Stage I 序列化漏层级或漏外围文字,Stage II 补回;图上 Overall 58.98→100.00 与 67.66→100.00 是单页示意,不是基准总分。图 13 三行公式页(手写积分、对齐方程组、含 trace 的期望公式)显示 LaTeX 预测可再渲染。
阅读时需要注意
- Stage II 增益是整包协议的结果,论文自己写明不能识别残差感知分配的孤立效应。
- OmniDocBench 比较绑定标注真值与冻结 v1.6 评测器;PureDocBench 的合成/物理退化也不能代表所有真实损毁。
- 结论第 20 页:手写、历史扫描、严重损坏页与更广采集仍测量不足;重平衡依赖探测集、表示、聚类与评测器,并有额外算力。
- 高风险场景需要来源追踪和人工审阅。本文为 2026-09-21 预印本(arXiv:2609.20423),尚未同行评审。
关联工作
- Donut、Pix2Struct、Nougat 把页面变成序列;SmolDocling 与 DeepSeek-OCR 改视觉 token。WeVisDoc 不在这条线上改解码器,而改同骨干的数据接口。
- MinerU2.5-Pro、DocHumming、Infinity-Parser 把语料建设写成解析器研发的一部分。WeVisDoc 再接上“覆盖之后如何按剩余错误花钱”。
- HunyuanOCR-1.5、Logics-Parsing-v2、FD-RL、Qianfan-OCR 是图 1 与表 2 的端到端对照;PaddleOCR-VL-1.6 与 MinerU2.5-Pro 是更强流水线,也担任 Stage I 专家标注器。
- DoReMi、Nemotron-CLIMB、Rho-1 与文档侧簇采样提供“预算往哪花”的先例;本文用不相交探测集和覆盖审计来区分缺数据与欠曝光。
- Augraphy、DewarpNet、UVDoc 处理退化与展平;WeVisDoc 只在目标仍可读时把增强当外观支持,不当新的语义支持。