快速导读:nnFoundation 在 210 万 CT/MRI/PET 体积上预训练一对 CNN 与 ViT,并在 108 项下游任务上显示可迁移的三维放射学表征,同时强调任务依赖架构与数据集感知适配。
放射学人工智能发展很快,但多数系统仍是窄任务、吃标注、怕域移。基础模型承诺更可迁移的表征,可既有三维工作规模有限、评测偏窄,还常默认“一个预训练权重打天下”。德国癌症研究中心(DKFZ)、波恩与海德堡等机构联合的预印本 nnFoundation(arXiv 2609.26924,未经同行评审)在 Human Radiome Project 下发布一对互补三维模型 nnFoundationCNN 与 nnFoundationViT,于 210 万 CT/MRI/PET 体积上自监督预训练,并在 108 项下游任务上系统评测。
必须先说清边界:这不是临床诊断产品,不能替代放射科医生,也不能根据文中分数做诊疗决策。作者约 83 人。正文写 nnSSL 预训练框架与下游仓库可在 GitHub 获取,并称模型已接入 nnU-Net 与 nnDetection;本次没有打开页面或仓库复核,代码与权重状态一律记为待核验。PDF 很长,下文做雷达级深度,只保留主文关键主张与图示。
英文题目:nnFoundation: 3D Foundation Models for Radiology
论文出处:arXiv 每日论文精选 · arXiv:2609.26924
原始论文:PDF / 论文页面
这篇论文解决什么问题?
监管视野里医学 AI 已大量落在放射学,但主流仍是单任务全监督:换扫描仪、换机构、换人群就脆弱,且难以及时获得新标注(第3页)。二维胸片基础模型相对成熟,三维截面成像却要求真正的体数据架构与更大算力(第3–4页)。
更关键的设计问题是异构:分辨率、对比机制、解剖覆盖与协议差很大;分割/检测要空间精度,分类/检索/视觉语言要全局语义。是否存在单一通吃架构,以及预训练后如何对齐下游数据拓扑,此前缺少受控的大规模答案(第4页)。
核心创新
- 以目前报告中最大的三维放射学预训练资源训练一对互补基础模型。
- 在 108 项任务上揭示卷积偏空间定位、Transformer 偏全局语义的任务依赖结构。
- 把数据集自适应范式扩展到预训练权重迁移,做无需再训练的动态拓扑对齐。
- 将模型直接接入 nnU-Net 与 nnDetection,降低工程接入成本。
方法概览
组装 125 个来源共 210 万体积(MRI 为主,含 CT/PET),系统比较架构、预训练目标与超参;发布 nnFoundationCNN 与 nnFoundationViT,默认以 MAE 扩到全量;下游接入 nnU-Net/nnDetection,并用启发式动态适配把预训练拓扑对齐数据集;评测覆盖分割、检测、分类、检索、报告生成及域移、低数据、外部伙伴。
- 数据:125 个机构与公开来源共 210 万三维系列,MRI 约 71.7%、CT 约 26.6%、PET 约 1.7%;临床合作约 60.9%、研究队列约 34.2%、小公开集约 4.9%(第7页)。这是作者声称迄今报告最大的三维放射学预训练资源之一(Fig.1)。
- 模型对:在匹配算力预算下比较卷积与 Vision Transformer,以及 MAE、DINO、CLR 等目标。开发基准(约 630k 公有体积)上 MAE 整体更优,于是扩到全量 2.1M;缩放实验后最终选择较小 CNN 与较大 ViT 作为发布配置(Fig.6,第27页)。
- 动态适配:继承 nnU-Net/nnDetection 的数据集自适应思想,在权重迁移时用启发式调整网络拓扑与核参数,使预训练表征对齐下游体素间距与形状,而无需为适配再训练(Fig.3,第13页)。
- 下游协议:分割与检测走框架内微调;分类等按任务框架;检索与报告生成在冻结视觉编码器设定下评估语义质量。排名在数据集内对多指标取秩再等权平均,配对自助法给置信区间(第9–10、37页)。
- 工程:作者称全部预训练模型直接接入官方 nnU-Net 与 nnDetection,以降低临床研究流水线改造成本;分类/检索/视觉语言另有任务框架(第19页)。接入声明待核验。
逐图理解论文
现实瓶颈
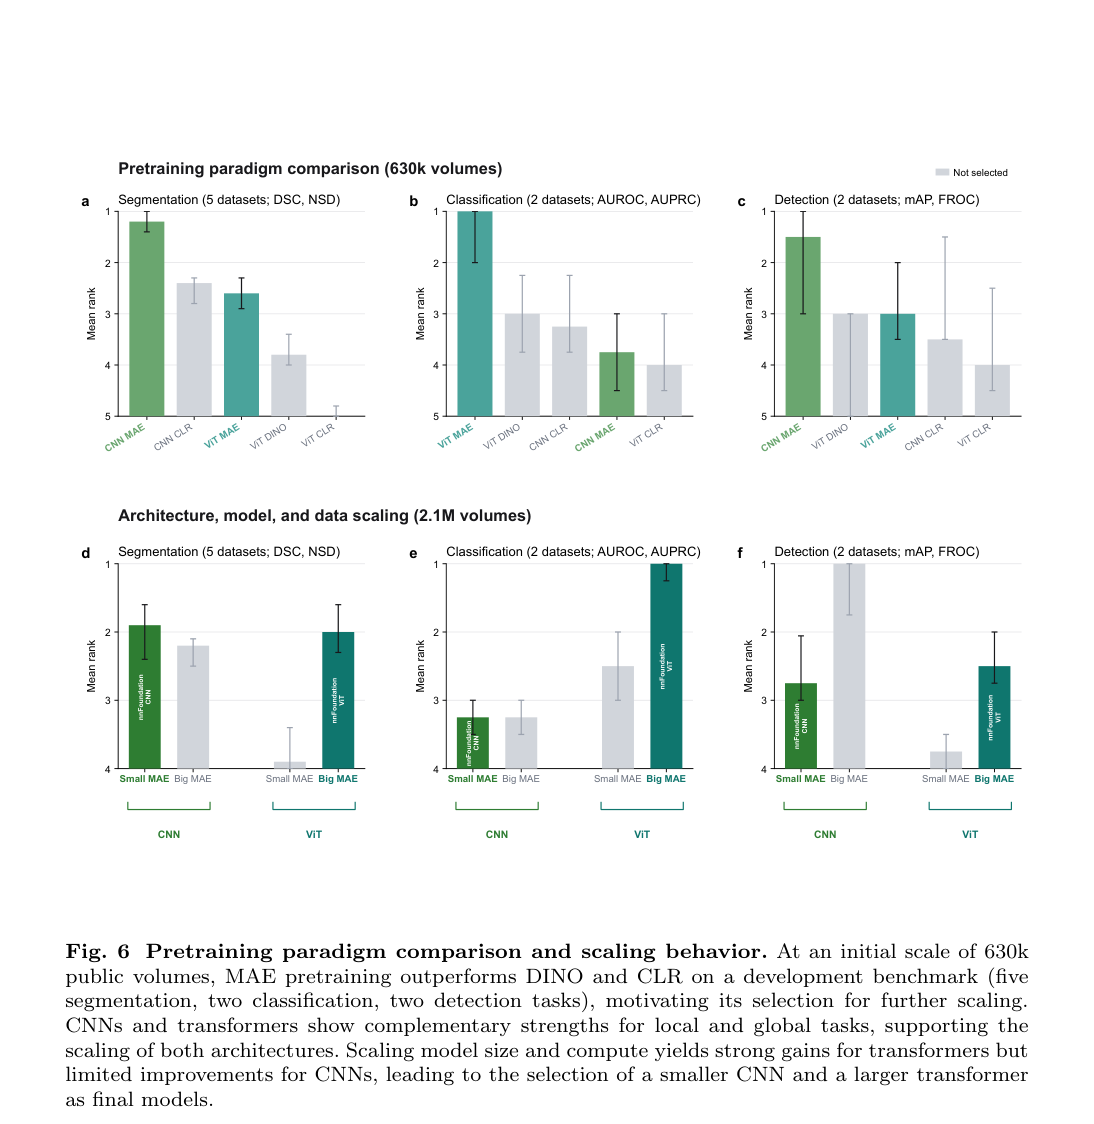
第27页 Fig.6。上排 630k:分割/检测 CNN MAE 靠前,分类 ViT MAE 靠前,支撑选 MAE。下排 2.1M:高亮的发布配置是小 CNN(绿)与大 ViT(青);ViT 缩放收益更明显。用它理解为何最终不是“越大越好的单一模型”。
任务依赖
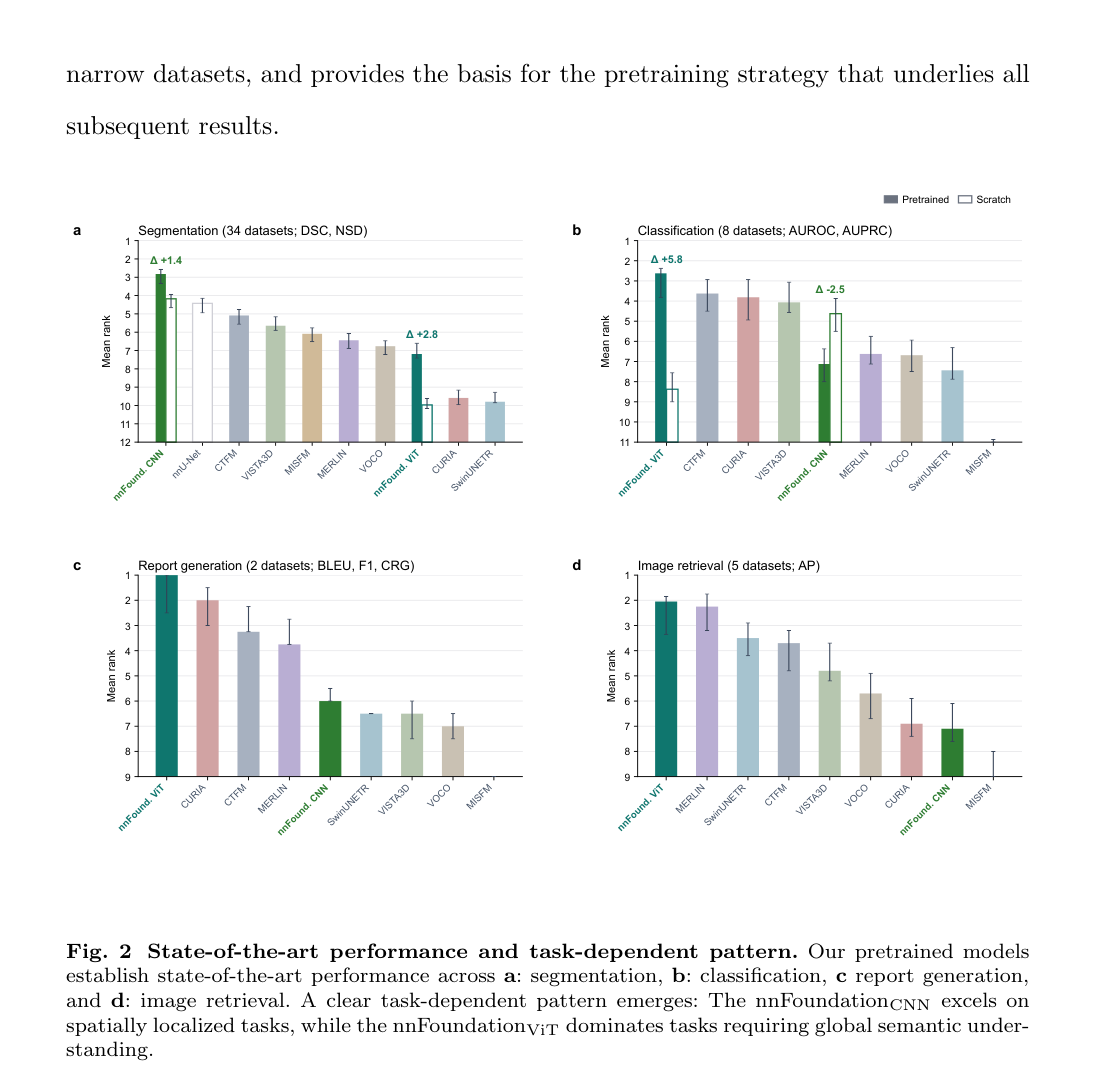
第8页 Fig.2 四联均值排名柱图,纵轴倒置、1 最好。实心为预训练,空心为从零。(a) 分割 34 集:深绿 nnFound. CNN 约 2.8 最优,标 Δ+1.4;(b) 分类:nnFound. ViT 最优,Δ+5.8,CNN 预训练反而变差;(c)(d) 报告与检索同样 ViT 居首。用来理解“互补而非通吃”,不是临床准确率仪表盘。
适配与稳健
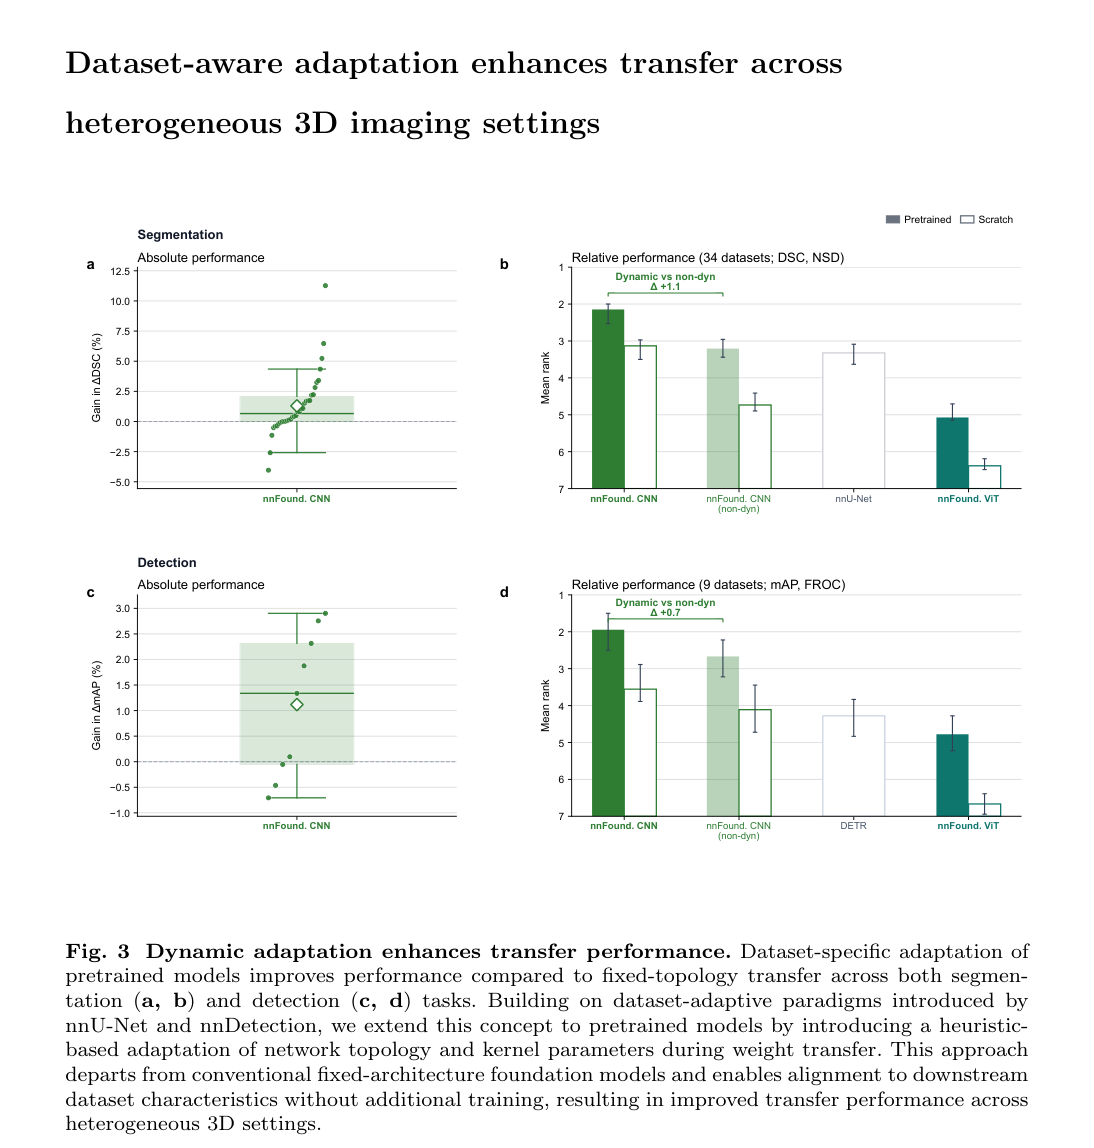
第13页 Fig.3。上排分割:左箱线为动态适配的 ΔDSC 增益,多数点在零上;右柱为均值排名,预训练 CNN 约 2.1,相对非动态 Δ+1.1。下排检测:ΔmAP 中位约 1.3,排名 Δ+0.7。读图时先看增益是否为正,再看相对 nnU-Net/DETR 等基线。这是研究迁移设定。
边界
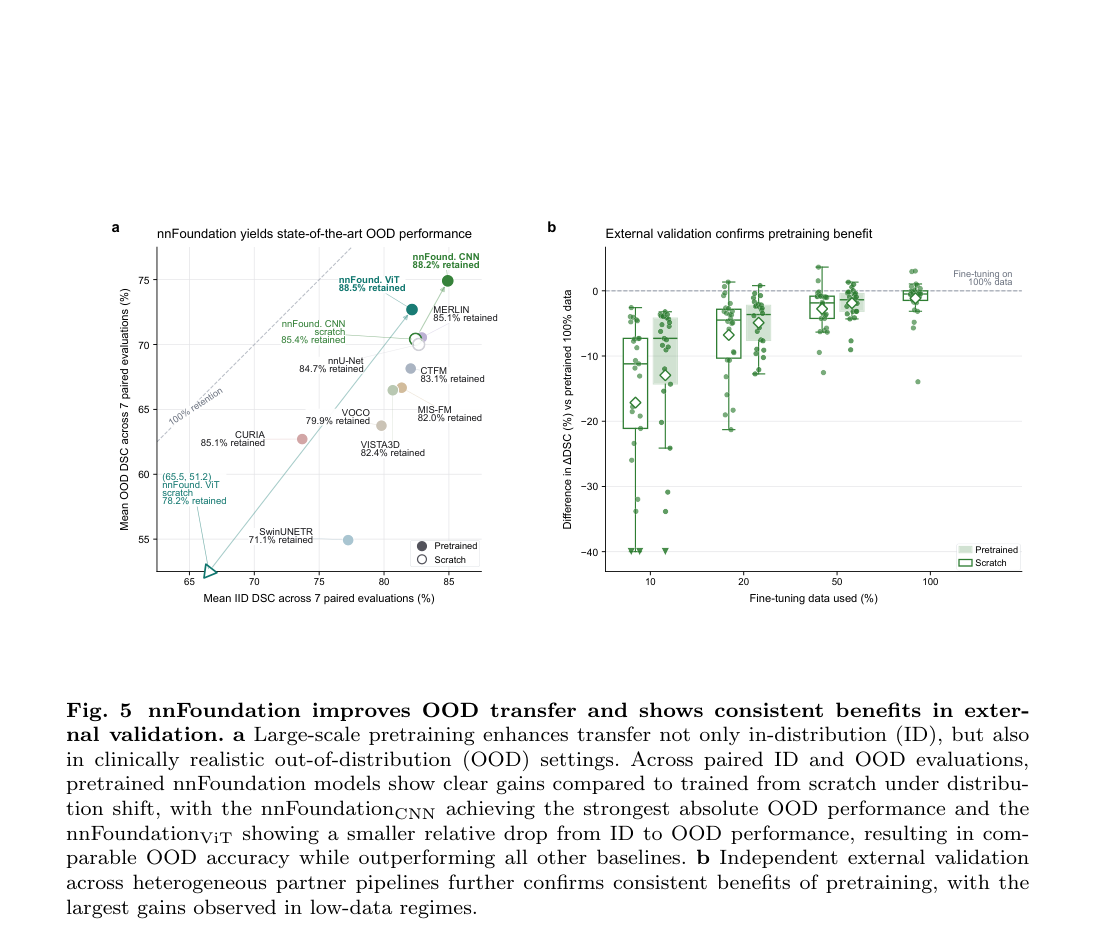
第18页 Fig.5。(a) ID–OOD 散点:预训练实心点更靠右上,nnFound. CNN 标注约 88.2% retained,ViT 约 88.5%;虚线为 100% 保留。(b) 外部验证箱线:横轴 10/20/50/100% 微调数据,纵轴相对预训练满数据的 ΔDSC,低数据时空心从零掉得更深。强调稳健性与低数据,不是床旁认证。
实验如何设计?
- 广度:108 任务、约 16 万评测体积,覆盖脑、头颈、胸、腹、全身/骨骼肌等,含健康解剖与病理目标,并含域移与外部验证(Fig.1,第5–6页)。
- 主对照:从零训练的同架构、nnU-Net,以及 CT-FM、CURIA、VISTA3D、Merlin、VOCO、MIS-FM、SwinUNETR 等;检测侧注明部分基线缺少统一微调接口(第10页)。
- 专项:动态 vs 非动态拓扑;低标签(如 10%–100% 数据)与缩日程微调;7 组配对 ID/OOD 分割迁移;外部学术与工业伙伴在本地流水线独立评估(Fig.5,第18–19页)。
- 开发缩放:630k 上 MAE/DINO/CLR × CNN/ViT;2.1M 上 Small/Big MAE(Fig.6)。
关键结果与论文证据
- 总体:预训练 nnFoundation 在各任务类型上超过从零训练与既有三维基础模型对照(第9–10页)。分割上 nnFoundationCNN 平均最优,相对 CTFM +3.0 Dice、相对 nnU-Net +1.9 Dice,且是宽协议下唯一超过 nnU-Net 的基础模型;作者以此批评窄评测上的虚假领先(第10页)。
- 任务依赖(Fig.2):CNN 在分割(34 集)均值排名最好,预训练相对从零约 Δ+1.4;ViT 在分类(均值排名 2.63)、报告生成与图像检索居首,分类预训练增益约 Δ+5.8,而 CNN 在该图上预训练甚至可变差。冻结特征的检索与报告进一步放大 ViT 优势(第11–12页)。
- 动态适配(Fig.3):相对固定拓扑迁移,分割均值排名 Δ+1.1,检测 Δ+0.7;绝对 ΔDSC/ΔmAP 箱线多数为正,中位增益约几个百分点量级(第13页)。
- 域移与外部(Fig.5):配对 ID/OOD 上预训练点更靠右上;nnFoundationCNN 绝对 OOD 最强(图上约 75 OOD DSC、约 85 ID、保留约 88.2%),ViT 相对保留约 88.5%。外部伙伴箱线图显示低数据比例时预训练相对从零的优势最大(第18页)。
- 预训练选择(Fig.6):630k 上 MAE 在分割/检测等开发任务上优于 DINO/CLR;扩到 2.1M 后 ViT 受益更明显,CNN 加大未必全面更好,故发布“小 CNN + 大 ViT”(第27页)。
- 效率:文中报告低算力日程下 CNN 可保留全日程约 99.16% 的分割表现等(主文效率段);这些仍是研究协议数字。
阅读时需要注意
- 明确不是临床产品:未证明可进入诊疗工作流,不能替代放射科阅读。
- 宽基准仍受公开标签与伙伴本地协议差异影响;效应量跨站点波动(第19页)。
- 单一架构通吃的假设被结果否定,部署需按任务选型并做数据集适配。
- 代码、权重与框架接入本次待核验;预印本未经同行评审;长附录中的逐集表未在本雷达解读中展开。
关联工作
- nnU-Net/nnDetection 提供数据集自适应规划;nnFoundation 把预训练权重接到同一哲学上,而不是另起炉灶(第13、19页)。
- 先前三维基础模型多在较窄解剖或模态上示范;本文用规模与 108 任务宽度重新标定“可迁移”主张(第3–5页)。
- MAE 相对对比学习在开发基准上的优势,支撑其作为扩规模默认目标(第27页)。