快速导读:阿里 AAIG 提出 InGuard:用模型自身提示嵌入与中间潜变量做内护栏,在五套开源文生图上达到约 97.9–98.8% 安全率,并相对外护栏降低良性打扰;代码已开源。预印本。
开源文生图越强,越需要能进管线内部的安全机制。Zeyu Wang、Xiaodan Li、Zhiwen Li、Yuefeng Chen 与 Hui Xue 来自阿里 AAIG。他们的 InGuard 不做外挂式“先挡提示、后挡成片”,而是在文本嵌入与去噪中途潜变量上插入插件,基座参数保持不动。论文是 arXiv:2609.27620,2026-09-23 v1 预印本。代码仓库 https://github.com/Alibaba-AAIG/InGuard 已公开。
系统分三步:PE-MLP 把提示分成 unsafe、risky、benign;SAGE 只改 risky 的嵌入,争取直接出安全图;潜空间检测在中间步检查一步干净潜变量估计,不安全就提前停。配套 RevGen Safety Benchmark 含一万条反向生成提示。五套开源模型上安全率约 97.9–98.8%,良性打扰相对外护栏下降约 57.5–73.5%。本文解读只讨论外护栏与内护栏机制,不展开不当画面细节。
英文题目:InGuard: Towards Generalized Inner Guardrail for Safe Text-to-Image Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.27620
原始论文:PDF / 论文页面
这篇论文解决什么问题?
面向公众的文生图服务必须处理不当内容与受控 IP 角色等策略风险。常见外护栏有两端:生成前的提示分类器,以及生成后的成片分类器。
作者指出三点结构性弱点。提示侧若用外部小语言模型,表征容量限制风险判别;换成更大语言模型又抬延迟。图像侧要等全部去噪结束才检查,拦截时算力已经花完。拒绝式策略一旦判风险就整单拒绝,即使用户意图本可被改写成安全结果。
根因是护栏看不见模型自己的表示:它只看输入文本和最终像素,不看提示嵌入和中间潜变量。理想方案应非侵入、架构无关、低开销,并能在管线内纠偏而不只是否决。
核心创新
- 把护栏做成管线内插件:复用模型自身嵌入与中间潜变量,而不是只检查外部文本和成片。
- SAGE 对 risky 请求做嵌入级安全增强,优先出安全图而不是一律拒绝。
- 中途潜空间检测接近成片检测效果,并可跳过剩余去噪步。
方法概览
InGuard 不改基座参数。PE-MLP 读文本编码器嵌入,把提示标成 unsafe / risky / benign:unsafe 早停,benign 直接生成,risky 进 SAGE。SAGE 按风险标签选概念子空间,做 leave-one-out 触发分析与非对称软门混合,把嵌入推向更安全方向。生成中途对一步干净潜变量估计做潜空间检测,判不安全则跳过剩余去噪。另构建 RevGen:一万条反向生成提示,含分级风险、受控 IP 与难分良性负例。
- 图 5 给出总览。文本提示经模型自带 Text Encoder 得到嵌入后,先进入风险分类插件。Unsafe 直接 Early Termination;Benign 走虚线绕过增强;Risky 进入 SAGE,得到 Modified Embedding 再去生成。
- PE-MLP 是接在该嵌入上的轻量头,输出多维风险标签与强度,用于路由。它复用 LDM 自己的文本编码器,不另挂一套大编码器。表 5 显示其参数约 5.8–15.8M,低于外置 mE5 的约 282M,且多类准确率更高、提示侧误报更低。
- SAGE(图 6)在嵌入空间工作:按标签选择概念子空间并构造投影 PC,把有害方向与正交补空间分开;leave-one-out 估计哪些内容 token 更触发风险;再用非对称软门 γ 把原嵌入与更安全投影混合,toxic 侧门更陡、safe 侧更缓。类别相关的 α 控制各风险维强度。结构 token 保持不动。作者强调无需改 LDM、也无需为 SAGE 另训生成器。
- 生成阶段用 flow-matching 迭代去噪。在选定中间步 i,用一步估计得到干净潜变量近似,送入 Latent Detection;判 Unsafe 则 Early Termination 并跳过后续步,否则继续到 VAE Decoder。部署步在文中按模型选择,潜检测 Avg F1 接近成片检测。
- 数据与评测侧,RevGen 从真实图像反向得到提示,再经改写加入受控 IP 角色,形成分级色情/血腥、类别化 IP 与难分良性负例,共一万条。潜检测器采用两阶段:大规模 VAE 特征蒸馏预训练,再用生成轨迹上的安全标签微调。预训练数据准备比微调轨迹快数十到上百倍。
逐图理解论文
外护栏的三处盲区
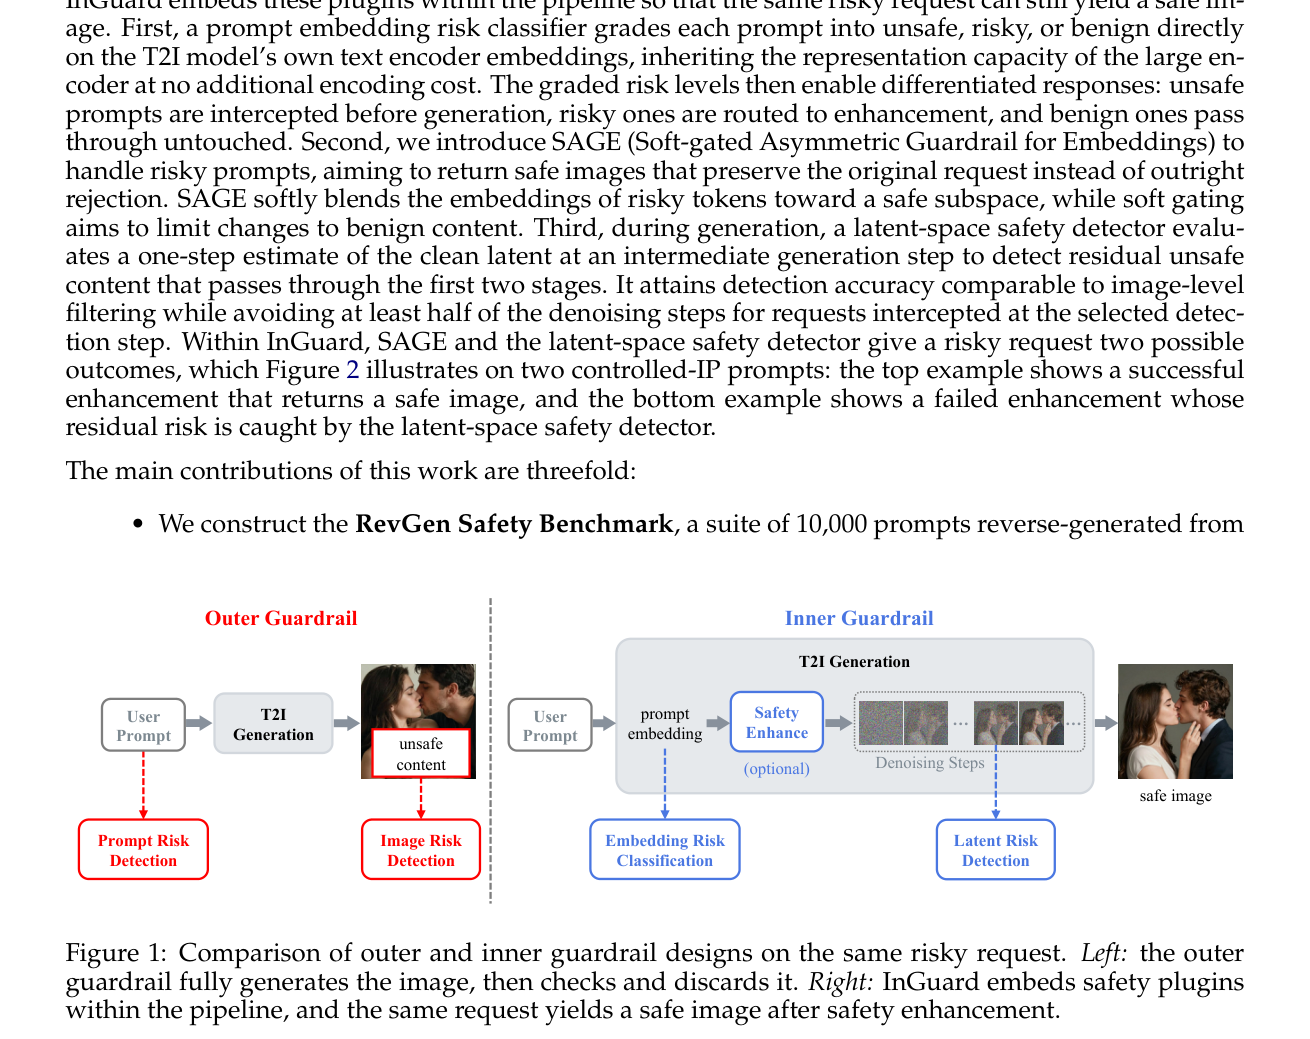
左右对比同一风险请求。左侧红系 Outer Guardrail:提示经 T2I 生成出成片后,再靠 Prompt/Image Risk Detection;成片被标为 unsafe content 并丢弃,算力已经花完。右侧蓝系 InGuard:提示先到 prompt embedding,经 Embedding Risk Classification,可选 Safety Enhance,再在 Denoising Steps 上做 Latent Risk Detection,最终走向 safe image。解读只谈流程差异,不描述示意画面的不当细节。
三级内护栏
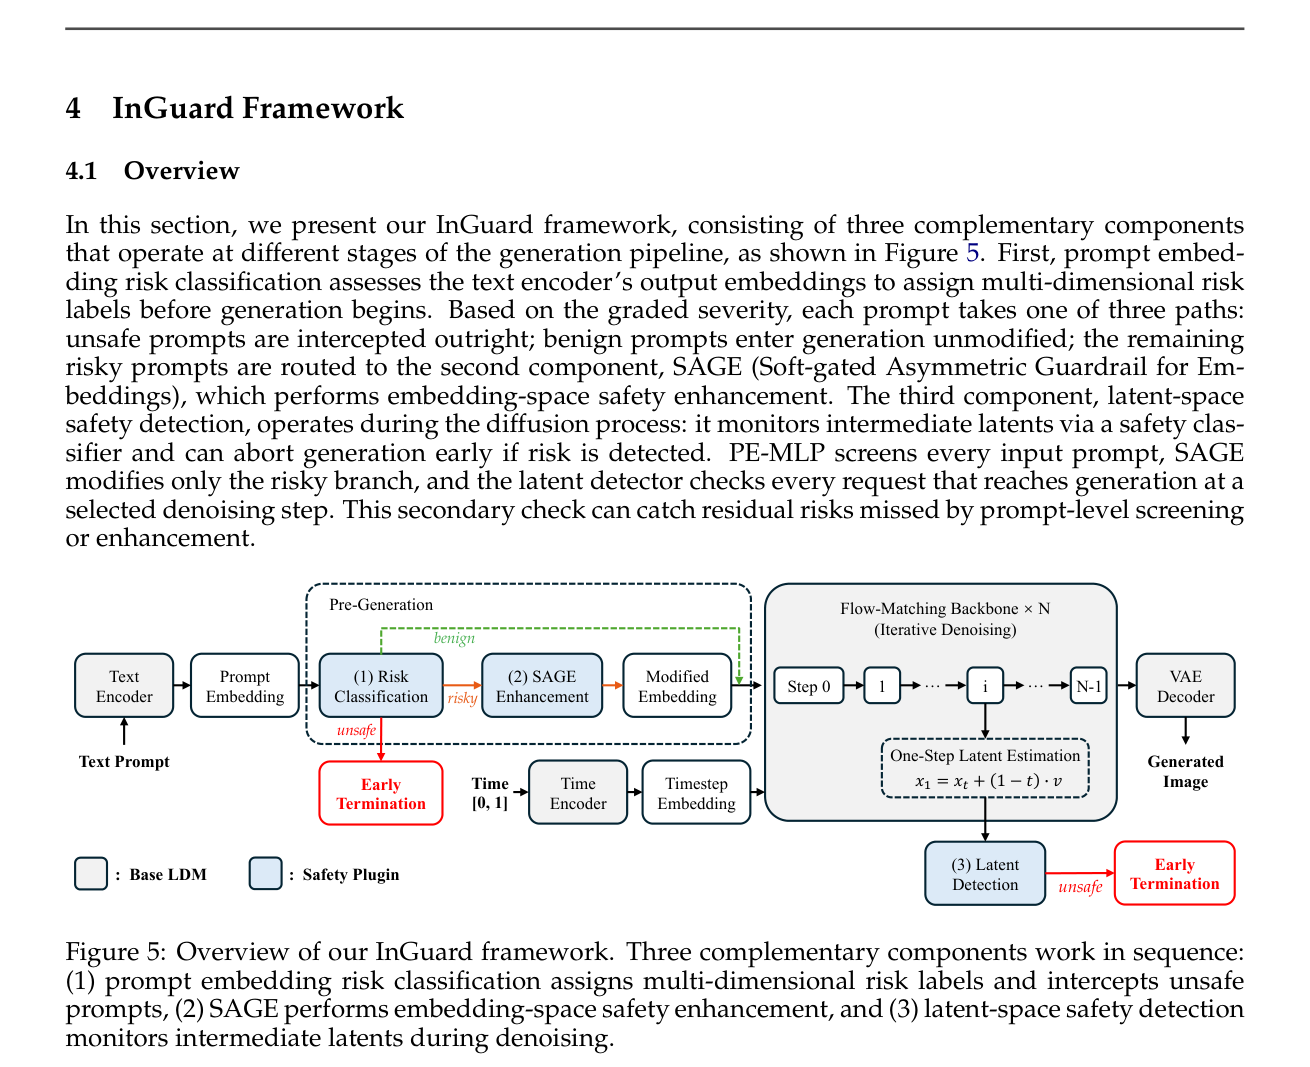
InGuard 总览。绿虚线框是生成前:Text Prompt→Text Encoder→Prompt Embedding,经 Risk Classification 分成 Unsafe 早停、Benign 旁路、Risky 进 SAGE Enhancement,得到 Modified Embedding。灰框生成阶段:Modified Embedding 与 Time Encoder 进入 Flow-Matching Backbone 迭代去噪;在步 i 做 One-Step Latent Estimation 并 Latent Detection,Unsafe 则早停。通过则 VAE Decoder 出 Generated Image。白框是基座,蓝框是安全插件。用它区分外挂检查与内嵌插件。
两种结局
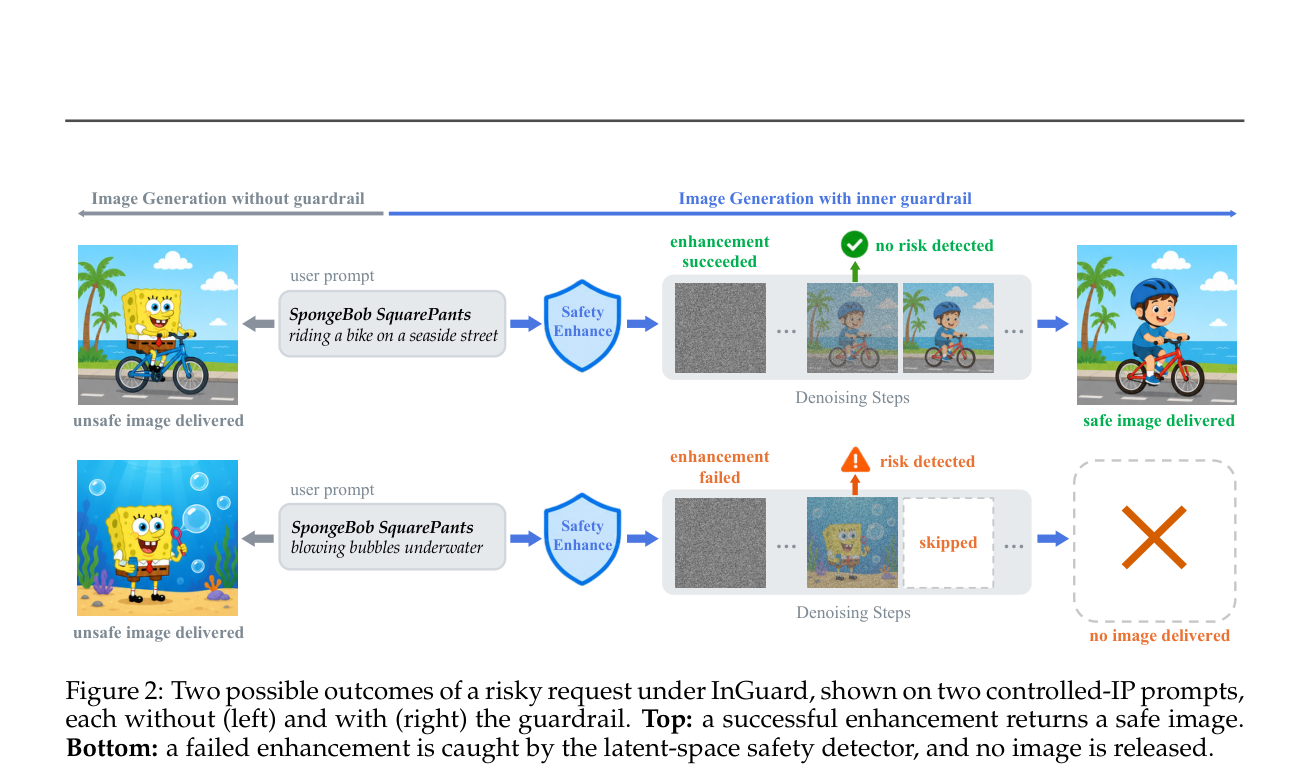
两条受控 IP 提示的结局。上行:无护栏直接交付违规角色图;有内护栏时经 Safety Enhance,中途 no risk detected,最终交付去角色化的安全图。下行:增强失败,中途 risk detected,后续步 skipped,结果 no image delivered。它说明内护栏既可纠偏也可中止,而不是只做事后丢图。
实验如何设计?
- 骨干:Z-Image-Turbo、Qwen-Image-2512、HunyuanImage-2.1、FLUX.2-klein-base-9B、InternVL-U。护栏分类器按后端适配,基座权重冻结。
- 系统对比三配置:无护栏;外护栏 = mE5 提示分类 + ConvNeXt-Base 成片分类;内护栏 = PE-MLP + SAGE + ConvNeXt-Base 潜检测。
- 安全率:最终图像安全或请求被拦截都算安全。良性打扰:提示与未加护栏原图都安全时,仍被拦截或被 VLM 判定语义改动的比例。
- 工作点按模型设定拦截阈值;外护栏文本阈值示例为 porn≥3、gore≥2。比较的是完整系统,不是对齐阈值后的单分类器。
关键结果与论文证据
- 表 8:五模型上 Inner 安全率 97.90–98.78%,均不低于对应 Outer;良性打扰从约 9.3–10.6% 降到 2.6–4.5%。附加参数从 370.6M 降到约 100M,约 3.7×。无护栏安全率仅 44–57% 量级,说明开放模型裸用不行。
- 以 Z-Image-Turbo 为例:Outer 98.18% 安全 / 9.93% 打扰,Inner 98.23% / 2.63%。FLUX.2-klein 上 Inner 安全率 98.59%,高于 Outer 的 97.02%,差距更明显。
- 表 5:PE-MLP 在各后端的 Porn/Gore/IP 准确率高于 mE5 与 mBERT,FA 更低,说明“复用模型自己的嵌入”带来提示侧收益。
- 中途潜检测:在所选步上 Avg F1 与成片检测相差约 0.26–1.71%;拦截时可跳过约 50–55.6% 去噪步。作者提醒这不等于端到端时延同比例下降,因为还不含文本编码、SAGE 与 VAE 等。
- 图 2 用受控 IP 提示展示两条结局:增强成功则继续去噪并交付安全图;增强失败且中途仍检出风险则跳过后续步、不交付图像。它说明内护栏不是只会拒绝,也可以先改嵌入再监视。
阅读时需要注意
- SAGE 绑在分类器与有限概念集上;对抗改写和多角色 IP 仍待加强。
- 策略覆盖目前主要是三类风险,其他维度未评。
- 一步潜变量估计能否迁移到新生成器与视频仍未知。
- 表 8 是系统级工作点比较,不能直接归因到某一个插件。
- 敏感示意仅用于说明机制;公开资源应用于防御研究,不应被用来制造违规内容。
关联工作
- 外护栏把安全当成输入输出过滤器;内护栏把安全当成表示空间里的路由、改写与早停。
- 提示改写类方法也能减少硬拒绝;SAGE 的差别是直接在模型嵌入上做标签门控混合,并与中途潜检测串联。
- RevGen 强调反向生成与难分负例,用来逼近真实部署分布,而不是只堆极端违规词。