快速导读:CMU+Meta 提出 TrackEverything:体素去重的世界坐标 3D 轨迹 + 静动分解 + 3D WAFT,使全点跟踪扩展到 1000+ 帧并报告在 40GB 内可行。
点跟踪长期存在取舍:稀疏跟踪能拉长时域但只跟少量查询点;稠密跟踪想跟所有点,却往往困在数十帧短片,因为按帧的 2D 表示会随时长线性堆冗余。CMU 与 Meta 的 Ayush Jain、Sreeharsha Paruchuri、Ishita Gupta、Fan Zhang、Tanner Schmidt、Jakob Engel、Katerina Fragkiadaki、Adam W. Harley 提出 TrackEverything(arXiv:2609.30222,预印本):把视频建成世界坐标下的持久 3D 场景轨迹,使复杂度随独特几何增长而非帧数。
三项要点:窗口边界体素去重合并共位轨迹;端点精炼器预测终点并做静/动分类,轨迹精炼器只为动态点解码密轨迹;3D WAFT 用场景云特征采样替代昂贵 4D 相关体。摘要称其是首个能在约 40 GB 显存内对超 1000 帧视频做全可见点 3D 跟踪的方法。项目页 https://trackeverything.github.io/(HTTP 200);详细可视化与补充材料见该页。
英文题目:TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
论文出处:arXiv 每日论文精选 · arXiv:2609.30222
原始论文:PDF / 论文页面
这篇论文解决什么问题?
按帧处理会把已见过的表面再次编码成整栅格 token,内存与算力随 T 线性涨。稀疏跟踪(如 CoTracker 系、SpatialTracker-v2、TAPIP-3D)可做长时域,但只覆盖查询点;首帧稠密法忽略后出现的表面;全帧稠密法(VDPM、D4RT、TraceAnything 等)又多停在约 48–64 帧量级。
作者强调视频是 3D 世界的 2D 投影:若在世界坐标维护实体,同一物理表面不应随帧复制。缺口在于如何在滑动窗口间去重,并在长视频上仍解码稠密运动。
既有 3D 稀疏跟踪器内部特征云仍常按帧保留整栅格,内存仍随时长涨。需要「随场景内容扩展、随重复观察收缩」的表示。
核心创新
- 窗口边界体素去重,使表示随独特几何而非帧数增长。
- 端点—轨迹分解,把密解码集中在动态表面。
- 3D WAFT 特征采样,避开内存敏感的 4D 相关体。
方法概览
滑动窗口反投影 3D 特征云;端点精炼预测终点与静/动;轨迹精炼只解码动态点;窗口边界体素合并共位轨迹;3D WAFT 替代 4D 相关。
- 输入 RGB 与世界坐标点图(传感器或 VGGT-Ω 等)。非重叠窗口 L=16:冻结 DINOv3-small + 可训练 ViT Adapter 提 2D 特征,按点图反投影为 3D 特征云,并做帧内体素合并降空间冗余。
- 端点精炼:循环 Transformer 结合源/目标位置嵌入与 3D WAFT(在投影源/目标处采样特征做模板匹配)迭代预测窗口末端 3D 偏移、可见性与静/动分类。
- 轨迹精炼:动态点用匀速初始化,再经轨内时序自注意力与 [CLS] 对场景云的交叉注意力解码密轨迹;静点在世界坐标保持不动。窗口边界按更新后位置体素化,共位轨迹 mean-pool 合并,再与新显现内容一起进入下一窗。
- 另支持非体素化的用户查询点分支,避免关键点被不可逆合并。训练数据含 Kubric、PointOdyssey 等。
逐图理解论文
冗余瓶颈
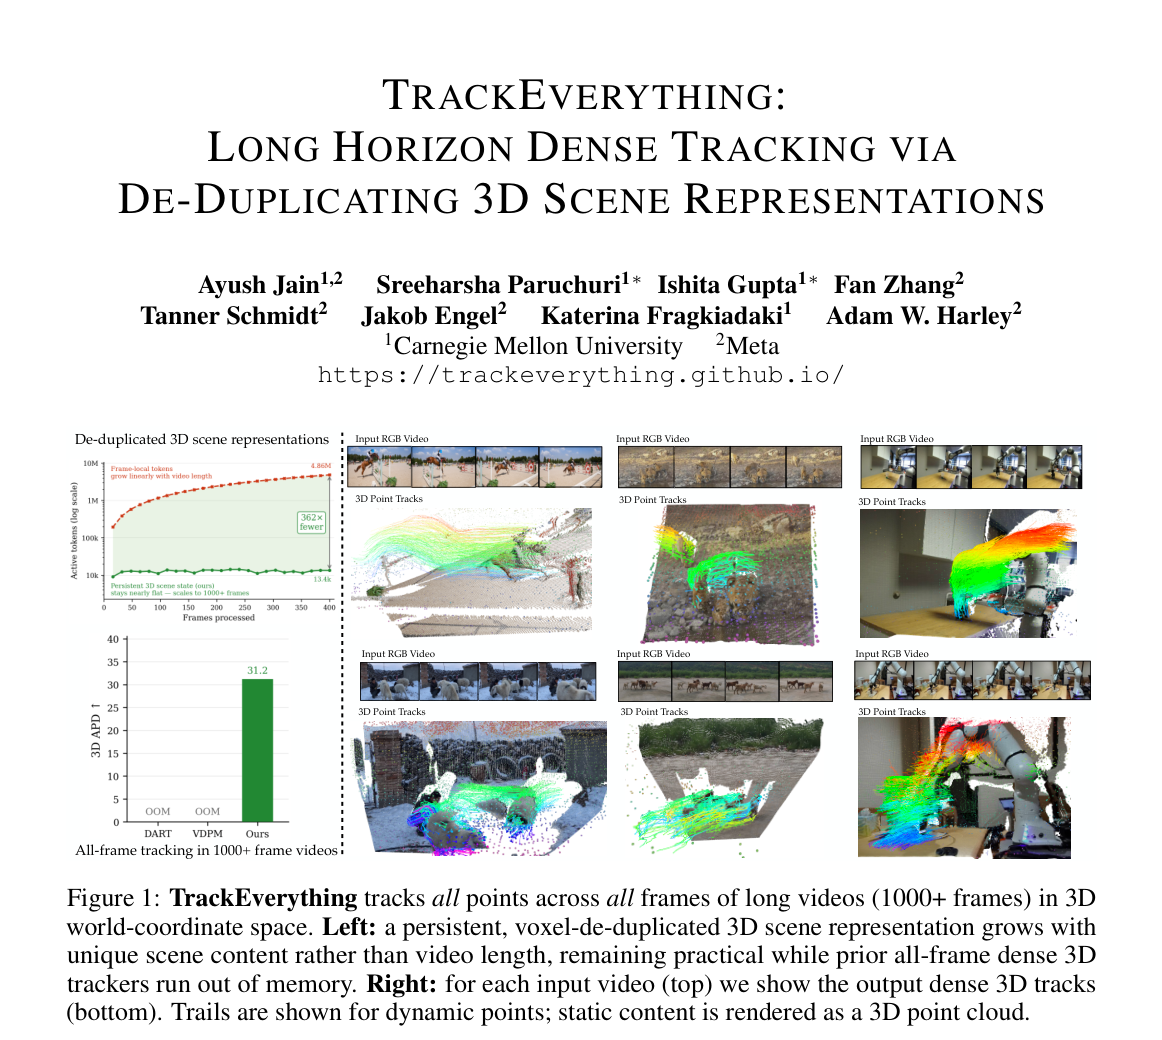
左上:active tokens 随帧数,帧局部红虚线升到 4.86M,持久 3D 绿线约 13.4k(标 362× fewer)。左下:1000+ 帧全点跟踪柱,DART/VDPM OOM,Ours 31.2。右:六组 RGB 与 3D 轨迹,动态拖尾、静态点云。适合特色图。
扩展与新内容
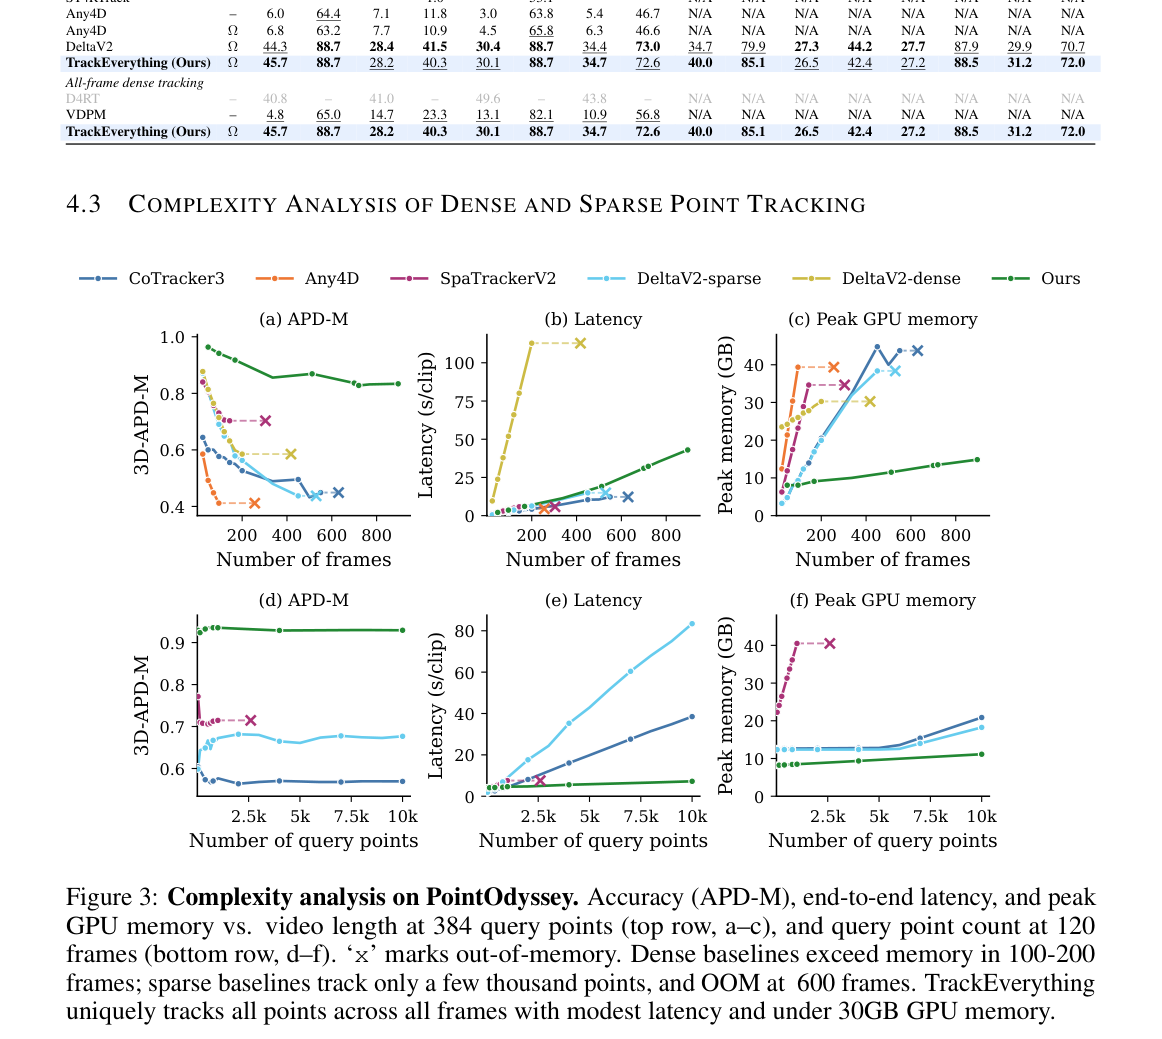
PointOdyssey 复杂度六图:对帧数与查询点数扫 APD-M、延迟、峰值显存。绿线 Ours 更平坦;竞品出现 x=OOM。支撑「长视频全点仍可在数十 GB 内」的叙述,具体峰值以正文 caption(under 30GB)与摘要(40GB)口径区分。
Figure 4: Qualitative comparison against baselines
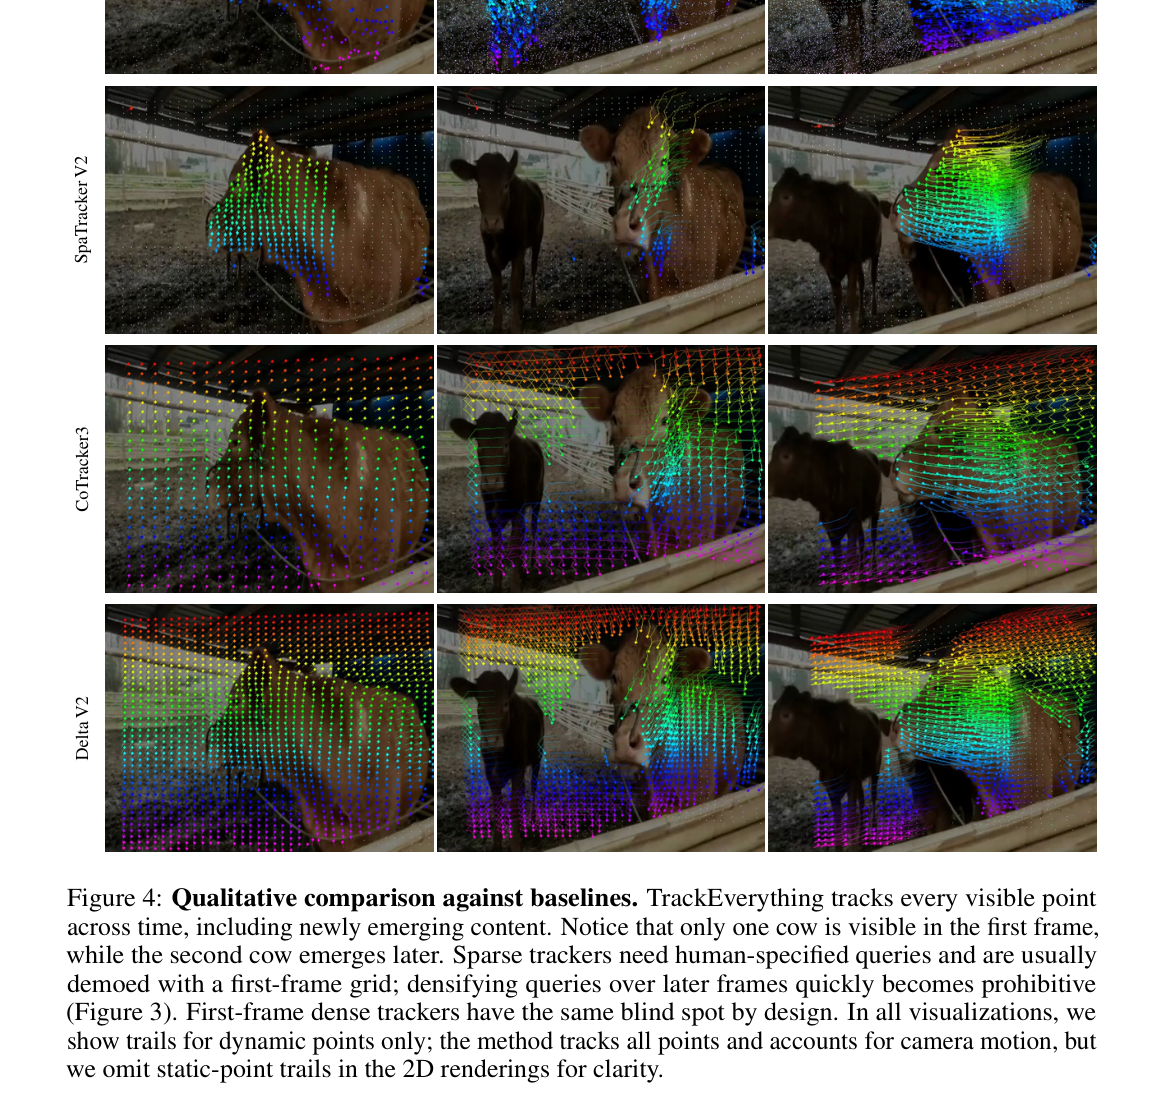
牛舍序列:仅第一帧有一头牛,后帧第二头牛进入。TrackEverything 两头都有密点;SpaTracker V2、CoTracker3、Delta V2 行几乎只跟首帧主体。说明全可见点与新内容覆盖。
实验如何设计?
- TAPVid-3D:ADT / DriveTrack / PStudio,报告 short(首 48 帧)与 full-length 的 APD-P / APD-M;几何默认 VGGT-Ω。对照含稀疏、首帧稠密与全帧稠密开源方法;闭源 D4RT 不参与排名。
- Fig.3 / PointOdyssey 复杂度:在单卡 L40S-46G 上扫帧数与查询点数,记 APD-M、端到端延迟与峰值显存;x 标记 OOM。
- Fig.4 定性:后出现的第二头牛等新内容;并强调动态点才画拖尾以便阅读。局限写依赖外部几何与不可逆合并风险。
关键结果与论文证据
- Table 1:TrackEverything 全长平均 APD-P / APD-M 为 31.2 / 72.0;短clip 平均 34.7 / 72.6。相对开源全帧稠密基线,摘要称短片 APD 高出 20% 以上;长序列上与强稀疏跟踪器接近,同时跟踪点数量远多。
- Fig.1:400 帧时持久 3D 状态约 13.4k active tokens,相对帧局部 4.86M 约少 362×;长视频柱状图标 Ours APD 31.2,而 DART/VDPM 标 OOM。
- Fig.3:稠密基线约 100–200 帧 OOM;稀疏基线约 600 帧 OOM 且只跟数千点。TrackEverything 在长视频与上万查询设定下延迟与显存增长更缓,文称稠密全点跟踪峰值可低于约 30 GB(摘要口径为 1000+ 帧、40 GB 内)。
- Fig.4:相对 SpaTracker V2、CoTracker3、Delta V2 等首帧/稀疏演示习惯,TrackEverything 在第二头牛进入后自动密化新表面。
阅读时需要注意
- 开放世界持续探索时活跃内存仍会增长,超长时域需要空间缓存淘汰。
- 依赖外部点图质量,误差会传导到跟踪。
- 窗口边界按空间邻近做不可逆 mean-pool,误合并可能永久黏连不同表面;虽可用查询点分支保护,但去重机制仍待改进。
- 更大模型容量与更广预训练或能改善复杂真实动态。
关联工作
- 稀疏 3D 跟踪(SpatialTracker-v2、TAPIP-3D)证明世界坐标有用,但常保留按帧特征云。
- 首帧稠密(AllTracker、DELTA、Any4D、DeltaV2)长时域更稳,却盲于后出现内容。
- 全帧稠密短片法把每帧表面当独立实体,预测量随分辨率×帧数爆炸;TrackEverything 用去重把尺度绑到独特几何。