快速导读:COSA-GS 在 Scaffold-GS 锚点上用无空间聚合的锚内因果上下文建模属性分布,结合率失真优化、自适应剪枝与整数量化感知推理,实现强压缩与跨平台比特级一致解码。
三维高斯溅射能高质量新视角合成,但显式高斯原语与外观几何参数带来沉重存储与传输成本。现有压缩常在不规则三维结构上抽取空间上下文,推高训练与编解码复杂度;浮点上下文推理还可能在不同平台产生概率偏差,直接导致熵解码失败。
COSA-GS(arXiv:2609.30245,中山大学 / 鹏城实验室等;代码 https://github.com/pengpeng-yu/COSA-GS 。主张:用合适的上下文诱导,优化本身就能削弱锚点间依赖,把剩余依赖收束到锚点内部,从而用更简单的锚内建模替代复杂空间聚合,并配合整数量化拿到跨平台一致的快速解码。
英文题目:Towards Practical Compression of 3D Gaussian Splatting
论文出处:arXiv 每日论文精选 · arXiv:2609.30245
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Scaffold-GS 已经用锚点、可学习偏移与视点条件属性提供了更紧凑的基底,后续 HAC/HAC++、ContextGS、PCGS 等继续用哈希网格或层级已解码锚点做空间上下文,率失真不错,但流水线更重、速度受限。
与此同时,神经压缩经验反复提醒:编码器与解码器必须对同一符号算出一致概率;平台相关的浮点差异足以让算术/熵解码崩溃。于是实用目标变成三件事同时成立——强率失真、简单高速、跨平台 bit-exact。
COSA-GS 的直觉不是“丢掉空间信息”,而是把空间线索收成每个锚点自己的坐标导出几何上下文,再在锚内做因果因子化。
核心创新
- 无空间聚合:用锚内坐标→潜变量→属性的因果因子化替代不规则三维空间上下文。
- 上下文仅由线性变换与激活组成,结构简单,利于高速编解码。
- 率失真优化 + 自适应偏移掩码剪枝,在质量与码率间可调。
- 量化感知训练与整数推理,实现跨 GPU/CPU 平台解码一致。
方法概览
COSA-GS(Context without Spatial Aggregation)对每个锚点:由归一化坐标经 MLP 得几何上下文 cgi;用 cgi 因果建模紧凑可学习锚点潜变量 zi;融合后得锚点上下文 cai,再并行/分支建模特征、位置缩放、偏移掩码、偏移与高斯缩放。坐标用八叉树占用编码。训练用 L1+SSIM 与各属性率项的率失真目标,并用偏移掩码做自适应高斯剪枝。部署侧对上下文模型做 8-bit QAT 与整数线性推理,保证熵解码符号跨平台 bit-exact。
- 表示与坐标:基于 Scaffold-GS 锚点;锚点坐标经八叉树占用符号按层共享经验分布编码,解码逐层展开精确恢复最细层整数坐标,再还原度量坐标用于上下文。
- 几何上下文与潜变量:对锚点 i,归一化坐标经 MLP 得 cgi;引入场景可学习紧凑潜变量 zi,按通道对 cgi 与已重建潜变量通道做因果高斯条件建模,锚点之间仍可并行。
- 锚点上下文:全部潜变量重建后,cai = Fa([cgi; Ez(ẑi)]),仅线性+GELU。随后用 cai 建模特征 f、位置缩放 r;嵌入重建的 r 后再建模偏移 o(受二值偏移掩码 m 约束)与高斯缩放 s。
- 率失真:图像项为 (1−α)L1 + α(1−SSIM)(α=0.2),加上潜变量与各属性组的率项,λ 控制权衡;掩码抑制不活跃高斯并剪掉无活跃偏移的锚点。
- 跨平台:对激活做 per-tensor 仿射 8-bit、对权重做 per-channel 对称 8-bit,QAT 适应量化;推理时整数线性累加,保证熵解码符号跨平台一致。
逐图理解论文
锚内因果建模
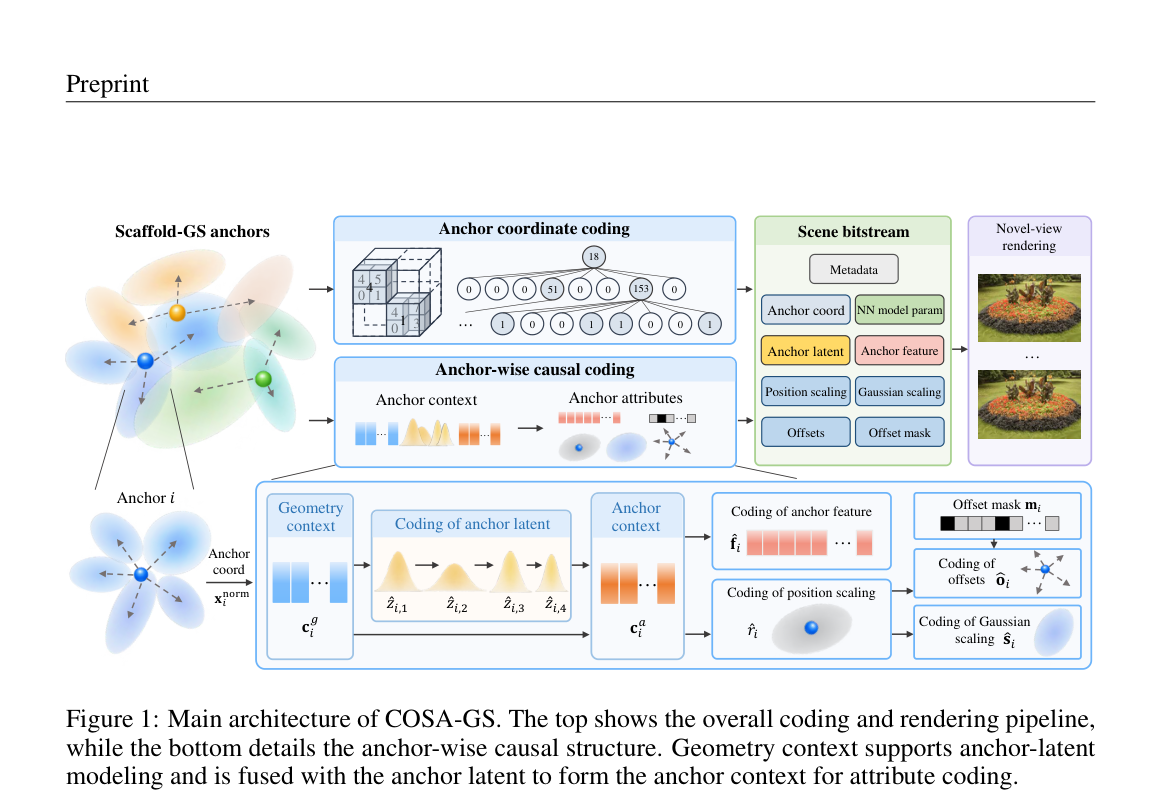
图1总览:上排从 Scaffold-GS 锚点到坐标编码、锚内因果编码、场景码流与新视角渲染;下排展开单锚点路径——几何上下文建模潜变量,再融合为锚点上下文,驱动特征/缩放/偏移掩码/偏移/高斯缩放编码。适合作为方法主图与特色图。
训练与整数推理
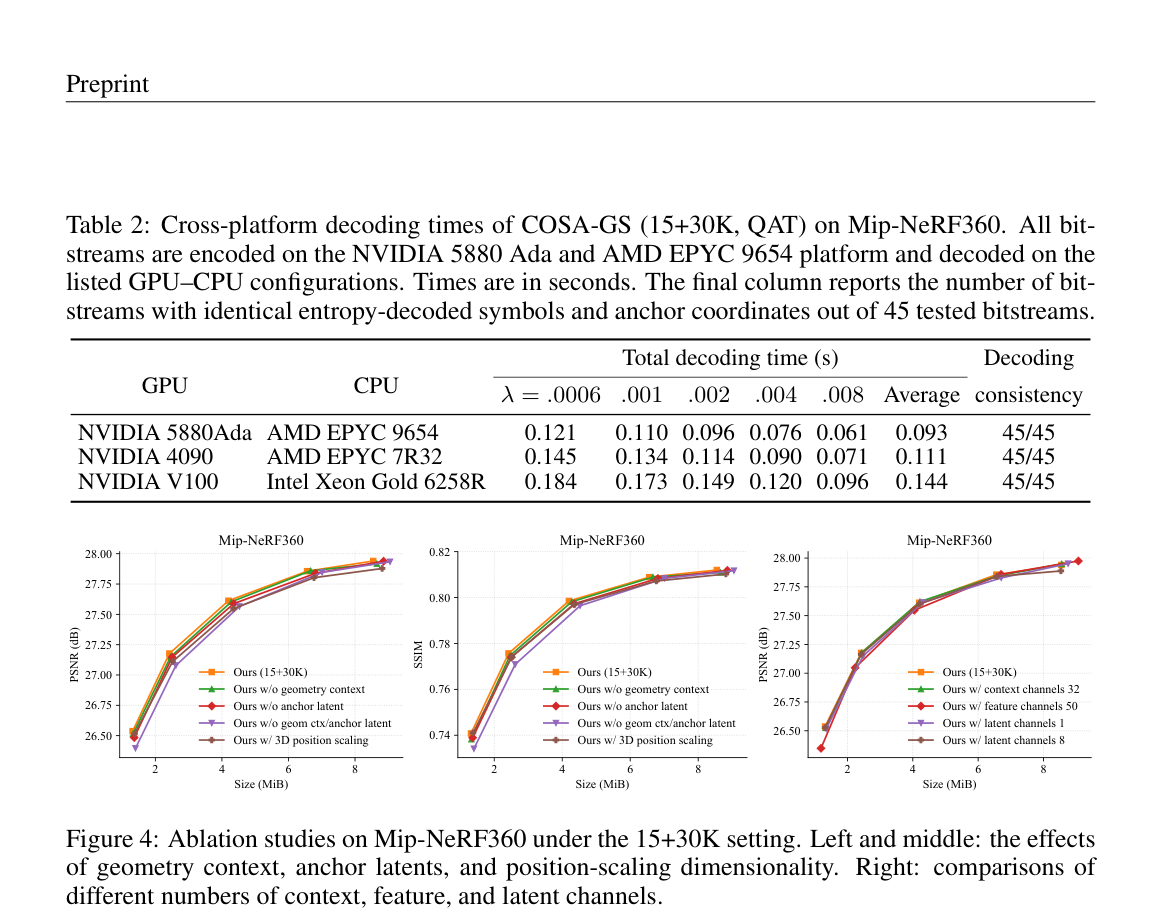
图4在 Mip-NeRF360(15+30K)上做消融:左中显示去掉几何上下文或锚点潜变量会损害 PSNR/SSIM–体积曲线;右侧比较不同通道配置。同页跨平台表则给出 QAT 解码一致与亚秒耗时,支撑设计选择。
关键证据
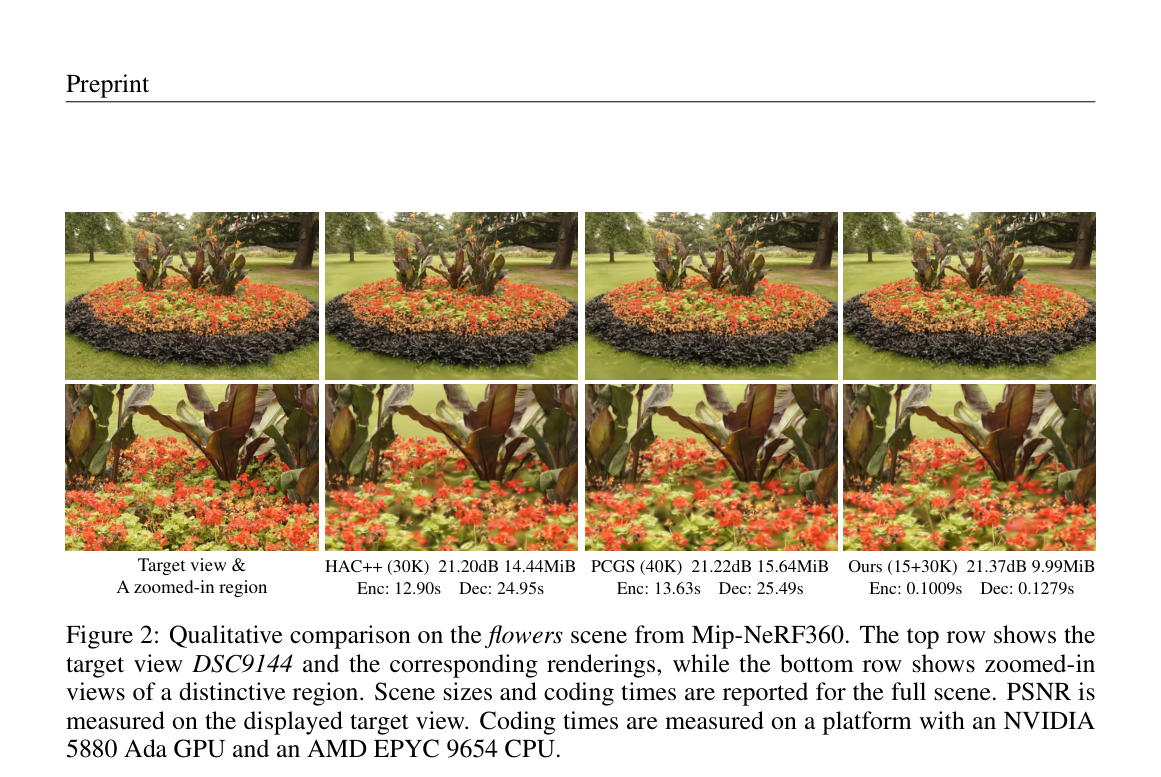
图2在 flowers 场景对比目标视图与 HAC++、PCGS、Ours 的渲染与局部放大,并标注 PSNR、整场景体积与编解码时间。Ours 以更小体积和亚秒级编解码达到更高单视图 PSNR,是“实用速度”最直观证据。
实验如何设计?
- 数据集:Mip-NeRF360、DeepBlending、Tanks&Temples、BungeeNeRF,遵循 Scaffold-GS/HAC++/PCGS 等公开分辨率与训练/测试划分。
- 主对比:率失真曲线(PSNR/SSIM/LPIPS)与定性渲染;报告整场景体积与编解码墙钟时间(含 warmup 协议)。
- 消融:去几何上下文、去锚点潜变量、位置缩放维度,以及 context/feature/latent 通道数。
- 一致性:QAT 模型在多套 NVIDIA GPU + CPU 组合上统计解码时间与符号一致率;附录分析码流组成。
关键结果与论文证据
- Figure 2(Mip-NeRF360 flowers):Ours(15+30K) 单视图 PSNR 21.37dB、整场景约 9.99MiB,Enc/Dec 约 0.10/0.13s;HAC++ 约 14.44MiB 且 Enc/Dec 约 12.9/25.0s,PCGS 约 15.64MiB——体积更小、编解码约两个数量级更快(页7)。
- Figure 3 率失真曲线显示在多数据集上相对现有方法具竞争力;增加优化步数通常改善曲线但边际递减,BungeeNeRF 上不同步数更接近。
- Figure 4 消融:完整模型在 PSNR/SSIM–体积平面上优于去掉几何上下文或锚点潜变量的变体;通道配置影响曲线形状。
- 跨平台表:三套硬件解码一致性均为 45/45,平均解码约 0.093–0.144s,支撑“实用一致解码”主张(页9)。
- 码流:中高码率下特征与偏移占主导,潜变量仅数个百分点即可服务多组属性分布;低码率时坐标与元数据占比上升(页13)。
阅读时需要注意
- 方法绑定锚点式 Scaffold 表示,迁移到其他 3DGS 参数化需额外适配。
- 最终点依赖 λ、步数与 QAT 导出是否正确;不同数据集对训练预算敏感度不同。
- 计时口径不含渲染与磁盘 I/O,系统端到端延迟需另测。
关联工作
- 表示与压缩:3DGS、Scaffold-GS、HAC/HAC++、ContextGS、PCGS、LightGaussian 等。
- 一致解码:Ballé 整数网络、视频/点云压缩中的模型整型化工作。
- 开源复现:官方仓库提供训练、压缩、解压与评测脚本。