快速导读:PROVE 按问题证据结构路由到三体制与五算子子集,并用确定性证明特征校准权重,在医疗 VQA 黑盒幻觉检测上达到 0.821 AUROC。
医疗视觉问答里,前沿 VLM 可能给出自信却错误的回答:左右侧搞反、捏造不存在的病灶、或给出与可见病理矛盾的诊断。对诊断辅助场景,哪怕单次错误也可能误导后续决策,因此需要可靠的幻觉检测。现有黑盒方法要么盯回答一致性,要么做视觉证据核验,但都对所有问题套同一策略,容易漏掉系统性盲区,也会对简单感知题过度报警。
复旦大学团队提出 PROVE(Proof-guided Regime-aware Operator VErification,arXiv:2609.29604 ,摘要页 https://arxiv.org/abs/2609.29604 )。它先按问题所需视觉证据结构分到三种核验体制,再激活体制对应的算子子集,最后用确定性问答特征做轻量校准,输出幻觉风险分。重要声明:这是黑盒研究型检测框架与评测结果解读,不是临床可用产品,也不能替代医生判断或医院部署验收。
英文题目:PROVE: Proof-guided Regime-aware Operator Verification for Hallucination Detection in Medical Visual Question Answering
论文出处:arXiv 每日论文精选 · arXiv:2609.29604
原始论文:PDF / 论文页面
这篇论文解决什么问题?
API 部署下无法读取权重、注意力或 token 概率,检测器只能重新提问并观察回复。一致性方法在左右侧约定错误上常失败:重采样会复现同一错误约定,风险被判为零;证据核验若仍沿用问题框架,也可能重复同一误解(Fig.1,第1–2页)。
另一端是过度核验:对“肋骨在不在 CT 上”这类简单感知题,为难题设计的算子会制造误报。作者在 VQA-RAD 训练样本上观察到幻觉模式按证据链长度聚类,提示应先决定“需要什么核验”,再决定“怎么核验”(第2–3页)。
因此目标不是再加一个统一分数,而是按证据结构路由到不同算子组合,并在同一体制内按问题特征微调权重,同时避免漏检与误报。
核心创新
- 按证据结构把问题路由到三种核验体制与对应算子子集。
- 五类互补黑盒算子覆盖改写、干扰、落地、充分性与主张分解。
- 确定性证明特征条件化算子权重,兼顾体制间与问题内差异。
- 在三基准四模型上相对强基线 +0.159 AUROC,并泛化到未见基准。
方法概览
零样本体制分类(感知/属性/组合)→体制路由五算子多查询→β/ν/κ 自适应校准得到风险分;参数在 VQA-RAD 用逻辑回归拟合。
- 输入为图像 I、问题 q、VLM 答案 a,输出风险分 s∈[0,1]。流水线三阶段:零样本体制分类 → 体制特定算子多查询执行 → 自适应校准聚合(Fig.2,第4页)。
- 三种体制:Perceptual(确认单一实体或全局属性,如模态/有无骨折);Attribute(先定位实体再抽属性,如侧别/正常与否);Compositional(多观察、空间关系或开放描述)。训练数据上幻觉率约 20%→33%→48% 单调上升(第3页)。
- 五个互补算子:Consistency(改写稳定性)、Contrast(临床邻近干扰项)、Grounding(框架分离的独立证据引出)、Sufficiency(图像信息是否足够)、Claim Decomposition(多主张原子核验)。路由见表1:感知激活 CS/CT/GR;属性激活 CT/GR/SF;组合激活 CT/GR/SF/CD;无效算子直接排除而非降权(第4页)。
- 校准用三个确定性证明特征:答案有界性 β、视觉特异性 ν、主张复杂度 κ。权重 w_k=α+λ(ϕ−均值),再经 sigmoid 得到风险分;参数按体制用逻辑回归在 VQA-RAD 拟合,体量很小(式4–5、Algorithm 1,第5页)。
逐图理解论文
问题背景
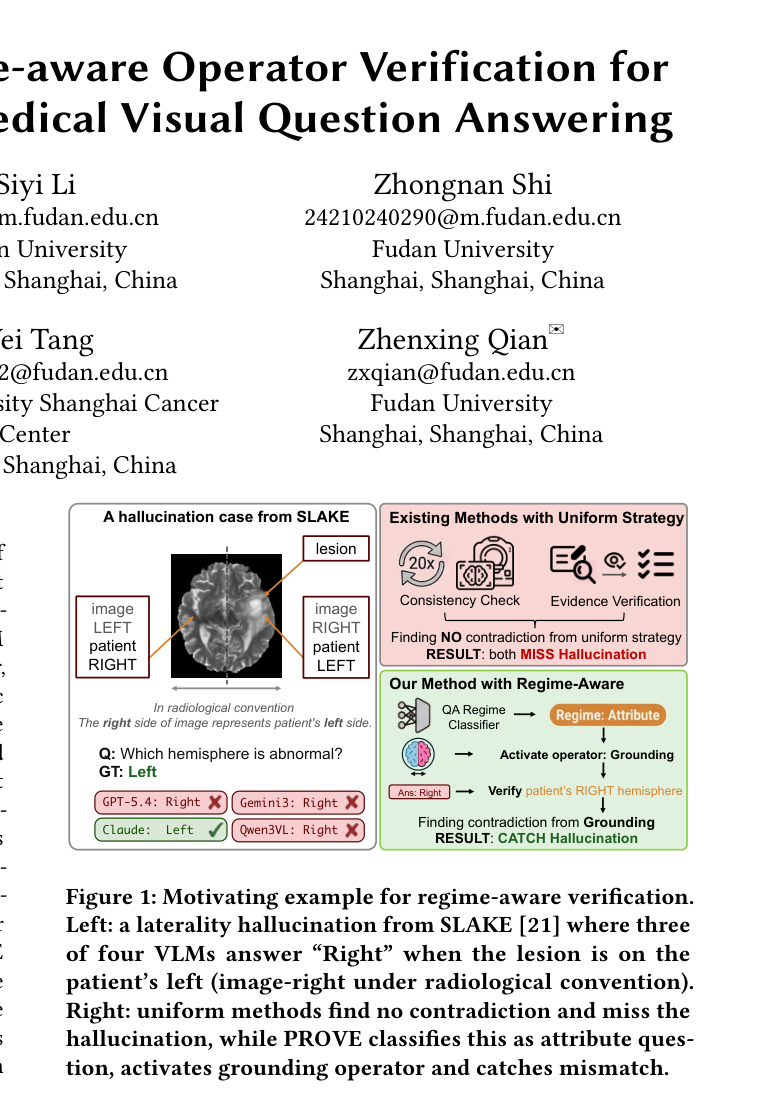
Fig.1 动机例:SLAKE 脑 MRI 病灶在患者左侧(影像右侧),三模型答 Right;统一一致性/证据核验未找到矛盾而漏检;PROVE 判为 Attribute 体制并激活 Grounding,抓住侧别约定错误。适合开场。
方法总览
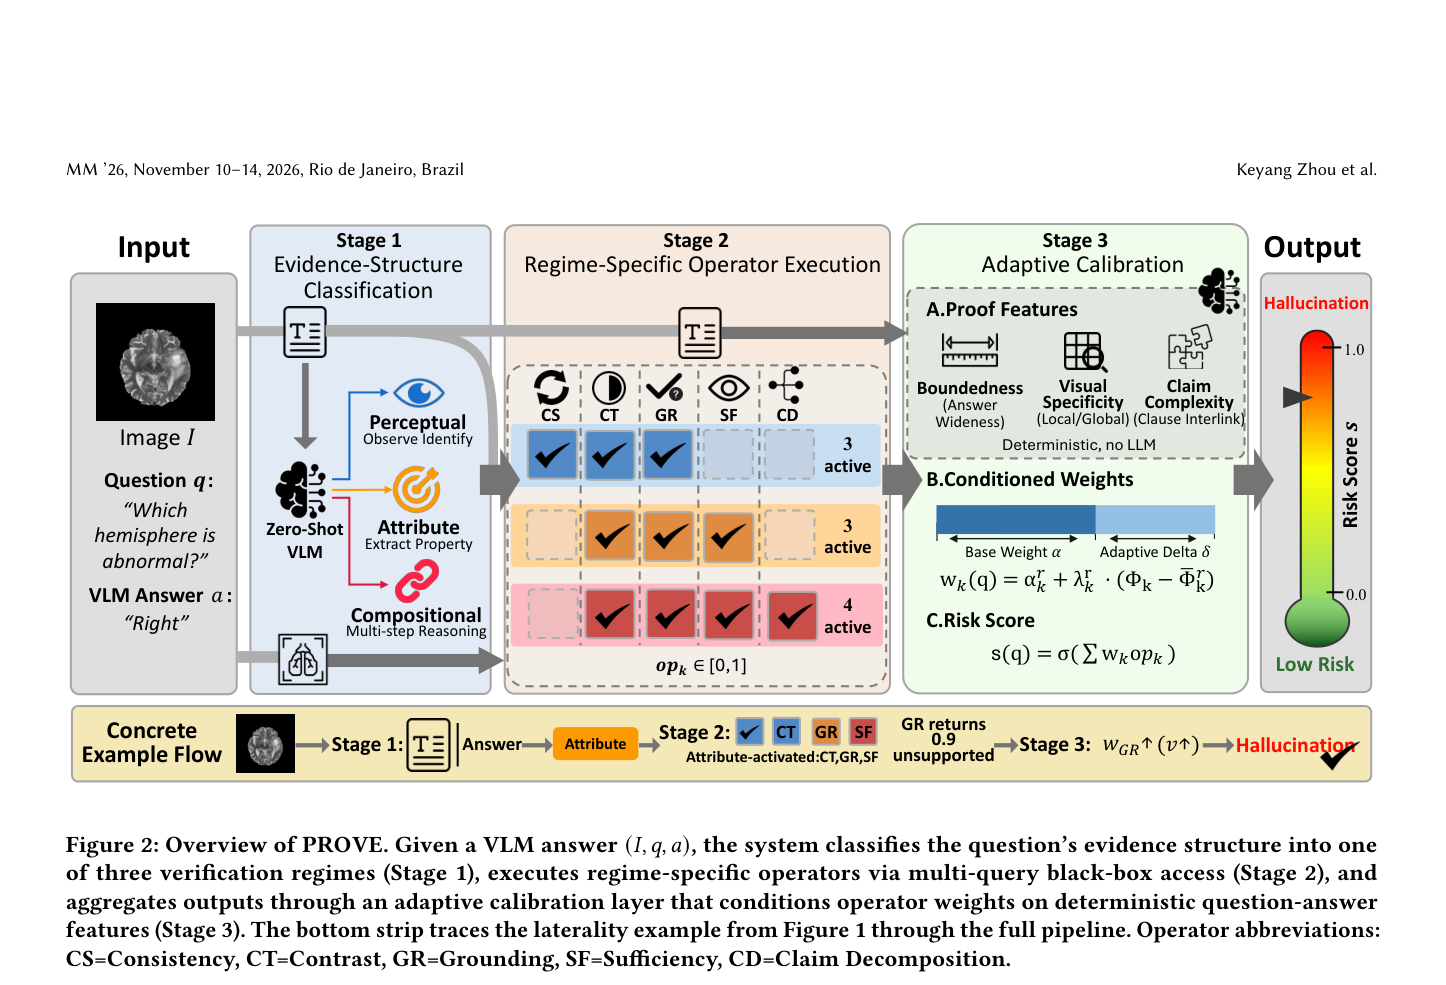
Fig.2 方法总图:Stage1 零样本分到三体制;Stage2 体制特定执行 CS/CT/GR/SF/CD;Stage3 用 β/ν/κ 做条件权重并输出风险分。底栏复现 laterality 例子。适合方法主图与特色图。
关键证据
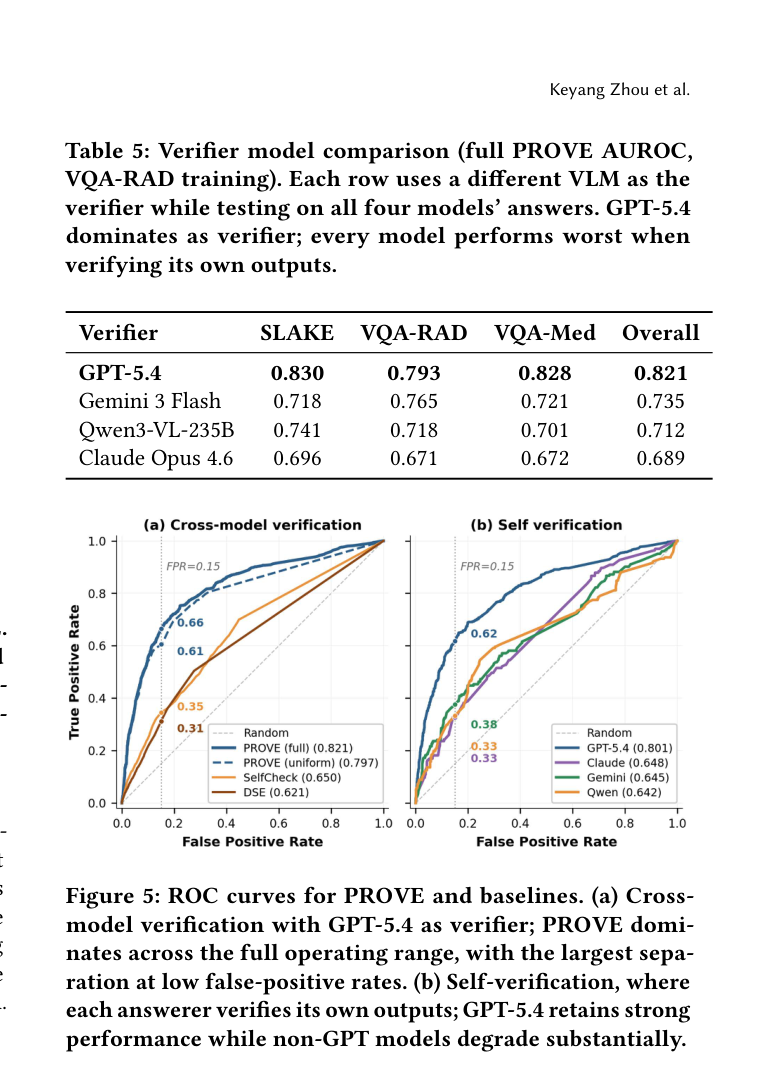
Fig.5 ROC:交叉核验下 PROVE 0.821 全面压过 SelfCheck/DSE;自核验时 GPT-5.4 仍较强,其他模型明显下滑。配合 Table 2 读主结果。
实验如何设计?
- 测试共 8,048 条:SLAKE 4,244、VQA-RAD 1,804、VQA-Med-2019 2,000;回答模型为 GPT-5.4、Claude Opus 4.6、Gemini 3 Flash、Qwen3-VL-235B;默认交叉核验器用 GPT-5.4;每算子 K=3 轮(第6页)。
- PROVE 只在 VQA-RAD 训练 7,168 条上拟合;SLAKE 与 VQA-Med-2019 完全未见。体制分布:感知 5,448、属性 728、组合 1,872。
- 基线含 DSE、SelfCheck、RadFlag、FAITHSCORE、LogicCheckGPT,统一用 GPT-5.4 作核验器;主指标 AUROC;另做路由/校准 2×2、单算子消融与核验器对照(Table 2–5,第6–8页)。
关键结果与论文证据
- 总体 AUROC 0.821,强于最强基线 SelfCheck 0.662(+0.159),也强于 FAITHSCORE 0.528(+0.293);未见训练的 SLAKE / VQA-Med-2019 上分别 0.830 / 0.828(Table 2,第7页)。
- 按回答模型,Claude Opus 4.6 上达 0.844(流畅但欠落地的错误更易被 grounding 抓住),GPT-5.4 最难核验(0.801)。无路由的均匀多算子已达 0.797,仍高于全部基线;完整路由+校准再 +0.024(第7页)。
- Table 4:仅路由 0.816,仅自适应 delta 0.808,全模型 0.821。Table 3 权重可解释:感知上一致性/对比主导;属性上 grounding 主导且排除一致性;组合四算子更均衡并启用主张分解。
- Fig.5 ROC 显示全工作区领先,低假阳区分离最大;自核验整体 0.726 仍超基线交叉结果,但交叉相对自核验差距约 +0.095,外部核验器更有价值(第8页)。
阅读时需要注意
- 依赖多轮黑盒查询与外部核验器能力;自核验显著弱于交叉核验。
- 幻觉标签由 LLM-as-judge 相对参考答案构造,存在标注噪声。
- 校准在 VQA-RAD 拟合,跨域临床工作流与真实部署分布需另验。
- 本文是研究型风险打分,不是医疗器械、诊断软件或临床决策产品。
关联工作
- 相对 Semantic Entropy / SelfCheck / RadFlag 等一致性族,PROVE 强调按证据结构选算子而非统一重采样。
- 相对 FAITHSCORE / LogicCheckGPT / V-Loop 等证据分解或回环,本文指出无路由的子主张核验在医疗幻觉上接近随机。
- MedHallu、MedHEval、HEAL-MedVQA 等基准说明幻觉模式随问题类型变化,支持体制感知路线。