快速导读:GeoRefer-Bench 用度量场景图上的可执行逻辑式与 Exact Query Success,把遥感指称从掩码重叠改成可验证的集合指称解析。
遥感指称分割往往是关系句:句子要的是“路北边的建筑”或“离居民区最近的池塘”,所指对象是一个、多个,甚至是空集。传统基准多在预裁小块上标一个对象,再用掩码重叠打分;重叠会奖励“把同类候选都圈进去”,却无法证明模型真的做了关系分辨。
中南大学、江西师大等团队发布 GeoRefer-Bench(arXiv:2609.29541 )。它把每条查询写成度量场景图上的可执行逻辑式,用 Exact Query Success(EQS)只在返回实例集合完全正确时记成功,并为单掩码模型提供读出协议。代码与审计脚本见 https://github.com/anticipate218/GeoRefer-Bench 。本文是评测基准解读,不是遥感业务交付系统。
英文题目:GeoRefer-Bench: A Benchmark from Referring Pixels to Verifiable Geospatial Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.29541
原始论文:PDF / 论文页面
这篇论文解决什么问题?
消费照片里“红衣服的人”常是显著单目标,身份与边界一起成败;正射影像没有特权前景,同类屋顶/池塘外观接近,区分靠相对其他对象的空间关系,答案基数事先未知且可为零(第1–2页)。
现有遥感指称集(RefSegRS、RRSIS-D、RISBench、NWPU-Refer 等)多报告 mIOU/cIoU,且常在已对准目标的 crop 上评测,弱化了整景检索难题(Table 1,第4页)。
诊断显示:把真值实例掩码交给关系盲策略,类别并集仍可拿 29.7 mIOU、L3 达 36.9,但 EQS 在 L3 仅 9.2,L2/L4 为 0——重叠不能认证关系推理(第7–8页)。
核心创新
- 证明重叠指标会给关系盲并集虚高分。
- 提出 EQS 与像素模型可读出的集合判据。
- 发布经审计的整景可执行基准(700 景/2.94 Gpx/20k+ 查询)。
- 四家族十五模型诊断:关系深度与候选歧义主导失败。
方法概览
整景实例+度量关系图→五级可执行查询→EQS 精确集合成功;提供单掩码读出、改写/无解/反事实与审计;评十五模型转移表现。
- 场景 S=(I,O,R,G):2048×2048 正射 RGB;O 含离散实例与区域锚点;R 在度量 CRS 上算八方位、米制距离与拓扑;G 含 GSD/CRS/北向(第4页)。
- 查询 q=(句子 T, 逻辑式 ϕ),文法覆盖 ENT/ATTR/REL/AND/HOP 五级;答案集由同一 RESOLVE 执行,空集合法。模型只看 (I,T,G),看不到 ϕ 与 R(式1–2,第4–5页)。
- EQS:答案为空则预测也必须为空;非空则基数相等且匈牙利匹配后每个实例 IoU≥0.5。单掩码通过并集读出切成实例集,使像素模型可按集合准则计分(式3–4,第5页)。
- 构建:提示分割器提实例→度量场景图→程序生成查询→执行校验;含三句改写、24.0% 无解句、2,477 反事实对、五级难度与防泄漏划分;审计重算几何/归属/关系/执行与来源窗,700 景 0 issue(第5–7页)。
逐图理解论文
基准设计
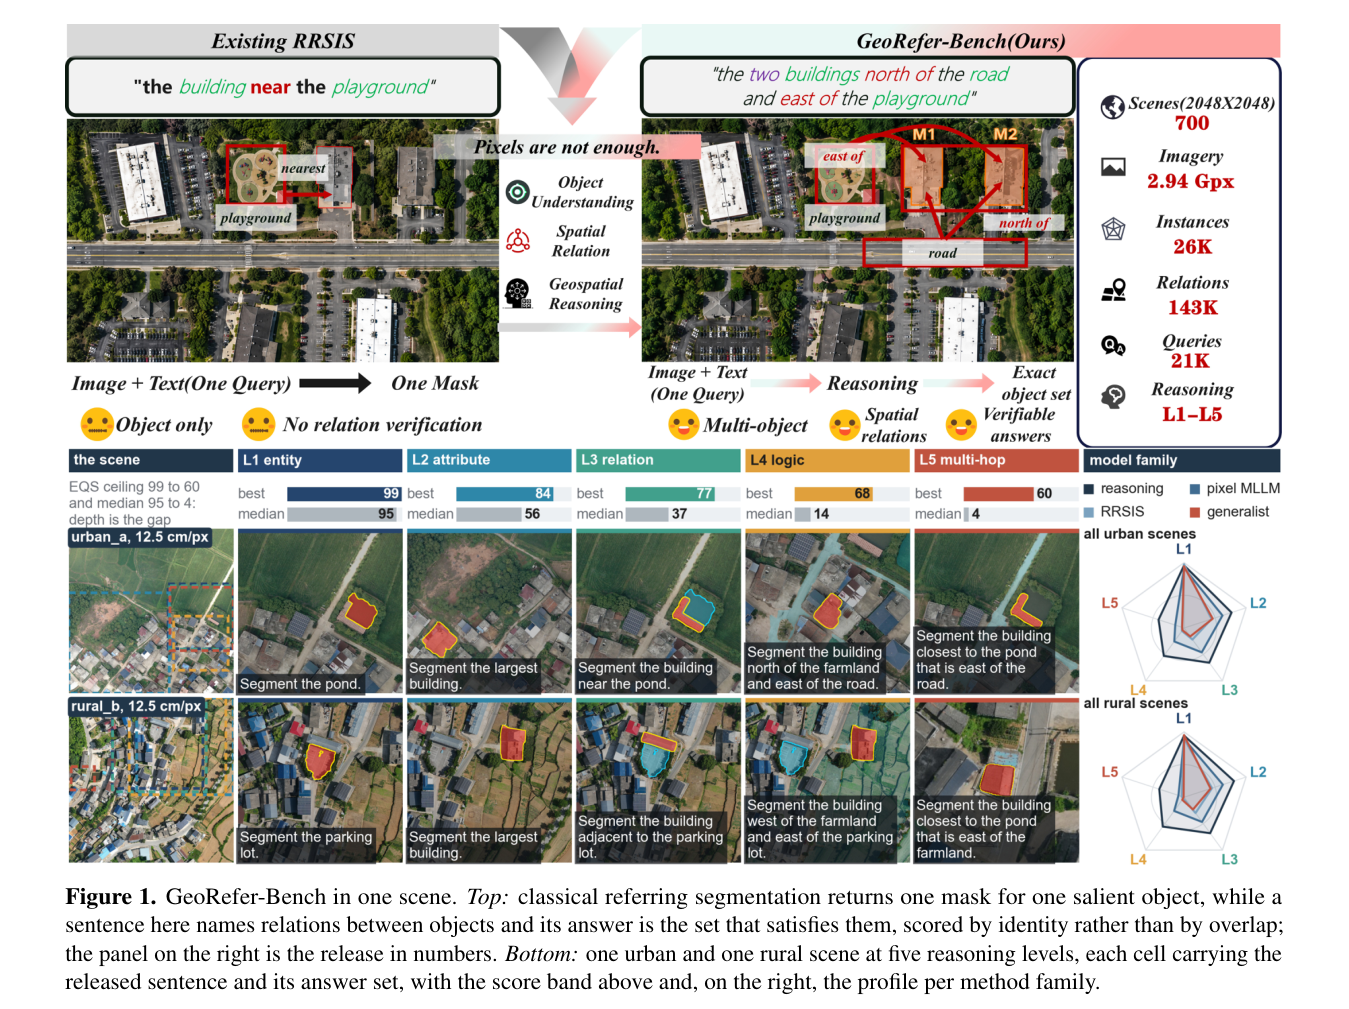
Fig.1 总览:上对比经典单掩码指称与集合式关系指称及数据规模;下给城乡场景 L1–L5 例句与答案集,并展示家族雷达随深度收窄。适合开场与特色图。
关键证据
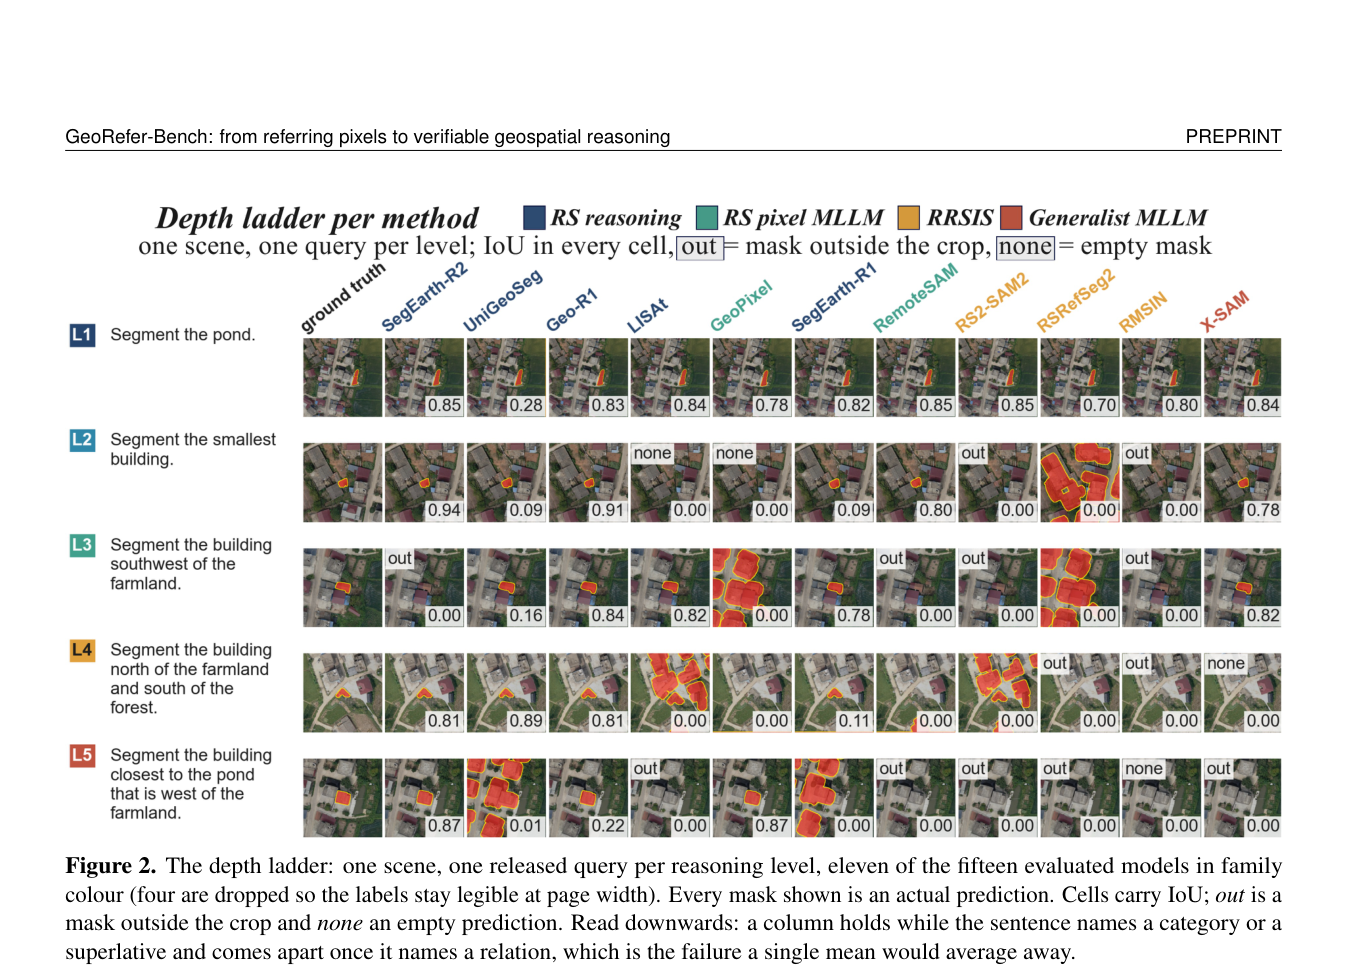
Fig.2 深度梯:同一景五行查询,十一模型预测与 IoU;L1/L2 多列尚可,一进入关系/合取/两跳即大面积失败。直观说明均值会掩盖关系崩塌。
Figure 4
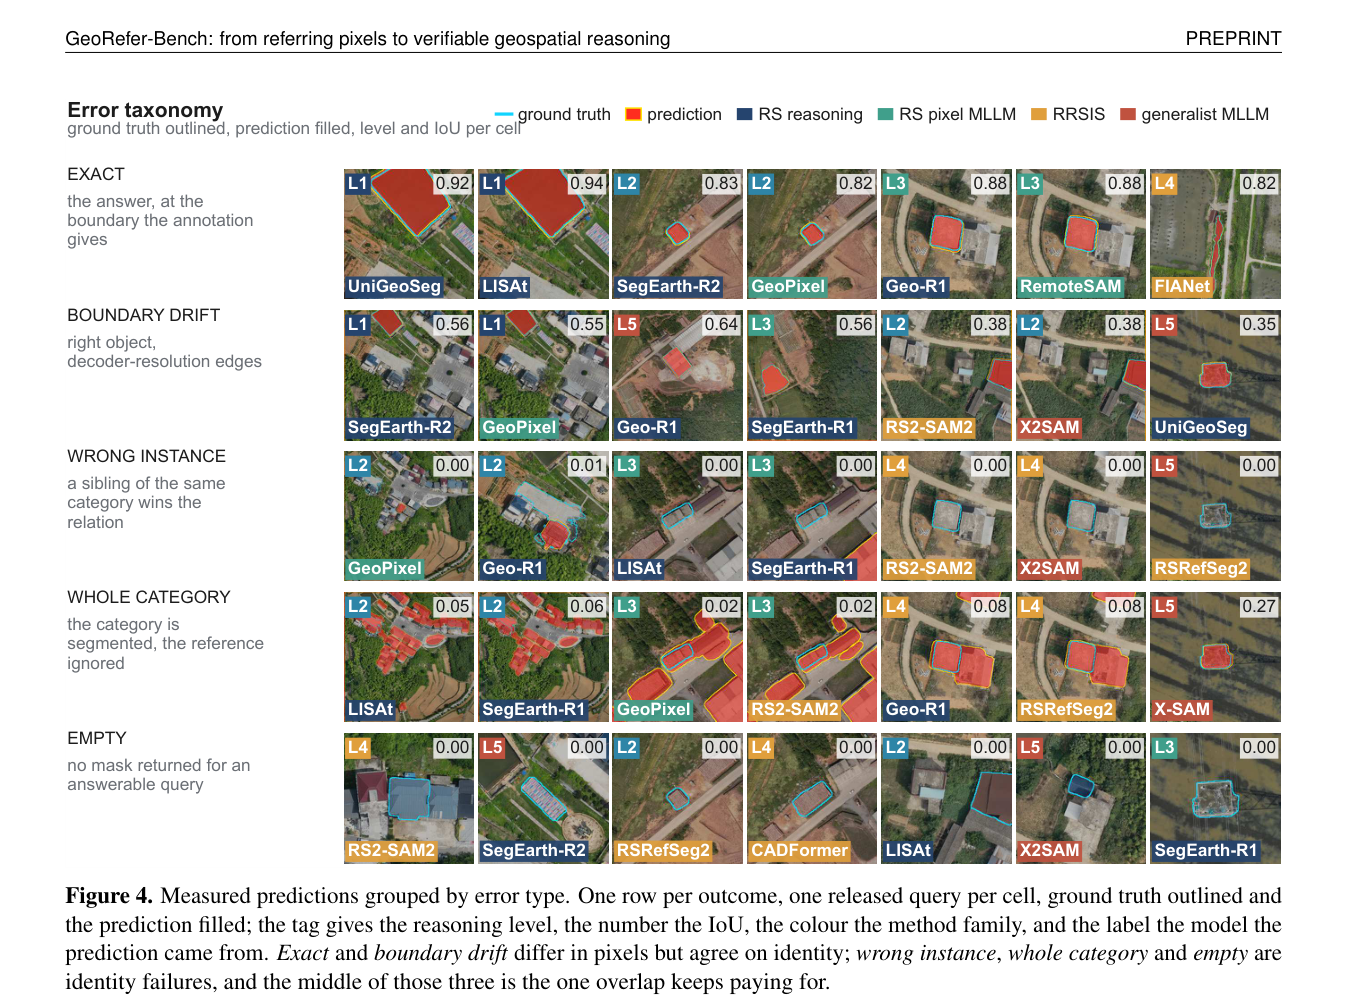
Figure 4. Measured predictions grouped by error type. One row per outcome, one released query per cell, ground truth outlined and the prediction filled; the tag gives the reasoning level, the number the IoU, the colour the method family, and the label the model the prediction came from. Exact and boundary drift differ in pixels but agree on identity; wrong instance, whole category and empty are identity failures, and the middle of those three is the one overlap keeps paying for.
实验如何设计?
- 规模:700 整景、2.94 Gpx、26,217 实例、142,796 关系、20,916 可执行查询(表面句约 62,748);GSD 12.5/25 cm(摘要与 Fig.1)。
- 诊断:三类关系盲策略在真值掩码上报告 EQS 与 mIOU(Table 2,第7页)。
- 系统评测:四家族十五模型,在场景不相交测试集 130 景 1,881 查询上零样本转移;报告总 EQS、可答 EQS、mIOU、拒识准确率、L1–L5、难度层与误差类型(Table 3、Fig.2–5,第8–15页)。
关键结果与论文证据
- 关系盲上限:总体 EQS≤22.7;L1 类别策略 100,更高层崩溃;同预测的 mIOU 却仍可观,证明指标选择决定“看起来会不会做关系”(Table 2)。
- 十五模型:最强 SegEarth-R2 总 EQS 74.1、可答 77.0、mIOU 71.2;L1 98.9→L5 60.5(Δ1→5=38.4)。Geo-R1 73.2 且拒识 65.4 最佳。经典 RRSIS 与通用分割 MLLM 多在 25.5–38.3,尽管 L1 常>90(Table 3,第10页)。
- 十个模型双跳查询 EQS 低于 5;失败更随同类别候选数上升,而非答案面积变小(Table 4)。约三分之二系统的“全查询分”被无解句抬高(Table 3 红箭头)。
- Fig.2 深度梯:多数列在命名关系后解体;Fig.5 显示无解句上乱出掩码与一味拒答两种失败。类别均衡与去掉窗口校准距离词后排名几乎不动(Table 5)。
阅读时需要注意
- 边界来自经审核的提示分割器,类别命名与句子自然度仍依赖人工,审计不能替人做语义裁决。
- 测试查询中建筑占比高;稀有类别单列结论受限。
- 部分模型需最小预处理才能吃 2048 输入,协议是转移评测而非各架构上限微调。
- 近/远等定性距离词随地窗校准,跨采样解读需按发布标记剔除(约 5.2% 查询)。
关联工作
- 相对 RefCOCO/gRefCOCO 与遥感 RefSegRS/RRSIS-D/NWPU-Refer:从 crop+重叠转向整景+可执行集合判据。
- 构图思路接近 CLEVR/GQA:程序生成与图执行;此处图边由几何度量而非手绘。
- 评测对象覆盖 SegEarth-R2、Geo-R1、GeoPixel、RS2-SAM2、X-SAM 等四家族代表。