快速导读:StereoGaussians 从一对标定立体图前馈预测米制 3DGS,用冻结立体特征、双层高斯与扩展画布支撑邻近视角外推。
一对标定立体图能给出可见表面的米制几何,但 XR 头显、立体相机与空间视频还需要“挪一点点视角”也仍可渲染:被遮挡后新露出的表面、以及输入视野之外的内容。纯视差匹配填不满这些区域的外观;单目前馈高斯又缺少可靠米制锚定。
StereoGaussians(arXiv:2609.38592 ,Goertek Alpha Labs)从单对标定立体图前馈预测可复用的米制 3DGS:冻结预训练立体网络的中间特征与视差,用可训练预测器在扩展画布上输出前后两层高斯,并用 SceneSplat-Stereo 的邻近目标渲染监督外观与容量。
英文题目:StereoGaussians: Feed-Forward 3D Gaussian Splatting from Stereo Images
论文出处:arXiv 每日论文精选 · arXiv:2609.38592
原始论文:PDF / 论文页面
这篇论文解决什么问题?
与多视图插值不同,邻近视角外推要求预测“输入覆盖之外”的内容。立体标定能锚定可见表面深度,却无法单独告诉模型新露出区域该如何着色与塑形。
相关工作里,前馈高斯路线(pixelSplat、MVSplat、DepthSplat、SHARP)强调免优化重建;transformer 新视角合成(LVSM)则直接生成目标像素。立体匹配网络强在对应,却很少把中间表示转成显式可渲染场景。
因此需要同时满足三点:米制几何锚定、可学习外观/形状、以及为遮挡后与视野外预留的场景容量。
核心创新
- SceneSplat-Stereo:大规模立体输入+邻近目标渲染监督,静态场景一致且保留真实外观。
- 冻结立体特征转移:用中间描述子与米制深度条件化高斯属性预测,而非只做视差。
- 外推友好表示:第二层高斯补遮挡后内容,扩展画布补视野外高斯容量。
- 在 StereoNVS 与 ReplicaGS 零样本新视角合成上相对强基线全面领先。
方法概览
StereoGaussians 冻结预训练立体编码器,取多尺度特征与标定视差转深度;DPT 式解码器融合成密集描述子,卷积预测器在扩展画布上输出前后两层高斯属性。前层深度由立体锚定,后层用邻域更深锚点加正偏移;FoV padding 用边缘复制扩展画布以支持视野外射线。训练用 SceneSplat-Stereo:从质量过滤的真实场景 3DGS teacher 渲染约 324K 立体对与 3.24M 邻近目标图(803 训练场景)。
- 流水线先经冻结立体编码器得到左参考视差与多尺度特征;视差转米制深度后,DPT 式解码器把特征、缩放 RGB 与深度融成全分辨率描述子。卷积预测器在扩展后的左图/深度/描述子上输出前层与后层属性残差,以及后层深度正偏移。
- 几何上,前层深度由标定立体锚定,像素平面偏置限制在半像素量级;后层在邻域最大深度上叠加 softplus 偏移,给遮挡边界后方留容量。画布两侧做边缘复制 padding,并平移主点,使填充像素对应原锥体外射线。
- 训练数据 SceneSplat-Stereo 从质量过滤的真实场景 3DGS teacher 采样参考位姿,渲染标定立体对与十个邻近目标,并附内参、相对位姿与有效掩码;约 803 训练场景、324K 立体对与 3.24M 目标图,保证静态一致与真实外观。
逐图理解论文
方法总览
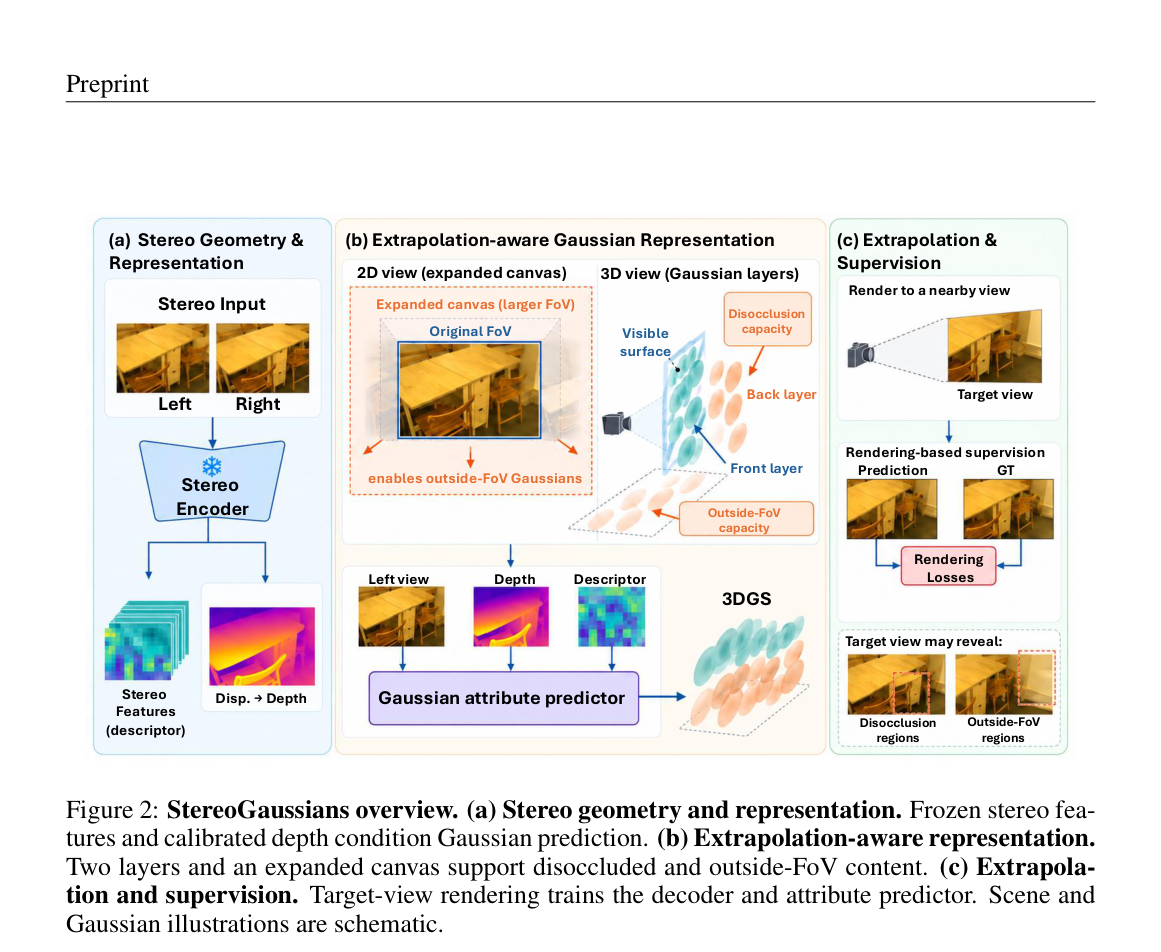
图2是方法总览:冻结立体特征与标定深度条件化高斯预测;双层与扩展画布分别提供遮挡后与视野外容量;邻近目标渲染监督解码器与属性头。宜作特色图。
训练数据
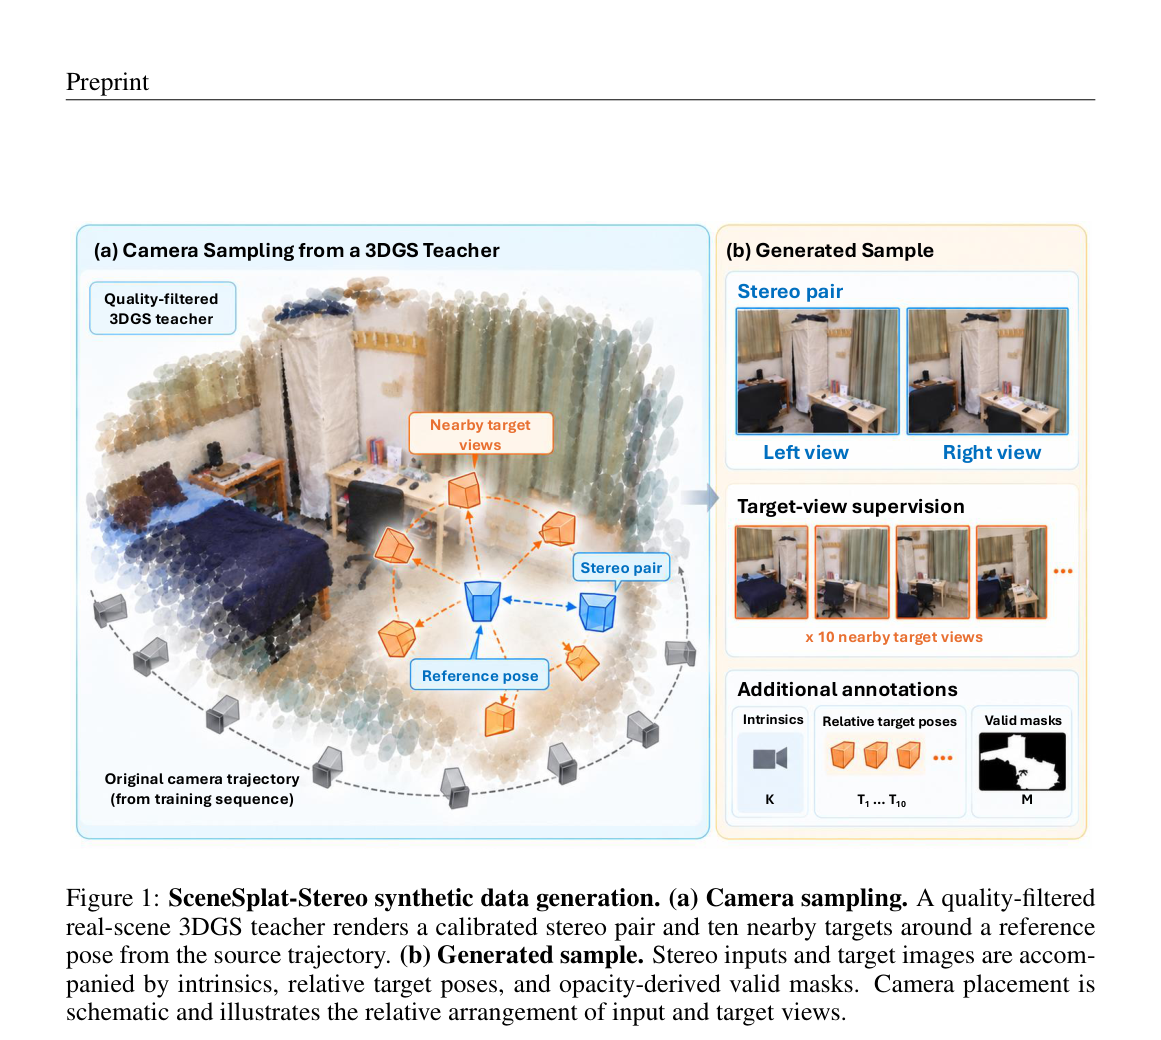
图1说明 SceneSplat-Stereo:从质量过滤 3DGS teacher 采样参考位姿,渲染立体对与十个邻近目标,并附内参、相对位姿与有效掩码。
关键证据
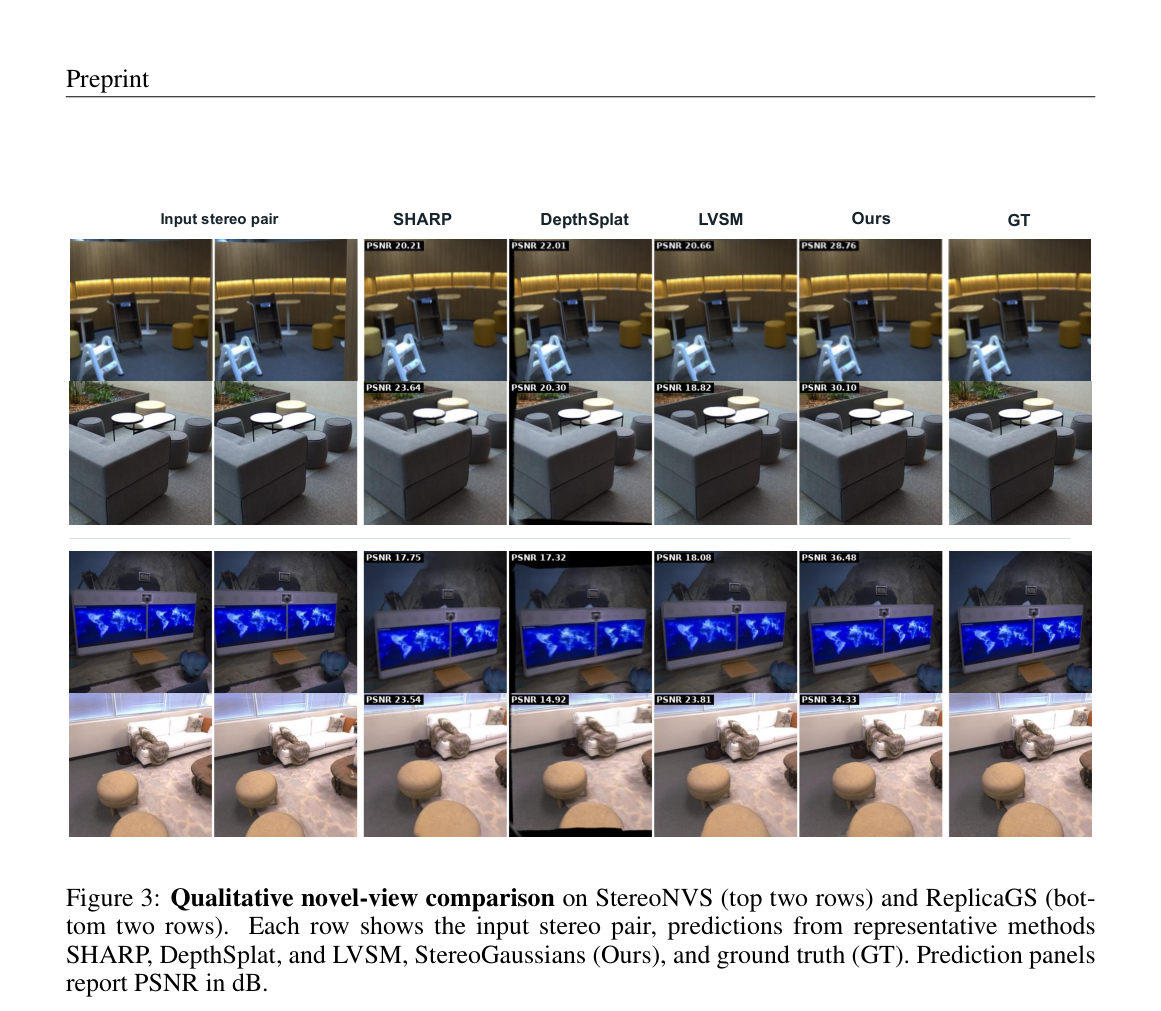
图3在 StereoNVS 与 ReplicaGS 上对比 SHARP、DepthSplat、LVSM 与本文;本文边界更清晰、纹理更稳,个案 PSNR 明显高于基线。
实验如何设计?
- 默认配置:FoundationStereo 编码器、双层高斯、无后层边缘门控、每侧 16 像素 FoV padding;消融多在 256×256、30K 步、MSE+0.05 LPIPS。
- 零样本测试集为未见的 StereoNVS 与 ReplicaGS;指标为 PSNR/SSIM/LPIPS-VGG,ReplicaGS 对 teacher 支持区域使用 opacity 有效掩码。
- 基线含 SHARP、MVSplat、DepthSplat、LVSM、Efficient-LVSM,以及仅用 FoundationStereo 深度做前向溅射/手工高斯属性的 FS 对照。
关键结果与论文证据
- Table 2:StereoGaussians 在两套基准六项指标全面最佳;StereoNVS PSNR 21.261、ReplicaGS 30.266,相对最强已发布 PSNR 基线 LVSM 分别高 1.465/4.494 dB。
- 同用 FoundationStereo 几何的 FS 基线仍明显落后,说明“有米制深度”不等于“会预测可渲染高斯”。
- SceneSplat-Stereo 训练在 ReplicaGS 上相对 StereoNVS/IRS 训练分别高约 6.3/5.7 dB;同数据微调 DepthSplat 仍全面落后,说明收益不只来自数据。
- 消融:去描述子、去后层、去 padding 都会显著伤质量;padding 对 ReplicaGS 影响尤其大(无 padding 降约 8.7 dB)。
阅读时需要注意
- 固定前层深度限制了纠正立体误差的能力。
- teacher 伪影可能进入监督。
- 当前评测偏邻近视角,更大视角变化与遮挡/视野外区域专项指标仍待加强。
关联工作
- DepthSplat / MVSplat 代表稀疏多视图前馈高斯。
- SHARP 代表单图前馈高斯与属性合成先验。
- LVSM 代表无显式场景表示的 transformer 新视角合成。