快速导读:Gestalt 按模态独有、跨模态对齐到协同的金字塔,用离散扩散与分阶段 interplay 架构统一理解、生成与语言。
大多模态模型已经从“把视觉编码器接到语言模型”走到“在共享骨干上混训图文”,但作者认为真正的瓶颈不是再塞进一种模态,而是没有区分三类信息:只在单一模态里的独有信息、跨模态重复的冗余信息,以及必须把两边合在一起才出现的协同信息。只追求兼容,容易把特化冲淡,也容易把预训练语言模型的几何结构改坏。
Gestalt(arXiv:2610.00576,中国人民大学高瓴人工智能学院 / 北航 / 北邮 / 上海人工智能实验室等)把这件事写成一座交互金字塔,并用统一离散扩散把理解、文生图和纯文本放进同一个模型。视觉走固定 IBQ 码本,文本走 LLaDA 词表,中间插入可学习 interplay tokens:下层限制视觉与文本直接对视,上层再做全连接融合。项目见https://GeWu-Lab.github.io/Gestalt,代码见https://github.com/GeWu-Lab/Gestalt,权重见https://huggingface.co/GeWu-Lab/Gestalt。
这篇论文解决什么问题?
图1b用一只戴蓝项圈的金毛把问题说清楚:文本提供“大狗红项圈、小狗蓝项圈”,图像只给出可见项圈颜色;二者关于草地金毛的描述构成跨模态对应,而“这是较小那只狗”只能从两边合起来得到。现有统一模型往往从很早的层就开始共享计算,独有线索容易被对齐压力抹平。
相关工作一条线用投影器保语言、迁就视觉,一条线在共享离散或连续空间里同时做理解与生成。离散扩散的双向注意力本适合互为条件,但若没有显式的交换界面,仍可能变成“两个模态挤在同一套 FFN 里”。Gestalt 要同时回答:如何保住模态特性、如何学双向依赖、如何在指令阶段把协同用起来。
因此方法必须覆盖三件事:分阶段架构、按信息类型组织的数据,以及从对齐走到协同的课程训练,而不能只换一个更大的混合语料。
核心创新
- 提出多模态交互金字塔,把独有信息、跨模态冗余对齐与协同信息分成可操作的学习层级。
- 用 interplay tokens 把 Transformer 分成瓶颈交互区与全连接交互区,先保模态特性再做深度融合。
- 用同一掩码扩散目标统一理解与生成,并以四类 interplay 数据的课程采样把金字塔落到训练。
- 在细粒度文生图、视觉中心理解与纯文本评测上同时检验扩散统一模型是否保住语言几何。
方法概览
Gestalt 初始化自 LLaDA-8B-Instruct,用固定 IBQ 把图像编成 16384 词表离散视觉令牌,与文本令牌共享序列,在统一掩码扩散目标下双向条件化。引入 32 个可学习 interplay tokens:前 4 层为 Zone I,视觉与文本走独立 FFN,注意力屏蔽二者直接交互,只经 interplay tokens 交换;其后 Zone II 放开为全多模态自注意力与共享 FFN。训练先在 70M LLaVA-OneVision-1.5 图文对上联合掩码预训练,再在 8M 对上做条件持续预训练,最后在 13.7M 按冗余/文本独有/视觉独有/协同组织的指令数据上三阶段课程 SFT,并加入 2.5M 文生图样本。
- 表示上,图像经 IBQ 编成 16384 个离散视觉令牌,与文本令牌拼成同一序列,并用 interleaved MRoPE 保留二维位置。训练目标是统一掩码扩散:随机遮住部分位置,用双向上下文重建,视觉损失与文本损失加权相加。这与自回归固定从左到右不同,图文可以互为条件,理解与生成走同一套去噪。
- 架构上共 32 个 interplay tokens。Zone I 只占前四层:视觉令牌走 Visual FFN,文本令牌走 Textual FFN,注意力掩码禁止 V↔T 直接交互,只允许它们与中间的 I 令牌通信,相当于把跨模态交换收成瓶颈。Zone II 取消该限制,V/I/T 做全多模态自注意力并共享 FFN,让协同信息在整段序列上聚合。新引入的视觉 FFN 从对应文本 FFN 初始化,全阶段参数都可训练。
- 数据与训练跟金字塔对齐。模态独有基础来自预训练 LLaDA;多模态阶段先在 70M 对齐图文上联合掩码预训练学联合分布,再在 8M 对上做“一侧可见、一侧被掩”的条件持续预训练,分别强化图到文与文到图。SFT 使用 13.7M 指令样本,按冗余 2.8M、文本独有 4.2M、视觉独有 4.0M、协同 2.7M 标注,三阶段课程始终保留四类、但采样重心从语言与对齐,转到视觉感知,再转到协同;并另加 2.5M 文生图数据。
逐图理解论文
三类信息
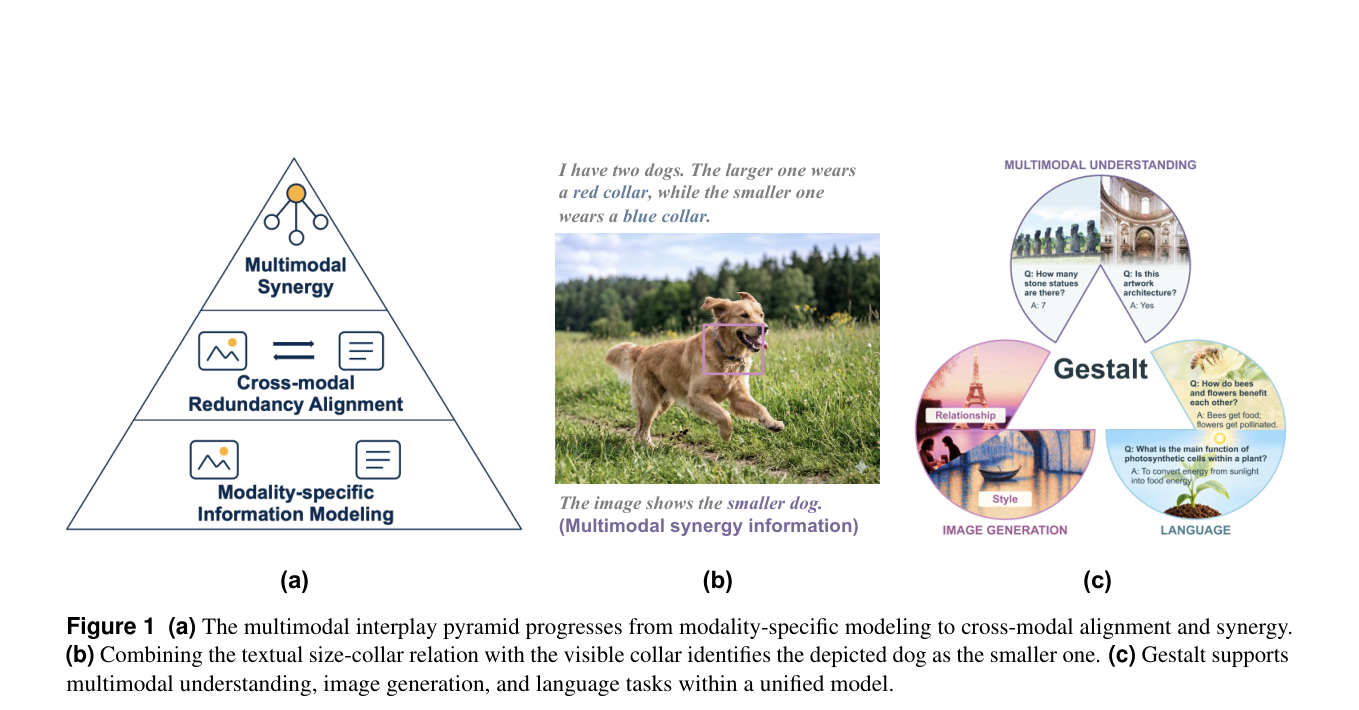
图1给出问题直觉:左柱金字塔从模态独有建模、跨模态冗余对齐到顶端协同;中图金毛草地奔跑,紫框标出蓝项圈,文案用体型-项圈关系推出“这是较小的那只狗”;右扇区把 Gestalt 画成理解、文生图、语言三块能力。
分阶段架构
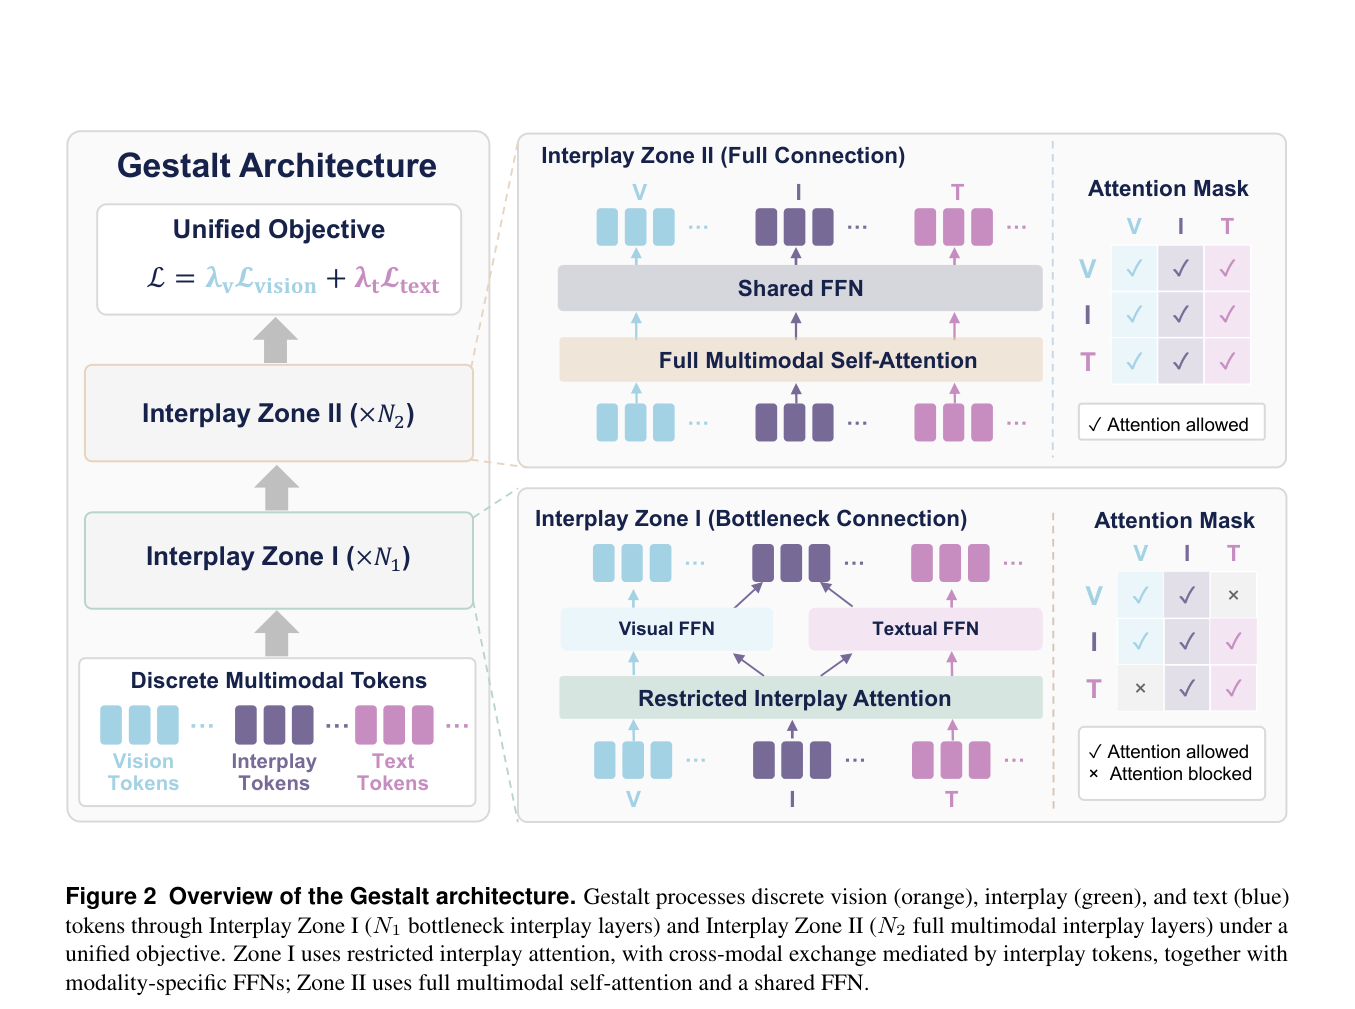
图2是架构总览,宜作特色图。左侧自下而上为离散视觉/交互/文本令牌、Zone I(×N1)、Zone II(×N2)与统一目标 λvLvision+λtLtext。右下 Zone I 用 Visual FFN 与 Textual FFN,限制性注意力禁止 V 与 T 直接互看,只经紫色 interplay tokens 交换;右上 Zone II 改为共享 FFN 与全多模态自注意力,V/I/T 掩码全开。
数据课程
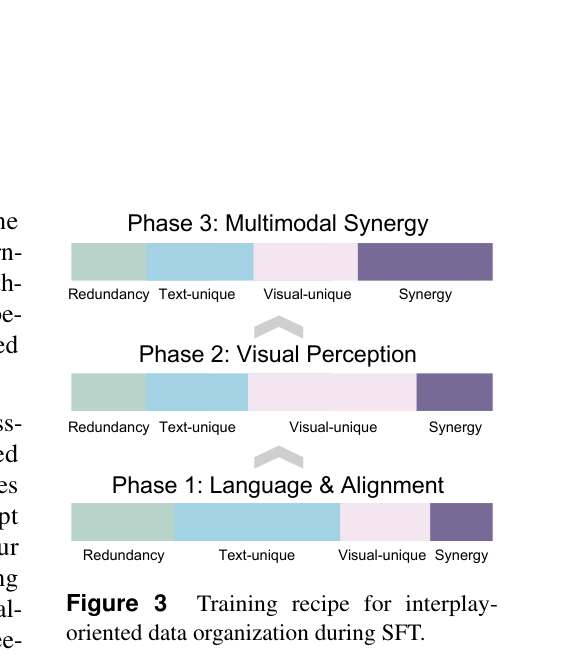
图3是 SFT 三阶段堆叠条:Phase 1 语言与对齐以 Redundancy 与 Text-unique 为主;Phase 2 视觉感知明显加长 Visual-unique;Phase 3 协同阶段 Synergy 成为最宽色块。四类数据始终保留,只改采样重心。
关键证据
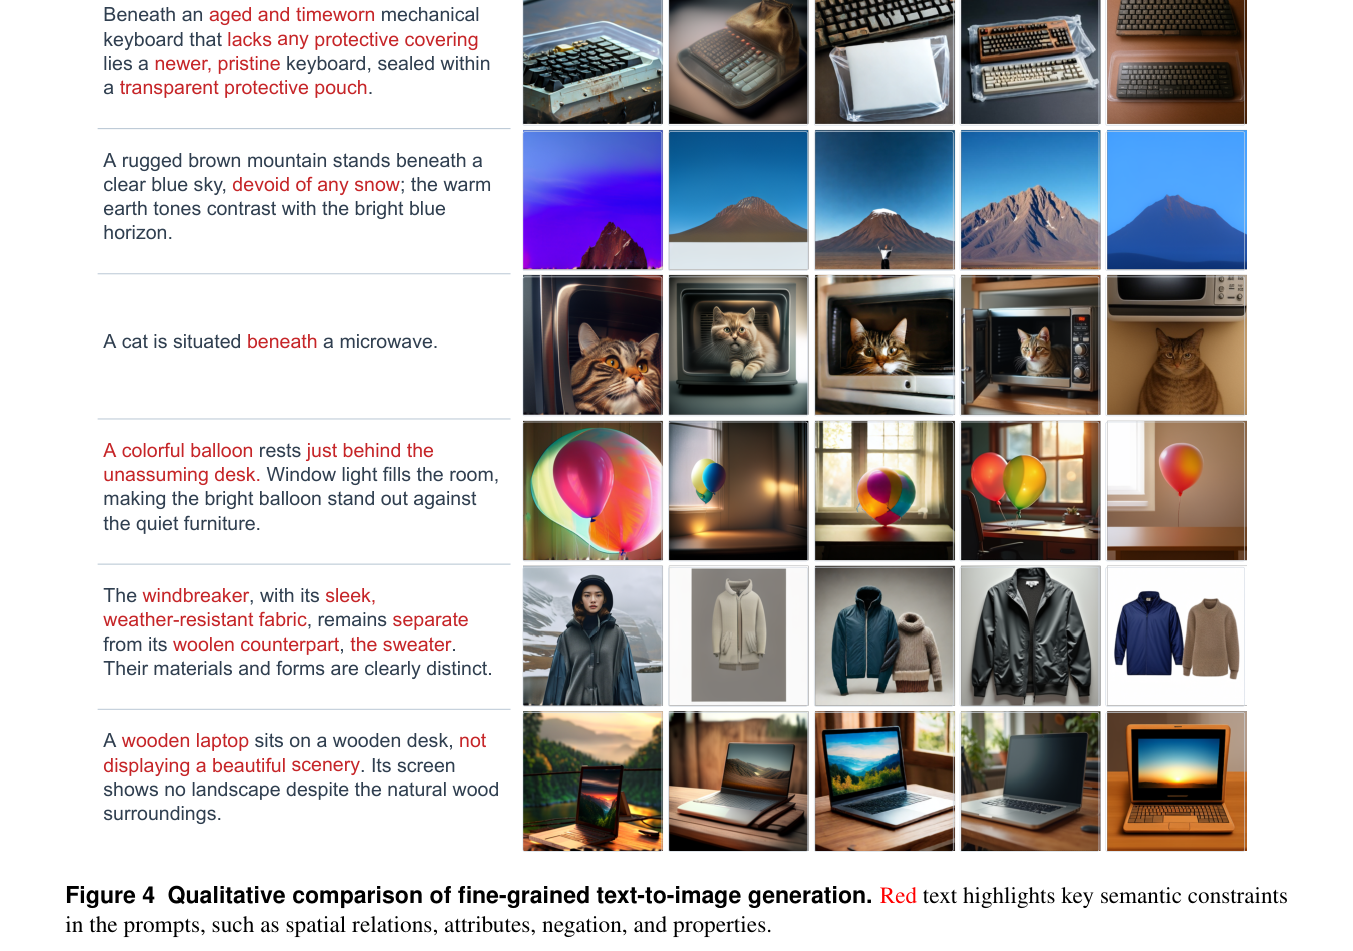
图4为细粒度文生图定性对比。左列提示把空间、属性、否定标成红色,可见行包括旧键盘下的新键盘、无雪棕山、猫在微波炉下方、气球在桌后、风衣与毛衣分离、木纹笔记本屏幕不显示风景;右侧五列对应 Emu3、MMaDA、Show-o2、BAGEL 与 Gestalt,最右列相对更遵守红色约束。
实验如何设计?
- 骨干为 LLaDA-8B-Instruct + IBQ。生成评测用 UniGenBench 的属性、动作、空间、组合与逻辑维度,以及 TIIF-Bench 的短/长指令;对照既有 DALL-E 3、SD-3.5-Large、OmniGen2、FLUX.1 Pro 等生成专用模型,也有 Emu3、MMaDA、Show-o2、Janus-Pro、BAGEL、Lumina-DiMOO 等统一模型。
- 理解评测覆盖通用 VQA 与视觉中心基准,扩散对照包括 MMaDA、Lumina-DiMOO、LaViDA-o、LLaDA-o、Omni-diffusion,自回归对照为代表模型 BAGEL。表征实验在 DOCCI 图文对的第 24 层可视化图文分布,并用范数、距离、余弦与 CKA 衡量相对预训练 LLaDA 的语言空间保留。
- 交互评测把 MIB-V、CoreCognition-SM 视为视觉特化,把 MM-IMDb、SRBench 视为协同;再在 MIBench 上按视觉独有、文本独有、协同三类样本看第 16 层 interplay token 是否分簇。
关键结果与论文证据
- 细粒度生成上,Gestalt 在 UniGenBench 取得 Overall 73.30,超过生成组最高的 OmniGen2(71.39)与统一组最高的 Lumina-DiMOO(71.81),并在风格、关系、组合、语法、布局、逻辑上排第一;TIIF-Bench 短/长指令 Overall 为 74.57 / 78.86,长指令优势更大,说明多重约束下仍能保住细节(页6–7)。
- 理解上,它在八个基准里有五个于扩散模型中最好、七个进入前二。视觉中心更明显:MMVP 48.7,CV-Bench 两轨 78.9 与 86.1,后者超过 BAGEL 的 77.7 与 84.2。作者把这归因于 Zone I 对视觉独有信息的保护(页7–8)。
- 表征上,Lumina-DiMOO 的图文簇明显分离,Qwen3.8-9B-Distill 只有部分重叠,Gestalt 更交错。统一词表通常会大幅改写语言空间,但 Gestalt 对预训练 LLaDA 的余弦与 CKA 仍达 0.9968 与 0.9949,而 Lumina-DiMOO 掉到 0.5880 与 0.4389。纯文本上它在六个基准中的五个领先其他扩散统一模型,ARC-E/C 提升尤其大(页8–9)。
- 交互上,Gestalt 在 CoreCognition、MM-IMDb、SRBench 取得扩散模型最好成绩;interplay token 对视觉独有与文本独有样本分居不同区域,协同样本则夹在中间,说明交换界面会按信息需求改表征组织(页9–10)。图4定性对比里,对照常在“无雪”“在下方”“不显示风景”等否定或空间约束上失败,最右列相对更贴红色约束。
阅读时需要注意
- 同一张 UniGenBench 表里,图像内文字 Text 只有 3.80,远低于 OmniGen2 的 27.99,说明细粒度语义赢面并不等于 OCR 级渲染。
- World Knowledge 与 GQA 并非全面第一,视觉中心增益不能掩盖部分通用问答短板。
- 离散码本、8B 规模与全参数多阶段训练限制了细节与可及性;论文也尚未把金字塔扩到音频、视频等更多模态。
关联工作
- LLaVA 式投影器对齐优先保住语言,统一词表模型则用共享计算换生成能力,二者都较少显式处理协同信息。
- BAGEL、Janus-Pro、Show-o2 代表自回归统一路线;MMaDA、Lumina-DiMOO、LLaDA-o 代表扩散统一路线,Gestalt 的对照主要落在这两簇。
- 讨论部分把交互金字塔连到混合模态扩展律:协同不只取决于模型和数据规模,还取决于信息交换如何分阶段组织。