快速导读:PhysVista 把物理状态感知、动态推理与可信度评估收成闭环,并在真实与生成视频上区分事件级与尺度级物理理解。
视觉语言模型已经很会认物体、讲场景,甚至能做多步多模态推理,但这不等于它们抓住了真实世界的物理一致性。现有基准常常只测闭环里的一段:有的停在感知,有的只问事件有没有发生,有的把物理题出成几乎不看视频的试卷。结果很难诊断:模型究竟是看不见、想不通,还是看见了也讲得出机制、却不会按违规严重程度打分。
PhysVista(arXiv:2610.00559,NeurIPS 2026,中国科学技术大学 / 字节跳动 / 香港城市大学)把人类式的看见—推理—评估收成同一套基准,并同时使用真实视频与 AI 生成视频。它还把推理拆成事件级与尺度级:前者关心发生了什么机制,后者关心幅度、数量、精确位置或比例。代码见https://github.com/Helen1p/PhysVista。
英文题目:PhysVista: Benchmarking Physical Intelligence in VLMs via a Perception-Reasoning-Assessment Loop
论文出处:arXiv 每日论文精选 · arXiv:2610.00559
原始论文:PDF / 论文页面
这篇论文解决什么问题?
物理理解天然是闭环。人先恢复可观察状态,再推断因果,最后判断整段运动是否还像物理世界。PhysBench 侧重感知却被语言捷径困扰;IntPhys2 把可信度压成二元判断;CausalVQA 等更接近真实因果,但仍偏事件级;PAI-Bench 补上感知加推理,却没有评估。缺了最后一环,就无法知道模型会不会当“物理裁判”,去评价生成视频的失真。
数据源也限制了结论。早期基准大量用仿真,场景干净但分布窄;近年真实视频进来了,生成视频却仍少。生成内容里的物体交互、人体运动和场景切换,常常以很细的方式违反守恒、接触或尺度,而这正是 VLM 可能靠纹理统计蒙混过关的地方。
因此 PhysVista 把任务覆盖、选项粒度和域多样性一起设计:既要能定位失败发生在感知、因果还是校准,也要能比较真实域与生成域。
核心创新
- 把看见、推理、评估收成同一套物理认知闭环,而不是只测其中一段。
- 在因果任务上显式区分事件级与尺度级选项,避免“答对类别但错了幅度”。
- 同时覆盖真实视频与 AI 生成视频,并加入违规批判、五级打分与相对排序。
- 用固定模板、视频盲测和人工改写压低语言捷径。
方法概览
PhysVista 不强调从零采集全新视频,而强调任务形式、系统重标注与统一评测。感知阶段含空间状态、时间违规定位、十类相机运动、分数比例尺度估计、参数/结果不确定性。推理阶段含打乱帧的时序重构,以及机制、原理违规、动态预测、反事实、违规批判五类因果任务,选项按事件级与尺度级分层构造。评估阶段对单视频做 1–5 可信度打分,并对真实-生成、生成-生成、真实-真实三类成对比较。视频主要来自 WISA-80K、VideoPhy-2 与 Multi-CamVideo;固定无槽位模板降低语言提示,并用视频盲测与人工核验。
- 感知阶段测五件事。空间状态再拆成相对关系、接触碰撞等交互、地形天气等场景上下文,以及尺寸可否实现的空间可行性。时间违规定位要求给出秒级区间,而不是视频级“有没有问题”。相机运动识别覆盖十类,包括环绕、平移、俯仰、静止与变焦。尺度估计要求输出如 1/3 这样的相对比例。不确定性则分参数不确定(摩擦系数等无法从画面唯一确定)与结果不确定(信息不足或过程不可观察)。
- 推理阶段先做时序重构:把不规则间隔采样、打乱的帧排回物理上说得通的顺序。因果部分有五类:机制推理、原理违规(可多选)、动态预测、反事实,以及违规批判(指出失真并给出最小修正)。机制、反事实、预测和批判的选项按三层构造:先生成事件级粗选项,再在同类里细化尺度差异,最后分别抽样以分开“类别对了但幅度错了”的失败。
- 评估阶段不再解释某一个事件,而对整段视频做整体判断:单视频 1–5 分,分数要跟违规严重程度对齐;成对比较则覆盖真实对生成、生成对生成、真实对真实。生成对生成会控制语义相近、分差通常不超过两档,逼模型看细微物理差异而不是看题材。数据上,除相机任务用 Multi-CamVideo 外,其余主要来自 WISA-80K 与 VideoPhy-2;题目用固定、无实例槽位的模板,并做视频盲测与人工改写。
逐图理解论文
闭环任务
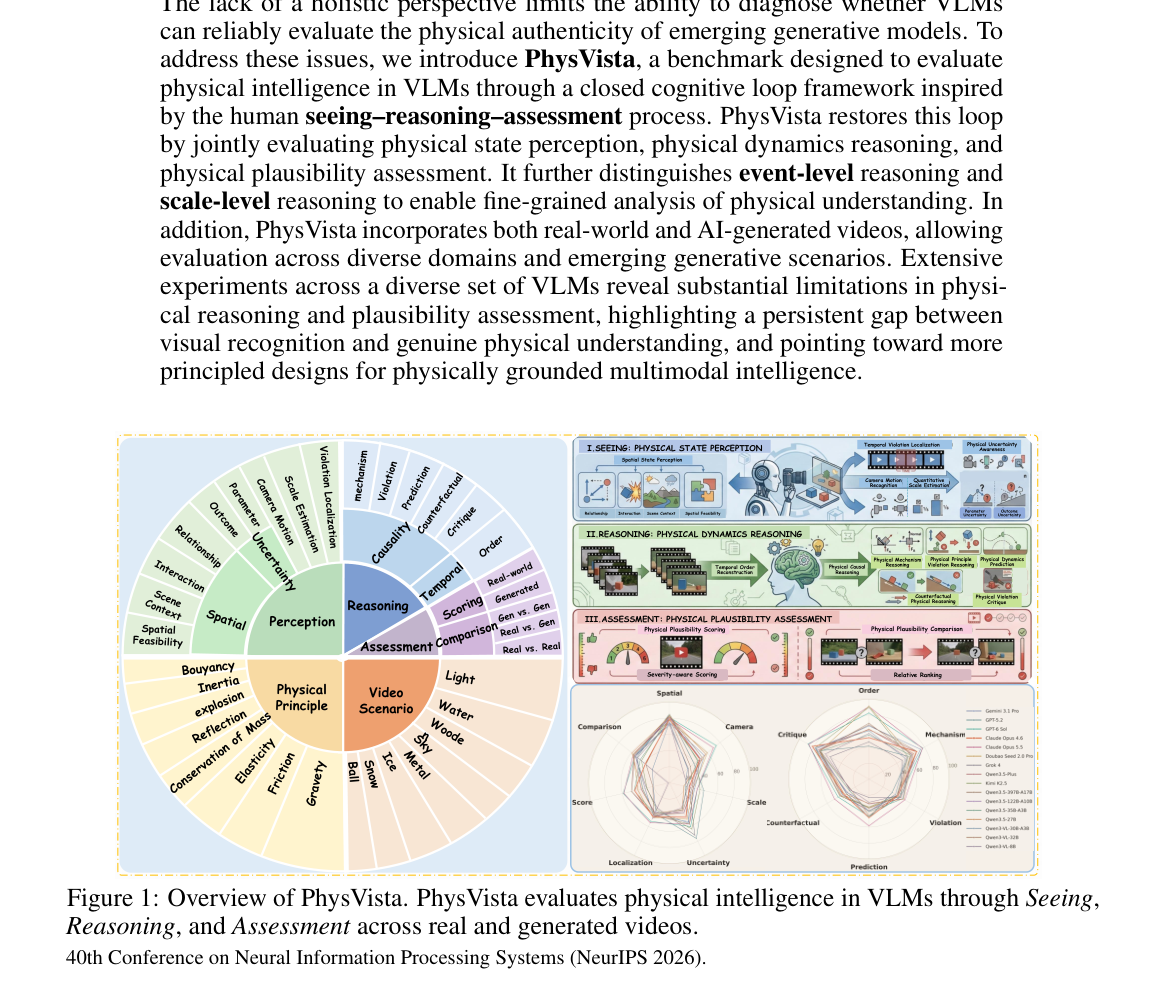
图1是方案总览,宜作特色图。画面上半残留摘要文字,主体在虚线框内:左轮盘把 Perception、Reasoning、Assessment 与物理原理、视频场景连在一起;右上三条色带分别画感知、动态推理、可信度评估任务;右下两张雷达图汇总多模型在空间、相机、尺度、时序、机制、预测等轴上的表现。
数据质检
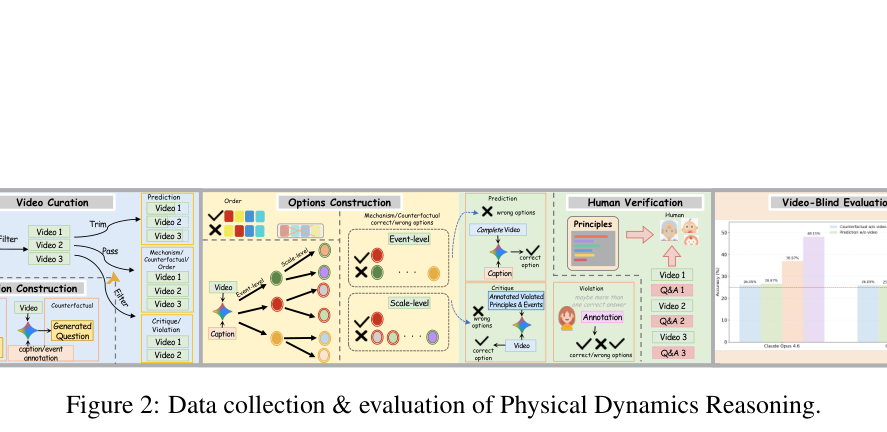
图2是动态推理的数据与质检流程。从视频筛选、裁剪,到事件级与尺度级选项构造,再到人工核验;最右侧 Video-Blind Evaluation 柱状图显示不看视频时准确率接近随机,用来证明题目不能靠纯文本捷径答对。
关键证据
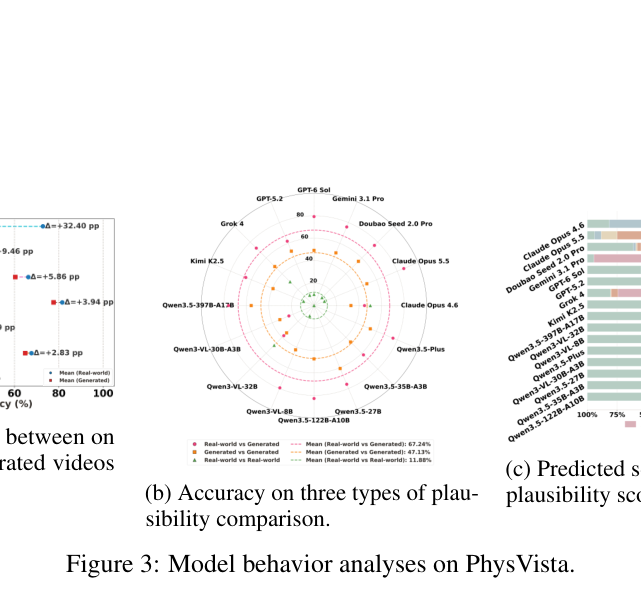
图3分析模型行为。中图雷达给出三类可信度比较:真实vs生成均值约67%,生成vs生成约47%,真实vs真实约12%。左图残段可见真实相对生成的准确率优势(标注到 +32.40 个百分点);右图为各模型打分表现条形,开源与闭源都出现校准不稳。
实验如何设计?
- 主实验按三阶段报告。感知与评估见表2:空间、相机、尺度、不确定性用准确率,定位用平均 IoU,打分用 SRCC/PLCC,比较用准确率,再给任务数加权平均。推理见表3:违规用 Micro-F1,其余用准确率。对照覆盖闭源与开源共十余个 VLM。
- 行为分析看三件事:各任务在真实与生成视频上的准确率落差;三类成对比较的雷达图;生成与真实视频上的预测分数分布,用来识别“分数塌缩”。附录给出样本量,并由独立评估者对约四成数据打语言中立、问答精度与物理推理有效性。
- 感知样本约为空间/定位/相机各 200、尺度 60、不确定性 180;推理为时序 150、机制 192、违规 224、预测 135、反事实 119、批判 100;评估为打分 200、比较 100。
关键结果与论文证据
- 总体规律是:感知相对最好,推理其次,评估最不稳。GPT-6 Sol 感知加权 68.59%,Claude Opus 5.5 推理加权 67.89%。但尺度估计和不确定性明显拖后腿,很多模型尺度准确率只有两到三成,说明“看得到物体”不等于“量得准比例”(页8–9)。
- 认知闭环内部名次会交叉。GPT-5.2 与 Kimi K2.5 感知靠前,推理名次下降;Gemini 3.1 Pro 与 Doubao Seed 2.0 Pro 推理不错,评估却掉下来。作者据此认为:强感知推不出强因果,会讲机制也不等于会按严重程度打分(页8)。
- 推理内部也分难度。时序重构普遍高于因果;动态预测和反事实最难,因为既要事件对、又要尺度对,反事实还要在未看见的干预下推演。批判任务相对更高,例如 Claude Opus 5.5 达 87%、GPT-6 Sol 达 88%,更像能指出“哪里不对”,却仍不会把后续状态推准(页8–9)。
- 真实视频整体好于生成视频,不确定性与动态预测的落差更大;尺度估计是例外,生成域略高,可能因为画面更干净。成对比较里真实对生成最好(均值约 67%),生成对生成降到约 47%,真实对真实只剩约 12%:两个都合理时模型仍会硬选边。打分上,Qwen3-VL-8B、Kimi K2.5 等会把大量样本堆到最高档,Gemini 3.1 Pro、Grok 4 则可能默认最低档,相关接近随机(页8–10)。
阅读时需要注意
- 部分题目由 Gemini 辅助出题,人工核验降低了但未消灭风格与标注偏差。
- 选择题便于统一打分,却测不到自由描述因果链;尺度任务样本量也明显更小。
- 生成域主要来自 VideoPhy-2,不能代表所有视频生成器;真实对真实的强制选择也会低估“两者都合理”的判断力。
关联工作
- PhysBench、IntPhys2、CausalVQA、MVP Bench、PAI-Bench 分别覆盖感知、违背预期、因果或具身,但都没有把评估闭环和生成域同时补齐。
- PhyGenBench、WorldBench、VideoPhy-2 等更关心生成模型是否遵守物理;PhysVista 把问题翻过来:VLM 能不能当可靠的物理评审。
- 论文结论不是某家模型全面懂物理,而是当前 VLM 的物理智能在闭环各段都不完整,后续设计需要把校准和尺度敏感性算进目标。