快速导读:SpectralCache 发现世界模型特征的主导奇异子空间跨步稳定、奇异值可外推或常比缩放,从而训练无关地跳过大量 DiT 计算,在 Voyager-13B 上约 5.22 倍加速并保住 WorldScore。
扩散式世界模型能按场景和动作生成可交互的未来观测,但去噪过程要反复跑大型 Diffusion Transformer,推理时间动辄上千秒,交互式规划很难用。既有缓存多半复用或预测特征、token,对常规图/视频生成有效,搬到层次动态更复杂的世界模型时,质量往往明显掉。SpectralCache(arXiv:2610.02660,Stevens Institute of Technology、Northeastern University、TU Darmstadt)不问“这个 token 变没变”,而问特征矩阵的奇异结构稳不稳。
观察是:世界模型中间特征低秩,主导奇异子空间在相邻去噪步几乎不动,奇异值则可线性外推,邻近刷新步之间还近似差一个常比。于是全计算步只存最近两次 SVD 状态,近似步复用 U、V 和残差,只估 r 个奇异值;误差大了再刷新,刷新还与 γ=1.1 的缩放交替。训练无关。HunyuanVoyager-13B 上约 5.22 倍加速,WorldScore 静态/动态 65.90/46.13,高于 WorldCache 的 3.65 倍与 64.89/45.43。制作时未见独立项目页。
英文题目:SpectralCache: Accelerating Diffusion-Based World Models via Spectral Feature Caching
论文出处:arXiv 每日论文精选 · arXiv:2610.02660
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Fig. 1 用同一句走廊提示把反差摊开。左列 Vanilla、WorldCache、EasyCache、SpectralCache 的远景差不多,但 Window detail 里拱窗和苔藓:Vanilla 最清晰,SpectralCache 比 WorldCache/EasyCache 更接近原模型。右上时延条:Vanilla 1054 s,WorldCache 289 s,EasyCache 294 s,SpectralCache 202 s,标 5.22×。右下表:SpectralCache SSIM 0.818、WS-S 65.90、WS-D 46.13,三项都高于两条缓存基线,仍略低于 Vanilla 的 1.000/66.28/46.40。
相关工作里,策略式世界模型靠交互学动态,生成式世界模型靠大规模视频做扩散模拟。加速可以改采样 ODE、蒸馏步数,或剪枝量化网络。缓存路线吸引人,是因为训练无关、且尽量保住质量。但 ToCa、DuCa、TaylorSeer 这类方法面向常规生成;HERO、WorldCache 开始处理世界模型差异,重点仍是逐步特征怎么变。本文把同一特征做 SVD,把可复用部分从“哪些 token”改成“哪些奇异方向可以冻结、哪些标量还要更新”。
核心创新
- 提出面向扩散世界模型的训练无关频谱缓存:复用稳定奇异子空间,只估计低维奇异值。
- 揭示特征强低秩、主导子空间跨去噪步与邻近刷新步稳定,奇异值可线性外推或近似常比缩放。
- 用误差累积触发刷新,并在触发步交替全计算与奇异值缩放,进一步少跑骨干。
方法概览
对 DiT 末层视觉特征 reshape 成 token×通道矩阵后做秩 r SVD(默认 r=128,平均覆盖约 96% 能量),缓存最近两次全计算的频谱状态 {U, Σ, V, R}。近似步不跑骨干,直接复用最近全计算的 U、V 和残差 R(残差约 3% 能量),只更新 r 个奇异值:连续缓存步用两次全计算之间的步距做线性外推,经验相对误差约 0.71%;当累积误差或最大间隔 N 触发刷新时,并不总跑全计算,而是与 γ=1.1 的奇异值缩放交替,再进入新一轮外推。误差监视跟 WorldCache,对 chaotic tokens 做曲率加权累积。整套训练无关。
- 第 t 步 DiT 末层特征 F_t 拉成 X_t∈R^{M×D},M 是帧×高×宽个视觉 token。秩 r 分解写成 X=UΣV^T+R,Q_t={U,Σ,V,R} 叫频谱状态。默认 r=128,因为平均能盖住约 96% 能量,残差大约 3%。Fig. 2(a) 用主角相似度看相邻步:间隔到 8 步,U/V 余弦大多仍在 0.95 以上。Fig. 2(b) 显示固定两次全计算步 m<n 后,后续 p 的奇异值可按步距比 (p-n)/(n-m) 外推,相对全计算特征的经验误差约 0.71%。邻近两次刷新之间,奇异值范数比还接近常数,主文量到约 1.1。
- 全计算步跑完整骨干,写下当前 Q_t,缓冲区只留最近两次。近似步跳过骨干,重建 X̂_t=U_n Σ̂_t V_n^T + R_n。连续缓存用 Σ̂_t=Σ_n+β_t(Σ_n-Σ_m),β_t=(t-n)/(n-m)。是否允许继续近似,看 chaotic tokens 上曲率加权误差的累积 E_acc 以及已缓存步数 k:E_acc<τ 且 k<N 就继续,否则触发刷新。
- 触发后并不总付一次全 DiT。若上一次刷新已经是全计算,这次就用 Σ̂_t=γ Σ_n、γ=1.1 做缩放近似;若上一次已经是缩放,这次才真正全计算。于是“该刷新”的步里仍有一半可能只更新 r 个奇异值。Fig. 4 把这条控制画成 (a) Adaptive step selection 的 F/S 交替,(b) Rank-r SVD 与双状态缓冲,(c) 橙色 Extrapolation 与绿色 Scaling。整条管线不改模型权重。
逐图理解论文
缓存痛点
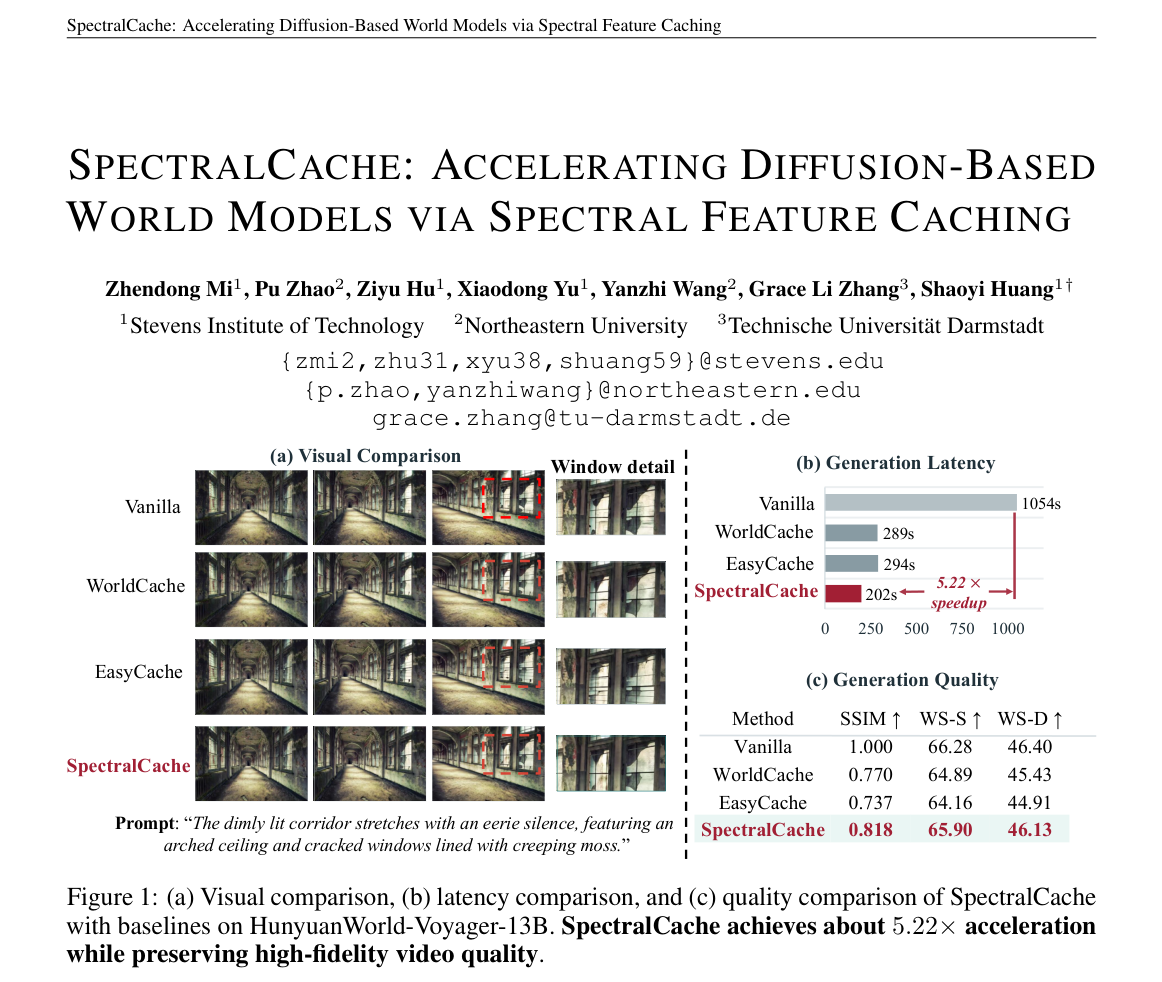
图1是封面对比。标题下 (a) 四行同一走廊提示的生成结果,红框窗口放大后 SpectralCache 的窗棱与苔藓比 WorldCache/EasyCache 更接近 Vanilla。(b) 灰色 Vanilla 1054 s,蓝灰 WorldCache 289 s、EasyCache 294 s,红色 SpectralCache 202 s 并标 5.22×。(c) 表中 SpectralCache 行底色标出 SSIM 0.818、WS-S 65.90、WS-D 46.13。提示词写 dimly lit corridor、arched ceiling、cracked windows、creeping moss。作者行含 Stevens / Northeastern / TU Darmstadt。
频谱观察
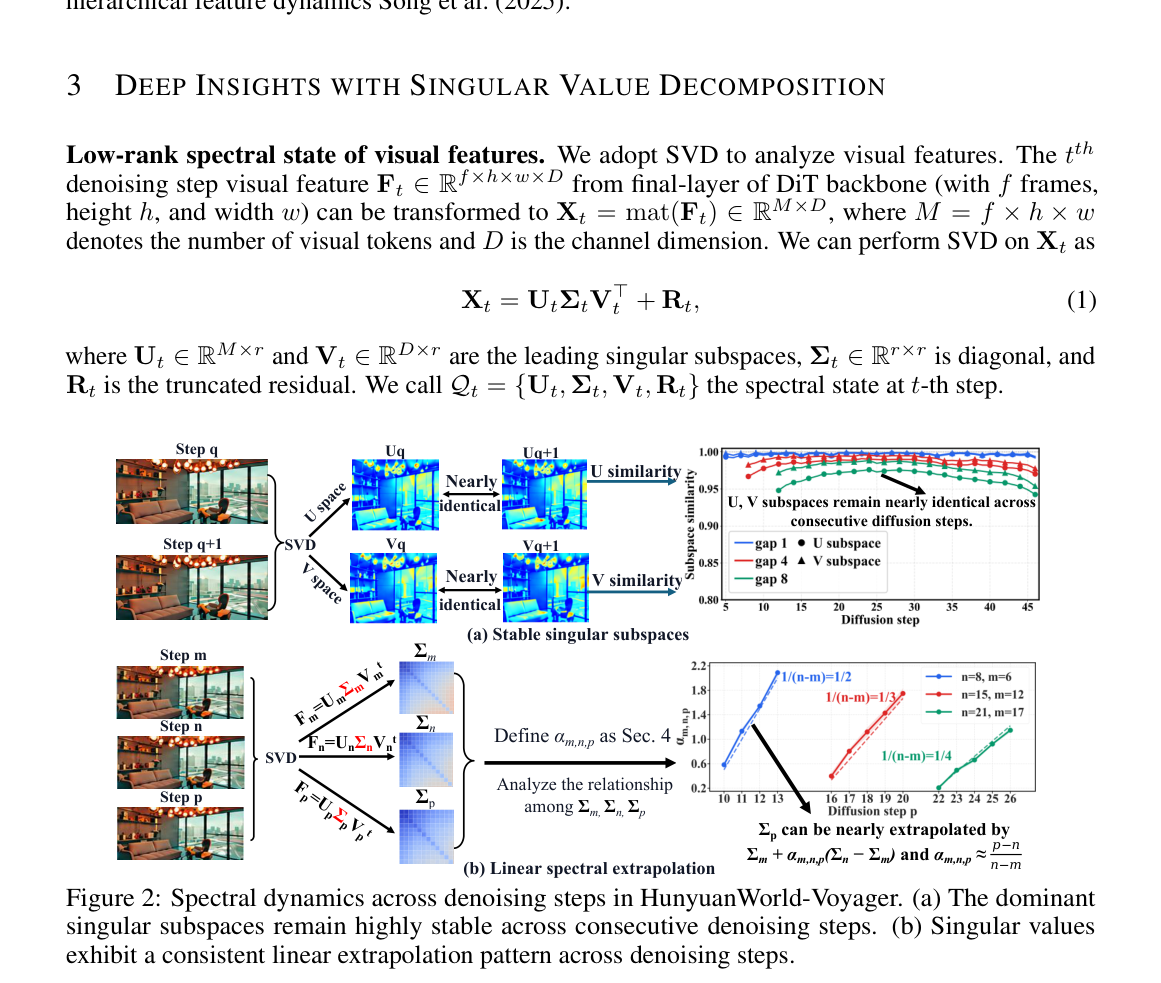
该裁切上半是第三节 SVD 设定与公式 (1),下半才是 Fig. 2。左上 (a):Step q 与 q+1 的室内帧做成 U/V 示意,标 Nearly identical,右侧曲线在 gap 1/4/8 下余弦多在 0.95–1.00,箭头写 U,V subspaces remain nearly identical。(b) 三帧对应 Σ_m、Σ_n、Σ_p 的对角示意,右图 α_{m,n,p} 随 p 近似直线,斜率标 1/(n-m)=1/2、1/3、1/4,公式写 Σ_p≈Σ_n+α(Σ_n-Σ_m) 且 α≈(p-n)/(n-m)。讲图时不要把上方段落当画面元素。
缓存管线
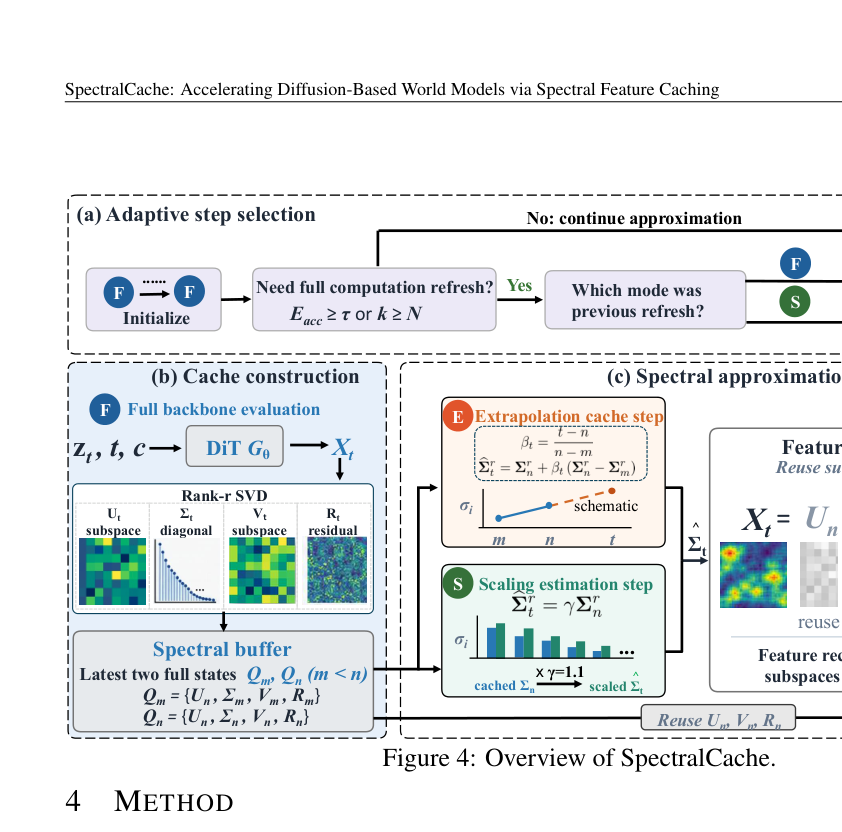
图4是方法总览,宜作特色图。顶部 (a) Adaptive step selection:两次 F 初始化后问 E_acc≥τ 或 k≥N,否就继续近似,是则看上一次刷新是 F 还是 S,二者交替。左下 (b) Cache construction:z_t,t,c 进 DiT G_θ 得到 X_t,再 Rank-r SVD 分成 U_t、Σ_t、V_t、R_t 四张示意热图,Spectral buffer 只保留最近两次全状态 Q_m、Q_n。右 (c) 橙色 Extrapolation 写 β_t=(t-n)/(n-m) 与 Σ̂=Σ_n+β(Σ_n-Σ_m);绿色 Scaling 把 cached Σ_n 乘 γ=1.1。右侧特征重建公式被裁切,完整式是 X̂_t=U_n Σ̂_t V_n^T+R_n,并标注 reuse U_n,V_n,R_n。
结论与局限
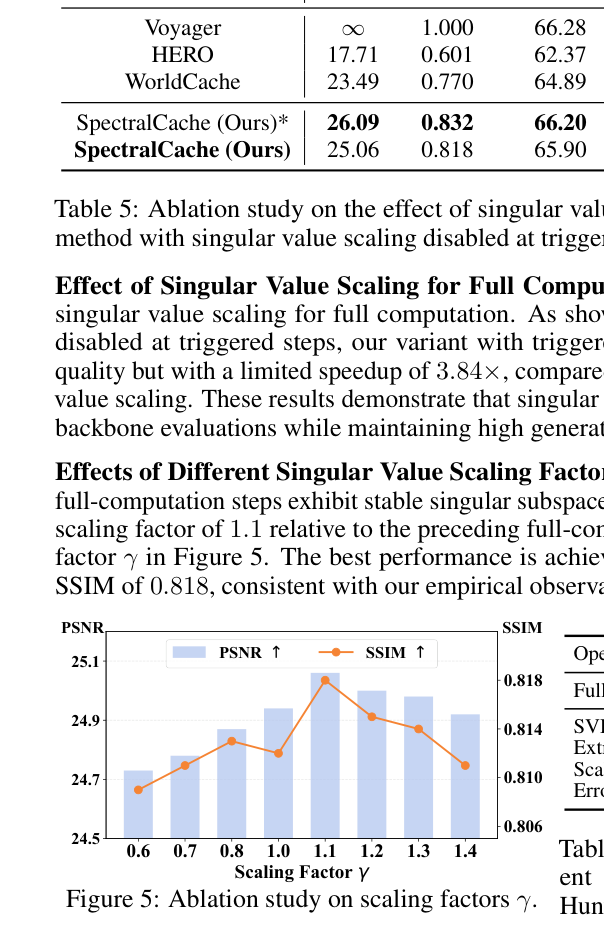
该 PNG 不是干净的 Fig. 5:上方是 Table 5 残表与关于 singular value scaling 的正文,中间才是 γ 扫描柱状图,右侧露出 Table 6 的操作时延。柱为 PSNR,橙线为 SSIM,横轴 γ 从 0.6 到 1.4,二者都在 1.1 处最高,约 PSNR 25.06、SSIM 0.818。Table 5 可见关掉缩放的变体 PSNR 26.09 / SSIM 0.832 / WS-S 66.20,完整方法 25.06 / 0.818 / 65.90。Table 6 列出 Full DiT 17942.06 ms 等。讲 γ 时以柱状图为准,不要把残表当 Fig. 5 面板。
实验如何设计?
- 两个骨干:HunyuanVoyager-13B,512×768、49 帧;Aether-5B,480×720、41 帧。二者都吃初始图像、指令和相机位姿,联合出 RGB 视频与深度。硬件是两张 NVIDIA Pro 6000 96GB。
- 生成质量跟先前世界模型加速工作:WorldScore 分静态与动态;相对无缓存基线报 PSNR、SSIM、LPIPS。三维侧在 Sintel 上评 AbsRel、δ1/δ2、ATE、RPE-t/RPE-r,并报加速比与峰值显存。对照包括 DuCa、ToCa、TaylorSeer、HiCache、TeaCache、EasyCache、HERO、WorldCache。层缓存方法在表注里标了会超单卡、需 CPU offload。
- 默认 r=128、γ=1.1、N=4,其余超参跟 WorldCache/Aether/HERO 对齐。消融扫 rank、N、触发步是否缩放、γ∈[0.6,1.4],并用 Table 6 对比全 DiT、SVD、外推、缩放和误差计算的毫秒开销。
关键结果与论文证据
- Table 1 是主表。Voyager 上 SpectralCache 的 WS-S/WS-D 为 65.90/46.13,PSNR 25.06,SSIM 0.818,LPIPS 0.154,5.22×,显存 50.54 GB,相对 Vanilla 的 50.44 GB 几乎不变。WorldCache 是次强速度/质量折中:3.65×、64.89/45.43、SSIM 0.770。EasyCache 3.58× 但 SSIM 只有 0.737。若干层缓存方法加速不足 1.3×,显存却到 100 GB 以上。Aether 上同样全面最高:65.44/45.82、SSIM 0.959、2.20×,对 WorldCache 的 1.68× 与 0.924 SSIM。注意 §5.2 叙述把 Voyager 写成 65.94/46.16 与 SSIM 0.831,与表格不一致,解读以 Table 1 和 Fig. 1 为准。
- Table 2 看几何是否被缓存毁掉。Aether 上 SpectralCache AbsRel 0.331、δ<1.25 0.520、δ<1.25^2 0.773,深度三项都优于 WorldCache 的 0.341/0.508/0.741;ATE 0.179、RPE trans. 0.060,也略好;RPE rot. 0.800 对 0.796,几乎持平。延迟 16.06 s、3.45×,高于 WorldCache 的 2.61×。说明跳过的是频谱里可预测的幅度,不是把相机与深度结构一起扔掉。
- 消融把加速从哪来拆开。Table 3:rank 128 是默认折中;32 太糙,256 几乎不涨质量还略慢。Table 4:N=4 对应 5.22×;N=3 更像 25.33 PSNR 但 4.87×,N=5/6 更快但 PSNR 掉到 24.72/24.63。Table 5:触发步若始终全计算,质量可以到 PSNR 26.09、SSIM 0.832、WS-S 66.20,非常接近 Vanilla 66.28,加速却只剩 3.84×——5.22× 里有一块是缩放换来的。Fig. 5 的 γ 扫描在 1.1 处形成峰值,和第三节量到的幅度比一致。开销上,一次全 DiT 约 17.9 s,SVD 82 ms,外推 16 ms,缩放 46 ms,误差项 0.33 ms;额外缓存大约 0.1 GB。
阅读时需要注意
- 这是训练无关近似:N 或 γ 选错会把误差累积写进后续帧,主文没有声称对所有扩散架构都成立。
- 相对 Vanilla,Voyager 的 WorldScore 仍低约 0.4/0.3 分,SSIM 也不是 1;关掉缩放能更接近原模型,但加速回落到与 WorldCache 同一量级。
- 没有公开代码/项目页;实验绑定两张 96GB GPU 与两个特定世界模型。Fig. 4 裁切右侧不完整,复现应以公式 (5)(6)(7) 为准。
关联工作
- WorldCache 用异构 token 缓存和误差触发给世界模型加速;SpectralCache 沿用触发逻辑,但缓存对象换成奇异子空间与少量奇异值。
- EasyCache、TeaCache、HERO 代表另一组训练无关基线:在 Voyager 上要么更慢,要么 SSIM/WorldScore 明显更低。
- 常规生成缓存(ToCa、TaylorSeer、HiCache)提醒:世界模型的层次动态让“直接复用特征”更危险,需要先确认哪一部分几何上真的慢变。