快速导读:Video2World把视频到仿真写成编码Agent任务,发现多数系统能交出可执行世界,但任务成功率仍低,而且更好的几何不等于更高的功能正确。
把真实交互变成可交互仿真,本来是扩展具身数据的办法,但Real-to-Sim仍大量靠人搭环境、标定几何和物理。Video2World(arXiv:2610.04432,Aether AI / 加州大学圣迭戈分校)把视频到仿真写成端到端软件工程:编码Agent看RGB具身视频,在指定仿真器和工具里搭建场景与机器人行为,再用执行反馈改代码。项目页https://aetherlabsai.github.io/Video2World 代码https://github.com/AetherLabsAI/Video2World 数据https://huggingface.co/datasets/AetherLabs-AI/Video2World
基准含222个重建实例,来自189段机器人与人类演示、39个任务族。评价拆成几何保真、动力学保真和功能正确。九套前沿编码Agent里,多数能交出可执行世界,但完整完成演示交互仍然难;任务成功率从Claude Opus 5起才从不足5%升到超过15%,最强自动系统Claude Fable 5.1也只有25.5%,人在环路参考58.8%。看起来更像的世界未必更能用:GPT-6 Astra物体形状更好,Fable任务完成更多。
英文题目:Video2World: Benchmarking Coding Agents for Interactive World Modeling from Embodied Videos
论文出处:arXiv 每日论文精选 · arXiv:2610.04432
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1把基准画成开放框架:左侧厨房实验室里多臂机器人,扇形Dataset Composition写222 Tasks,覆盖Robot Manip、Human Manip、Sim Interact、Cross-Embod;底部从真人自我中心操作到白机器人桌面;右侧三条折线Functionality/Geometry/Dynamics随模型抬升,底栏Real Video→现成编码Agent→Interactive World。它要问的是:Agent会不会把看见的交互写成可执行物理世界。
表1对照相关基准。SWE-bench评仓库修bug;VSI-Bench评视频空间问答;RoboDojo、CaP-X、RLE-Bench、EmbodiedSWE-Bench在已有交互环境里做操作或工程;SimuScene、3DCodeBench、SceneActBench、BVB分别偏物理脚本、三维建模、场景动作或可编辑环境重建。没有一条同时覆盖具身、物理、空间、Agent规划和可执行代码,并把任务定义成从RGB视频重建交互环境。
因此评测必须同时看:环境能不能跑;几何是否像源场景;物理滚动是否复现物体运动;以及机器人在重建世界里能不能把演示任务做完。
核心创新
- 把自主视频到仿真写成端到端软件工程,并配上可复现的沙箱协议。
- 用隐藏的物体中心标注同时评几何、动力学和功能正确。
- 在同一接口下比较九套编码Agent系统与人在环路参考,并拆开几何与任务成功。
方法概览
Agent观察视频,在指定仿真器与工具下输出环境η与行为π,用执行反馈迭代修改。222实例来自189段视频、39任务族。隐藏物体中心标注覆盖几何、运动和任务里程碑。指标含Build、交互加权几何、相对起点的动力学误差、Task Success/Progress,合成V2WScore。九套系统各一次自动构建,墙钟180分钟;HAR作人在环路参考。
- 形式化:给定视频v、仿真器S和工具T,Agent输出P=(η,π),η是环境,π是在该本体和控制接口下的行为。执行得到状态–动作轨迹,功能正确要求该滚动在重建环境里用机器人执行复现演示任务。构建是迭代写代码:检查视频与资源、改程序、跑仿真、用反馈改η和π,直到提交或耗尽墙钟/工具预算。
- 数据来自FurnitureBench、DROID、RoboDojo、HOI4D、HOT3D、DexYCB、OakInk2和内部家务集,含真实与仿真、多种本体与视角。每个实例配对源视频与目标配置(仿真器、本体、控制接口)。物体中心标注覆盖场景几何(形状、尺度、关节、空间关系)、物体运动和任务要求(角色、初态、关键事件顺序、终点、进度里程碑),对Agent隐藏。跨本体对齐通过对物体状态与运动,而不是强迫同一条关节轨迹。
- Agent在隔离沙箱里工作,可看视频、仿真API、文档、资产和通用编码工具。内部策略不强制统一脚手架:七套走OpenCode,GPT-6 Astra走Codex CLI,Fable-5.1走Claude Code。每实例一次独立构建,墙钟180分钟,可看物理仿真和渲染滚动并改场景与行为。提交后由评测器接管步进,初始化之后物体变化必须来自动力学而非直接写状态。
- 指标:Build Rate看能否执行。几何用交互加权的场景误差,操纵物、接收物和邻近结构权重大,并报Shape CD、尺寸、位置、相对位姿。动力学比较相对各自起点的平移,并报旋转与可变形表面对应,平移截断1米。功能按任务族定义初态、事件顺序和终点,报Task Success与分级Progress。V2WScore把四块合成0–100,先在任务族内平均再等权跨族。失败构建在成功与进度上记零。
逐图理解论文
视频写成软件任务
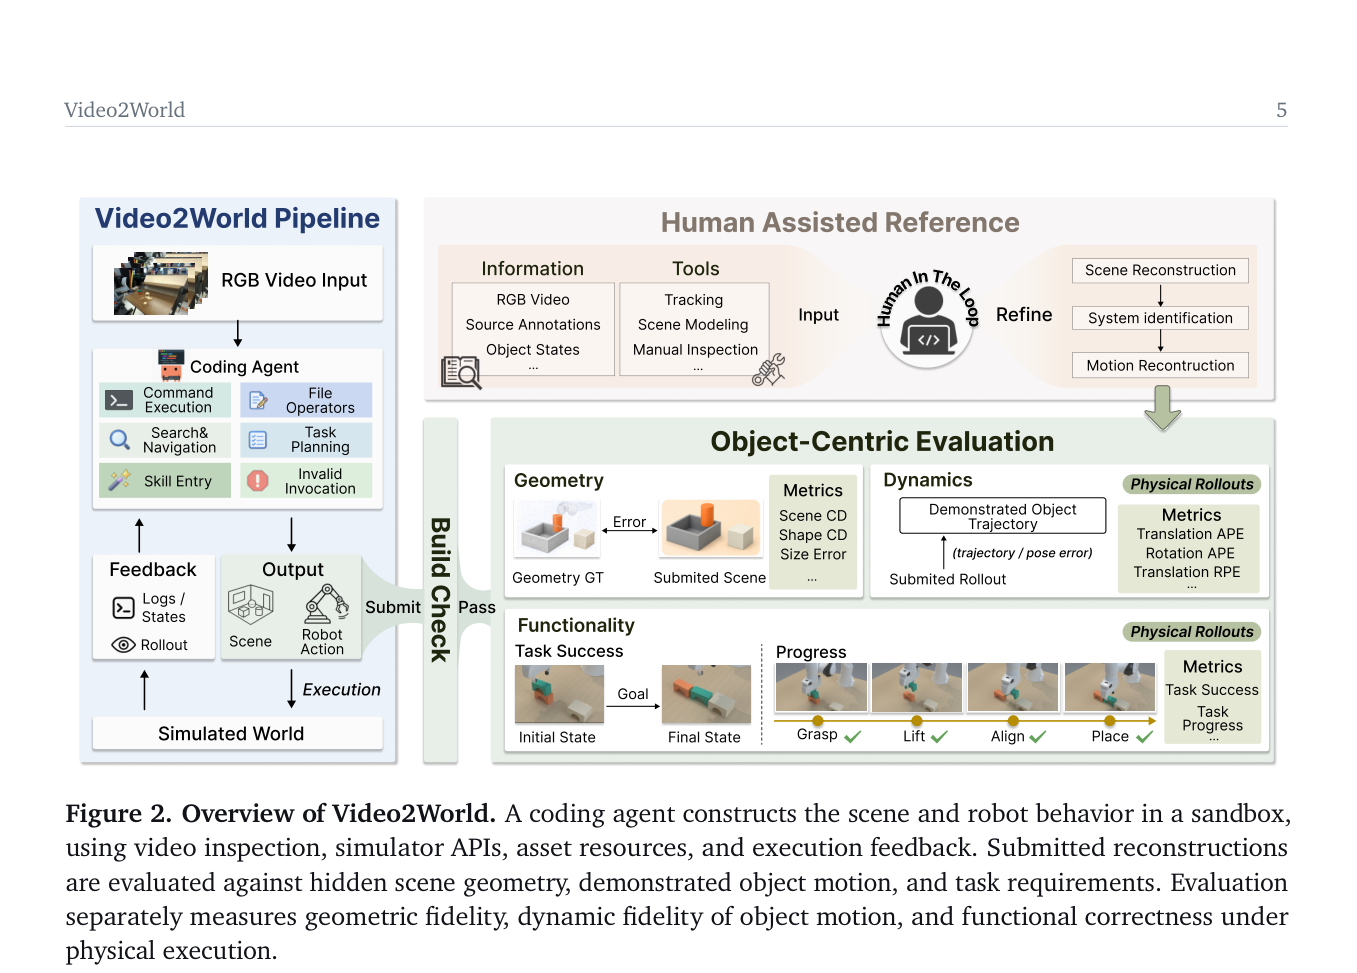
图2是流水线,宜作特色图。左蓝Video2World Pipeline:RGB视频进入编码Agent(命令执行、文件、搜索导航、任务规划、技能入口、非法调用),输出场景与机器人动作,经Execution进Simulated World,日志/状态/滚动反馈再改。Submit过Build Check才进入评测。上粉Human Assisted Reference:源标注加跟踪、场景建模、人工检查,人在环路refinement场景、系统辨识与运动重建。下绿Object-Centric Evaluation分Geometry(GT对提交、Scene/Shape CD、尺寸)、Dynamics(演示轨迹对提交滚动、T-APE/R-APE/T-RPE)、Functionality(初末态成功;Grasp/Lift/Align/Place进度)。隐藏真值不给Agent。
关键证据
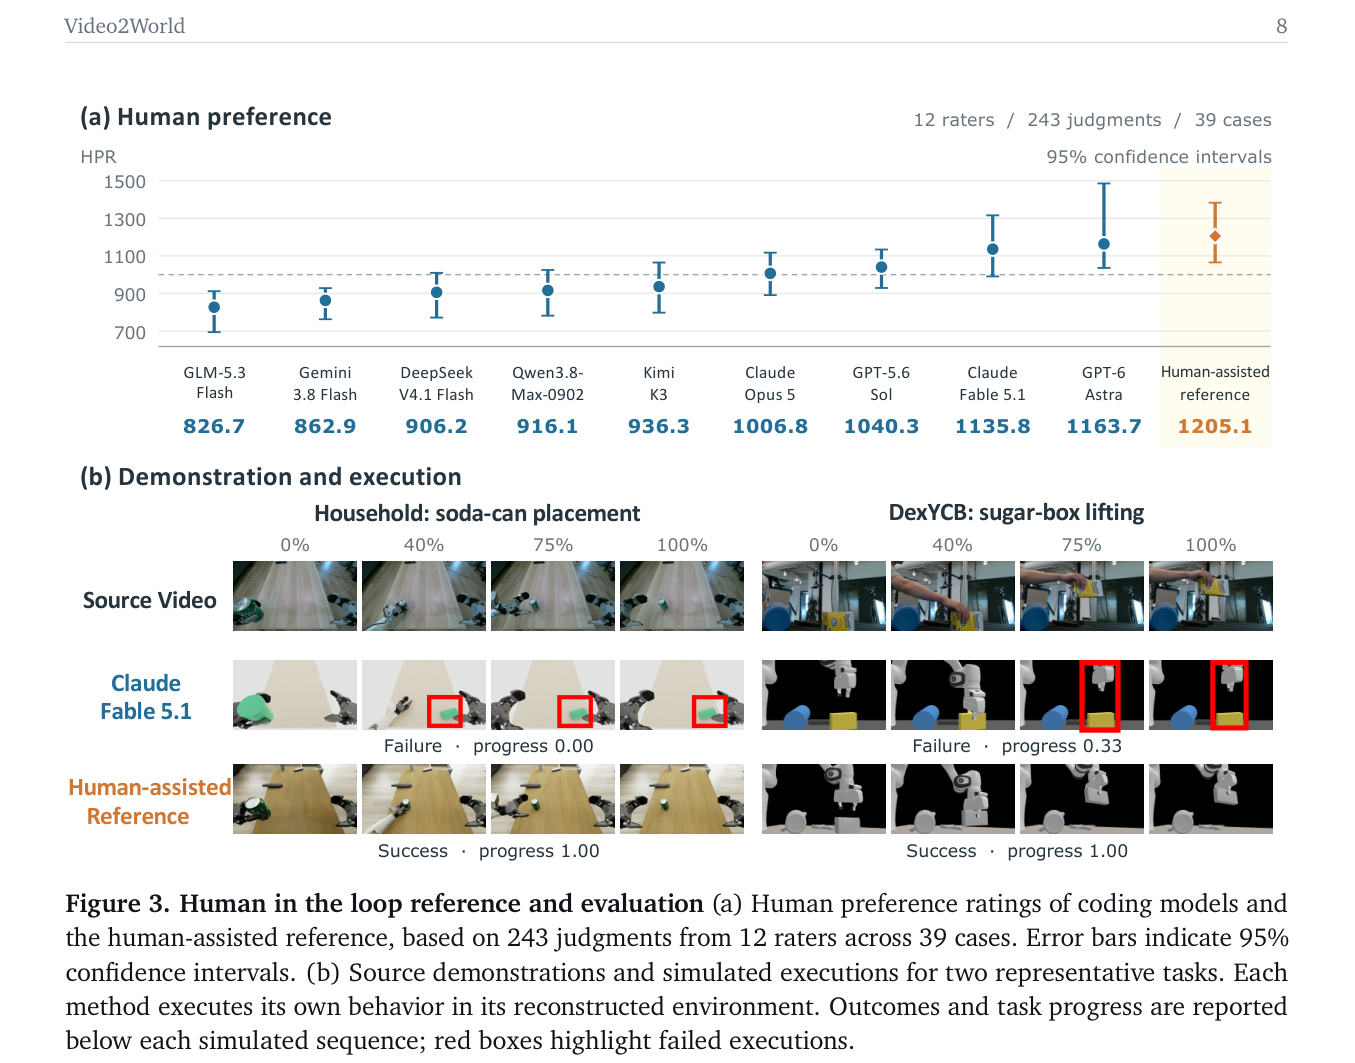
图3对照人类偏好与执行。(a)HPR误差棒:GLM-5.3 Flash 826.7到GPT-6 Astra 1163.7,橙HAR 1205.1,虚线约中位,12人/243判断/39案例。(b)左家务放汽水罐、右DexYCB举糖盒,时间轴0/40/75/100%。源视频是真人;Fable仿真里罐子错位、盒子对不齐,红框Failure进度0.00与0.33;HAR两列Success进度1.00。每个方法在自己重建的环境里执行自己的行为,不是共用同一世界。
Figure 4
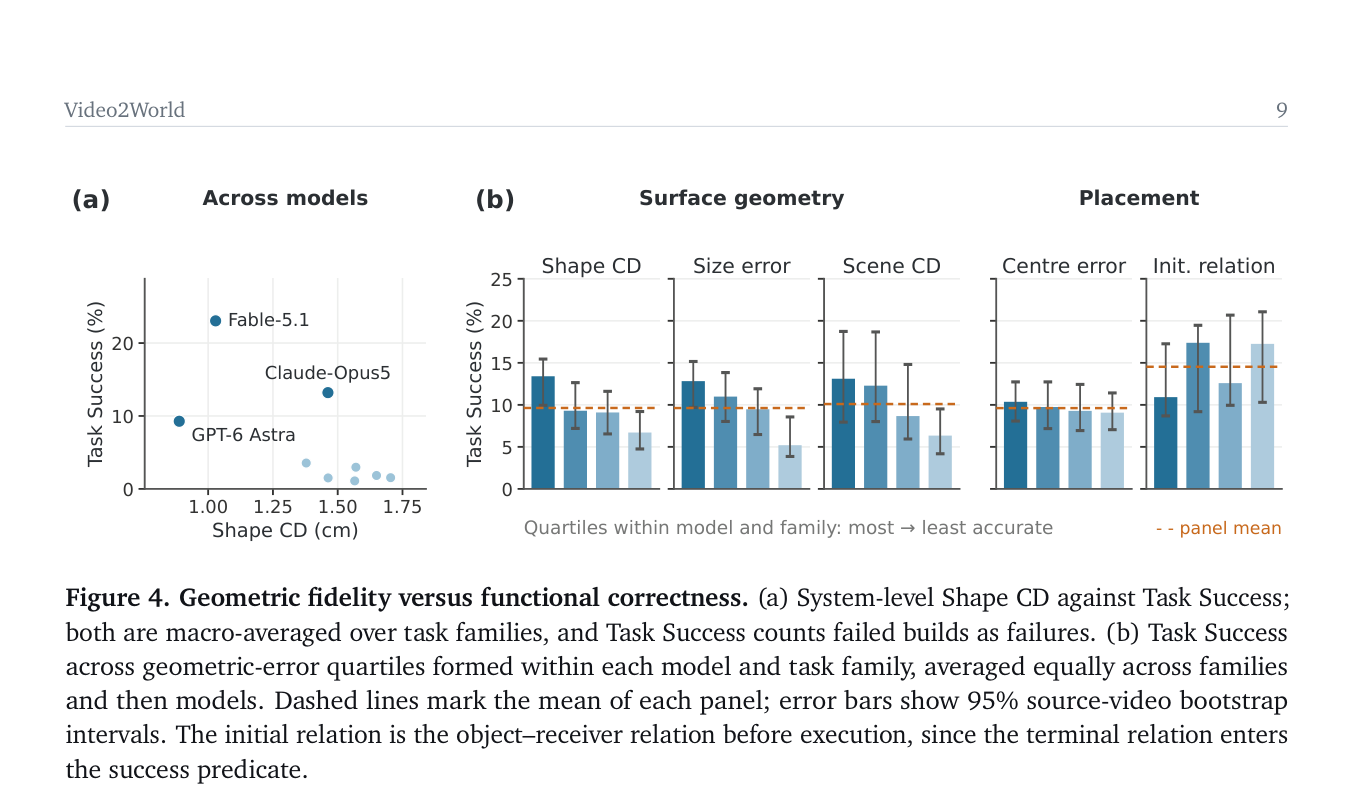
图4把几何和功能拆开。(a)横轴Shape CD、纵轴Task Success:Fable-5.1最高成功约23%、Shape CD约1.0 cm;GPT-6 Astra更靠左但成功约10%;Claude-Opus5居中;其余点成功接近0。失败构建算失败。(b)五组四分位柱,最准到最差:Shape CD、Size error、Scene CD的成功下降;Centre error较平;Init. relation因终点关系已进成功谓词,不能按表面趋势解释。虚线是面板均值,误差条是源视频自助区间。
实验如何设计?
- 九套编码Agent系统在全部222实例上各一次自动构建,不按隐藏分数人工挑选。人在环路参考HAR额外使用源标注并手工refinement,作为经验上界而不是完美金标准。
- 图3a:12名评分者、243次判断、39个案例的成对人类偏好,报HPR点估计与95%区间。图3b选家务放汽水罐和DexYCB举糖盒,源视频、Fable与HAR各执行自己环境里的自己行为,红框标失败。
- 图4把Shape CD与Task Success放在一起:系统级散点按任务族宏平均,失败构建算失败;分位数图在模型×任务族内按几何误差四分位,再对族和模型等权平均,误差条约95%源视频自助区间。初始关系是执行前的物体–接收物关系,因为终点关系已进入成功谓词。
- 图5补充40个HAR成功实例、35段视频的末端执行器统计,不是主表排序依据,本文视觉选用图1–4。
关键结果与论文证据
- 能跑不等于能做完。表2里自动系统Build Rate多在87.6–93.1%,但Task Success远低于Progress。Fable-5.1 V2WScore 48.52、成功25.5%、进度0.53;Opus 5成功16.0%;Astra成功10.7%但Shape CD 0.69 cm、尺寸误差1.62 cm优于Fable的1.00/2.78。更弱模型成功常低于5%(第7页)。
- 人在环路更强但不完美。HAR V2WScore 74.24、Build 100%、成功58.8%、进度0.70、Scene CD 2.19 cm。图3a中HAR HPR 1205.1,Astra 1163.7、Fable 1135.8,开源Flash档在826.7–916.1。图3b上Fable放罐进度0.00、举盒0.33且红框标错位,HAR两例成功进度1.00。说明任务在配置下可行,也说明有源信息仍难稳定复现可执行行为(第8页)。
- 几何帮助功能,但不保证功能。图4a:Fable成功约四分之一、Shape CD约1 cm;Astra形状更好但成功更低;其余点堆在更大Shape CD、成功接近零。图4b:Shape CD、尺寸误差、Scene CD从最准四分位到最差时成功下降;中心误差较平;初始关系因进入成功谓词的是终点关系,趋势不可直接当因果。作者结论:应分开报忠实重建与任务有效重建(第9页)。
- 摘要还写:世界看起来更好,工作起来可能更差,呼应生成模型里感知真实与事实正确的裂隙。成功重建的末端运动统计与源演示仍相关,但那是HAR成功子集上的补充检查,不能代替功能指标。
阅读时需要注意
- 每实例只有一次构建,墙钟180分钟,结果依赖脚手架和推理设置,比较的是完整Agent系统而不是裸模型。
- HAR自身任务成功只有约六成,不能当成已解决的仿真上界;跨本体对齐看物体状态,末端运动只在成功HAR子集上核对。
- 几何与功能在系统级会错位,用单一视觉分数排序会误导。预印本,未同行评审。
关联工作
- RialTo、Re3Sim、PhysTwin、GenSim、RoboGen、Video2Policy和Agentic Real-to-Sim走真实到仿真或生成仿真,但不是把编码Agent从RGB视频端到端搭交互世界写成可复评软件任务。
- SWE-bench、CaP-X、RLE-Bench、EmbodiedSWE-Bench、3DCodeBench、SceneActBench、SimuScene、BVB各切一刀;Video2World要求具身、物理、空间、Agent与代码同时成立。
- 作者把交互世界重建写成联合的场景–行为问题,主张用执行接地的评价,而不是只看单路保真。项目页https://aetherlabsai.github.io/Video2World 代码https://github.com/AetherLabsAI/Video2World