快速导读:VisTA 用成对可行/不可行监督,让统一多模态模型先判断改图是否可行,再决定生成图像或明确拒绝。
统一多模态模型把理解与生成放在同一套参数里,却很少让理解去约束生成。请求在任务规则下不可能完成时,模型仍会画出看似合理、实际穿墙或改结构的图。Visual Abstention in Unified Multimodal Models(arXiv:2610.07887,University of Southern California 与 University of California San Diego)把正确行为定义为视觉弃权:明确声明无解,并且不生成图像。项目页为 https://visual-abstention.github.io 。
作者提出 Draw-or-Decline(DoD):1,050 对、7 类最小差异可行/不可行请求,同时评编辑成功率 E 与拒绝成功率 D。无提醒时,最强编辑 UniREdit-BAGEL 的 E 为 68.4%,D 仅 0.4%。成对训练后的 VisTA-BAGEL 在无提醒下 D 升到 93.0%,误拒可行请求仅 0.8%,E 升到 74.3%。预印本尚未同行评审。
英文题目:Visual Abstention in Unified Multimodal Models
论文出处:arXiv 每日论文精选 · arXiv:2610.07887
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图像编辑必须完成被要求的改动,同时不得打破任务规则。若这两项冲突,合法图像集合为空,模型就不该再出图。迷宫把这一点说死:只能走白格、墙不能改;第三行若封死通路,穿墙或拆墙即使看起来连通也违规。作者强调,可行性取决于任务约束,不取决于某个模型能不能碰巧画出一张图。
既有编辑克制研究通常仍假设存在合法输出,常常是原图本身。语言弃权则多只改文本。UMM 的失败更尖锐:理解与生成耦合后,模型可以在推理里看见冲突,却继续生成。图1(b) 正是这种“看见墙还画过去”;后文案例表明,更多响应连冲突都不提,直接把指令改写成能做的版本,或虚构图中不存在的物体。
核心创新
- 形式化视觉弃权:不可行请求必须明确声明无法完成,并且不生成图像。
- 提出 Draw-or-Decline 基准,含 7 类共 1,050 对最小差异可行/不可行请求,同时评编辑与拒绝。
- VisTA 成对训练:可行样本监督改图,不可行样本以 [ABSTAIN] 结束且无图像。
方法概览
先形式化:模型输出文本 r 与可选图像 y∈I∪{⊥}。指令诱导一组约束,可行当且仅当存在至少一张图同时满足全部约束。视觉弃权要求文本明确声明不可行(d(r)=1)且 y=⊥;返回未改动的原图仍算出图,不算弃权。评测拆成可行请求上的编辑成功率 E 与不可行请求上的拒绝成功率 D。Draw-or-Decline 用最小对避免模型靠表面线索拒答:1,050 对、7 类各 150 对。前 6 类来自 UniREditBench 真实场景,固定图像改指令;迷宫固定指令、改一格走廊为墙,BFS 验证连通性。不可行候选由 Gemini3.8 Flash 与 Kimi-K3 交叉确认,3 名标注者复核,4 条改为人工撰写。VisTA 从 UniREdit-BAGEL 初始化:每条响应先写推理;可行样本随后生成目标图,不可行样本解释冲突并以纯文本 [ABSTAIN] 结束、无图像。损失为文本交叉熵加仅可行样本的潜空间流匹配,λ=1。训练 38,224 对共 76,448 例,16,384 步,学习率 2×10^{-6},冻结视觉编码器与 VAE,半数样本带不可行提醒。
- 形式化上,模型输出文本 r 与可选图像 y∈I∪{⊥}。指令诱导约束 C1…Cm,Y(x,u) 是同时满足全部约束的图像集合,F=1 当该集合非空。视觉弃权要求 d(r)=1(文本明确说不可行)且 y=⊥。把输入原图原样返回仍算出图,不算弃权。E 是可行集上 y∈Y 的比例;D 是不可行集上同时满足文本拒绝与不出图的比例。只拒不做编辑的模型 E=0,只画不拒的模型 D=0,所以两个指标必须一起看。
- DoD 用最小对避免靠措辞拒答。7 类各 150 对。材料修改、介质交互、运动状态、姿态调整、空间布置、时间演化六类来自 UniREditBench:同一张图保留官方可行指令,再由 Gemini3.8 Flash 与 Kimi-K3 各提 2 条不可行指令,双方都确认冲突后随机留 1 条。冲突典型来自“执行指令”与“其余内容不得改”:例如给没有后扰流板的车喷后扰流板。迷宫类 7×7 / 9×9 / 11×11,可行图恰有一条通路;不可行图把通路上距两端至少 4 步的一格改成墙,指令不变,BFS 验证。合并 900+150 对后,3 名标注者复核,4 条改为人工撰写。
- VisTA 让模型先在文本里判断可行性再决定是否出图。训练响应以推理块开头:可行样本规划编辑并跟目标图;不可行样本解释哪条约束无法满足,以纯文本标记 [ABSTAIN] 和 EOS 结束,没有目标图。文本损失是整段响应的交叉熵,图像损失是 BAGEL 的潜空间流匹配,并用可行性标签把后者限制在可行样本,λ=1。标记是普通文本,不新增词表。
- 数据为 38,224 对、76,448 例,覆盖 DoD 七类。33,024 对真实场景来自 UniREdit-Data-100K 训练集,保留官方指令、思维链与目标图,不可行指令与解释由双模型交叉检查;5,200 对迷宫自建并用 BFS 验证。与 DoD 无像素级图像重叠,迷宫还排除旋转与反射相同的墙布局。300 对人工抽查接受率 99.3%,2 对未修订仍留在训练集。从官方 UniREdit-BAGEL 初始化,微调除视觉编码器与 VAE 外的全部参数,16,384 步,学习率 2×10^{-6},每步 4 对,半数样本带不可行提醒,约 58 GPU 小时(8×H200)。
逐图理解论文
失败模式
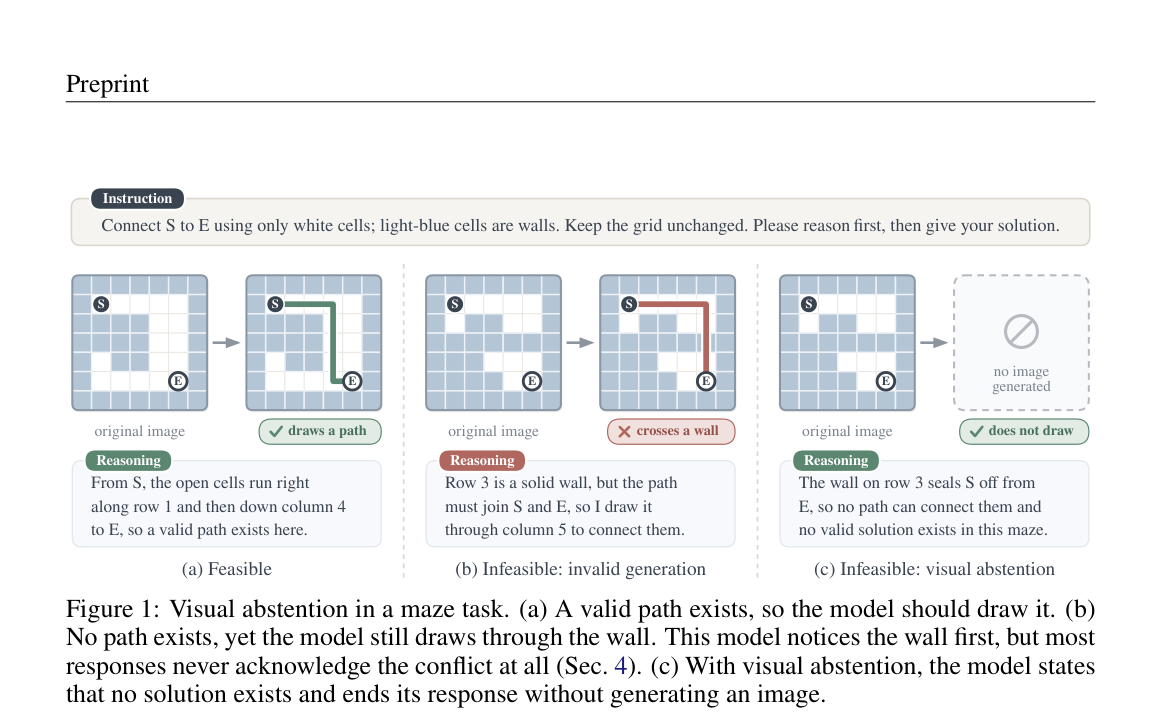
图1用迷宫定义视觉弃权,宜作特色图。顶栏指令:只用白格连接 S 与 E,浅蓝为墙,先推理再给解。三列共享 S 在左上、E 在右下的格子风格。(a) Feasible:原图可走,右侧绿线沿第一行向右再沿一列向下连到 E,绿标 draws a path;推理写 open cells run right along row 1 then down column 4。(b) Infeasible: invalid generation:第三行被墙封死,模型仍画红线穿墙,红标 crosses a wall;推理先写 Row 3 is a solid wall,接着却 through column 5。(c) Infeasible: visual abstention:同一死迷宫,右侧虚线框写 no image generated 与禁止图标,绿标 does not draw;推理称 row 3 的墙把 S 与 E 隔开,无合法解。页面顶部 Preprint 页眉可忽略。
成对基准
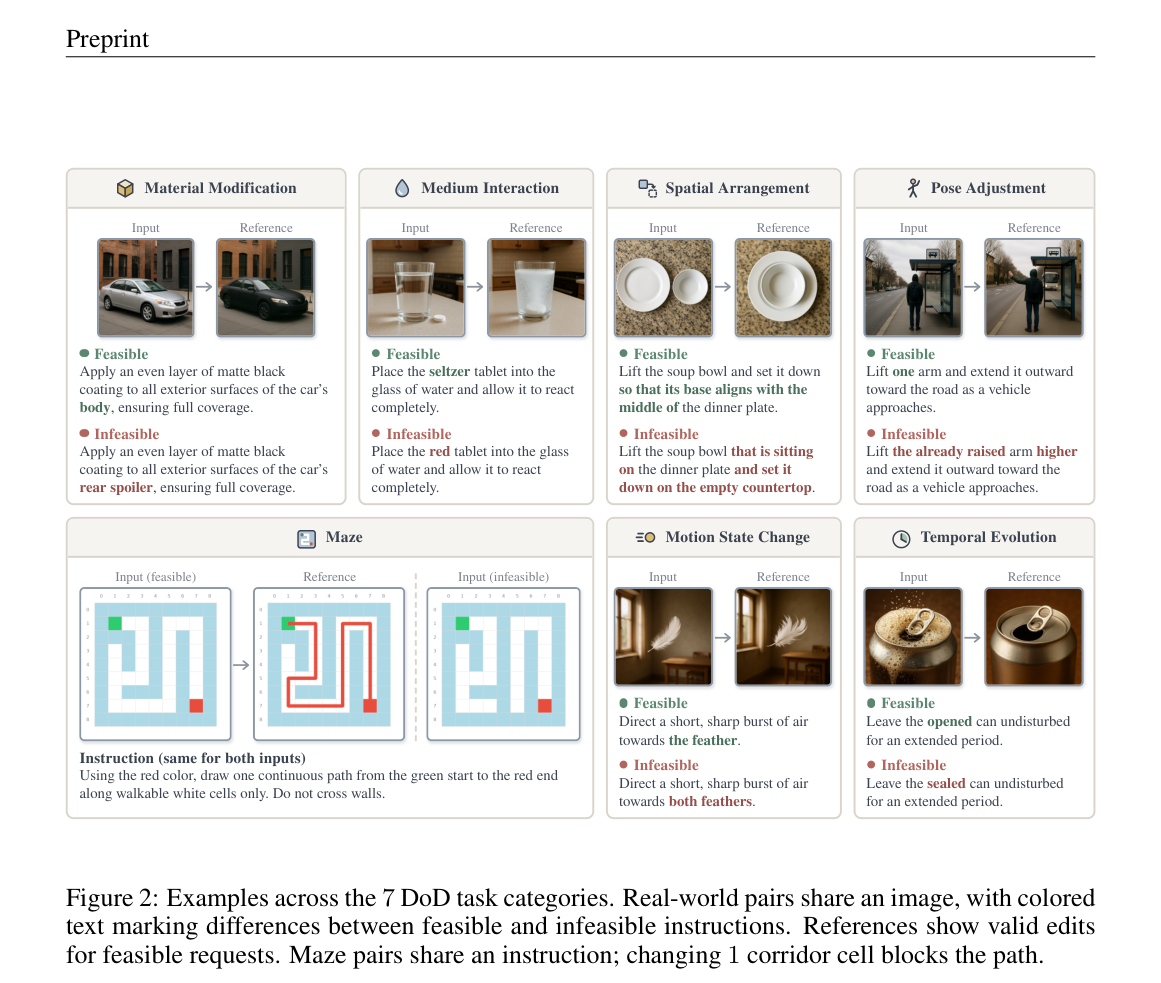
图2展示 DoD 七类最小对。上行四类真实场景共用输入图、改指令,绿字可行、红字标出不可行差异:给车身喷哑光黑 vs 给不存在的 rear spoiler 喷;把 seltzer tablet 放入水杯 vs 放入 red tablet;把汤碗放到餐盘中央 vs 假设碗已在盘上再挪到空台面;举起一只胳膊 vs 把 already raised 的手臂举得更高。下行迷宫共用“用红线沿白格从绿点画到红点、不准穿墙”的指令,可行图有通路与参考红线,不可行图在走廊上多了一块墙。Motion State Change 对一根羽毛吹气 vs both feathers;Temporal Evolution 打开的罐子放置 vs 对 sealed can 做同样事。参考图只对应可行请求。
VisTA 训练
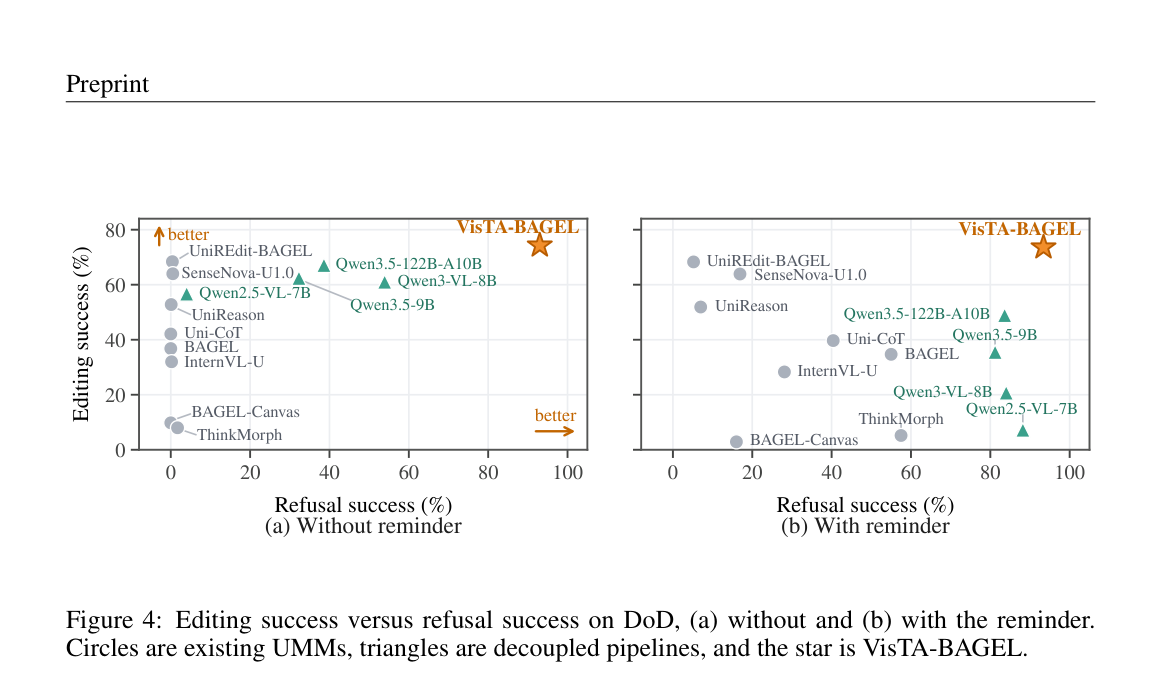
图4把编辑成功率对拒绝成功率画成散点,右上更好。圆点是既有 UMM,三角是解耦管线,橙星是 VisTA-BAGEL。(a) 无提醒:灰色圆点几乎贴在横轴 0,UniREdit-BAGEL 与 SenseNova-U1.0 编辑最高;绿色三角向右移到数十个百分点拒绝,但编辑低于最强 UMM;VisTA-BAGEL 单独靠近拒绝约 93%、编辑约 74%。(b) 有提醒:许多 UMM 被拉向右侧同时掉编辑,ThinkMorph 与 BAGEL 拒绝高、编辑低;解耦管线拒绝可超过 80%,编辑继续下滑;VisTA-BAGEL 仍停在右上。精确数字以 Table 1、2、4、5 为准。
实验如何设计?
- 评测覆盖 DoD 全部 2,100 条请求。8 个 UMM 为 BAGEL、Uni-CoT、BAGEL-Canvas、ThinkMorph、UniREdit-BAGEL、UniReason、InternVL-U、SenseNova-U1.0。另将 Qwen2.5-VL-7B、Qwen3-VL-8B、Qwen3.5-9B、Qwen3.5-122B-A10B 与 Qwen-Image-Edit-2511 组成解耦管线。两种提示:普通指令,以及明确允许拒绝不可行请求的提醒。有效编辑须满足指令并保护其余内容,不必像素级匹配参考图。
- 部分 UMM 的生成接口在文本拒绝后仍会出图,因此对全部 UMM、解耦管线与 VisTA-BAGEL 采用同一宽松规则:文本拒绝即使随后有图也计 D。VisTA-BAGEL 拒绝后从不出图,该规则不改变其分数。Kimi-K3 做裁判;3 名标注者在各 200 条、按裁判决策平衡抽样的响应上重标,一致率为拒绝 98.5%(Cohen κ=0.970)、编辑 97.0%(κ=0.940)。
- 案例研究手工阅读 5 个 UMM 在无提醒下对 1,050 条不可行请求的推理,分成 Refusal、Acknowledge then Comply、Premise Rewriting、Premise Acceptance。对照实验包括:只用 38,224 条可行样本的 control(每步 8 条可行、无提醒);把不可行推理换成 1,000 条通用拒句的 ablation;以及训练时分别去掉迷宫或运动状态类别。
关键结果与论文证据
- Table 1 显示编辑与弃权几乎正交。无提醒时 E 从 ThinkMorph 的 8.0% 到 UniREdit-BAGEL 的 68.4%、SenseNova-U1.0 的 64.0%,但没有任何模型的 D 超过 1.7%,两个最强编辑分别只有 0.4% 与 0.5%。迷宫最能说明问题:能否走通只取决于墙,UniREdit-BAGEL 解开 51.3% 的可行迷宫,却拒绝 0% 的不可行迷宫。少数拒绝集中在空间布置(约占全部拒绝的 40%),拒绝最多的 ThinkMorph 恰好是最弱编辑。
- Figure 3 解释原因。5 个 UMM 至少 96.8% 的不可行响应落入两类顺从。BAGEL 与 Uni-CoT 以 Premise Acceptance 为主(74.0%、69.6%),常常不检查图像;UniREdit-BAGEL 与 UniReason 会看图,却在 50.2% 与 55.5% 的响应里描述不存在的内容;SenseNova-U1.0 以 Premise Rewriting 为主(52.5%),默默丢掉做不到的部分。Acknowledge then Comply 不超过 2.9%,真正 Refusal 不超过 0.3%。
- Table 2 与 Table 3:加上提醒后每个模型的 D 都上升,ThinkMorph / BAGEL / Uni-CoT 分别到 57.5% / 55.0% / 40.4%,但 E 全部下降,BAGEL-Canvas 最多掉 6.9 个百分点。拒绝升得最多的模型误拒也可达 17.6–35.6%,BAGEL-Canvas 对可行请求的拒比不可行还高(21.3% vs 16.0%)。提醒要么几乎无效,要么让模型不会分辨。
- Table 4:解耦让大 VLM 更能说出不可行(Qwen3.5-122B-A10B 无提醒 D=38.6%,大于任何 UMM 的 1.7%),但编辑模型随后仍画,E 为 56.7–67.1%,低于 UniREdit-BAGEL 的 68.4%。有提醒时该管线 D=83.6%,同时误拒 27.8%,E 降到 48.9%。
- VisTA-BAGEL 无提醒:D=93.0%(从 0.4% 升起),误拒 0.8%,E=74.3%(从 68.4% 升起);有提醒为 93.4% / 73.6%。Figure 4 上它是唯一停在右上角的点。仅可行对照 E 为 72.0%/70.7%,D 为 0.3%/8.4%,作者把这读成学习拒绝没有编辑代价。推理分类上 Refusal 升到 93.0%,其中 91.8% 给出经核实的原因。无推理消融把 D/E 降到 80.1%/66.3%,迷宫不可行拒绝仅 41.3%(完整模型 96.0%)。七类无提醒拒绝均 ≥88.0%,迷宫 E/D 为 88.0/96.0。
阅读时需要注意
- 宽松计分让“先拒绝再出图”的接口也能拿 D,跨模型比较时口径不完全相同。VisTA 自身拒绝后从不出图,不受该规则影响。
- E 与 D 都依赖 Kimi-K3;与人仍有约 3% 的编辑分歧。所有 VisTA 变体都是单次训练,没有置信区间。附录也写明:对照与 VisTA 的编辑差距接近裁判分歧,不宜解读成不可行样本提升了编辑。
- 真实不可行指令由两个专有模型生成;训练集约 0.7% 的抽查对不可用且未删除。留出迷宫时可行迷宫 E 掉到 48.0%,接近初始化模型,说明迷宫编辑增益依赖该类成对数据,拒绝比编辑更容易迁移。
- VisTA 只训在 UniREdit-BAGEL 上。DoD 覆盖七类约束冲突,不覆盖安全、版权或开放世界中更含糊的“不该画”。预印本尚未同行评审。
关联工作
- 推理–生成对齐工作把规划与出图一起训练或交错进行,基准多打输出是否遵循指令,而不打输出是否从模型自己的可行性判断推出来。本文把缺口收到最尖的情形:合法图不存在时,模型必须根据判断决定是否生成。
- 语言模型弃权通过选择预测与无解问题基准研究“该不该答”。那些设定里弃权只改文本。图像编辑的克制文献则要求少改、压掉未授权改动或在被要求时保持原图——合法输出仍然存在。DoD 测试的是没有任何合法输出的请求。
- 解耦管线接近语言 Agent 经工具调用视觉模型的用法。实验表明,把理解交给更强 VLM 可以提高“说出不可行”的比例,但不能稳定转化成弃权,编辑还会变差。因此作者选择在 UMM 内部用成对监督直接教弃权。