快速导读:MoR-MLLM 把 Mixture-of-Recursions 接到多模态大模型,用三阶段 MoR-Tuning 与熵正则路由,按词元难度分配递归深度。
多模态大模型已经能做视觉问答与指令跟随,但训练显存和推理浮点运算仍然把部署挡在门外。稠密小模型每个词元都走完全部参数;MoE-LLaVA 这类稀疏模型按词元选专家,层深却仍然固定。MoR-MLLM(arXiv:2610.08830,电子科技大学、庆熙大学、Nota Inc. 与同济大学)把 Bae 等人的 Mixture-of-Recursions 接到多模态设定:共享递归模块反复使用,轻量路由器决定每个视觉或文本词元还要不要再算一步。
作者强调贡献不在递归共享或自适应路由本身,而在于如何把预训练稠密语言模型稳定改成计算稀疏的 MLLM。为此他们设计三阶段 MoR-Tuning,并用熵正则避免所有词元塌到同一深度。在八张 RTX 4090 上,预训练加微调合计 65 GPU 小时;相对 LLaVA-1.5-7B,平均 TFLOPs、显存与首 token 延迟分别降 86.6%、54.1%、54.5%。九项基准上,用 2.2M 样本训练的模型在 GQA 与 SEED 上表现突出。预印本尚未同行评审。
英文题目:MoR-MLLM: Mixture of Recursions for Efficient Multimodal Large Language Models
论文出处:arXiv 每日论文精选 · arXiv:2610.08830
原始论文:PDF / 论文页面
这篇论文解决什么问题?
缩放有效:Qwen-VL-72B 与若干超过 100B 的工作把精度推上去,也把计算与显存推到难以落地。压缩权重、减少视觉词元、参数高效适配只能缓解一部分。轻量 MLLM 因此分成参数稠密与参数稀疏两类。前者如 MiniCPM-V、MobileVLM,结构更小,推理时每个词元仍激活全部参数;后者如 MoE-LLaVA,每个词元只进一部分专家,但仍然穿过预定层数。
结果是:模型不能把更深的计算留给视觉或语言上更难的词元,也不能让简单词元提前退出。MoR 在语言侧已经演示了按词元递归深度分配计算,但直接搬到多模态会把视觉对齐、共享模块初始化和路由学习缠在一起,优化容易崩。RecursiveVLM 同期把递归 Transformer 接到多模态,却仍用固定深度。作者要解决的是这条适配与训练路径,而不是再发明一种递归模块。
核心创新
- 把 MoR 做成计算稀疏 MLLM:中间层分组替换为共享递归块,用逐步 expert-choice 按词元分配递归深度。
- 三阶段 MoR-Tuning 把视觉对齐、递归模块与路由器适应、下游联合微调解耦,避免同时稀疏化导致崩溃。
- 用熵正则最大化每词元深度分布的熵,抑制单一深度塌缩,并配合 grouped sharing 初始化。
方法概览
骨干沿用 MoE-LLaVA 设定:CLIP-Large/336 视觉编码器、两层 GeLU MLP 投影、Phi-2(2.7B)语言模型。保留首尾各一层标准 Transformer,把中间 30 层均分成 m 组,每组换成一个 MoR 块:共享 Transformer 子模块 M(·) 加线性+sigmoid 路由器。输入把投影后的视觉词元与文本嵌入拼接。路由采用 expert-choice:每一步由当前隐状态打分,超过该步分数的 β 分位数才进入共享模块做残差更新,未选中词元直接跳过。默认 m=5、Pβ=80%、最大递归深度 S=32。训练分三阶段 MoR-Tuning。Stage I 只训 MLP,用 LLaVA-Pretrain 558K 做视觉对齐。Stage II 用 grouped sharing 初始化共享模块,只训 M(·) 与路由器,路由器负偏置鼓励浅递归,数据为 964K 混合语料(SViT 157K、LVIS 220K、LRV 331K、MIMIC-IT 256K)。Stage III 解冻 Transformer、词嵌入与 MLP,配合 LoRA 在 LLaVA-Mix665k 上联合微调,并加入熵正则防止路由塌到单一深度。总目标为任务损失加 λent·Lent,默认 λent=0.10。优化用 AdamW、无权重衰减、余弦学习率;三阶段分别为 10K/20K/30K 步,学习率 1e-4 / 5e-5 / 2e-5,全局 batch 64/64/32;图像 336×336,文本最长 2048,Bf16;八张 RTX 4090,Stage I–II 用 ZeRO-2,Stage III 开 offload。
- 骨干与 MoE-LLaVA 对齐,便于对照:CLIP-Large/336 出视觉词元,两层 GeLU MLP 投到语言模型隐空间,Phi-2(2.7B)做语言骨干。图像 336×336,文本最长 2048。保留首尾各一层标准 Transformer,中间 30 层均分成 m 组,每组换成一个 MoR 块。消融取 m=5,即五个共享模块加五个路由器。路由器是线性投影加 sigmoid。
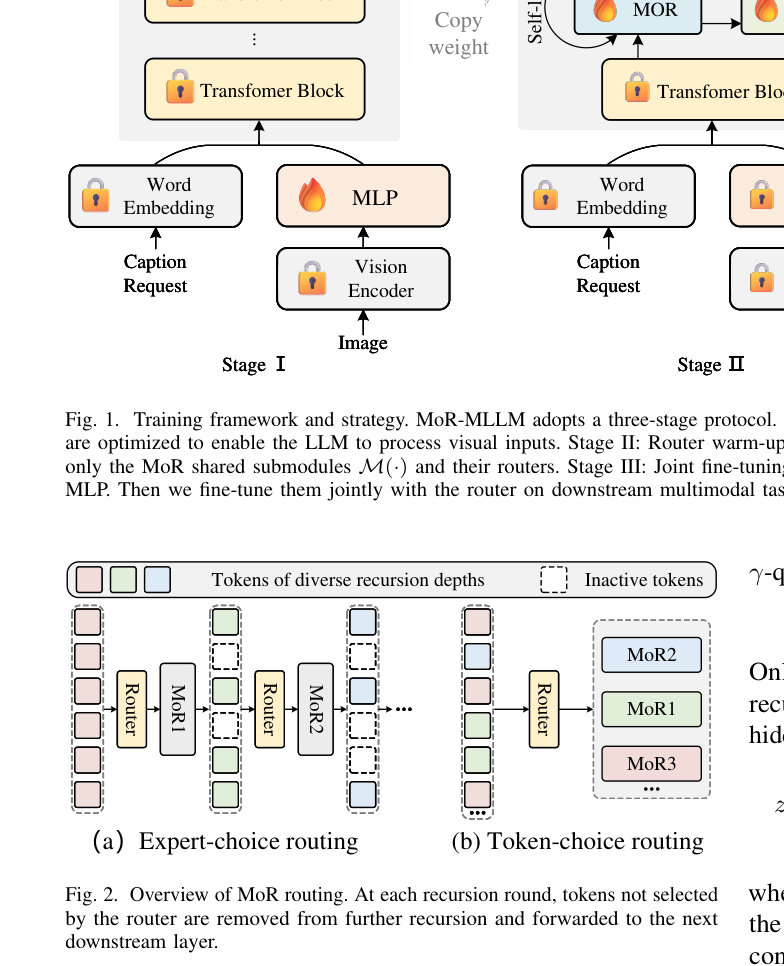
- 前向采用 expert-choice。第 s 步根据当前隐状态打分,超过该步分数的 β 分位数才进入共享 Transformer 做加权残差更新;未选中词元隐状态不变,并被移出后续递归。默认 Pβ=80%、最大深度 S=32。与一开始就定死深度的 token-choice 相比,逐步重估更稳,也避免过早承诺。视觉与文本词元走同一个路由器,不按模态分两套路由函数。
- MoR-Tuning 分三步。Stage I 只训 MLP,用 LLaVA-Pretrain 558K 让语言模型读得懂图像词元。Stage II 用 grouped sharing 把一组预训练层拷进共享模块,只训 M(·) 与路由器,负偏置鼓励早期浅递归;数据为 964K 混合集(SViT 157K、LVIS 220K、LRV 331K、MIMIC-IT 256K)。Stage III 解冻 Transformer、词嵌入与 MLP,加 LoRA,在 LLaVA-Mix665k 上联合微调,并打开熵正则。总损失为任务交叉熵加 λent·Lent,默认 λent=0.10。
- 优化为 AdamW、无权重衰减、余弦学习率。三阶段分别 10K / 20K / 30K 步,学习率 1×10⁻⁴ / 5×10⁻⁵ / 2×10⁻⁵,全局 batch 64 / 64 / 32,Bf16。硬件是八张 RTX 4090;Stage I–II 用 DeepSpeed ZeRO-2,Stage III 开 offload。最大深度 S 是最坏情况预算:路由器仍可让不同输入停在不同深度。
逐图理解论文
递归路由
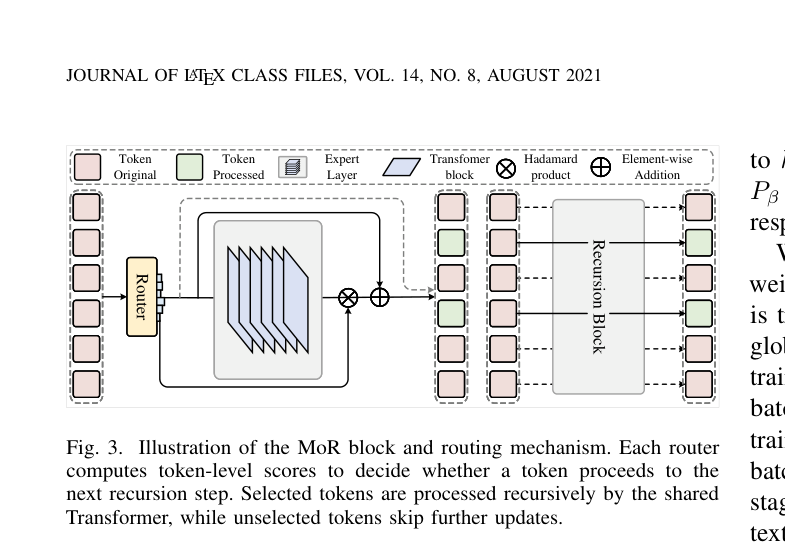
图3画单个 MoR 块。粉色是 Original Token,绿色是 Processed Token。词元先过黄色 Router,再进入共享 Transformer(图例称 Expert Layer),经 Hadamard 乘与残差加法。右侧 Recursion Block 只把被选中的词元变成绿色,其余保持粉色并由虚线跳过。这对应 expert-choice:每一步重新打分,未过 β 分位数的词元不再更新。裁切右缘带进了正文残字,不是结构的一部分。默认 Pβ=80%、S=32 写在正文而非图内。
关键证据
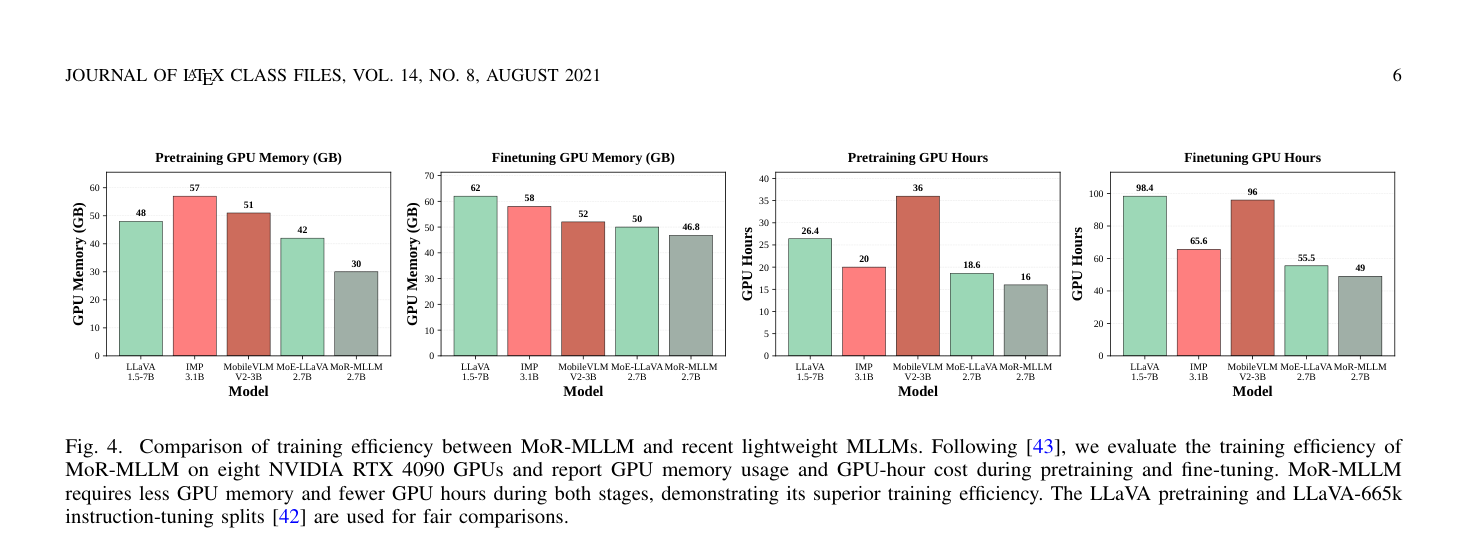
图4四张柱状图比较训练成本,设定为八张 RTX 4090、LLaVA 预训练与 LLaVA-665k。从左到右模型为 LLaVA-1.5-7B、IMP-3.1B、MobileVLM-V2-3B、MoE-LLaVA-2.7B、MoR-MLLM-2.7B。预训练显存约 48 / 57 / 51 / 42 / 30 GB,微调显存约 62 / 58 / 52 / 50 / 46.8 GB,预训练 GPU 小时约 26.4 / 20 / 36 / 18.6 / 16,微调 GPU 小时约 98.4 / 65.6 / 96 / 55.5 / 49。MoR-MLLM 四项都最低,合计 65 GPU 小时。此图不报告准确率;横轴 2.7B 与 Table II 的 3.6B 口径不同。
Fig
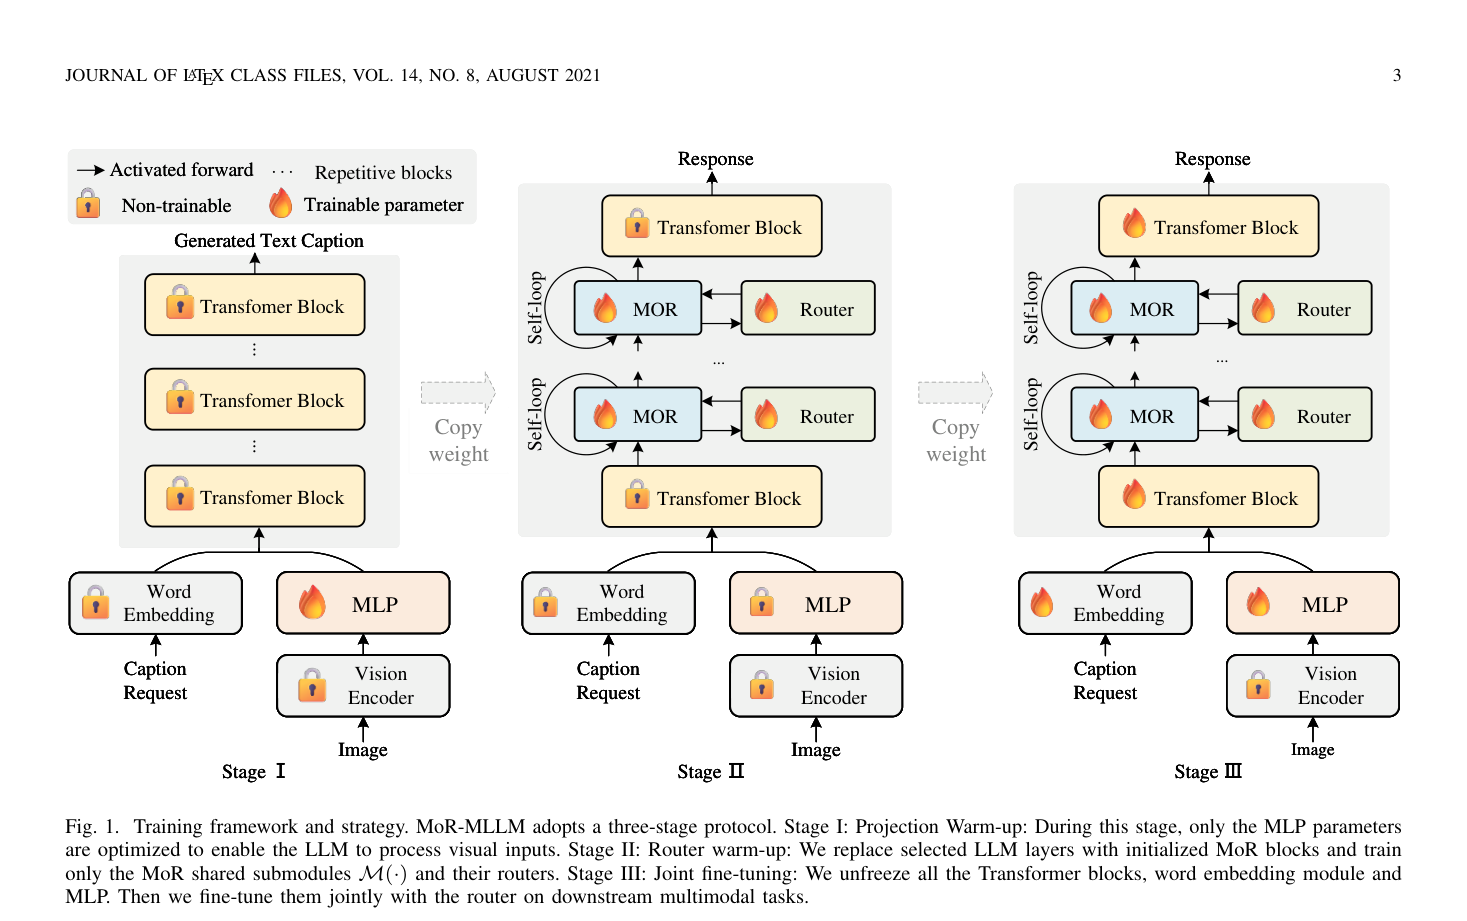
图1是三阶段训练总览,宜作特色图。左列 Stage I:Vision Encoder、Word Embedding 与全部 Transformer 带锁,只有 MLP 带火焰,对应投影预热。中列 Stage II:首尾 Transformer 仍锁定,中间换成带 Self-loop 的 MOR 块与 Router,二者带火焰;MLP 与词嵌入重新上锁,表示这一阶段只训共享模块和路由器。右列 Stage III:Word Embedding、MLP、首尾 Transformer、MOR 与 Router 全部带火焰,Vision Encoder 仍然锁定。灰色 Copy weight 箭头标出权重如何从稠密层拷进递归块。图例用锁表示 Non-trainable、火焰表示 Trainable。页眉是 LaTeX 模板,讲图时可忽略。
实验如何设计?
- 效率比较跟随 FlashSloth:同一软件栈、精度与八张 RTX 4090。训练侧看 LLaVA 预训练与 LLaVA-665k 上的显存和 GPU 小时。推理侧在 MME、MMBench、POPE、GQA、TextVQA 报告视觉词元数、首轮 TFLOPs、显存、首 token 延迟与吞吐。
- 准确率用 lmms-eval,覆盖 POPE、MME、MMB、MM-Vet、SEED、MathVista、GQA、SQA、DocVQA。对照包括 LLaVA-1.5、MobileVLM-V2、MiniCPM-V-2、InternVL2、Qwen2-VL、FlashSloth、MoE-LLaVA 等。Table II 把本文记为 3.6B 参数、2.2M 数据。
- 消融覆盖 λent、组数 m、最大深度 S、Pβ、三阶段相对一阶段 60K 步、mean 对 grouped sharing、expert-choice 对 token-choice,以及 dense / 固定深度递归对照。另把同一套 MoR-Tuning 接到 LLaMA-3.1-8B。
关键结果与论文证据
- Fig. 4 上 MoR-MLLM 预训练显存 30 GB、微调 46.8 GB,GPU 小时 16 + 49 = 65,相对 LLaVA-1.5-7B 约降 48%、相对 IMP 约降 24%。Table I 五任务平均为 576 词元、0.61 TFLOPs、0.05 s、7.2 GB、16.5 samples/s;相对 LLaVA,TFLOPs / 显存 / 延迟降 86.6%、54.1%、54.5%,吞吐升 153.8%。GQA、POPE、MMBench 降幅最大,TextVQA 仍有 79.4%。
- Table II 中 GQA 62.3、SEED 72.7 为表内最佳,DocVQA 89.2 为次优;POPE 87.7、MME 1798、MMB 69.9、MM-Vet 39.9、MathVista 42.7、SQA 70.4。作者认为组合推理任务更吃词元间不等的计算,幻觉、OCR 与数学则更受编码器与分辨率限制。同骨干 Table IX:稠密 Phi-2 为 62.5 / 87.8 / 1804.6 / 70.2 与 2.40 TFLOPs,MoR 为 62.3 / 87.7 / 1798.0 / 69.9 与 0.61 TFLOPs。LLaMA-3.1-8B 上 TFLOPs 从 6.95 降到 1.77,分数几乎持平。
- Pβ=80% 时稀疏度 0.62、四项分数最高;S 从 8 提到 32,VQAv2 / GQA / MMBench 从 75.2 / 59.4 / 63.1 升到 77.5 / 61.4 / 65.6,再加到 48 无增益。完整 MoR-Tuning 加熵正则为 GQA 62.3,一阶段加熵正则只有 61.2。GQA 上视觉词元平均深度 13.3、文本 8.4;低置信度样本平均深度 13.6,高置信度为 10.9。
阅读时需要注意
- 论文没有独立 Limitations 节。作者自己写明:幻觉检测、视觉文本识别与数学知识主要受视觉编码器、输入分辨率与任务监督限制,MoR 改的是计算分配,不直接改这些瓶颈。
- Fig. 8 是挑选的定性例子,延迟 0.05 s 不能代替 Table I 的平均口径,也不能外推为全面超过 Qwen2-VL 或 InternVL2。Table II 的 3.6B 与 Fig. 4 横轴 2.7B 口径不一致,阅读时应以 Phi-2-2.7B 骨干加视觉侧来理解。
- 最大深度只约束最坏情况,实际时延仍随任务变化。预印本未同行评审。
关联工作
- Universal Transformer 与 Looped Transformers 用共享层做迭代计算,但深度固定。Fixed Relaxed Recursive Transformers 用 LoRA 放松 KV 约束,深度仍静态。Bae 等人的 MoR 才把轻量路由和按词元递归深度放到一起。
- MLLM 主线是 LLaVA 视觉指令微调,以及 Qwen-VL、InternVL、DeepSeek-VL 的缩放。效率侧除了稠密小模型,就是 MoE-LLaVA 的专家稀疏。RecursiveVLM 把递归接到多模态,但不做词元自适应路由。FlashSloth 提供了本文效率表的评测口径。