快速导读:用每个目标占用的视觉词元数 S 与一次调用必须覆盖的内容量 L,解释视觉语言模型为何漏掉大图中的小目标,并给出可证明安全的分解规则。
在施工图、平面图或检测图里找出每一个小符号,是视觉语言模型经常失败的任务。补救办法很多:任意分辨率编码器、切块、厂商高分辨率模式、裁剪放大、边推理边调用 zoom 工具。它们各自对着自己的基准说话。Why VLMs Miss Small Objects(arXiv:2610.09313,UC Berkeley 与 Quotr AI)把每次调用写成两个接口量:S 是目标一边跨越的视觉词元数,L 是这次调用必须看完并枚举的内容。材料与代码在 https://github.com/shijunzhe/vlm-small-objects 。
接口本身已经定下单次调用的分辨率上界:预算加倍,整图能达到的最大 S 只升约 41%;要把图看到目标所需的 S,代价至少按 S² 增长。作者再加两条可测的单调性——更多词元、更少内容平均不伤害检测——证明只要没有相对整图缩小的视野,且按一个目标重叠,分解的期望召回不低于整图。约 177,000 次请求、797 张图上,受控实验的 40 组预测排序全部成立;安全规则相对整图召回最高提升 +0.28。预印本尚未同行评审。
英文题目:Why VLMs Miss Small Objects, and When Zooming In Is Safe
论文出处:arXiv 每日论文精选 · arXiv:2610.09313
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有 VLM 都把图像缩到预算、切成固定大小的视觉词元、再用文本作答。图 1 那张 11236×7698 的施工图若整图只给 2,500 token,一个符号只占 S=0.40;高分辨率模式把预算加到 10,000,S 也只到 0.80,而且还要在同一次调用里列出全部 23 个目标。切块同时提高 S、降低 L;高分辨率只加 S、不减 L;zoom 工具让模型自己选两样;纯推理两样都不改。
三个问题因此还开着。限制到底来自接口还是模型?下一代模型能去掉其中哪些?经典的局部分解还有没有前途?作者的回答是:接口先限制能看到的分辨率和必须付的覆盖代价;模型能改变的是识别所需的 S 和一次调用装得下多少内容;只要一次调用付不起覆盖代价又装不下内容,图像就必须被切开,区别只在于谁来切。
核心创新
- 用接口量 S 与内容量 L 统一整图、高分辨率、切块与 zoom Agent,并给出覆盖代价的 S² 下界。
- 在可检验的单调性假设下证明何时分解安全,并给出接近下界的切块规则。
- 用约十七万七千次注册实验把识别阈值、单次容量与坐标接口测成模型参数。
方法概览
理论分两层。第一层只由文档化接口推出,对所有模型成立:单次调用的 S 上界、在给定 S 覆盖整图的词元下界,以及叠字、插值不能增加 Shannon 信息。第二层只假设平均而言更多词元(R)、更少内容(M)、更多信息(I)不降低检测。在此单调性下证明:只要没有相对整图缩小的视野,且视野按一个目标重叠,分解的期望召回不低于整图(Theorem 1);该条件不能放松(Theorem 2、Proposition 4);Corollary 1 给出接近代价下界的切块规则。Theorem 5 把内容写成每找到一个目标所需的比特。实验约 177,000 次请求、797 张图、约 28,600 个标注实例。主基准 REDP-X40 为 40 张施工图、1,028 个实例,6 张调参、34 张测试(14 张整页 + 20 个局部,660 个实例)。另有 REDP-10、FloorPlanCAD 拼成的 FPC-300 与 FPC-sheets、FSC-147,以及 156 张合成图与 12 张假设检验图。任务是根据图例找出全部实例中心。对照含整图、厂商高分辨率、44 px 切块、Corollary 1 规则、propose-and-verify、以及带 zoom 工具的 Agent。主假设均在调用前注册。
- S = ms/t,其中 m 是目标尺度、s 是有效缩放、t 是词元边长。分辨率缩放接口(GPT、Claude、Qwen)超预算会再缩图;固定网格接口(Gemini、Gemma)把边长垫到 g 个词元。L 是该次调用显示的区域及其内部全部目标、干扰与线条。叠字、网格、插值放大不增加关于目标的 Shannon 信息;从原图裁出再以更大尺度发送,才可能带上整图缩放丢掉的细节。
- 单调性写成三条:(R) 同一区域给更多词元不降低平均检测;(M) 同等尺度下裁掉外围内容不降低;(I) 信息更多的来源不更差。Theorem 1:若所有视野都是整图的裁剪或加细、S 不低于整图,且核心按一个目标重叠,则分解对整图内部目标的期望检出不少于整图。Proposition 4 说明不缩小与重叠都不能省。Corollary 1 按目标 S* 切尽量大的重叠视野、且不再被厂商二次缩放,代价随图纸变大趋近下界 Cmin。
- Theorem 5 把内容写成比特:均匀独立目标下,期望召回乘上每目标约 log2(面积/容差圆) 的比特,不能超过答案携带的互信息。Agent 并不逃出分解,只是自己选视野;在识别阈值假设下,任何近乎正确的搜索仍要付覆盖代价。更符合现状的是渐变识别曲线给出的召回–代价前沿。
- 评测任务统一为:给出图例,找出全部实例中心,容差 τ=m/2。主基准 REDP-X40 含 40 张去标识施工图、1,028 个实例,6 张调参、34 张测试。合成图用来一次只改 S、目标数或面积。FPC-sheets 把同一块 FloorPlanCAD 嵌进越来越大的拼图,从而分开面积与内容。主假设在调用前写入六份计划。
逐图理解论文
两个量纲
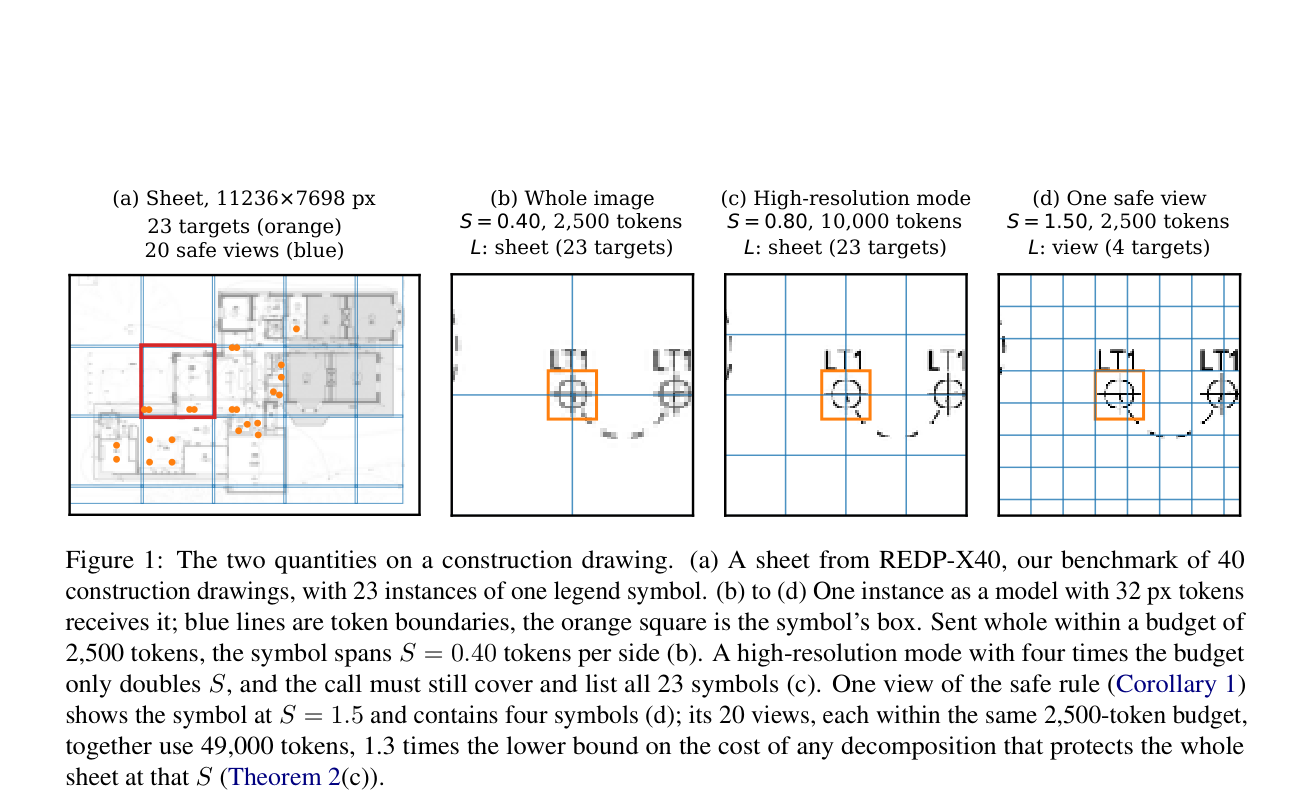
图1是接口直觉图,宜作特色图。(a) REDP-X40 中一张 11236×7698 施工图,23 个橙色目标,20 个蓝色安全视野,红框标出后面三列放大的位置。(b) 整图 2,500 token、32 px 词元网格,橙色框中的 LT1 只跨 S=0.40,L 仍是整页 23 个目标。(c) 高分辨率 10,000 token,S=0.80,L 不变,说明预算加倍只把最大 S 提高约 41% 量级。(d) Corollary 1 的一个视野仍用 2,500 token,S=1.50,框内约 4 个目标。20 个视野合计 49,000 token,约为 Theorem 2(c) 下界的 1.3 倍。蓝线是词元边界,不是检测框。
识别与容量
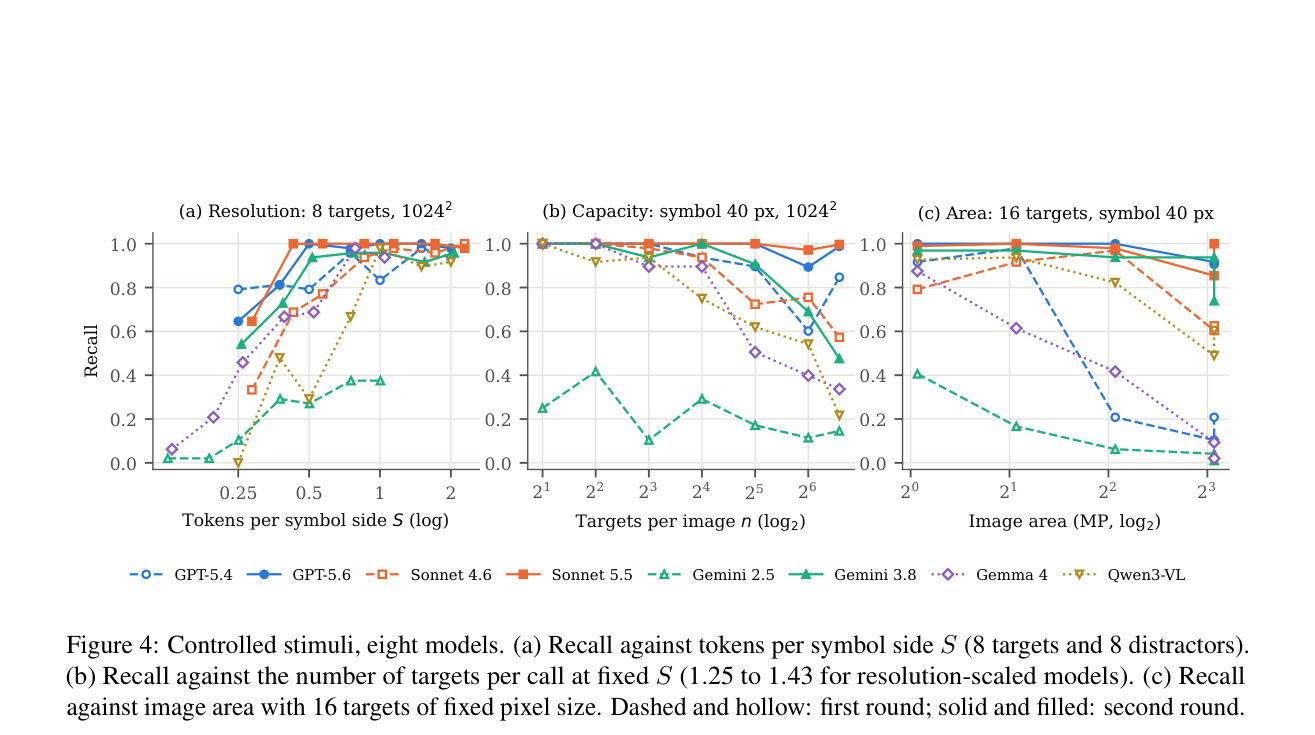
图4用合成刺激拆开两个量。虚线空心为第一轮模型,实线实心为第二轮。(a) 8 个目标加 8 个干扰,召回随 log S 上升,Gemini 2.5 明显更低,说明识别曲线是模型参数。(b) 符号 40 px、画布 1024²,固定 S 约 1.25–1.43,召回随目标数下降;96 个目标时正文给出 Qwen3-VL 0.22、Sonnet 4.6 0.57,而 Sonnet 5.5 与 GPT-5.6 接近 1.00。(c) 16 个 40 px 目标,面积增大时部分模型下降,GPT-5.6 从 1.00 降到 0.91。不要从图上未标出的中间点读成精确表值。
关键证据
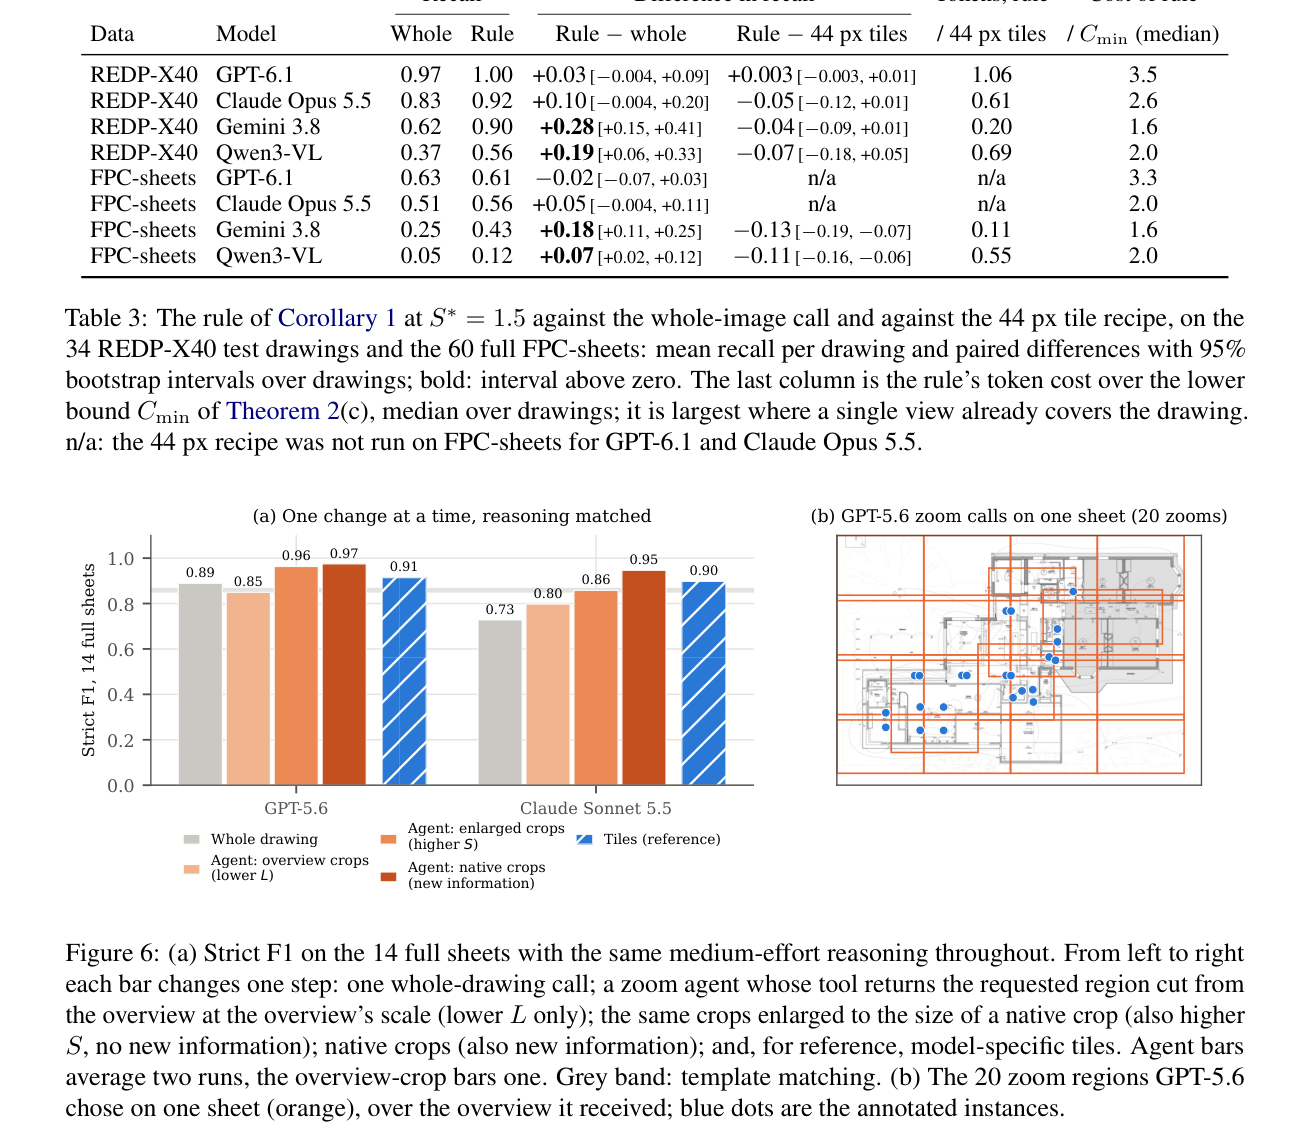
该资产把 Table 3 与 Figure 6 裁在同一张图。上表是 Corollary 1 在 S*=1.5 时相对整图与 44 px 切块的召回:REDP-X40 上 Gemini 3.8 从 0.62 升到 0.90(+0.28),GPT-6.1 整图已是 0.97;规则从未显著低于整图。下图 (a) 在 14 张整页上逐步改 zoom 工具,reasoning 对齐:GPT-5.6 为整图 0.89、概览裁 0.85、放大裁 0.96、原生素材 0.97、切块 0.91;Claude Sonnet 5.5 为 0.73 / 0.80 / 0.86 / 0.95 / 0.90。GPT-5.6 主要吃 S,Claude 要靠原生像素。(b) 展示 GPT-5.6 在一页上选的 20 个橙色 zoom 框与蓝色真值点,说明 Agent 自己在做分解。
实验如何设计?
- 第一轮模型为 GPT-5.4、Claude Sonnet 4.6、Gemini 2.5 Flash、Gemma 4 31B、Qwen3-VL;第二轮为 GPT-5.5 / 5.6、Claude Sonnet 5.5、Claude Opus 5.5、Gemini 3.8,随后补 GPT-6.1。除标明外关闭或压到最低 reasoning。配置包括整图(长边最多 1,600 px)、厂商高分辨率、44 px 切块、按 Proposition 2 选视野的模型特定切块、Corollary 1(S*=1.5)、模板匹配提案验证,以及最多 20 次原生裁剪的 zoom Agent。
- 理论检验用 hit recall;配置比较用 strict F1。差值是按图纸的配对 bootstrap,95% 区间不含零称为显著。受控电池有 12 张 2048² 图,各 48 个目标与 48 个干扰。Agent 消融在同一中等 reasoning 下逐步改工具:只降 L 的概览裁、提高 S 但不加新像素的放大裁、以及原生素材。
- 规模约 177,000 次请求、2.77 亿输入 token、797 张图、约 28,600 个标注实例。REDP-10 的参照来自符号库而非每页图例,且不公开。FSC-147 用来检查自然图上“目标已经够大时放大不应再帮”的负向预测。
关键结果与论文证据
- 受控图上 40 组排序无一违反,24 组显著。其他实验事后找到的 89 组中,61 组显著符合,4 组失败,全部是 OpenAI 模型获得超过默认路径的像素:GPT-5.4 在被厂商再次缩放的放大合成图上召回 −0.60;GPT-5.6 高分辨率加推理在整页上 F1 从 0.89 掉到 0.33。44 px 配方若在大符号上降低 S,21 格里有 19 格点估计为负。
- 识别随 S 上升。REDP-X40 上整图 F1 与事先由几何算出的天花板相关;像素固定、只加 Gemini 3.8 的词元预算时,8 px 符号召回从 0.44 升到 0.71,作用通过 S。同网格上 Gemini 3.8 比 Gemini 2.5 高 +0.55。容量方面,96 个孤立符号时 Sonnet 4.6 召回 0.57、Sonnet 5.5 为 1.00;FPC-sheets 上 GPT-5.6 第一块 F1 在周围加八块后降 −0.22,S≥1 的子集仍降 −0.23。
- Fig. 5 上 Sonnet 5.5 与 Gemini 3.8 的切块 F1 为 0.92 与 0.94,超过约 0.87 的模板匹配。Table 3:Corollary 1 从未显著低于整图,Gemini 3.8 在 REDP-X40 上 +0.28(0.62→0.90);GPT-6.1 整图已达 0.97。Fig. 6 中 GPT-5.6 的全页 Agent 为 0.97,有效成分是提高 S;Claude Sonnet 5.5 为 0.95,要靠原生像素。Gemini 3.8 与 Qwen3-VL 的 Agent 计数尚可,但作物到概览的坐标失败,F1 比自家切块低 0.30 与 0.41。
阅读时需要注意
- 接口界与信息论结果对所有这类模型成立;安全定理依赖单调性,且是对图像分布的平均,换域必须重测。四个违反都在 OpenAI 非默认像素路径上,保证只覆盖其默认路径。
- 定理管召回。F1 只给出假点的精确代价,因为假点在切块下不单调。容量测量针对预算缩放、全局注意力、文本作答;局部注意力或稠密输出头可能不同。识别阈值假设已被渐变曲线削弱,覆盖代价的硬阈值形式对当前模型偏弱。
- REDP-10 不发布。商业模型版本为 2026 年 9–10 月。伦理声明指出,无审核地用计数做造价会导致财务错误,应保留逐项位置。预印本未同行评审。
关联工作
- 小目标文献已表明准确率随尺寸和干扰下降,架构侧用动态切块或任意分辨率喂更多像素,推理侧用切块重组、注意力引导裁剪或可学习 zoom 策略。Liu 等人认为放大主要靠去掉背景。本文把这些配置都写成调用前就能算的 S 与 L,并在实验里把两者拆开。
- 计数基准 FSC-147、CountBench、PixMo-Count、CountQA 显示数量上升时准确率下降。图纸符号点选则有 FloorPlanCAD 与一批蓝图基准。模板匹配在图例干净时很强,参照换成符号库后会垮到 0.38,而 VLM 配置仍高出至少 0.30。训练好的类无关计数器在自然图上 F1 约 0.90,迁到图纸最多 0.25。