快速导读:TileSkipper 在冻结三维高斯检查点上编译静态的每高斯瓦片截断策略,按区域分配误差预算,减少配对枚举而不更新参数、也不做逐帧推理。
瓦片化三维高斯溅射已经很快,但每帧仍要为每个(高斯,瓦片)配对做复制、排序与混合。足迹一大,远处背景和窗框高光却被同一个贡献阈值对待。TileSkipper(arXiv:2610.09343,Arizona State University 与 Johns Hopkins University)把这个问题写成部署侧适配:冻结检查点、不改高斯参数,只编译一套静态的每高斯截断,让容易跳过的尾巴少占瓦片,敏感区域继续保守。
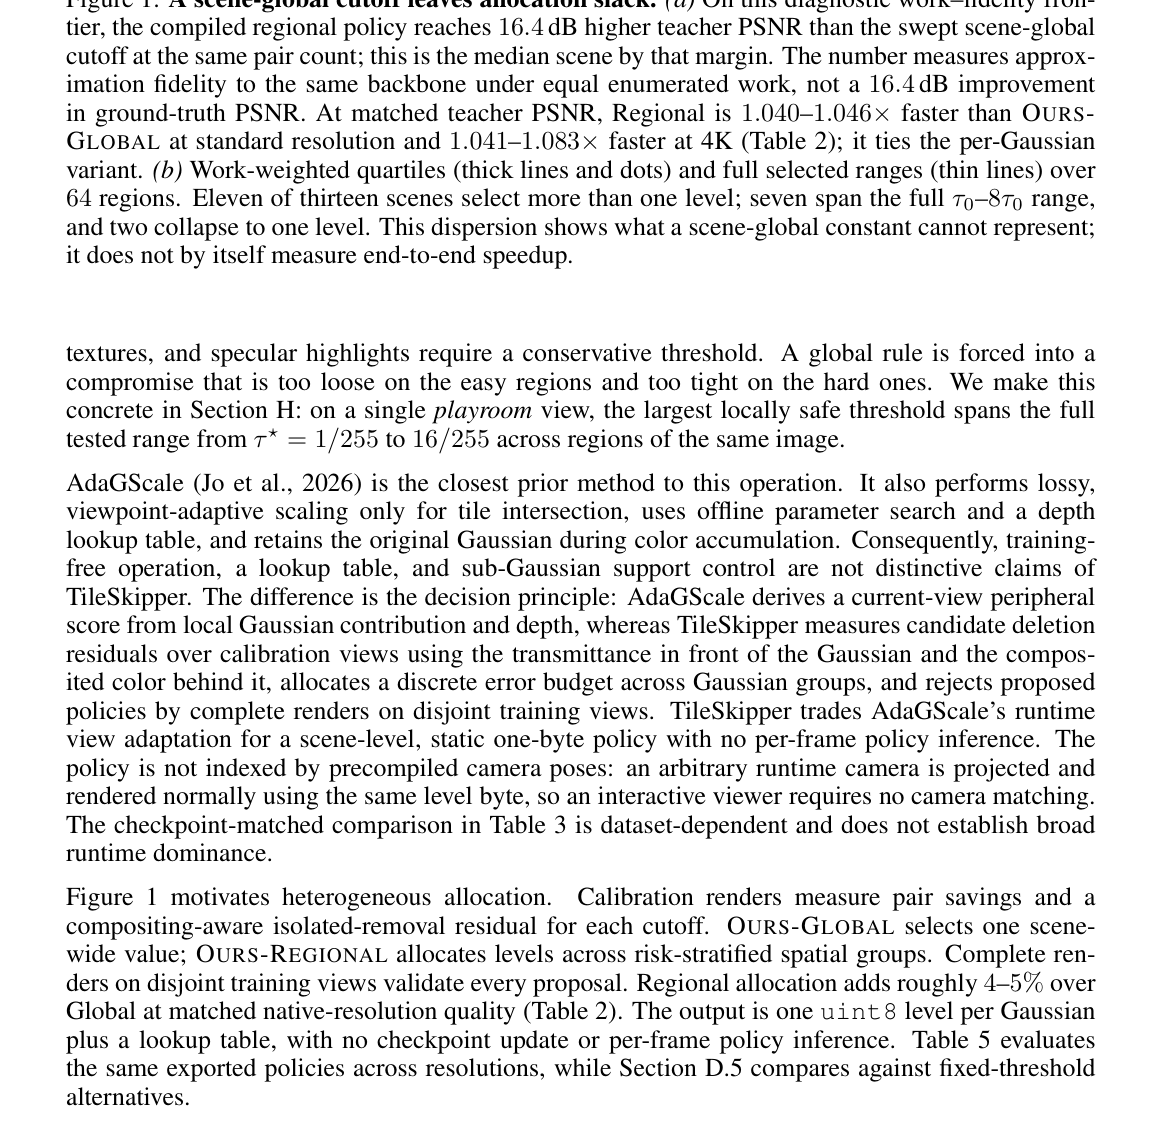
编译器在校准视角上测量配对节省和合成感知的孤立删除残差,按风险分层与工作量均衡把高斯分成 64 组,再用不相交训练视角的完整渲染做门控。导出物是每高斯一字节加查找表,没有逐帧策略推理。13 个场景的 AccuTile 扫描给出标准分辨率约 1.088×、宽 3840 约 1.238× 的数据集宏加速,平均 PSNR 变化约 −0.007 / −0.023 dB。预印本尚未同行评审。
英文题目:TileSkipper: Region-Adaptive Tile Pruning for 3D Gaussian Splatting
论文出处:arXiv 每日论文精选 · arXiv:2610.09343
原始论文:PDF / 论文页面
这篇论文解决什么问题?
3DGS 的屏幕足迹按高斯投影复制到许多瓦片上。自然的加速是用比混合更紧的支撑去做相交测试。AdR-Gaussian、Speedy-Splat、FastGS 已经用透明度水平集替换保守 3σ 盒,但 τ 仍是场景或实现级的单一常数。平坦墙面、远景、近乎不透明的材质块耐得住狠跳;锐边、细纹理和镜面高光不行。全局规则只能迁就最敏感的那一块。
AdaGScale 是最近的同类操作:离线搜表、只改相交用的尺度、混合仍用原高斯,并按当前视角打分。TileSkipper 不把训练免费、查找表或亚高斯支撑当成自己的新颖点。差别在决策:它在校准视角上直接测删除残差(含前向透过率与后方合成色),把离散误差预算分给高斯组,并用完整图像拒绝代理失效;换来的是场景级静态策略,任意运行时相机只需投影,不必匹配预编译位姿。
核心创新
- 对冻结检查点做合成感知的支撑分配:测量配对节省与孤立删除残差,按风险分层与工作量均衡在区域间分配误差,并用完整渲染拒绝代理失效。
- 在六条已有透明度感知边界的路径上隔离编译器,并在四条从 3σ 光栅器移植的路径上分开报告先验精确边界与增量收益。
- 用实测成本模型给出配对相关工作的上限,以及几何预剔除何时划算;预剔除在 52 次测量中图像比特精确。
方法概览
TileSkipper 把场景常数 τ0 换成静态每高斯阈值 τg=mgτ0。离线五步:在校准视角对离散梯子测量精确配对节省 s 与计及前向透过率和后方合成色的孤立删除残差代理 ρ;按效率分八个分位层;层内 Morton 排序并按瓦片工作量切成共 Kreg=64 个区域;对 48 个惩罚 λ 取区域最优,并纳入均匀水平候选;在不相交训练视角上做完整渲染,要求最低 teacher PSNR 与最差视角 p99 残差过关后取节省最大者。导出每高斯一字节加查找表。运行时只改第二阶段瓦片枚举,投影、排序与混合不变。OURS-GLOBAL 为 Kreg=1 的场景校准,OURS-REGIONAL 为 64 组分配。
- 光栅化仍是投影、瓦片配对、排序、混合四步。TileSkipper 只改第二步:支撑由 {x: ag(x)≥τ} 定义,基线用 τ0,编译后用 τg=mgτ0。水平集半径公式属于 AdR-Gaussian,不是本文贡献。经验上帧时延可写成 T≈F+βP,所以减配对不必等比例变快。
- 乘数 mg 取自梯子 {1, 1.05, 1.1, 1.15, 1.25, 1.5, 2, 3, 4, 6, 8}。独立给数百万高斯做决定会过碎,默认收成 Kreg=64 个搜索决策。五步编译:① 对每个梯子档位在校准视角上记精确配对变化 s,并用自定义反向传播累加孤立删除的 RGB 能量代理 ρ,反向过程不更新任何参数;② 在最狠档位按 log((s+ε)/(ρ+ε)) 分成八个分位层;③ 层内 Morton 排序,按测得的瓦片工作量切成近似等负载的连续块,避免均匀网格那种 3.1–4.8 的工作量变异系数;④ 对 48 个几何间隔的惩罚 λ 取 ℓc⋆=arg max(Sc,ℓ−λRc,ℓ),并纳入均匀水平策略,以便异构无益时退回场景级;⑤ 每个候选在不相交训练视角上完整渲染,最低 teacher PSNR 须过地板、最差视角 p99 残差不过帽,通过者里留配对节省最大的。测试视角从不参与选择。
- 导出是每高斯一个 uint8 加至多 256 档查找表。运行时在枚举循环里读字节查表,无额外核、无逐帧推理。默认 Kreg=64 时编译平均 9.0 秒、最长 14.0 秒。OURS-GLOBAL 是同一编译器的 Kreg=1;OURS-REGIONAL 才是 64 组分配。可选的区域预剔除在 52 次测量中图像比特精确,但调度规则若发现规划开销大于预计节省就会关掉它。
逐图理解论文
离线编译
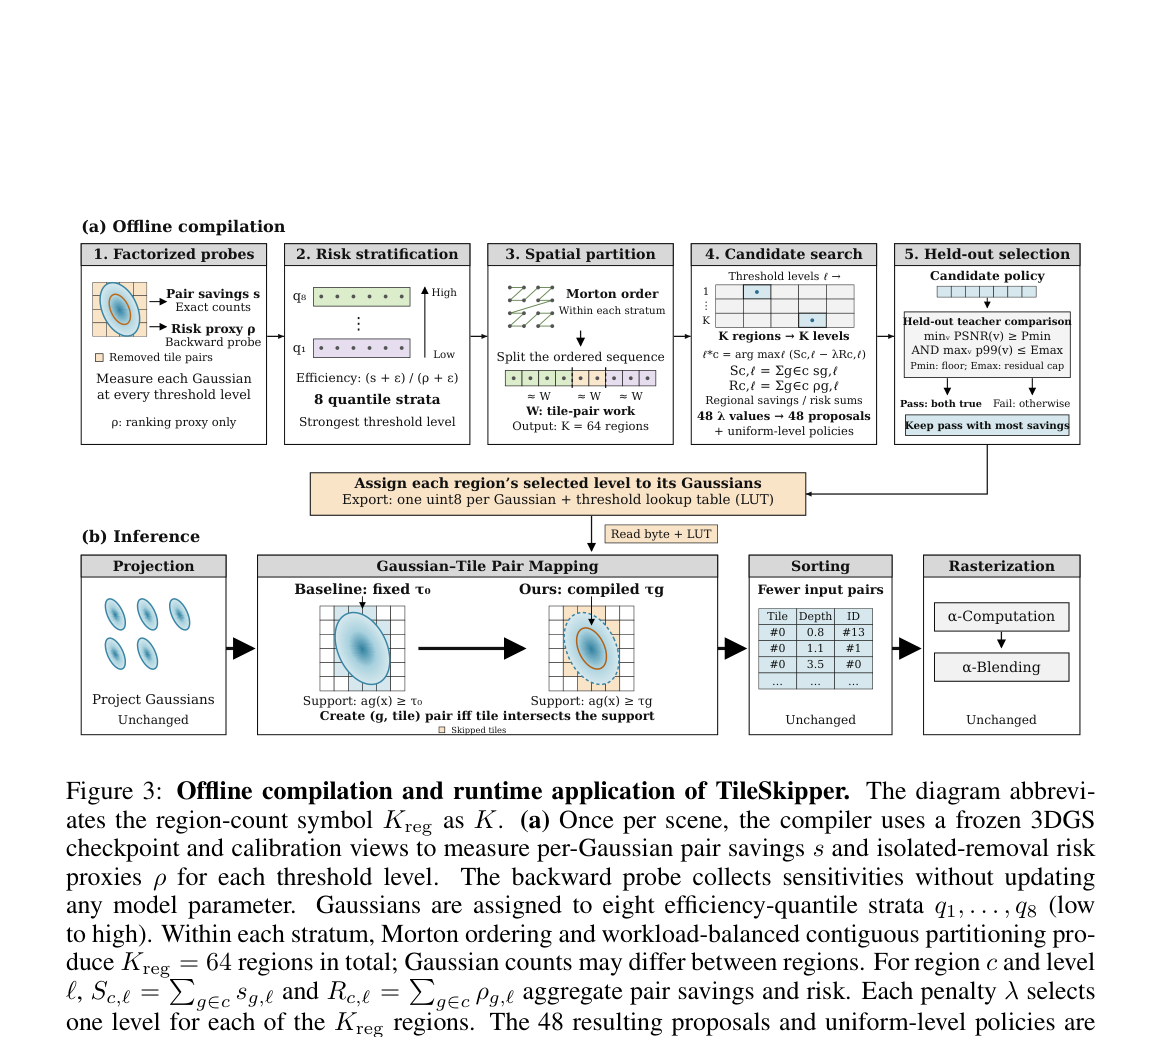
图3是离线编译与运行时。(a) 五步:因子化探针测 s 与 ρ;按效率分成 q8…q1 八层;层内 Morton 排序并按工作量切成 K=64 区域;48 个 λ 加均匀策略做候选;held-out 要求 min PSNR≥Pmin 且 max p99≤Emax,通过者留节省最大。反向探针不更新参数。中间导出每高斯 uint8 加 LUT。(b) 推理时投影、排序、α 混合不变,只把相交从 τ0 换成 τg;虚线蓝为原支撑,橙为新支撑,阴影瓦片被跳过。测试视角不参与选择。
运行时改动
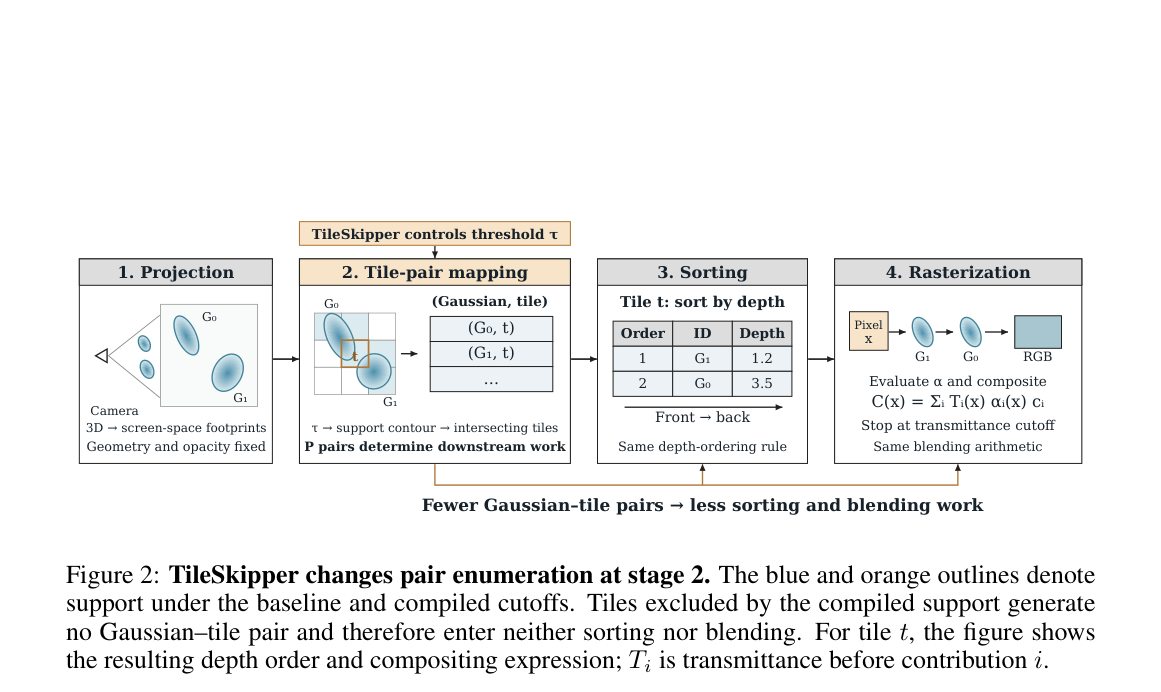
图2标出 TileSkipper 只改光栅化第二步。1 Projection 把 G0、G1 投成屏幕足迹,几何与透明度固定。2 Tile-pair mapping 用 τ 得到支撑轮廓与相交瓦片,蓝轮廓是基线、橙轮廓是编译后更紧的支撑,输出 (G0,t)、(G1,t)。被橙支撑排除的瓦片不再生成配对,因此不进排序也不进混合。3 Sorting 对瓦片 t 按深度前到后,示例 G1 深度 1.2、G0 深度 3.5。4 Rasterization 仍按 C(x)=Σi Ti(x) αi(x) ci 混合,到透过率截止停下。底部结论是配对变少,后续工作变少。
关键证据
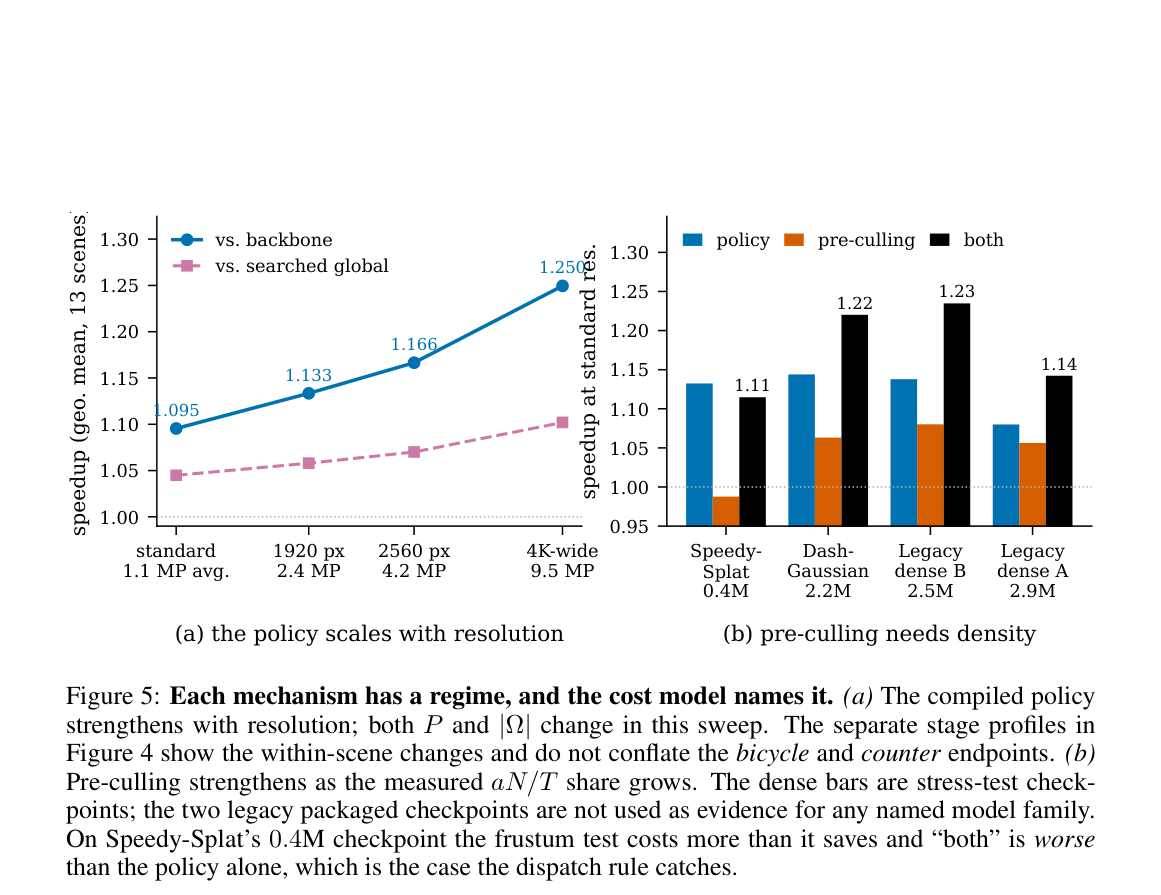
图5把成本模型说成换挡。(a) 13 场景几何平均加速随分辨率上升:相对骨干 1.095、1.133、1.166、1.250;相对已搜索全局阈值的粉线更平。该扫描同时改变配对数与像素数,场景内变化以图4为准。(b) Speedy-Splat 0.4M 上预剔除低于 1,both=1.11 差于策略单独,调度应关掉视锥测试。更密的压力检查点上 both 到 1.22–1.23。Legacy dense A/B 只作密度压力测试,不代表具名模型家族。
实验如何设计?
- 数据是标准 13 场景:Mip-NeRF 360 九个、Tanks & Temples 的 train/truck、Deep Blending 的 drjohnson/playroom。标准测试图 979×545 到 1559×1039;4K 把同一视角拉到宽 3840。计时在一块 RTX 5000 Ada 上,十二轮同进程轮转、同步缓存,禁止写图。报告 PSNR、SSIM、LPIPS、配对比 R 与几何平均加速。teacher PSNR 相对未修改骨干,60/55/50 dB 对应 teacher MSE 10−6 / 10−5.5 / 10−5,不是数据集真值。
- 六条路径已经暴露透明度感知瓦片边界,收益记为编译器单独贡献。vanilla 3DGS、Mini-Splatting、2DGS、Scaffold-GS 先把发布的 3σ 盒换成精确 1/255,再叠加策略,部署总计与增量在 Table 14/15 分开。SeeLe 与 FlashGS 是把 Speedy-Splat 策略原样迁入原生光栅器。门控默认最低视角 teacher PSNR 48 dB、p99≤0.012,16 个校准视角加 32 个选择视角。
- 粒度消融把 Global、Regional 与逐高斯控制的 Pareto 包络插值到同一 teacher PSNR。AdaGScale 对照固定检查点、渲染器、选择与测试视角以及计时协议。附录还扫 Kreg、区域构造、校准敏感性、光流对齐轨迹与分辨率。
关键结果与论文证据
- Table 1 上,Speedy-Splat 1.096×、FlashGS 1.121×、SeeLe 1.091×、LightGaussian 1.095×、Taming-3DGS 1.051×、FastGS 仅 1.009×。2DGS 与 Scaffold-GS 的部署总计 1.474× / 1.320×,但含昂贵的射线-面元或每帧 MLP,且先计入精确边界。vanilla 3DGS 的 1.493× 里 1.454× 来自 3σ→1/255,编译器只再加 1.027×。质量上平均 SSIM 变化在 −3.8×10⁻⁵ 到 −2.5×10⁻⁴,LPIPS 略降。
- Table 2 显示异构分配相对场景校准有用:标准分辨率 Regional 快 4.0–4.6%,4K 最高 8.3%,但与逐高斯控制 0.986–1.007× 持平。因此 Kreg 是搜索正则,不是已证实的速度或存储来源。对 AdaGScale,原生 1.010× 的区间含 1,不能说全面更快;4K 1.076×、12/13 场景领先。Figure 5 上策略随分辨率从约 1.095× 升到 1.250×;0.4M 的 Speedy-Splat 上视锥测试得不偿失,both 差于策略单独,正好被调度规则抓住。
- Figure 4 解释换挡:bicycle 的 duplicate+sort 从 21.4% 升到 34.2%,counter 从 31.6% 到 41.6%,而测试过的完美免费可见性剔除天花板从 22.6% 降到 7.6%、9.3% 降到 2.2%。阈值吃的是配对相关工作,预剔除吃的是整块高斯,二者不可当加性。
阅读时需要注意
- 附录 D.10 写明:编译必须能渲染训练视角,不是对任意发布 PLY 的无数据变换。方法假定足迹由贡献阈值决定;方向盒、凸包与非瓦片光栅器不在范围。区域共享在速度上打不平逐高斯,两种导出都是每高斯一字节。
- 静态策略在三条场景、359 帧的光流对齐测试上总体无回归,但 counter 归一化后回退 5.0%,不足以宣称永不爆闪。held-out 门控不能保证测试视角:39 次拆分-场景里 18 次超过 p99=0.012,最大 0.032。残差在真实 16 像素瓦片相位上最强,边界/非边界比约 6×,振幅只有 0.19–0.31 个 8-bit 码值,没有用户研究。全部计时来自同一型号 RTX 5000 Ada。
关联工作
- 片段级路径如 Fragment Pruning 学习每高斯截断并作用在排序之后;TileSkipper 在排序前删配对,且不更新检查点。作者只在其检查点家族上测兼容,硬件与渲染器不同,不能排名。
- SeeLe 的相交仍用编译期固定 τ=1/255,本文改的是这条阈值策略,迁移实验保留其聚类等组件,不复现完整移动端流水线。FlashGS、QuadBox 继续收紧几何枚举,与有损异构截断互补。
- AdaGScale 提供运行时视角自适应;TileSkipper 用完整渲染误差换掉逐帧推理。Table 3 的对照是数据集相关的,作者自己写明不确立广泛主导。