快速导读:SheafPrune 用跨模态层丛式比较、支撑约束图传播和度数校正,在固定预算下一次性选出视觉 token。
多模态大模型把整段视觉 token 送进语言模型,即使很多区域与当前问题无关,预填充成本仍按完整序列计算。单点显著性抓不住 token 之间的依赖;图方法则取决于关系如何把初始重要性变成最终排名。SheafPrune(arXiv:2610.13263;中国农业大学、杭州电子科技大学)从层丛几何借来异质比较和关系约束传递:模态专用映射加稀疏文本–视觉图产生相关性,再在另一张阈值视觉图上做支撑约束传播,并用度数校正避免“邻居多就排得高”。选择器约 450 万参数,在冻结的 LLaVA-NeXT-8B 上只靠语言建模损失端到端训练;显式保留比例条件使一个检查点服务全部预算。页眉写 Published as a conference paper at ICLR 2027,本文按预印本解读,不作已接收结论。
在四种骨干、十个基准、七档剪枝率、全部基线按同一协议重实现的设定下,按逐点最优度数指数(best-δ)协议,SheafPrune 在 28 个骨干–预算组合里有 22 个取得最高平均保留率,中等到激进剪枝时优势单调变大。在 LLaVA-NeXT 上保留 10% 视觉 token 时,净预填充加速 5.15 倍,端到端 FLOPs 降 84.0%。作者同时强调:这是性能包络而非固定超参部署曲线;打分选择也不保证空间覆盖。
英文题目:SheafPrune: Sheaf-Guided Graph Propagation for Visual Token Pruning
论文出处:arXiv 每日论文精选 · arXiv:2610.13263
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视觉编码通常不看当前指令,冗余 token 会与关键证据一起穿过每一层解码器。哪些区域可丢,取决于关系和问题:整体识别用得上的区域,对属性、空间、计数或文字题可能恰好关键。选择器必须在有限保留预算下联合权衡,而不是只留最大的单点分数。
现有方法分别吃视觉冗余、语言模型注意力或任务条件相关性。G-Prune 等图方法在相似度图上传播重要性,使最终排名不只由初始分数决定:图规定谁能交换分数,连通性又影响各点收到多少。这引出两个设计问题。第一,文本与视觉来自不同模态,比较前必须对齐。第二,传播必须限制在指定关系上,并校正邻域大小,否则密连接点会仅凭连通性获得更高排名。层丛几何用限制映射在共享边空间比较局部状态,并用指定关联约束交互,为这两步提供设计理由。
核心创新
- 层丛启发的选择器:模态专用比较、稀疏跨模态相关、支撑约束视觉传播与度数校正。
- 把源点行归一化与目的点度数校正分开,并用固定配置消融验证组合排名算子。
- 显式保留比例条件使一个训练检查点服务多档视觉预算。
方法概览
冻结编码器给出文本与视觉表示。预算条件双向文本编码器读入问题和保留比例。模态专用映射在比较空间算跨模态边能量,稀疏取邻居后得到相关性,并与视觉范数先验融合成初始分数。视觉图用样本分位数阈值形成对称支撑,分数做有限步转移后再除以邻域计数的 δ 次方。straight-through Top-k 在训练时门控注意力;推理时物理删除未选 token。约 450 万参数在冻结 LLaVA-NeXT-8B 上用语言建模损失训练,一个检查点覆盖全部评测预算。
- 接口上,XT、XV 是选择器处的文本与视觉表示。掩码区分有效文本、有效视觉和可剪候选;图像换行一类结构位置强制保留,不占候选预算。保留比例 ρ 时,选择器在候选集 C 上保留 k=min{|C|, max(1, ⌈ρ|C|⌉)} 个,再加上强制结构位置。记号 d 是选择器输入宽度,不是断言每条骨干原生隐藏维相同。
- 预算条件化的双向文本编码器在冻结语言模型之外编码系统提示、已完成对话和当前问题,并读入 g(ρ);目标答案位置、未来轮次、图像占位、填充和控制符一律排除,使训练与推理的信息边界一致。模态专用 LayerNorm 与线性映射把文本、视觉投到比较空间,用稳定单位归一化后的平方分歧定义边能量,再经温度得到跨模态亲和。掩码 softmax 给出文本重要性;每条有效文本行只留 K 个最强视觉邻居,度归一化后得到相关性。初始分数把相关性与归一化视觉特征范数融合:先验给视觉侧信号,中心化相关性相对它提升或压低候选。
- 视觉图由有效视觉特征的余弦相似度构成。样本内分位数阈值 ξqv 决定支撑:自环保留,非边转移权重精确为零,负相似度的保留边仍然有效。分数按行向量做 t 步传播 s←sT,再做度数校正 fi=s(t)i / d_i^δ,其中 di 是邻域计数而不是加权入度。行归一化只固定每个源点的出权总和,不能均衡目的点收到的总量;即使均匀初始化,一步传播也会因连通性产生非均匀排名,度数校正再按邻域计数重排。训练时用 straight-through Top-k:前向硬子集,反向平滑代理;掩码门控注意力概率。训练只更新约 450 万选择器参数,骨干冻结。先在 ρ=0.9 的强信号子集上约 0.3 个 epoch,再在加权 77.9 万混合上约 2 个 epoch,并按 ρ∈{0.5,0.3,0.1,0.9} 采样,使一个检查点覆盖七档预算。推理时选择器在解码器前运行一次,物理删除未选视觉 token,保留原始位置编号。
逐图理解论文
层丛式选择
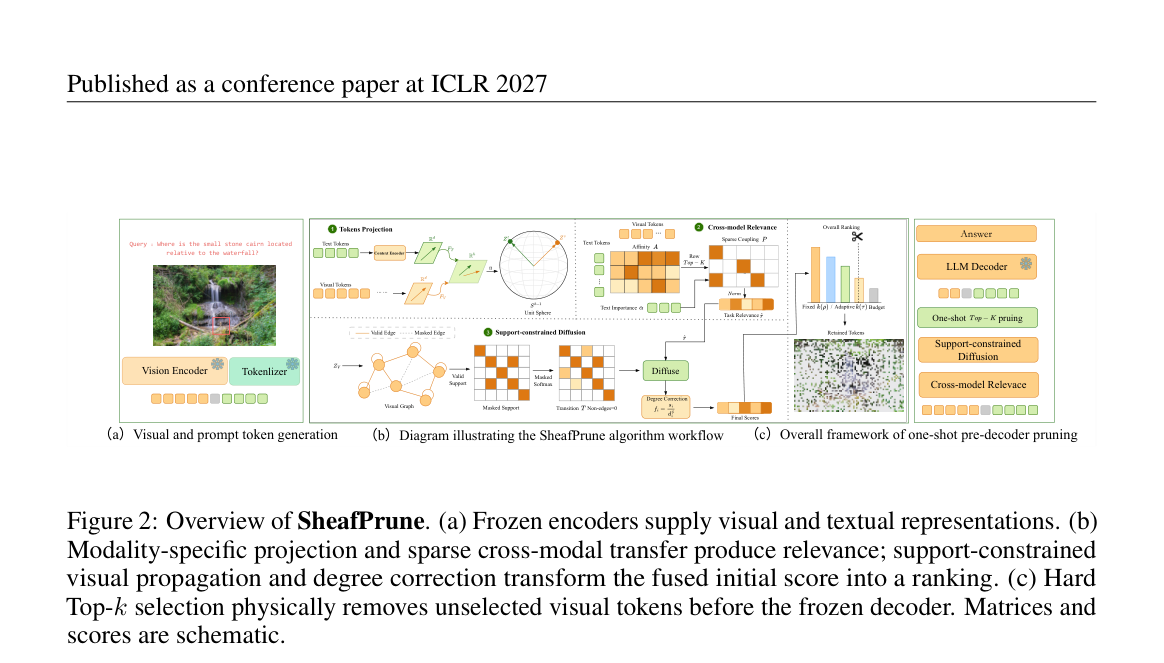
图2是方法总览,宜作特色图。(a) 问 Where is the small stone cairn located relative to the waterfall?,瀑布图经 Vision Encoder 与 Tokenizer 变成视觉与提示 token。(b) 绿色 Tokens Projection 把文本、视觉映射到单位球面;橙色 Cross-model Relevance 用亲和矩阵与稀疏耦合得到任务相关性;下方 Support-constrained Diffusion 在视觉图上区分 Valid/Masked Edge,经 Transition T 与 Degree Correction f=s/d^δ 得到最终分数,再按 Fixed/Adaptive Budget 做 Overall Ranking。(c) 右侧栈把 Cross-model Relevance、Support-constrained Diffusion、One-shot Top-k pruning 接到冻结 LLM Decoder 与 Answer。矩阵和分数为示意。
关键证据
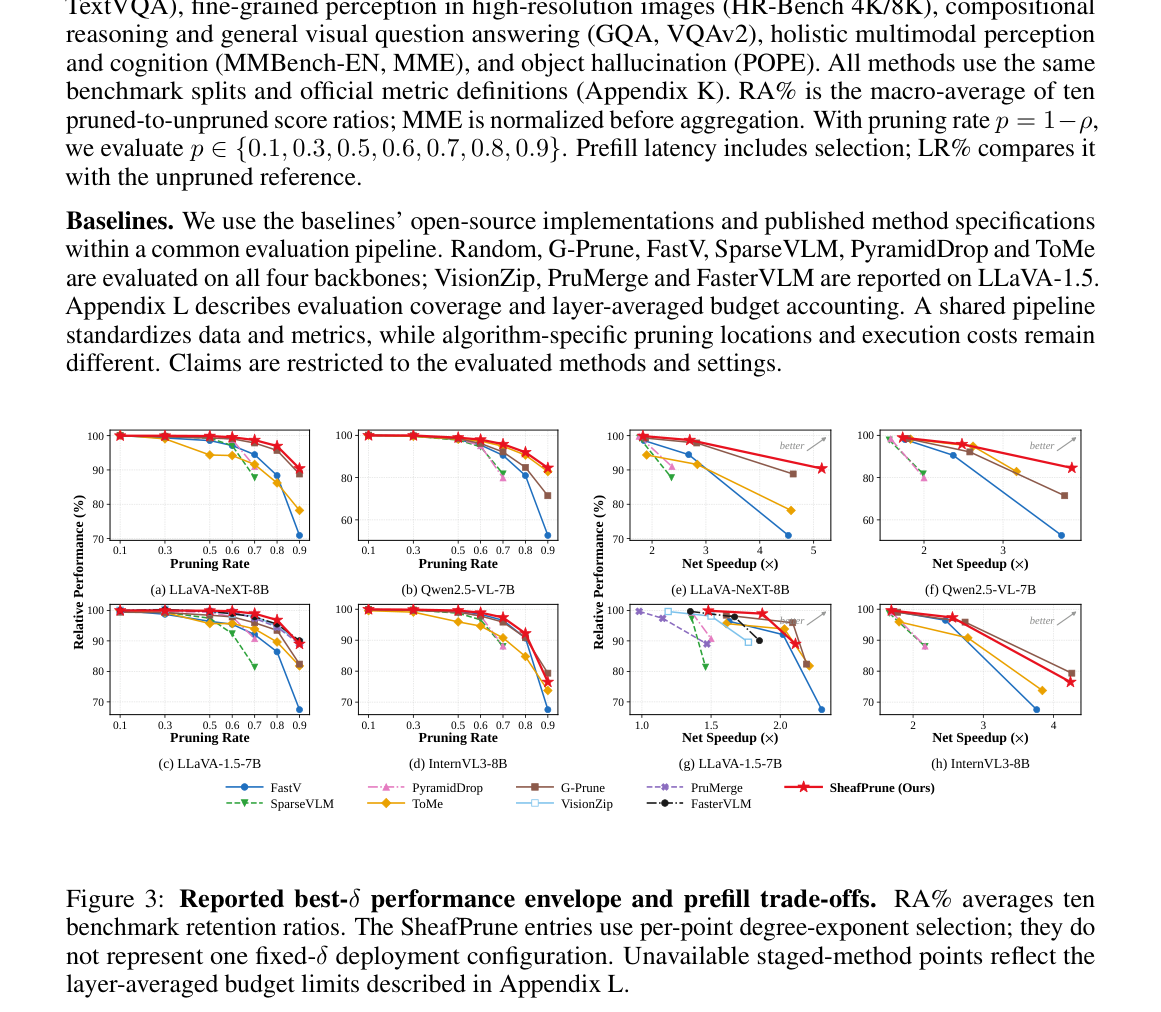
图3是 best-δ 性能包络与预填充权衡。上部裁切含实验设置正文,讲图时忽略。左列 (a–d) 是四条骨干上 Relative Performance 对 Pruning Rate 0.1–0.9:红色 SheafPrune 在高剪枝率仍最高,其他方法在 p≥0.7 下降更快。右列 (e–h) 是同一保留率对 Net Speedup:LLaVA-NeXT 上红线伸到约 5× 仍靠近 90%;Qwen2.5-VL 约到 4×;LLaVA-1.5 速度轴较短,约 2×。图注明确这些点按逐点选 δ,不是固定-δ 部署;部分分层方法缺测点来自附录 L 的层均预算下限。
结论与局限
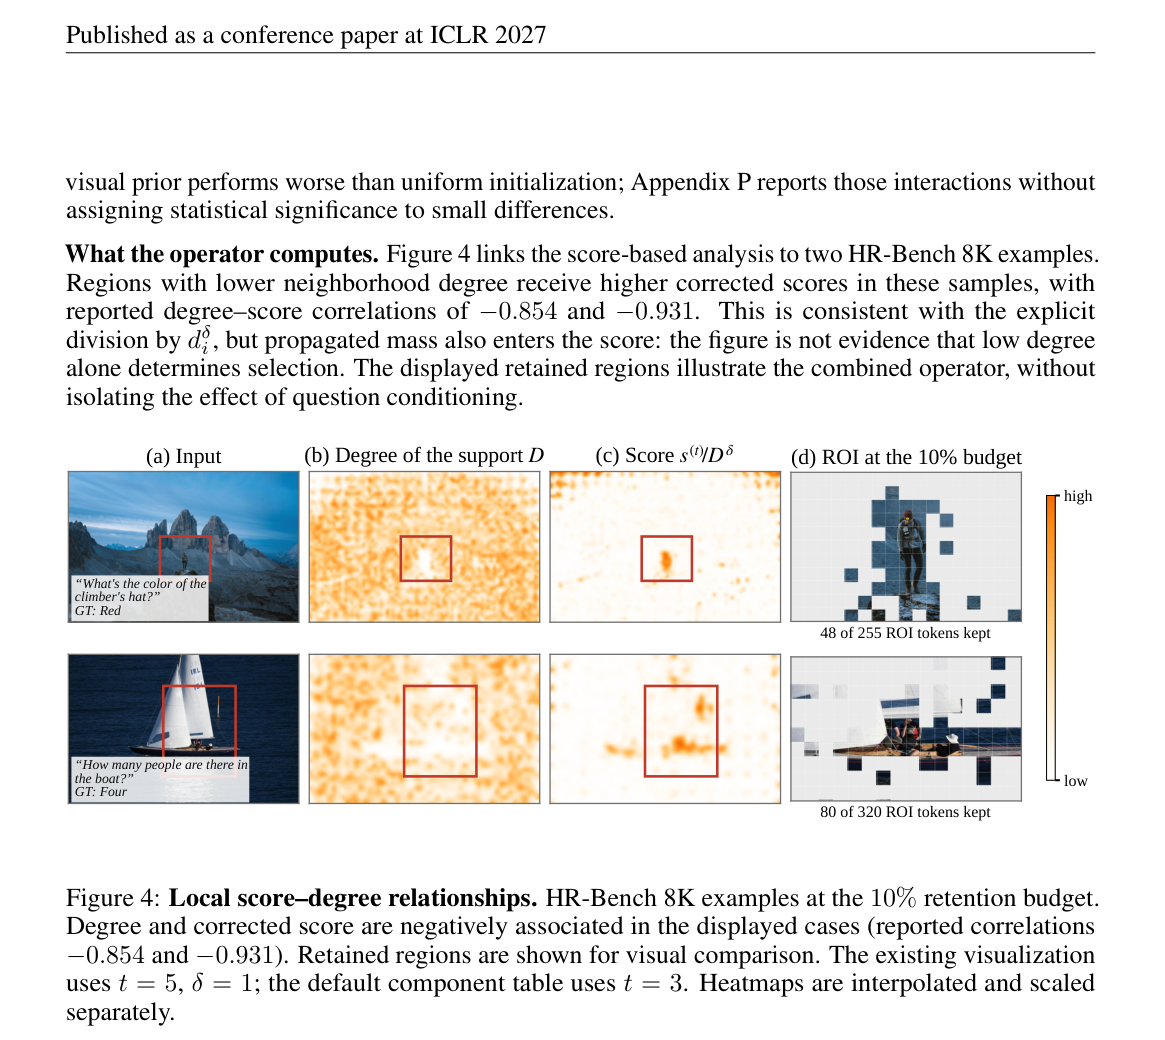
图4把分数–度数关系落到 HR-Bench 8K、10% 保留。上例问登山者帽子颜色,真值 Red;下例问船上人数,真值 Four。四列是 Input、Degree of the support D、Score s(t)/D^δ、ROI at the 10% budget。度数热图在红框兴趣区较亮(邻居多),校正分数则在人/船处更集中。上例保留 48 of 255 ROI tokens,下例 80 of 320。正文给出度数与校正分数相关 −0.854 与 −0.931。可视化用 t=5、δ=1,默认消融表用 t=3;热图分别插值缩放。
实验如何设计?
- 骨干为 LLaVA-NeXT-8B、Qwen2.5-VL-7B、InternVL3-8B、LLaVA-1.5-7B。十个基准覆盖 ChartQA、DocVQA、TextVQA、HR-Bench 4K/8K、GQA、VQAv2、MMBench-EN、POPE、MME。RA% 是十个基准剪枝/未剪枝分数比的宏平均,MME 聚合前先归一化。剪枝率 p∈{0.1,0.3,0.5,0.6,0.7,0.8,0.9}。预填充时延包含选择开销。选择器在 LLaVA-NeXT 上训练后,权重复用于其他骨干、不再重训。
- FastV、SparseVLM、PyramidDrop、ToMe、G-Prune 与随机选择在四条骨干上评;VisionZip、PruMerge、FasterVLM 主要在 LLaVA-1.5 上报告。主对比在每个点从 δ∈{0,0.5,1,2} 取最好,是包络不是固定-δ 部署曲线。组件消融改用固定默认:t=3、qv=0.05、δ=1。作者把结论限制在已评方法与设定,不声称优于未测选择器。
关键结果与论文证据
- 按 best-δ 协议,SheafPrune 在 p=0.5–0.8 的全部 16 个骨干–预算点领先;相对最强对照的点估计优势在 LLaVA-NeXT 上从 +0.10 增到 +1.25,InternVL3 上从 +0.22 增到 +1.40。轻剪时差距窄,预算变紧后持续变宽。总体 28 组里 22 组最高。p=0.9 时它在 LLaVA-NeXT(RA 90.42%)和 Qwen2.5-VL(84.60%)仍最高,但在 LLaVA-1.5 上被 FasterVLM 与 VisionZip 超过,在 InternVL3 上被 G-Prune 超过。
- Table 1 给出 p=0.7(ρ=0.3)切片。LLaVA-NeXT 未剪枝平均 65.2、时延 149.4 ms;SheafPrune 平均 64.3、RA 98.7%、时延 55.3 ms、时延降 63.0%。同设定 G-Prune 的 RA 为 97.9%,ToMe 为 91.6%。正文补充:该预算下 SheafPrune 保留 98.71%,相对 ToMe、G-Prune 的净预填充加速 2.70× 对 2.84×、2.83×,更好保留大约多付 5% 时延。p=0.9 时 LLaVA-NeXT 上准确与速度最优点重合:90.42% RA、5.15× 加速、端到端 FLOPs 降 84.0%。选择开销约占未剪枝预填充的 2.6%(LLaVA-NeXT)和 7.2%(更短的 LLaVA-1.5)。
- 固定配置消融(Table 2)显示运算符比初始化更关键。p=0.9 时完整方法 RA 89.39%;去掉度数校正掉到 72.80%,稠密归一化 72.68%,接近随机 73.38%。只按度数排名 81.38%,仍低 8.01 点。均匀初始化只低 1.20 点(88.19%),说明连通性本身就能造出大部分排名。图4在 HR-Bench 8K、10% 保留下,度数与校正分数呈负相关(−0.854、−0.931):登山者红帽问题保留 48/255 个 ROI token,船上人数问题保留 80/320。作者提醒这不是“低度数单独决定选择”,也不是问题条件化的因果证据。
阅读时需要注意
- 主表是逐点选 δ 的性能包络,不是单一固定超参的部署曲线;轻剪时更简单选择器有时更快。视觉阶段用的是普通图转移加计数校正,不是完整层丛拉普拉斯,也不声称提出新的通用层丛扩散算子。
- 打分选择不显式要求空间覆盖。p=0.9 时 GQA 网格覆盖 0.417,低于随机的 0.500;绝对数量也重要:345 个候选约留 35 个 token,4096 个 HR-Bench 候选约留 410 个。覆盖感知选择被作者列为待测方向,不是已验证补救。Qwen2.5-VL 在 p=0.9 上 t=20 的四基准均值低于 t=1–10,说明更长传播并非一律更好。
- 训练数据为公开 LLaVA-NeXT-Data,可能继承偏差与敏感内容。权重因文件体积未随补充材料发布,作者计划在双盲评审后放出代码与检查点。页眉 ICLR 2027 按预印本处理。
关联工作
- 视觉压缩在打分信号和对未选 token 的操作上分化:VisionZip 结合重要性与特征相似,DivPrune 强调子集多样性,ToMe 合并相似 token。FastV 用浅层注意力,SparseVLM 引入文本,PyramidDrop 分层删除。G-Prune 在相似图上传播视觉重要性,是图排名的直接对照。指令与交互感知还有 IVTP、LVPruning、ATP-LLaVA;CDPruner 与 CoIn 在子集层看相关与代表性。SheafPrune 训练小选择器并冻结骨干,实验只比较已实现方法。
- 细胞层丛给节点和边配备向量空间,用线性限制映射比较局部状态。Neural Sheaf Diffusion 把这些映射用于图表示学习。SheafPrune 借用该视角做跨模态比较,并把信息传递限制在选定关系上;附录 A 给出跨模态边能量的条件细胞层丛解释。随后的视觉排名仍是普通图转移加计数校正。