SemanTok:面向高效自回归视频生成的可预测语义token
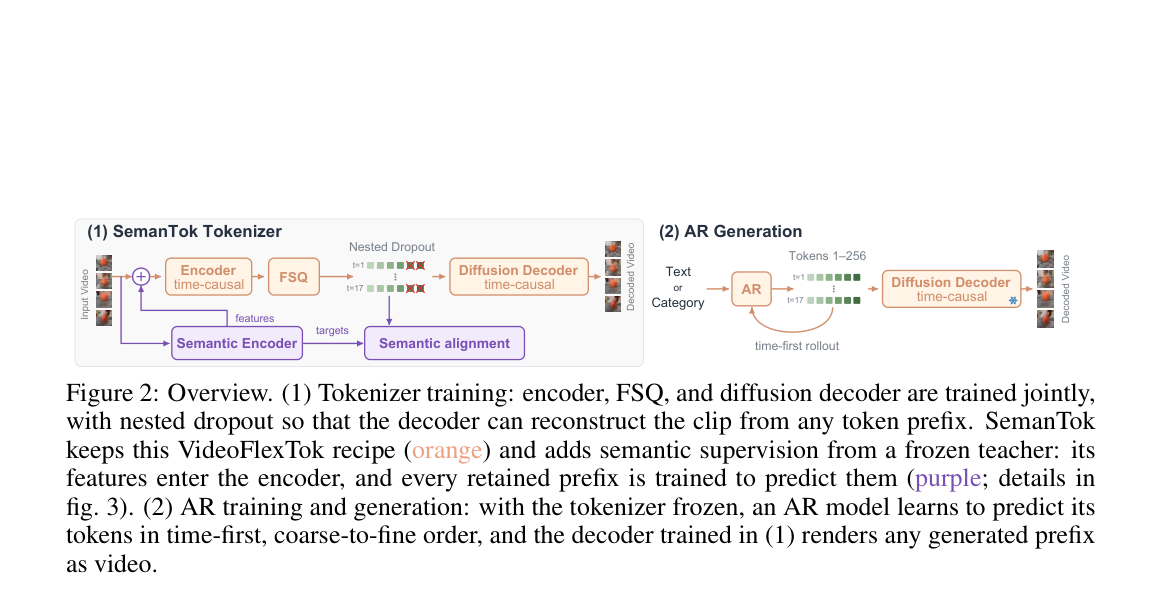
SemanTok 在灵活视频分词器上加入冻结 DINO 的编码器输入与前缀级语义头,让短 token 前缀先锁定片段语义,从而用更小的自回归模型达到更高生成保真与对齐。
PACT:从视频端到端学习人体姿态、接触与作用力
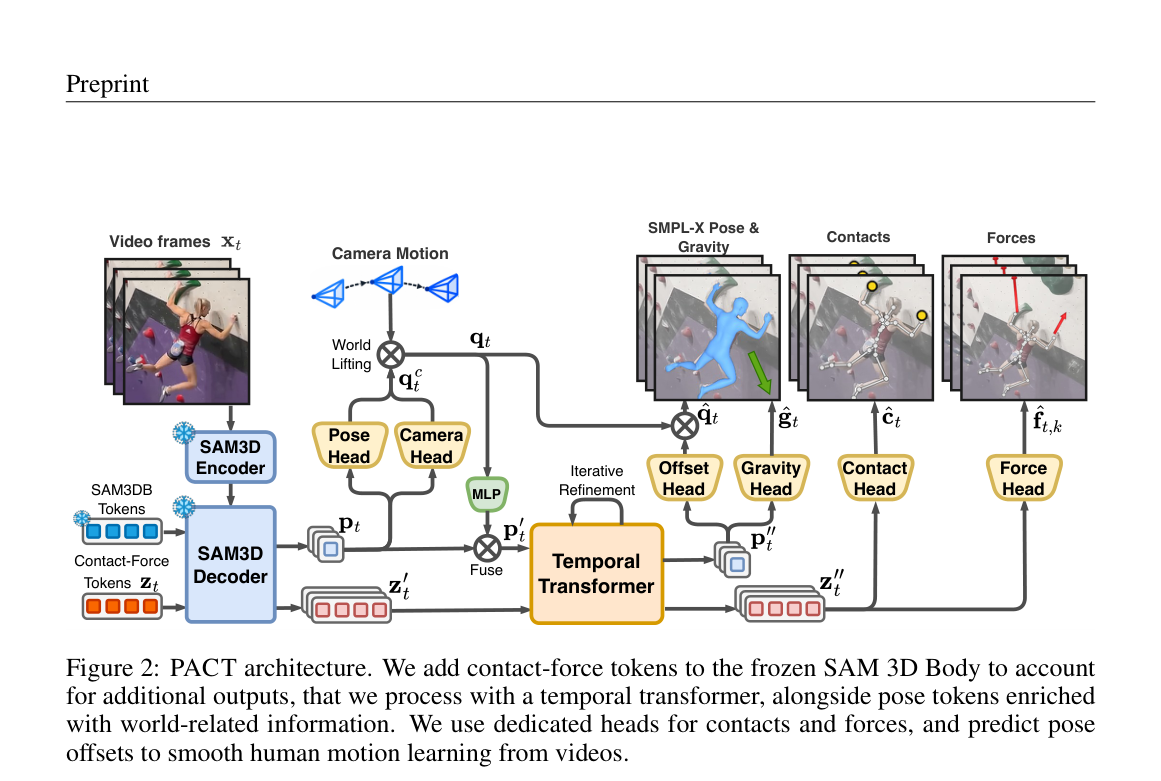
PACT 在冻结的 SAM 3D Body 上加入接触力 token 与时序 Transformer,联合预测姿态、接触与作用力,并用物理监督与伪标注管线解决力标注稀缺。
ATI-VLA:先做可行动对齐再自适应注入的动作中心预测式视觉语言动作模型
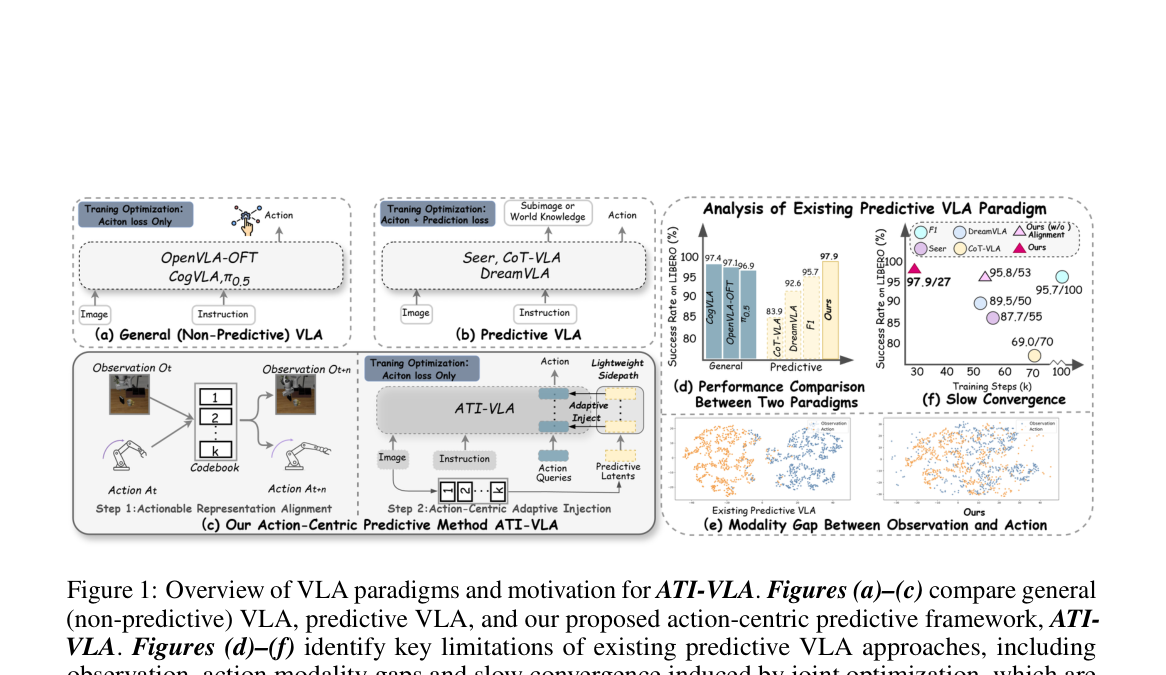
ATI-VLA 先用共享码本把观测与动作对齐到可行动离散潜空间,再以轻量旁路把预测潜变量按层间隔注入动作解码,只优化动作损失。