快速导读:现有视频推理基准有三个问题。第一,输入大多是线稿或抽象示意图,和真实世界视觉分布不匹配。第二,很多任务只要求生成一个合理的最终状态,不要求展示视觉推演过程。第三,任务难度没有经过校准,有的太简单,有的根本不可解。这三个问题让诊断结果缺乏说服力。
VGI-BENCH 是一个专门为视频生成模型设计的视觉智能基准,包含 27 个任务、810 个实例,覆盖四个互斥领域和七个非互斥技能标签。它的核心主张是:视频生成模型的视觉推理能力,不能只看最终画面是否合理,而必须考察生成过程中的中间状态是否有效。
这篇论文的独特之处在于三个设计选择:真实感输入、过程敏感评估、以及校准后的难度分布。这三个选择分别针对现有基准的三个系统性缺陷,使得 VGI-BENCH 的诊断结果比以往工作更有说服力。
英文题目:VGI-BENCH: Probing Visual Intelligence in Video Generation Models
论文出处:arXiv 每日论文精选 · arXiv:2608.19583
原始论文:PDF / 论文页面
这篇论文解决什么问题?
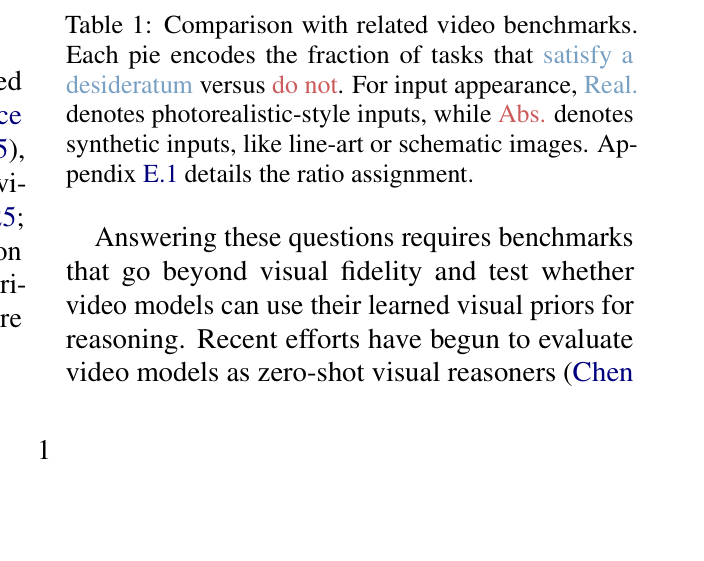
现有视频推理基准的第一个问题是视觉域不匹配。TiVi-Bench、PhysGenBench 等基准大量使用线稿、示意图或抽象图形作为输入,而视频生成模型的训练数据以真实世界视觉为主。这种分布差异意味着模型在基准上的失败可能只是视觉风格不适应,而非推理能力不足。
第二个问题是缺乏对视觉推演过程的要求。很多基准任务只需要模型生成一个合理的最终状态,比如把物体放到正确位置。但视觉智能的核心恰恰在于中间轨迹:物体是如何移动过去的?中间状态是否物理合理?是否遵守了规则约束?
第三个问题是任务难度未校准。如果任务太简单,所有模型都能通过,基准就没有区分度;如果任务太难,连人类都无法完成,那么模型的失败也不能说明什么。VGI-BENCH 通过预生成过滤和人工审核来解决这个问题。
核心创新
方法概览
现有视频推理基准有三个问题。第一,输入大多是线稿或抽象示意图,和真实世界视觉分布不匹配。第二,很多任务只要求生成一个合理的最终状态,不要求展示视觉推演过程。第三,任务难度没有经过校准,有的太简单,有的根本不可解。这三个问题让诊断结果缺乏说服力。
- 双层分类法:第一层是四个互斥领域——Visual Organization、Physical Manipulation、Structured Puzzles、Spatiotemporal Dynamics;第二层是七个非互斥技能标签——Spatial、Temporal、Planning、Attribute Grounding、Physics、Topology、Affordance。每个任务恰好属于一个领域,但可以携带一到三个技能标签。
- 真实感输入:所有任务的输入图像都采用真实感风格,避免线稿或示意图带来的视觉域不匹配。论文还专门做了风格对比实验,将部分任务转换为线稿版本,验证输入风格对模型性能的影响。
- 过程敏感评估:使用两个指标。Completeness 分为 complete、partial、failed 三档,衡量全局目标是否达成。Rubric Score 基于细粒度检查清单,对中间过程的每个关键步骤进行评分,并采用逆衰减惩罚——越靠后的违规惩罚越重。最终分数是两者的乘积。
- VLM 评估器:使用 Gemini-3-Flash 作为评估器,配合自适应帧采样和滑动聚焦窗口。自适应帧采样采用粗到细的策略,先粗看整体再细看关键帧;滑动聚焦窗口以 10 帧为单位检查局部连续性,以捕获瞬时违规。
- 难度校准:预生成过滤阶段,作者用多个模型对候选任务进行预生成,剔除那些所有模型都能轻易完成或所有模型都无法完成的任务。随后进行人工审核,确保每个任务的难度分布合理。
- 合成微调迁移分析:论文引入了 VBVR 系列模型,这些模型在大型视频推理套件上做了 LoRA 微调。通过比较 VBVR 模型与其基础模型在 VGI-BENCH 上的表现,可以分析合成训练数据的迁移效果。
- 去噪轨迹分析:作者在不同去噪步骤解码中间帧,追踪解决方案状态的转变。状态分为正确、错误和稳定三类,通过分析相邻步骤之间的状态转移矩阵,揭示模型在生成过程中的自我修正能力。
逐图理解论文
失败案例与直觉
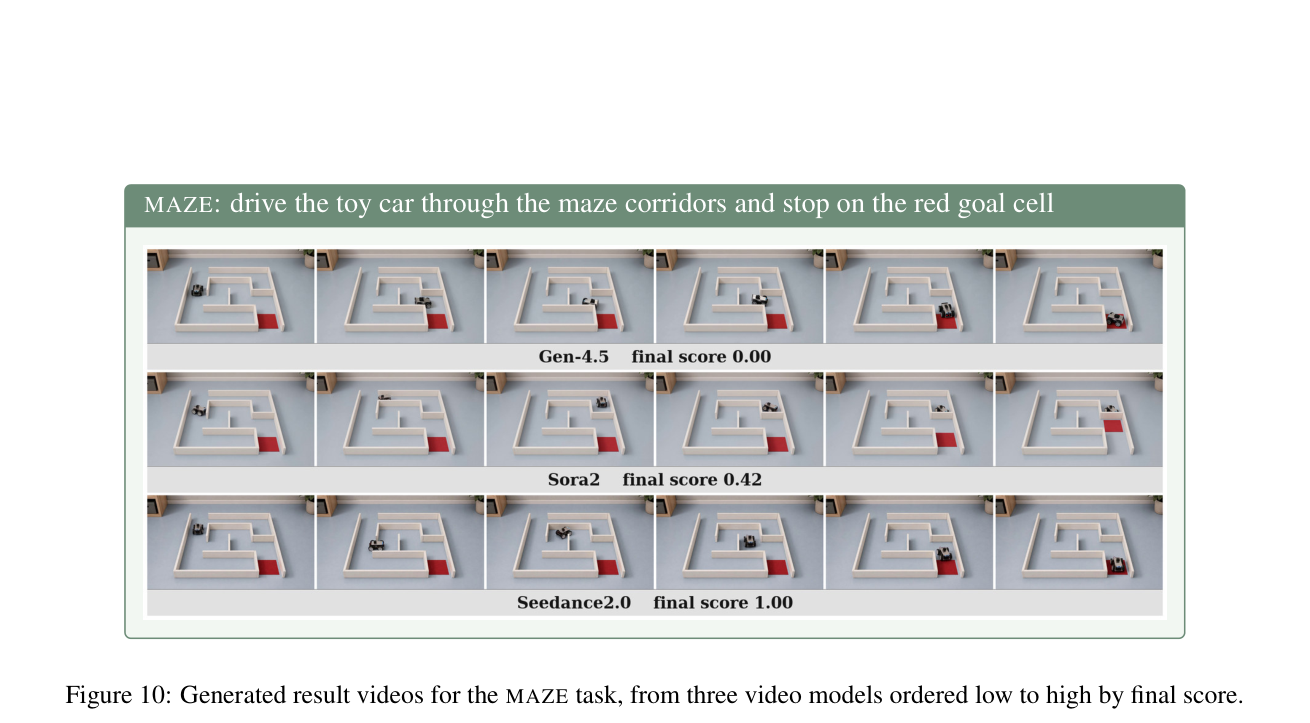
想象一个迷宫任务:模型需要从入口走到出口。很多模型生成的视频里,角色会直接穿过墙壁,或者瞬间跳到终点。最终画面看起来没问题,但中间过程完全不合理。这说明只看最终状态是不够的——视觉推理的关键在于中间轨迹是否有效。
研究缺口
现有视频推理基准有三个问题。第一,输入大多是线稿或抽象示意图,和真实世界视觉分布不匹配。第二,很多任务只要求生成一个合理的最终状态,不要求展示视觉推演过程。第三,任务难度没有经过校准,有的太简单,有的根本不可解。这三个问题让诊断结果缺乏说服力。
核心贡献
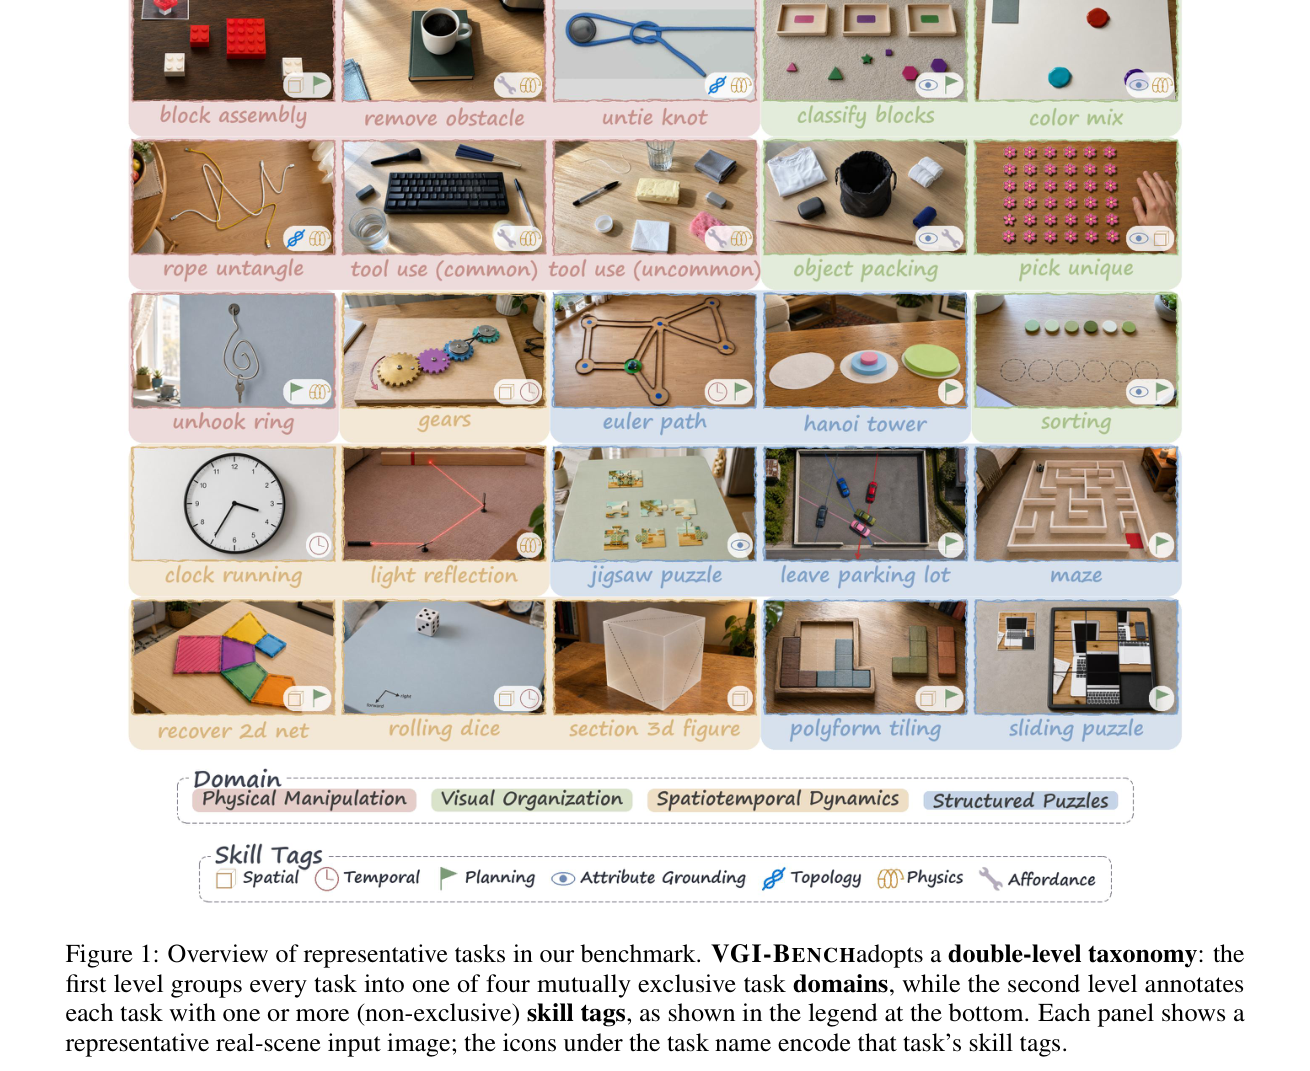
这张图展示了 VGI-BENCH 的代表性任务和双层分类法。注意每个任务面板下方的图标编码了该任务的技能标签,可以直观看到不同领域和技能的组合方式。
最强结论
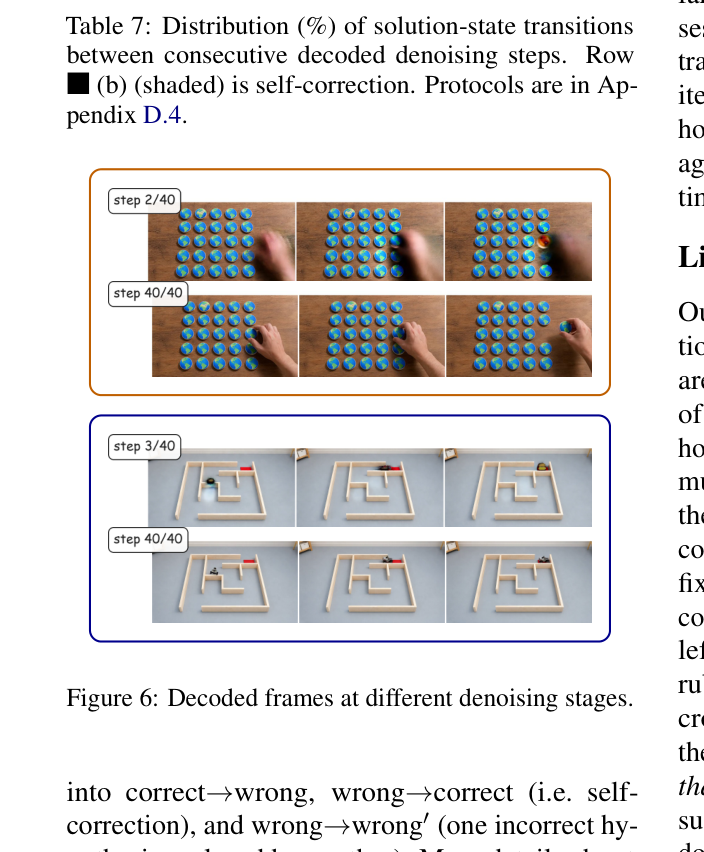
这张表报告了去噪过程中解决方案状态的转变分布。重点看自纠正行的数值——它揭示了模型在生成过程中几乎没有自我修正能力。
实验如何设计?
- 视频模型评估:9 个视频生成模型(包括商业和开源模型)在 VGI-BENCH 上评估,使用 image-to-video 设置,分辨率默认为 1280×720。
- 图像模型评估:11 个图像模型在适配的单图像子集上评估,使用 Success Rate 指标,与视频分支的评估方式不同。
- 评估器可靠性研究:将 VLM 评估器的结果与人工标注对比,报告 AUC 和成对准确率,并做关键组件和基础模型的消融实验。
- 输入敏感性实验:包括 oracle prompting(显式描述预期解决方案的提示)和视觉风格对比(真实感 vs 线稿)。
- 去噪轨迹实验:在不同去噪步骤解码帧,分析解决方案状态的转变分布。
关键结果与论文证据
- Seedance 2.0 在视频基准上取得最佳总分 51.0(第 5 页),但所有模型的绝对分数都偏低,说明视觉推演推理对当前模型仍然非常困难。
- VLM 评估器与人工标注的一致性为 AUC 0.803、成对准确率 73.2%(第 6 页),属于中等水平,说明自动评估仍有改进空间。
- 失败模式分析显示三类主要失败:物理坍缩(物体变形或穿透)、规则违反(不遵守任务约束)、对象/状态不一致(物体在帧间消失或改变属性)(第 7 页)。
- 输入风格敏感性实验显示,开源模型对线稿风格尤其敏感,性能下降明显;商业模型相对稳健(第 7 页)。
- VBVR-Wan2.2 相比基础模型 Wan2.2-I2V 总分从 21.5 提升到 41.2(第 8 页),但提升集中在训练分布中充分代表的技能上,如 planning 和 spatial reasoning;物理交互和强时序依赖仍然难以改善。
- 去噪轨迹分析显示,自纠正(错误→正确)比例低于 1%(第 9 页),而错误→错误'的转变在 4→10 和 10→20 步骤分别达到 23.1% 和 24.8%。稳定状态在后期步骤(20→40)上升到 90.6%。
- oracle prompting 实验表明,即使显式告诉模型预期解决方案,性能提升也有限,说明瓶颈不在提示理解而在视觉推演能力本身(第 8 页)。
阅读时需要注意
- 所有任务限制在典型的 5-10 秒生成长度内,更长时程的程序性推理不在覆盖范围内。
- 仅覆盖 image-to-video 设置和固定 16:9 宽高比,text-to-video、多图像输入、音频条件生成等设置未涉及。
- 所有提示和评分标准均为英文,没有多语言评估。
- 任务套件是代表性而非穷尽性的,不能覆盖所有可能的视觉推理类型。
- VLM 评估器与人工标注的一致性为中等水平(AUC 0.803),不能完全替代人工评估。
关联工作
- TiVi-Bench 是 think-in-video 推理的基准,但数据未公开发布,限制了可复现性。VGI-BENCH 在这一点上做出了改进。
- V-ReasonBench 是视频生成模型的统一推理基准套件,与 VGI-BENCH 的目标相近,但 VGI-BENCH 更强调过程敏感评估和难度校准。
- PhysGenBench 和 WorldSimBench 分别关注物理推理和世界模拟器评估,但它们的推理需求被作者归类为低到中等水平。
- VBVR 是一个大型视频推理套件,带有基准特定的 LoRA 微调。VGI-BENCH 利用 VBVR 模型来分析合成微调的迁移效果。