快速导读:Stream4D 提出用前馈 4D 高斯泼溅重建奖励替代静态 3D 奖励,并配合高斯运动门控与感知锚点,在强化学习框架下同时提升流式自回归视频模型的 4D 一致性与运动保持能力。
流式自回归扩散视频模型逐块生成长视频,但训练目标只优化局部帧预测,缺乏对全局几何与动态一致性的显式约束。随着生成时域变长,几何漂移会逐步累积,物体身份、深度关系和相机运动都会出现不一致。近期工作尝试用静态 3D 高斯泼溅重建作为强化学习奖励来对齐几何一致性,但这一思路在动态场景中存在根本性缺陷。
Stream4D 的核心判断是:静态 3D 奖励把真实物体运动误判为重建误差,因此模型会退化为冻结场景的捷径——让画面几乎不动,就能轻松获得高重建奖励。Stream4D 将奖励骨干替换为前馈 4D 高斯泼溅重建器 MoVieS,并加入以自然运动幅度为中心的高斯门控运动项和 HPSv2 感知锚点,在 DiffusionNFT 前向过程 RL 框架下同时优化 4D 一致性与运动保持。
英文题目:Stream4D: 4D-Consistency for Streaming Autoregressive Diffusion Video Models
论文出处:arXiv 每日论文精选 · arXiv:2608.19556
原始论文:PDF / 论文页面
这篇论文解决什么问题?
流式自回归视频模型的核心矛盾在于:训练时逐块优化局部帧预测,推理时却要维持全局时空一致性。蒸馏得到的 AR 骨干(如 Self-Forcing、Causal-Forcing、LongLive)在长时域生成中会累积几何漂移,表现为物体在帧间漂移、深度关系错乱、相机运动不连贯。
World-R1 和 VideoGPA 等近期工作用静态 3D-GS 重建作为几何一致性奖励。但刚性 3D 重建无法表示动态场景:一个正在奔跑的猫,其逐帧姿态变化在静态重建器看来就是重建误差。因此模型学到的最优策略不是生成连贯运动,而是让场景尽量静止。
论文用 Figure 1 的 LongLive 长时域 rollout 直观展示了这一捷径:蒸馏基座包含大幅运动但猫和鱼在帧间漂移;World-R1 和 VideoGPA 把场景压成低运动的刚性配置;Stream4D 则保持猫的清晰前向运动,同时维持主体和场景的连贯性。
这一观察指向一个明确的研究缺口:AR 视频 RL 需要的是能区分'真实运动'与'几何漂移'的奖励信号,而不是把两者一并惩罚的静态重建奖励。
核心创新
- 首次将 AR 视频 RL 的几何奖励从静态 3D 一致性重构为 4D 一致性,用前馈 4D-GS 重建器(MoVieS)建模动态场景,使真实运动不再被惩罚
- 设计高斯门控运动奖励 g(m)·smooth·rigid,以自然运动幅度为目标同时惩罚静态坍缩和过度运动,并通过 smooth 与 rigid 因子抑制抖动和非刚性伪影
- 提出三项奖励(4D 重建一致性 + 运动先验 + 感知锚点)的逐轴 z 归一化组合配方,可跨三个蒸馏 AR 骨干迁移
方法概览
Stream4D 将静态 3D 重建奖励替换为基于 MoVieS 前馈 4D-GS 的重建一致性奖励 Rrecon(LPIPS 感知一致性),加入以自然运动幅度 mnat 为中心的高斯门控运动项 Rmot = g(m)·smooth·rigid(分别惩罚静态坍缩/过度运动、时间抖动和空间非刚性伪影),并以 HPSv2 作为轻量感知锚点 Rhpsv2。三项奖励经逐轴 z 归一化后加权求和,在 DiffusionNFT 前向过程 RL 框架下优化。
- Stream4D 将静态 3D 重建奖励替换为基于 MoVieS 前馈 4D-GS 的重建一致性奖励 Rrecon,采用 LPIPS 感知一致性度量,使动态场景的重建误差不再被系统性高估。
- 运动项 Rmot = g(m)·smooth·rigid 以自然运动幅度 mnat 为中心的高斯门控 g(m) 为核心:运动过少(静态坍缩)或过多(过度运动)都会被惩罚,形成以自然运动为目标的奖励形状。
- smooth 因子惩罚时间抖动,rigid 因子惩罚空间非刚性伪影,两者共同约束运动质量而非仅仅运动量。
- 感知锚点 Rhpsv2 使用 HPSv2 作为轻量保真度奖励,防止几何与运动优化损害视觉质量。
- 三项奖励经逐轴 z 归一化后加权求和,解决不同尺度奖励不可比的问题。
- 训练在 Astrolabe 前向过程流式 AR RL 框架上进行,采用滚动 KV 缓存与 DiffusionNFT 前向过程扩散强化学习损失。
- 相机参数由 StreamVGGT 逐帧估计,为 4D 重建提供外参与内参。
逐图理解论文
冻结场景的捷径
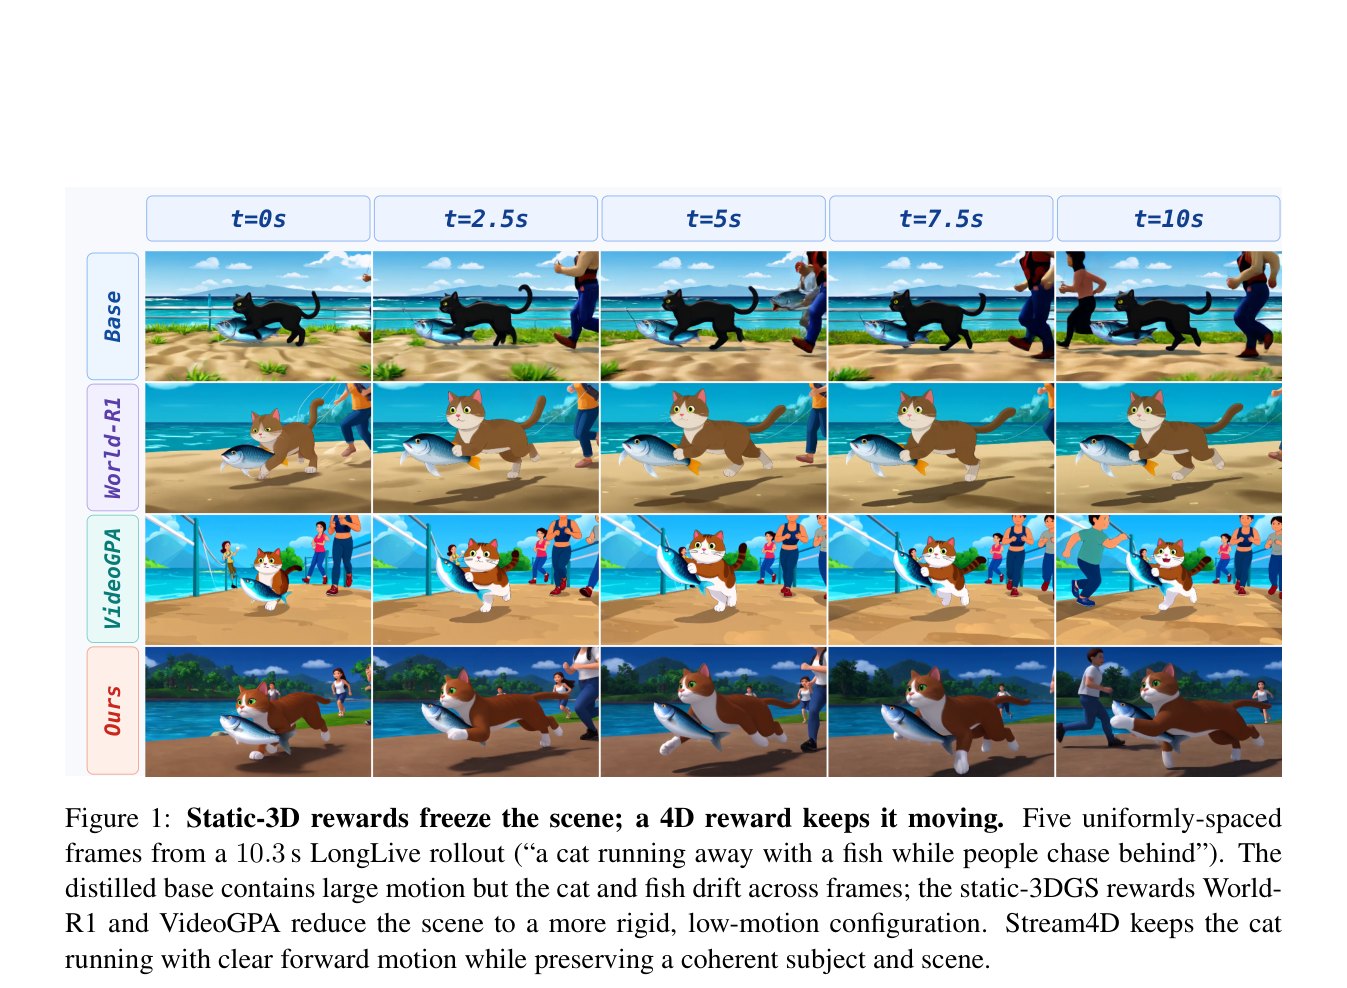
观察五帧均匀采样的 LongLive rollout:蒸馏基座中猫和鱼在帧间漂移,World-R1 和 VideoGPA 将场景压成低运动刚性配置,而 Stream4D 保持猫的清晰前向运动。这直接展示了静态 3D 奖励的冻结捷径与 4D 奖励的修复效果。
研究缺口:奖励信号混淆了运动与漂移
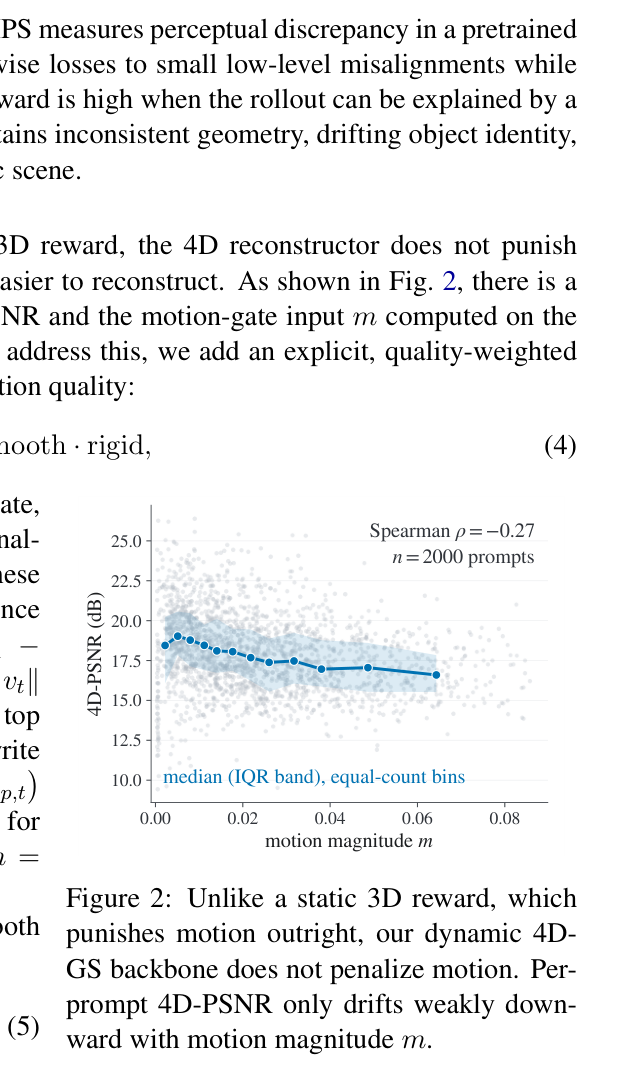
该图显示 4D-GS 骨干下每提示词 4D-PSNR 仅随运动幅度 m 微弱下降,证明动态 4D 重建器不会像静态 3D 奖励那样系统性惩罚运动。这是 Stream4D 方法可行性的关键前提。
Stream4D 的贡献与验证
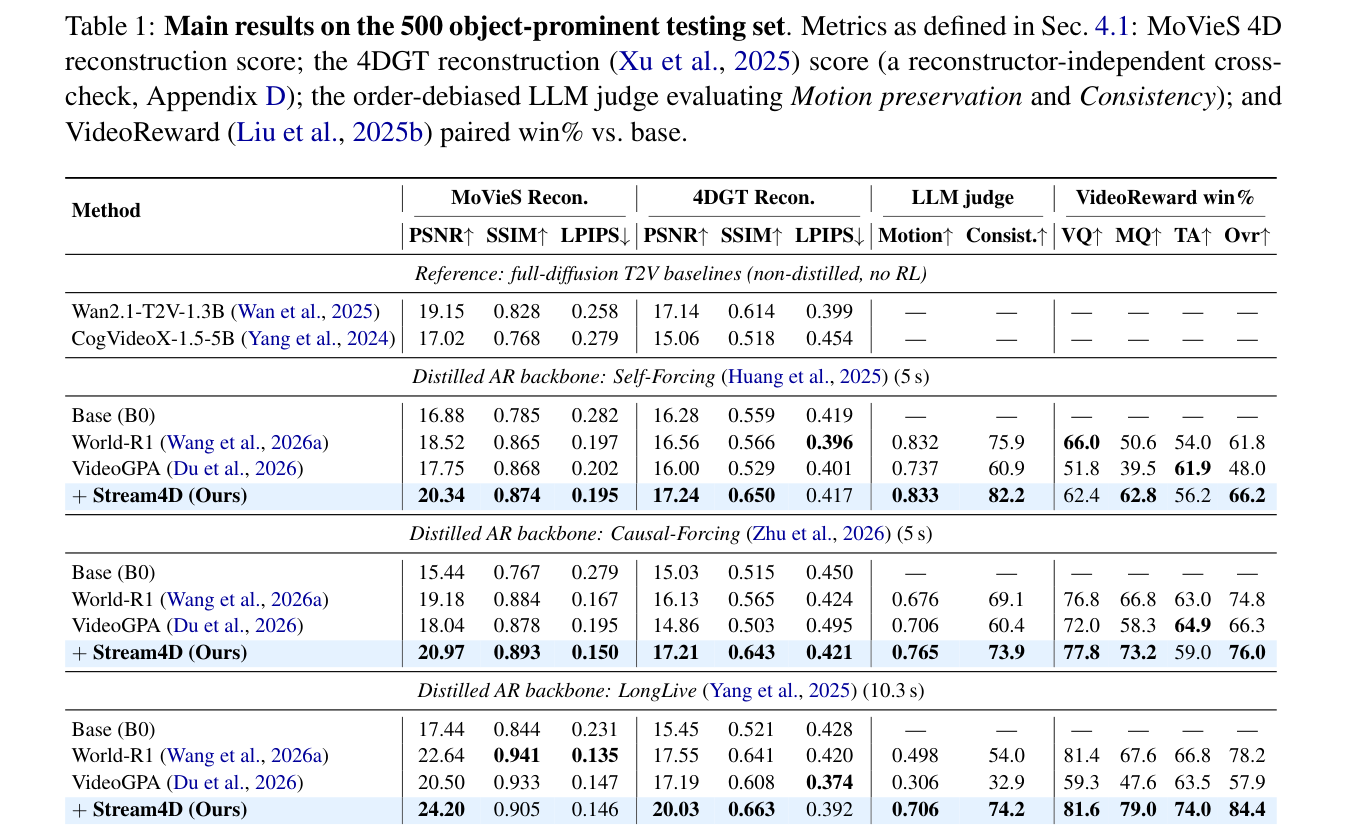
Stream4D 的贡献是把奖励骨干从静态 3D 替换为前馈 4D 高斯泼溅重建器 MoVieS,使真实运动不再被系统性惩罚。在此基础上,它加入以自然运动幅度为中心的高斯门控运动项,同时惩罚静态坍缩和过度运动,并用 smooth 和 rigid 因子抑制抖动与非刚性伪影。再加上 HPSv2 感知锚点,三项奖励经逐轴 z 归一化后加权求和。论文在三个蒸馏 AR 骨干上验证,并用独立的 4DGT 重建器交叉检查,排除了单一重建器的训练偏差。
运动项是防止静态坍缩的关键
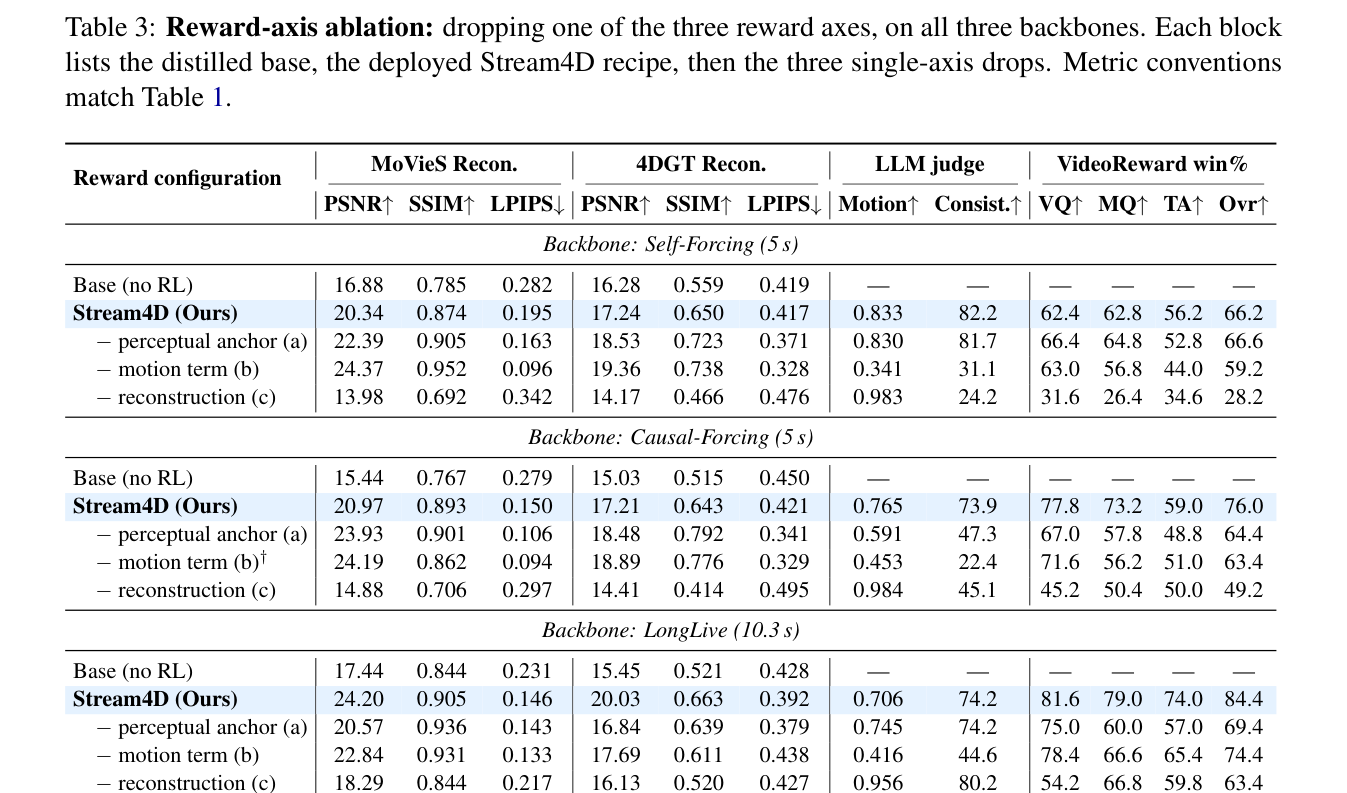
消融实验给出了最强结论:移除运动项后,LLM 一致性胜率骤降到三成以下,模型重新滑向静态坍缩。而移除重建项后,4D-PSNR 大幅回落,说明 4D 重建奖励是几何一致性的主要驱动力。两项证据合起来表明,Stream4D 的效果不是单一奖励项的功劳,而是 4D 重建与运动门控的协同结果。
实验如何设计?
- 在 Self-Forcing、Causal-Forcing、LongLive 三个蒸馏 AR 骨干上与蒸馏基座、World-R1 和 VideoGPA 对比,测试集为 500 个运动显著提示词。
- 在 LongLive 上进行 50 提示词 × 3 配对的人工盲评研究,共 150 次 2AFC 比较,5 名评分者,评估自然运动与整体质量。
- 奖励轴消融:分别移除感知锚点、运动项、重建项,验证三项奖励的独立贡献。
- 运动项公式消融:移除门控、线性项、仅门控、加法拆分,验证门控形状的必要性。
- 门控目标 mnat 敏感性分析(0.010/0.020/0.030),确定自然运动幅度的最优标定。
- 随机 500 提示词子集鲁棒性检验,排除提示词选择偏差。
关键结果与论文证据
- Stream4D 在 Self-Forcing 上 4D-PSNR 从 16.88 提升至 20.34(+3.46 dB),在 Causal-Forcing 上从 15.44 提升至 20.97(+5.53 dB),在 LongLive 上从 17.44 提升至 24.20(+6.76 dB),见第 7 页表 1。
- 4DGT 交叉验证下 Stream4D 在三个骨干上分别领先 World-R1 +0.7/+1.1/+2.5 dB PSNR,排除了 MoVieS 训练偏差的单一解释,见第 7 页。
- LLM 一致性胜率:Stream4D 82.2%/73.9%/74.2% vs World-R1 75.9%/69.1%/54.0%,见第 7 页表 1。
- 人工评估 Overall 胜率:Stream4D vs World-R1 76%,vs VideoGPA 80%,见第 8 页表 2。
- 移除运动项后 LLM 一致性胜率骤降至 31.1%/22.4%/44.6%,证明运动项是防止静态坍缩的关键,见第 8 页表 3。
- 移除重建项后 4D-PSNR 降至 13.98/14.88/18.29,证明 4D 重建奖励是几何一致性的主要驱动力,见第 8 页表 3。
- mnat=0.020 时取得最佳 Consistency 82.2% 和 VideoReward-Overall 66.2%,位于运动-保真度权衡的拐点,见第 10 页表 5。
- Figure 3 的重建-运动权衡图显示部署配方位于右上角前沿,说明 Stream4D 同时优化了两个通常冲突的目标。
阅读时需要注意
- LLM 裁判指标来自单一视觉 LLM(Gemini-3.5-Flash),虽经 VideoReward 和 4D 指标佐证,仍存在单一裁判偏差风险。
- 4DGT 交叉验证虽排除了 MoVieS 的训练偏差,但两者共享 StreamVGGT 相机估计组件,相机估计误差可能共同影响两个重建器。
- 训练奖励与评估指标共用 MoVieS 重建骨干,存在一定程度的指标自洽性。
- World-R1 和 VideoGPA 为作者在 AR 设定下的复现,无公开 AR 版本 checkpoint 可对比。
- 运动项中的 mnat 和 σ 为 MoVieS 规范场景单位下的经验值,跨模型迁移时需重新标定。
- 随机子集上冻结型基线(VideoGPA)在重建指标上可能反超 Stream4D,需结合运动感知裁判才能暴露其捷径。
关联工作
- World-R1 是基于静态 3D-GS 重建的几何一致性奖励方法,是 Stream4D 的主要对比基线和动机来源,见第 3 页。
- VideoGPA 同样使用静态 3D 重建奖励的偏好对齐方法,在 AR 设定下表现出冻结场景的捷径行为,见第 3 页。
- MoVieS 是前馈 4D 高斯泼溅重建器,是 Stream4D 奖励骨干的核心组件,见第 4 页。
- Astrolabe 是 Stream4D 所基于的前向过程流式 AR RL 训练框架,采用滚动 KV 缓存与 DiffusionNFT,见第 4 页。
- 4DGT 是与 MoVieS 架构、权重和训练数据均不同的 4D 重建器,用作重建增益的交叉验证,见第 7 页。