快速导读:4DAnyone 通过生成重建级多视角一致视频并将其提升为 4D Gaussian Splatting,从无标定单目视频重建可自由视角渲染的 4D 人物。
4DAnyone 解决的核心问题是:如何从一段随意拍摄、无相机标定的单目视频中,重建出可以在任意新视角渲染的动态人物。传统 4DGS 重建需要密集多视角视频,而单目视频天然缺少遮挡区域和跨视角外观信息,直接重建几乎不可行。4DAnyone 的答案是先“生成”再“重建”:用视频扩散模型生成一组多视角一致的视频,再用 FreeTimeGS 把这些视频提升为 4D Gaussian Splatting 模型。
这条生成-重建管线看似直接,但真正的难点藏在生成阶段。相机控制视频扩散模型在生成少数几个视角时表现尚可,一旦目标视角扩展到 4DGS 重建所需的数十个,跨视角一致性就会迅速崩溃。4DAnyone 的贡献正是针对这一扩展瓶颈,提出了两个互补机制:Reference Context Packing 和 Target Context Routing,分别解决参考上下文爆炸和跨组结构漂移。
英文题目:4DAnyone: Create Anyone in 4D from a Casual Monocular Video
论文出处:arXiv 每日论文精选 · arXiv:2608.20335
原始论文:PDF / 论文页面
这篇论文解决什么问题?
4DGS 方法需要密集多视角视频作为输入,但普通用户只有一部手机拍的单目视频。单目直接重建无法恢复被遮挡的区域,也无法保证高保真外观在不同视角下保持一致。因此,研究者转向生成-重建管线:先用视频扩散模型生成缺失视角,再重建 4DGS。
然而,现有相机控制视频扩散模型在扩展到数十个目标视角时面临两个瓶颈。第一,单次 DiT 前向的注意力上下文受内存限制,目标视角必须分组去噪,导致参考上下文随视角数 O(N) 增长,显存和计算量都难以承受。第二,分组去噪意味着不同组之间缺乏信息交换,跨组结构漂移持续存在,生成结果在不同视角间出现外观不一致和几何错位。
CAT4D 等先前工作尝试用滑动窗口去噪缓解跨窗口漂移,但在大视角数下漂移依然存在。Diffuman4D 面向 4D 人体重建,但需要同步稀疏视角视频和已知相机参数,无法处理随意拍摄的单目视频。4DAnyone 的定位正是填补这个空白:从无标定单目视频出发,生成重建级多视角一致视频。
核心创新
- 提出 4DAnyone 框架,从无标定单目视频实现重建级多视角一致视频生成与 4DGS 重建
- 提出 Reference Context Packing (RCP),将参考上下文复杂度从 O(N) 降至 O(1),保留跨视角外观引导
- 提出 Target Context Routing (TCR),在去噪过程中动态轮换目标视角分组,实现跨组上下文共享并减少结构漂移
- 采用 3D-aware skeleton conditioning,以深度缓冲骨架渲染解决 2D 骨架的前后遮挡歧义
- 构建 MVGameHuman 数据集(38k 多视角视频,318 演员,24 相机),结合 light-stage 与 in-the-wild 数据训练
方法概览
给定单目源视频,先用 GVHMR 估计 3D 骨架序列并渲染为深度缓冲骨架视频;3D-aware skeleton encoder 将骨架残差注入目标 latent;RCP 将增长的参考视角压缩为固定长度混合分辨率上下文;TCR 在高噪声阶段循环轮换四视角分组以传播全局结构,低噪声阶段固定相邻组以稳定细节;最终用 FreeTimeGS 从生成的多视角视频重建 4DGS 模型。
- 给定单目源视频,先用 GVHMR 估计 3D 骨架序列,并将其渲染为深度缓冲骨架视频。这一步的关键是把 2D 骨架提升到 3D,利用 z-buffer 处理前后遮挡关系,避免 2D 骨架在肢体交叉时的歧义。
- 3D-aware skeleton encoder 将骨架残差注入目标 latent。具体做法是计算目标视角渲染骨架与源视角骨架的残差,编码后加到噪声目标 latent 上,为生成提供显式的几何引导。
- Reference Context Packing (RCP) 解决参考上下文爆炸问题。它把源视频和已生成的参考视频打包成固定长度的混合分辨率上下文,灵感来自 FramePack 的多尺度 patchify 压缩策略。这样无论生成多少视角,参考上下文复杂度都保持 O(1),同时保留跨视角外观引导。
- Target Context Routing (TCR) 解决跨组结构漂移。在高噪声阶段,TCR 循环轮换四视角分组,让每个视角在不同去噪步骤中与不同组共享上下文,从而传播全局结构;在低噪声阶段,TCR 固定相邻组,稳定细节细化。
- 生成的多视角视频最终用 FreeTimeGS 重建为 4DGS 模型,实现自由视角渲染。
- 训练数据方面,作者构建了 MVGameHuman 数据集,包含 38k 多视角视频、318 位演员、24 个相机,结合 light-stage 与 in-the-wild 数据,覆盖多样的演员、服装、动作、光照和背景。
逐图理解论文
失败直觉
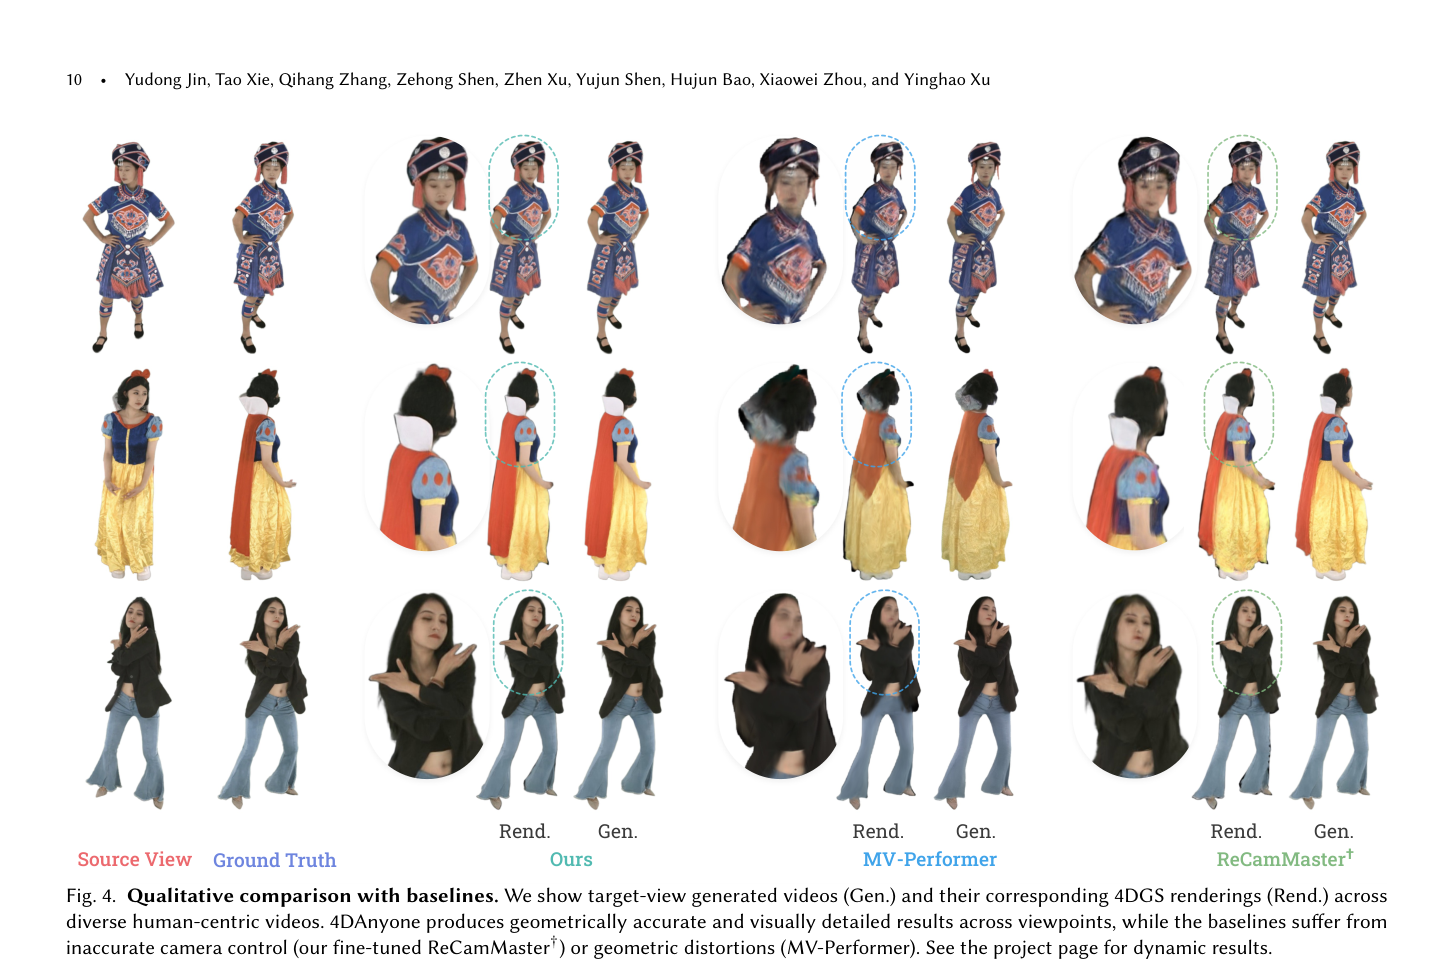
直接重建几乎不可能,因为单目视频看不到被遮挡的区域。于是大家转向生成-重建管线:先用视频扩散模型补出缺失视角,再重建4DGS。但问题来了——相机控制扩散模型生成几个视角还行,一旦要生成几十个视角,跨视角一致性就崩了。
核心贡献
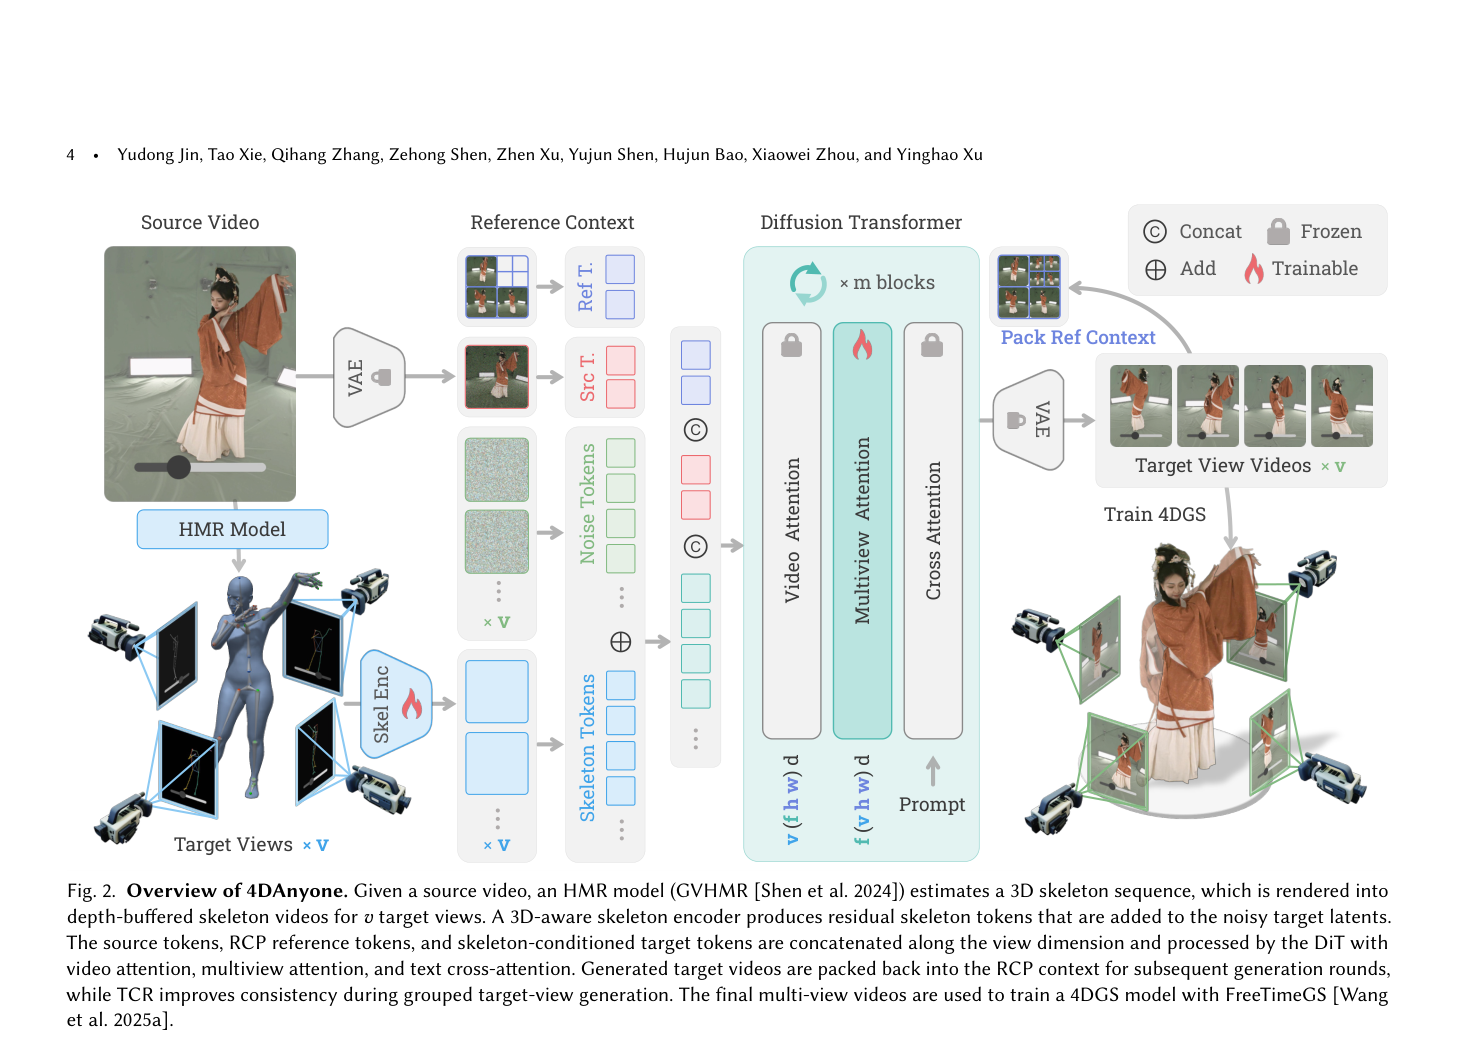
这是方法总览图,展示了从源视频到 4DGS 模型的完整管线。重点观察三个模块的位置:3D-aware skeleton encoder 如何注入骨架残差,RCP 如何打包参考上下文,以及 TCR 如何在分组生成中路由目标视角。
验证方式
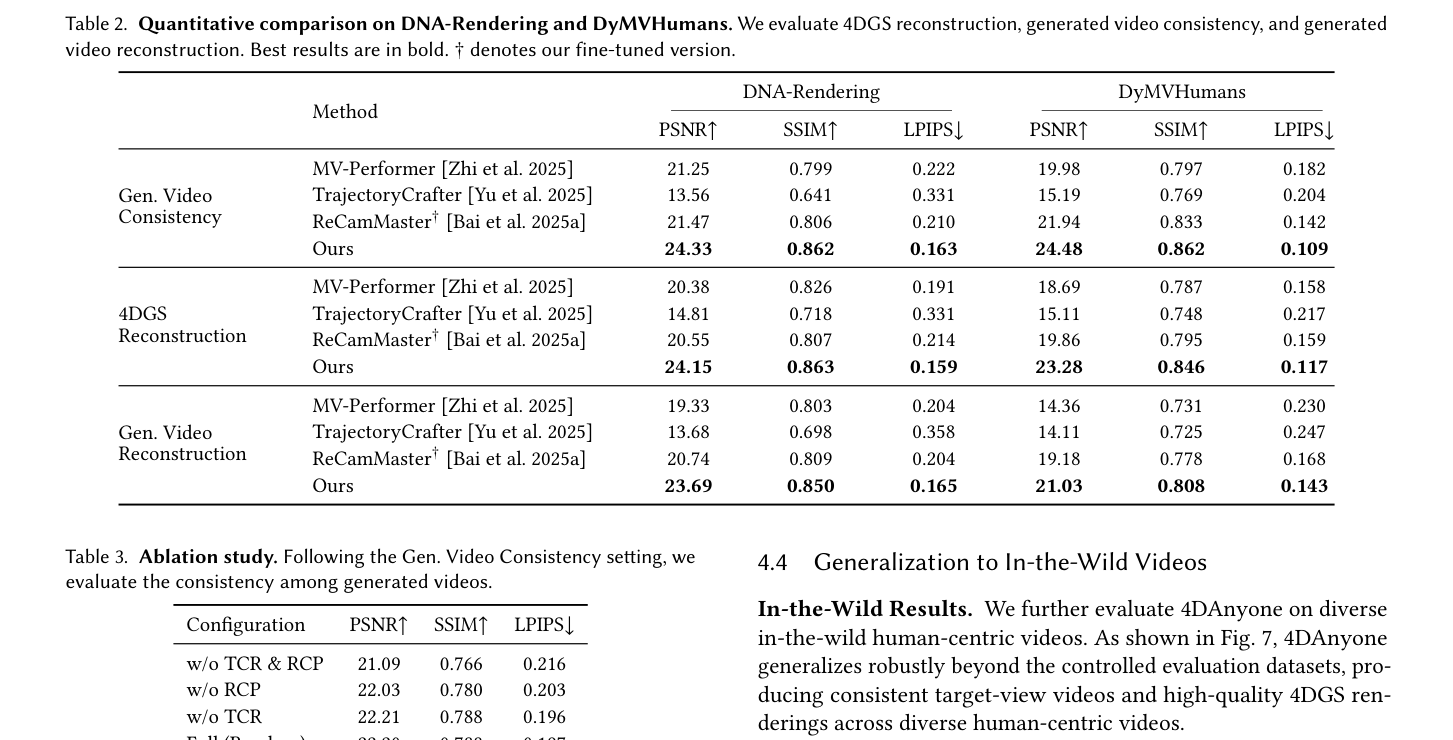
作者在DNA-Rendering和DyMVHumans上评估三个维度:4DGS重建质量、生成视频一致性、生成视频重建质量。消融实验逐个移除RCP、TCR和骨架条件,确认每个模块都有实质贡献。
结论与意义
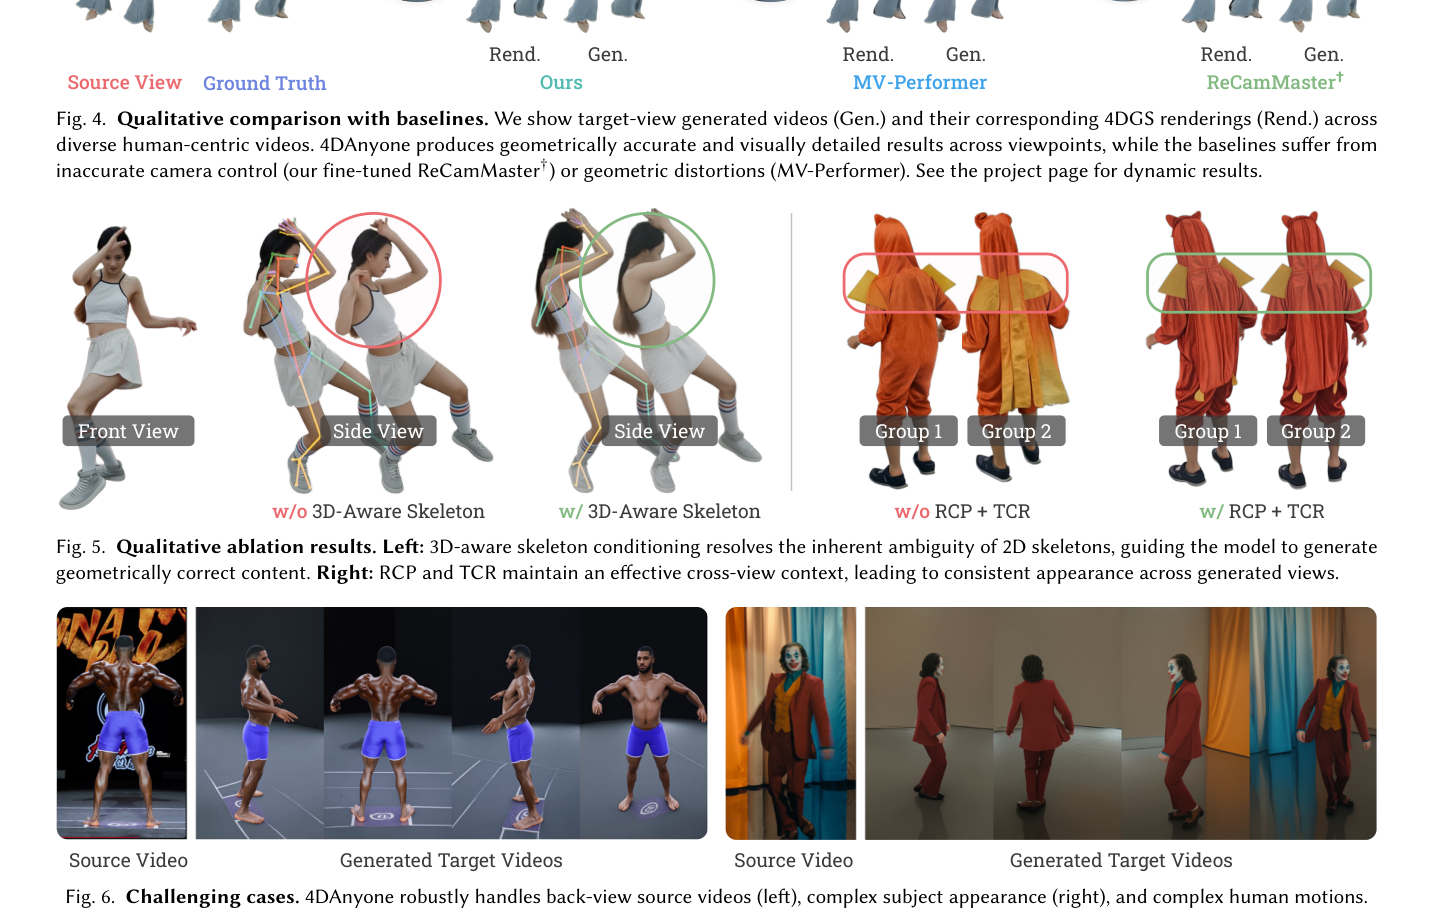
最强的结论是:多视角一致性的瓶颈不在扩散模型本身,而在上下文管理策略。RCP和TCR的组合让单目视频到4D人物的生成-重建管线第一次真正跑通,在背视源视频、复杂外观和复杂动作上都表现稳健。但必须诚实地说,大型流动织物如裙摆的骨架引导不足,HMR姿态估计错误也会被所有视角继承。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 主实验在 DNA-Rendering 的 10 个测试场景和 DyMVHumans 的 3 个场景上进行,评估三个维度:4DGS 重建质量、生成视频一致性、生成视频重建质量。
- 对比基线包括 MV-Performer、TrajectoryCrafter 和 ReCamMaster†。其中 ReCamMaster† 是作者用相同协议和数据集微调的版本,非原始发布权重;MV-Performer 和 TrajectoryCrafter 为零样本评估。
- 消融实验在 DNA-Rendering 的 8 个挑战序列上进行,分别移除 RCP、TCR、routing 策略和 3D-aware skeleton conditioning,评估生成视频一致性。
- TCR switching-time sweep 实验扫描滑动去噪步数,寻找高噪声阶段与低噪声阶段的最佳切换点。
- 在 in-the-wild 视频上测试泛化能力,包括背视源视频、复杂外观和复杂动作等挑战案例。
关键结果与论文证据
- 在 DNA-Rendering 的 4DGS Reconstruction 上,4DAnyone 达到 PSNR 24.15、SSIM 0.863、LPIPS 0.159,优于 ReCamMaster† 的 20.55/0.807/0.214(第 7 页)。
- 在 DNA-Rendering 的 Gen. Video Consistency 上,4DAnyone 达到 PSNR 24.33、SSIM 0.862、LPIPS 0.163,优于 ReCamMaster† 的 21.47/0.806/0.210(第 7 页)。
- 在 DyMVHumans 的 4DGS Reconstruction 上,4DAnyone 达到 PSNR 23.28、SSIM 0.846、LPIPS 0.117,优于 ReCamMaster† 的 19.86/0.795/0.159(第 7 页)。
- 消融实验显示,完整模型(Sliding 策略)的 PSNR 22.63/SSIM 0.796/LPIPS 0.191,优于移除 TCR 和 RCP 后的 21.09/0.766/0.216(第 7 页),证明两个机制对一致性有实质贡献。
- TCR switching-time sweep 表明,当 ts/T=0.20(16 个滑动去噪步骤)时,PSNR 22.6294/SSIM 0.7963/LPIPS 0.1906 达到最优(第 14 页),说明高噪声阶段的轮换分组对全局结构传播至关重要。
- 定性结果显示,4DAnyone 在背视源视频、复杂外观和复杂动作等挑战案例中表现稳健,而 ReCamMaster† 存在相机控制不准确,MV-Performer 存在几何失真(第 10 页)。
- 3D-aware skeleton conditioning 的定性消融显示,它解决了 2D 骨架的前后遮挡歧义,引导模型生成几何正确的内容(第 10 页)。
- 失败案例分析显示,大型流动织物(如裙摆)的骨架引导信息不足,跨视角生成不一致;HMR 姿态估计错误(如芭蕾 en-pointe 被误估为平足)会被所有生成视角继承(第 16 页)。
阅读时需要注意
- 大型流动织物(如裙摆)的骨架引导信息不足,跨视角生成不一致,导致重建退化。
- HMR 姿态估计错误会被所有生成视角继承,系统无法在生成阶段纠正姿态错误。
- 整体管线依赖 HMR 估计的 3D 骨架质量,姿态估计失败时缺乏纠错机制。
- 主实验使用 20 步去噪,虽然论文提及可减少到 10 步而质量损失极小,但未在主要结果中采用。
关联工作
- ReCamMaster 是隐式相机条件视频生成基线,作者微调版本 ReCamMaster† 作为对比方法。
- TrajectoryCrafter 使用显式几何条件(深度扭曲)进行相机控制视频生成,作为对比基线。
- MV-Performer 是人类特定的显式几何条件新视角合成模型,作为对比基线。
- CAT4D 使用滑动窗口去噪进行多视角视频扩散,但跨窗口漂移在大视角数下持续存在。
- Diffuman4D 面向 4D 人体重建,但需要同步稀疏视角视频和已知相机参数。
- FramePack 的多尺度 patchify 压缩策略是 RCP 的灵感来源。
- FreeTimeGS 用于从生成的多视角视频重建 4DGS 模型。
- GVHMR 用于从单目视频估计地面对齐 SMPL-X 网格序列。
- Wan2.2-TI2V-5B 是 4DAnyone 的基础 DiT 视频扩散模型。