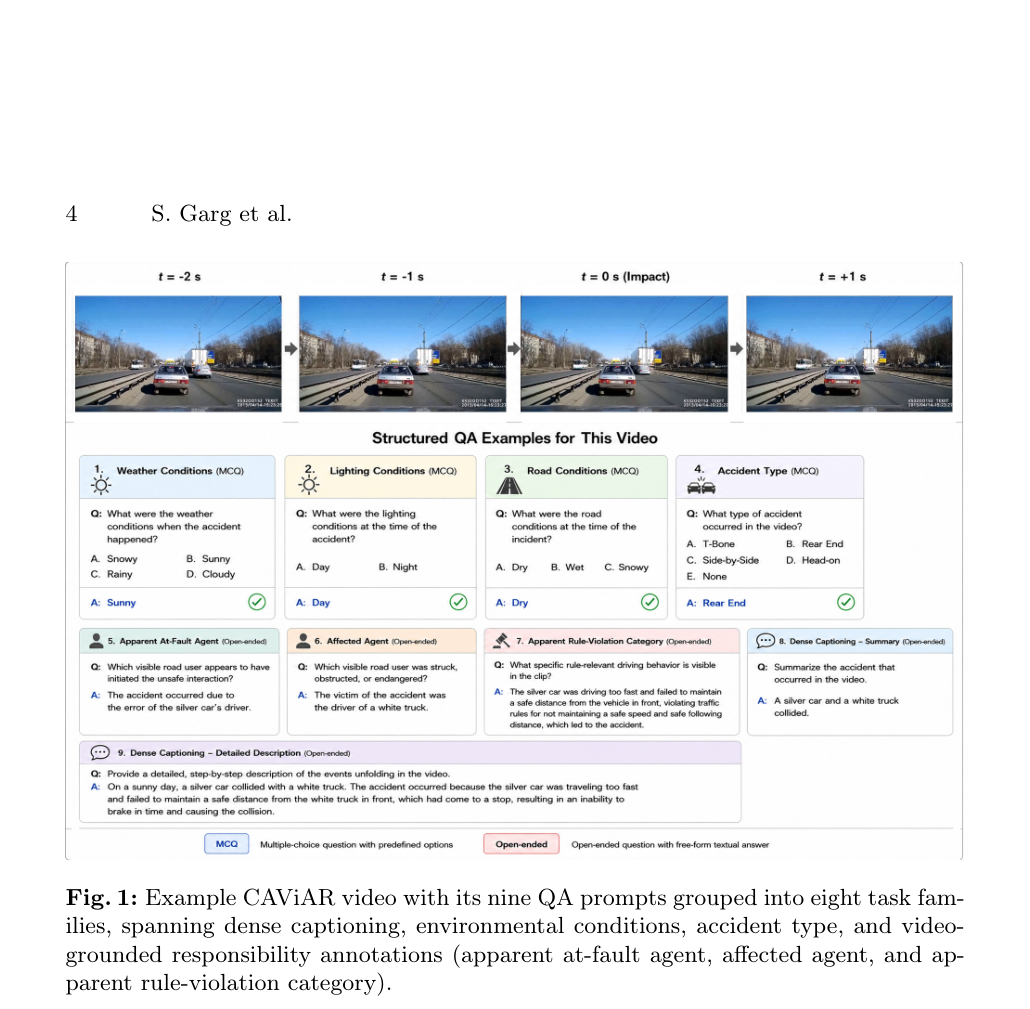
快速导读:CAViAR 是一个基于 CCD 和 Nexar 的 2,249 段真实行车记录仪事故视频基准,提供事故责任归因与交通规则违反的结构化标注,用于揭示 VLM 的感知-推理差距。
CAViAR 是一个面向真实场景细粒度事故推理的因果视频数据集,由 CCD 的 1,500 段训练视频和 Nexar 的 749 段测试视频构成,共产生 20,108 个 QA 对。与以往事故视频基准不同,CAViAR 首次为每段视频提供结构化的表面过错方(Apparent At-Fault Agent)、受害方(Affected Agent)和表面规则违反类别(Apparent Rule-Violation Category)标注,使模型不仅需要识别事故,还需要解释事故的责任结构。
论文的核心论点是:现代视觉语言模型在感知任务上表现优异,但在将视觉证据映射到规则相关的责任类别时存在系统性的感知-推理差距(Perception–Reasoning Gap)。这一差距无法通过简单的 LoRA 监督微调弥合,且在同源数据上依然存在,说明问题不在于域偏移,而在于模型缺乏因果推理能力。
英文题目:CAViAR: A Causal Video Dataset for Fine-Grained Accident Reasoning in Real-World Scenarios
论文出处:arXiv 每日论文精选 · arXiv:2608.19380
原始论文:PDF / 论文页面
这篇论文解决什么问题?
自动驾驶系统的安全部署要求模型不仅能检测目标、预测轨迹,还能理解事故的因果关系并判断可见责任方。然而,现有事故视频基准(如 CCD、Nexar、DoTA、DADA-2000、SUTD-TrafficQA、MM-AU、VRU-Accident)主要覆盖检测、时间定位、粗粒度分类或场景理解,缺乏统一的结构化责任归因与规则违反监督。
这种监督缺失导致了一个关键问题:我们无法区分模型是在真正理解事故因果,还是仅仅利用了类别先验。例如,一个模型可能因为 Rear-End 在训练集中占比最高而将所有事故都预测为追尾,却从未真正识别出侧碰或对撞的视觉证据。
CAViAR 的设计目标正是填补这一空白:通过提供过错方、受害方和规则违反类别的结构化标注,使研究者能够直接测量模型的责任推理能力,并将其与感知能力进行对比。
核心创新
- 首个提供结构化过错方、受害方和规则违反类别监督的事故视频基准
- 构建与司法辖区无关的十一类可观察规则违反本体及确定性映射协议
- 通过 CCD/Nexar 异源划分实现构造性无泄漏评估
- 系统量化感知-推理差距:感知任务与责任推理任务在同一视频上的表现分离
方法概览
CAViAR 复用 CCD(1,500 段训练)和 Nexar(749 段测试)构建无泄漏划分;四人团队完成主标注加审核,采用与司法辖区无关的十一类规则本体;GPT-4 仅做语言润色不改事实;每段视频映射到 9 个 QA 提示、8 个任务族,共 20,108 个 QA 对。
- 数据来源与划分:CAViAR 复用 CCD 的 1,500 段视频作为训练集,Nexar 的 749 段视频作为测试集。这种异源划分实现了构造性的无泄漏评估,确保测试集视频从未出现在任何训练过程中。
- 标注协议:四人团队完成主标注加审核流程。标注者需要为每段视频确定表面过错方、受害方和表面规则违反类别。标注基于视频中可见的行为证据,而非法律判定,因此使用"表面"(apparent)一词强调其研究性质。
- 规则本体:CAViAR 构建了一个与司法辖区无关的十一类规则违反本体,涵盖可观察的规则相关驾驶行为家族。这一设计避免了依赖特定国家或地区的交通法规,使数据集具有跨辖区的适用性。
- 确定性映射:规则违反家族映射使用确定性词典,63% 的答案触发多家族,需要固定优先级消解。这一设计保证了标注的可复现性,但也引入了优先级选择的主观性。
- 任务结构:每段视频映射到 9 个 QA 提示,分为 8 个任务族,包括稠密描述、环境条件、事故类型、表面过错方、受害方和规则违反类别等。
- GPT-4 仅用于语言润色,不改变事实内容,确保标注的语义准确性不受模型幻觉影响。
- LoRA SFT 设置:微调时冻结视觉编码器,仅适配语言模型的注意力和 MLP 投影层,以控制计算成本并隔离视觉表示的影响。
逐图理解论文
一个具体的失败案例
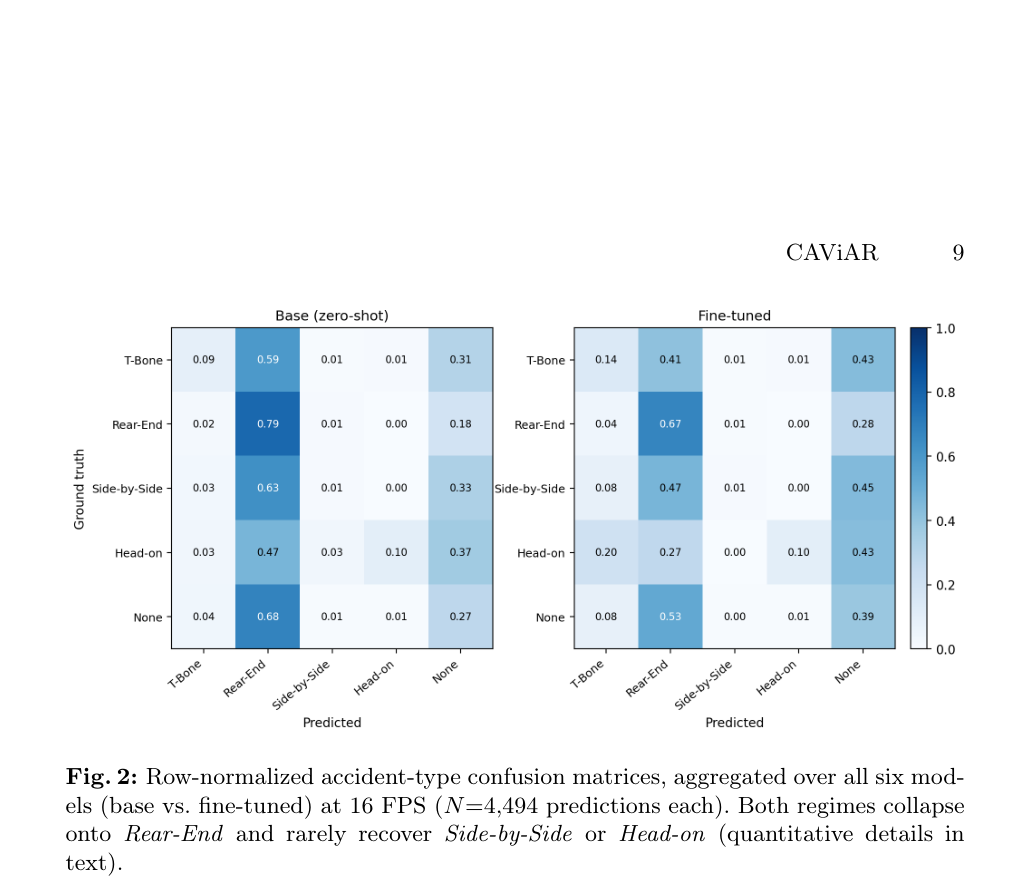
混淆矩阵揭示了事故类型预测的类别先验坍缩:所有模型都将预测集中在 Rear-End,Side-by-Side 和 Head-on 几乎无法恢复。这是感知-推理差距最直观的证据。
研究空白
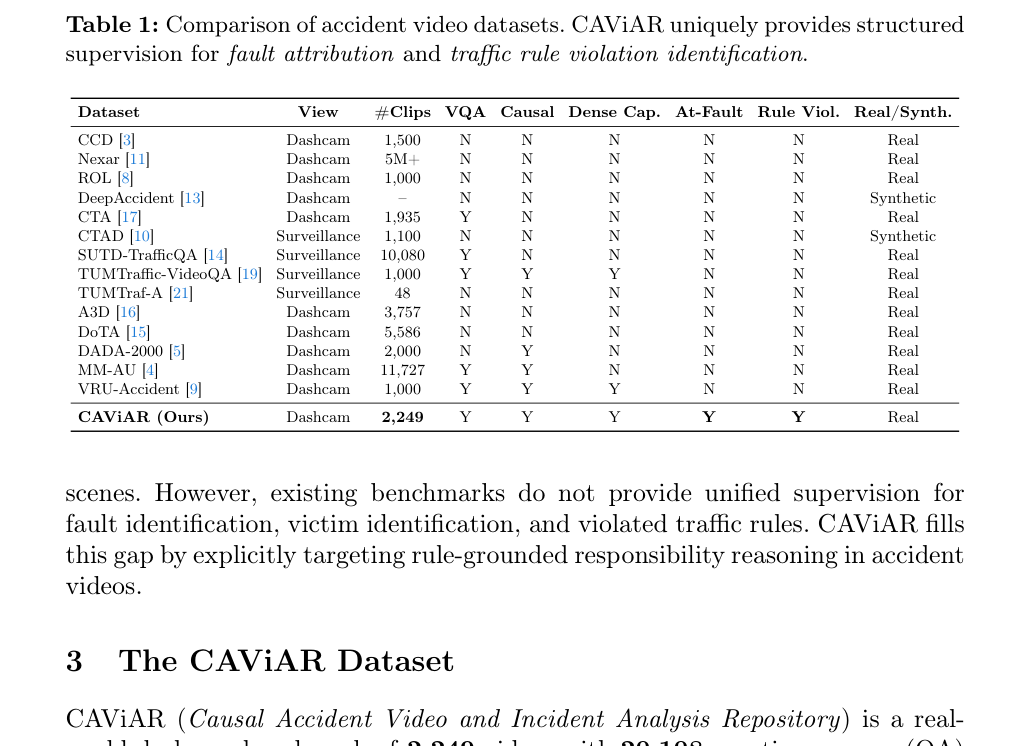
这张表对比了 CAViAR 与现有事故视频数据集的关键差异。重点观察最后几列:CAViAR 是唯一提供过错方归因和规则违反识别结构化监督的数据集,这是理解其核心贡献的起点。
CAViAR 的贡献与验证
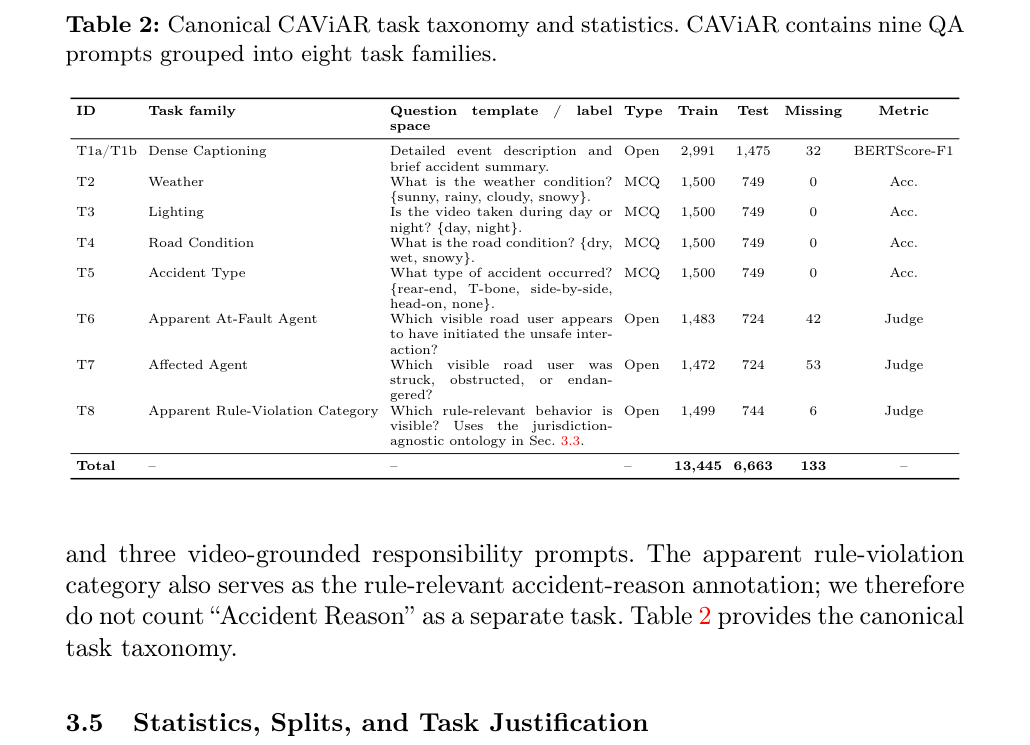
CAViAR 填补了这个空白。它复用 CCD 的一千五百段视频做训练,Nexar 的七百四十九段做测试,构造了无泄漏的异源划分。四人团队为每段视频标注表面过错方、受害方和规则违反类别,采用与司法辖区无关的十一类规则本体。每段视频映射到九个问答提示,共两万多个 QA 对。
感知-推理差距的证据
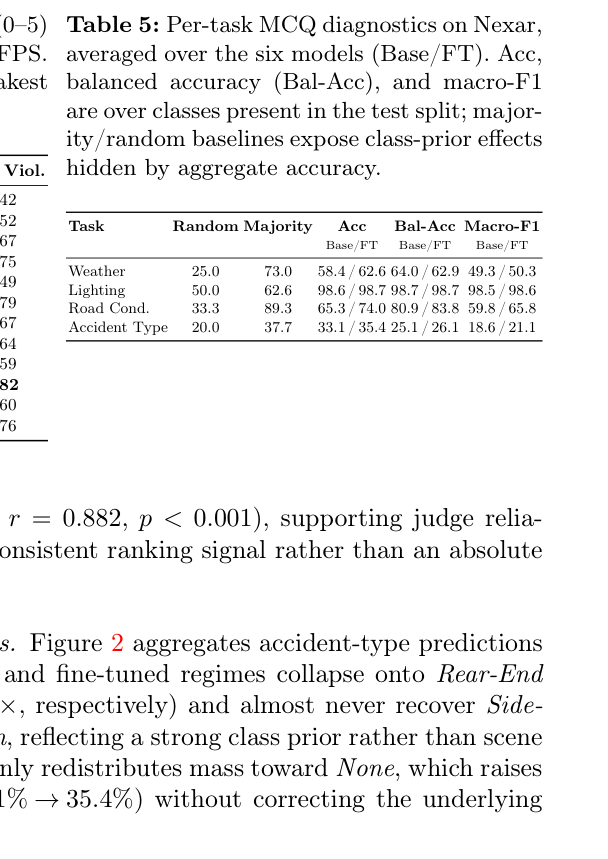
逐任务诊断表揭示了聚合准确率的误导性:Lighting 接近解决,但 Weather 和 Accident Type 低于多数类基线。应结合 balanced accuracy 和 macro-F1 解读。
结论与局限
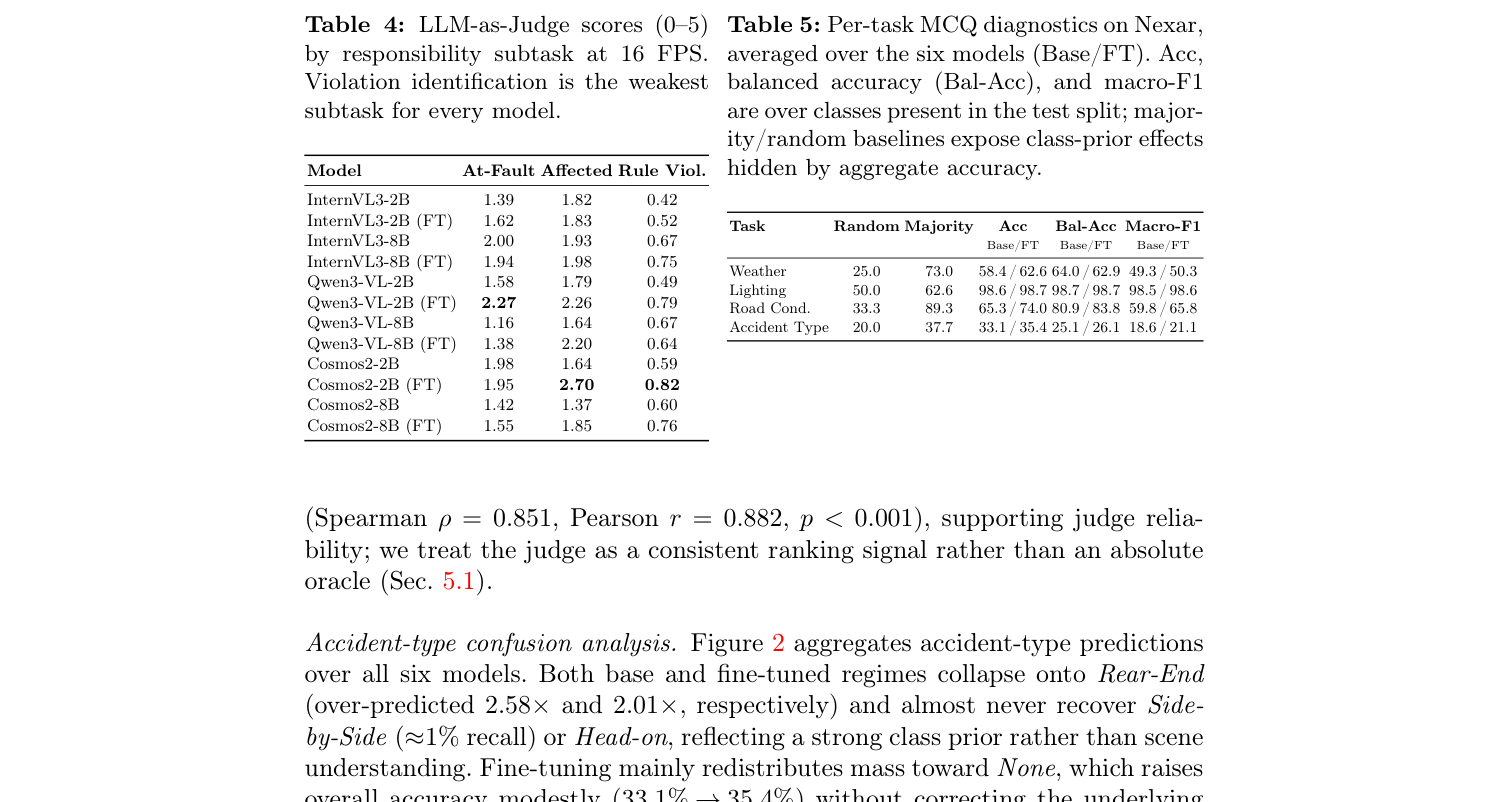
该表按责任子任务分解 LLM-as-Judge 分数。Rule Violation 是所有模型最弱的子任务,说明模型即使能识别过错方,也无法准确判断规则违反类别。
实验如何设计?
- 在 Nexar 测试集上评估 Cosmos-Reason2、Qwen3-VL、InternVL3 的 2B 和 8B 模型,对比零样本与 LoRA 微调两种设置。
- 报告三类指标:MCQ 准确率、BERTScore-F1 和 GPT-4o LLM-as-Judge(0-5 分制)。MCQ 衡量分类能力,BERTScore 和 LLM-as-Judge 衡量开放回答的语义质量。
- 事故类型混淆矩阵分析用于揭示类别先验坍缩现象,聚合所有六个模型在 16 FPS 下的 4,494 次预测。
- CCD 同源留出消融(1,200 训练/300 测试)用于隔离域偏移的影响,判断低分是否源于 CCD→Nexar 的分布差异。
- 规则违反家族分布与逐家族难度分析使用 TVD 和 JSD 量化训练测试标签偏移。
- GPT-4o Judge 与人类评分的一致性通过 Spearman 和 Pearson 相关系数验证(N=45)。
关键结果与论文证据
- InternVL3-8B Base 取得最高聚合 MCQ 准确率 69.06%,微调后为 68.83%(∆=-0.23),说明微调并未带来聚合层面的提升(第 8 页)。
- Qwen3-VL-2B 微调后 BERTScore-F1 从 20.07 提升至 45.36(∆=+25.29),为最大提升,但绝对分数仍然很低(第 8 页)。
- 最佳 At-Fault Judge 分数为 Qwen3-VL-2B (FT) 的 2.27/5.0;最佳 Rule Violation 分数为 Cosmos2-2B (FT) 的 0.82/5.0,表明规则违反识别是所有模型最弱的子任务(第 10 页)。
- Lighting 任务准确率 98.6-98.7%,接近解决;Weather 准确率 58.4-62.6%,低于多数类基线 73.0%,说明模型在环境感知上存在类别先验依赖(第 10 页)。
- Accident Type 准确率 33.1-35.4%,接近多数类基线 37.7%;Side-by-Side 召回率约 1%,混淆矩阵显示所有模型坍缩到 Rear-End(第 10 页)。
- CCD 同源留出实验中 MCQ 准确率 62.17-67.92%,BERTScore-F1 31.12-39.60%,与跨域结果同区间,证明低分并非域偏移所致(第 13 页)。
- Accident Type 域偏移最大(TVD=0.362,JSD=0.161 bits),多数类从 T-Bone 翻转为 None,但同源消融表明这不能解释推理任务的低分(第 13 页)。
- GPT-4o Judge 与人类评分 Spearman ρ=0.851,Pearson r=0.882(N=45),验证了 LLM-as-Judge 作为评估代理的可靠性(第 10 页)。
阅读时需要注意
- 未报告正式标注者间一致性,仅采用主标注加审核协议,标注质量的可重复性有待验证。
- BERTScore 和 LLM-as-Judge 是责任内容的不完美代理指标,可能无法完全捕捉责任归因的语义正确性。
- 未报告人类基线表现,无法校准任务的难度上限,难以判断模型与人类之间的绝对差距。
- 仅覆盖开源 VLM,未评估大型专有或推理调优系统,结论的普适性受限。
- 事故类型预测偏差未通过显著性分析归因到具体视觉证据,无法确定模型失败的确切原因。
- 8B 模型微调增益在 bootstrap 95% CI 半宽内(±1.7 MCQ 点),应视为边际效应而非实质性提升。
关联工作
- CCD 是 CAViAR 的训练数据来源,提供 1,500 段真实事故/近事故视频,但缺乏责任标注。CAViAR 在 CCD 的基础上增加了结构化监督,使其从感知基准升级为因果推理基准。
- Nexar 是 CAViAR 的测试数据来源,提供多城市自然驾驶碰撞片段,但无结构化 QA。CAViAR 为 Nexar 视频补充了完整的责任归因标注。
- DoTA 和 DADA-2000 分别关注事故检测与时间定位、事故预测,但均未提供过错方和规则违反标注。CAViAR 填补了这一空白。
- SUTD-TrafficQA、MM-AU 和 VRU-Accident 覆盖交通 VideoQA 或因果推理,但缺乏规则违反的结构化监督,CAViAR 的十一类规则本体是独特的贡献。