快速导读:DAV4将Riemannian Flow Matching应用于4D Gaussian Splatting参数的非欧几里得流形,从单目视频实现动态4D场景重建,并通过受控实验隔离出RFM相对确定性MLP基线的+0.044 F-score增益。
Depth Anything V4(DAV4)将Riemannian Flow Matching(RFM)应用于4D Gaussian Splatting(4DGS)参数的非欧几里得流形,从单目视频实现动态4D场景重建。与Depth Anything V1–V3的判别式回归范式不同,DAV4转向概率式生成建模,直接在高斯参数的黎曼流形上定义概率路径,保证所有中间采样状态都是有效的4DGS参数。
论文的核心贡献不在于提出一个更大的网络,而在于通过受控实验证明:在正确的几何空间(流形)上做生成建模,本身就能带来可测量的重建质量提升。这一方法论贡献通过严格的消融实验得到支撑,为动态场景重建领域提供了新的研究基线。
英文题目:Depth Anything V4: Dynamic 4D Scene Reconstruction via Riemannian Flow Matching on 4D Gaussian Splatting
论文出处:arXiv 每日论文精选 ·
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Depth Anything系列以38ms的前馈速度在单目深度估计领域占据领先地位,但V1到V3均采用判别式回归范式,输出点估计且缺乏时序建模能力。对于动态场景,这种范式无法捕捉视频帧之间的时间依赖关系,也无法提供不确定性估计。
4D Gaussian Splatting将3D高斯扩展到时间维度,其参数(尺度、旋转四元数、不透明度)天然位于非欧几里得流形上。在欧几里得空间中对这些参数做线性插值会产生无效值,例如负尺度或非单位四元数,需要后处理投影来修正。这种投影不仅引入计算开销,还破坏了概率路径的几何一致性。
Flow Matching及其黎曼推广(Tong et al., 2024)提供了免仿真的连续归一化流训练范式,但尚未被应用于4DGS参数流形。DAV4填补了这一空白,将RFM的概率路径直接定义在尺度、旋转、不透明度各自的流形上。
论文的核心研究问题是:在4DGS参数流形上做黎曼流匹配,相比在欧几里得空间做流匹配再加投影,能否带来可测量的重建质量提升?这一问题的答案需要通过受控实验来隔离RFM的独立贡献。
核心创新
- 首次将Riemannian Flow Matching应用于4D Gaussian Splatting参数,在尺度、旋转、不透明度各自的流形上直接定义概率路径,保证所有中间状态有效
- 通过受控实验(相同数据、架构、TTO协议)将RFM的贡献从预训练和测试时优化中隔离出来,RFM单独贡献+0.044 F-score
- 以视频时间τ为条件建模时序动态,而非时间平均的静态先验
- 通过多假设ODE采样实现不确定性量化,用NGLL和ECE评估校准质量
方法概览
用冻结DINOv2-L骨干和Perceiver模块提取视频帧特征,生成latent tokens;Riemannian Flow Matching先验在4DGS参数流形上建模以流时间t和视频时间τ为条件的概率路径;ODE求解器以粗到细方式采样高斯集合,再用20步测试时优化(TTO)以渲染损失细化。教师模型为自监督4DGS Head,使用渲染损失、SE(3)等变性、RAFT光流一致性和DA2中值深度尺度正则化训练,不使用人工标注深度标签。
- DAV4使用冻结的DINOv2-L骨干网络和Perceiver模块提取视频帧特征,生成latent tokens。Perceiver将变长集合映射为固定大小的token,为后续的流匹配先验提供条件输入。
- Riemannian Flow Matching先验在4DGS参数流形上建模概率路径,以流时间t和视频时间τ为条件。流时间t控制ODE采样过程,视频时间τ编码时序动态信息,使模型能够生成随时间变化的场景表示。
- ODE求解器以粗到细方式采样高斯集合:粗阶段捕捉全局布局,细阶段细化细节。这种策略在计算效率和重建质量之间取得平衡。
- 采样结果经过20步测试时优化(TTO),使用渲染损失对高斯参数做梯度细化。TTO在推理阶段利用渲染梯度修正采样结果,进一步提升重建质量。
- 教师模型为自监督4DGS Head,使用渲染损失、SE(3)等变性、RAFT光流一致性和DA2中值深度尺度正则化训练。论文声称不使用人工标注深度标签作为训练损失,但DA2中值深度作为尺度正则化属于弱监督信号。
- 多假设ODE采样通过从不同噪声初始化运行多条ODE轨迹来估计方差,实现不确定性量化。这一机制使DAV4能够输出校准良好的置信度估计,而非单一的点估计。
逐图理解论文
失败案例:欧几里得插值的代价
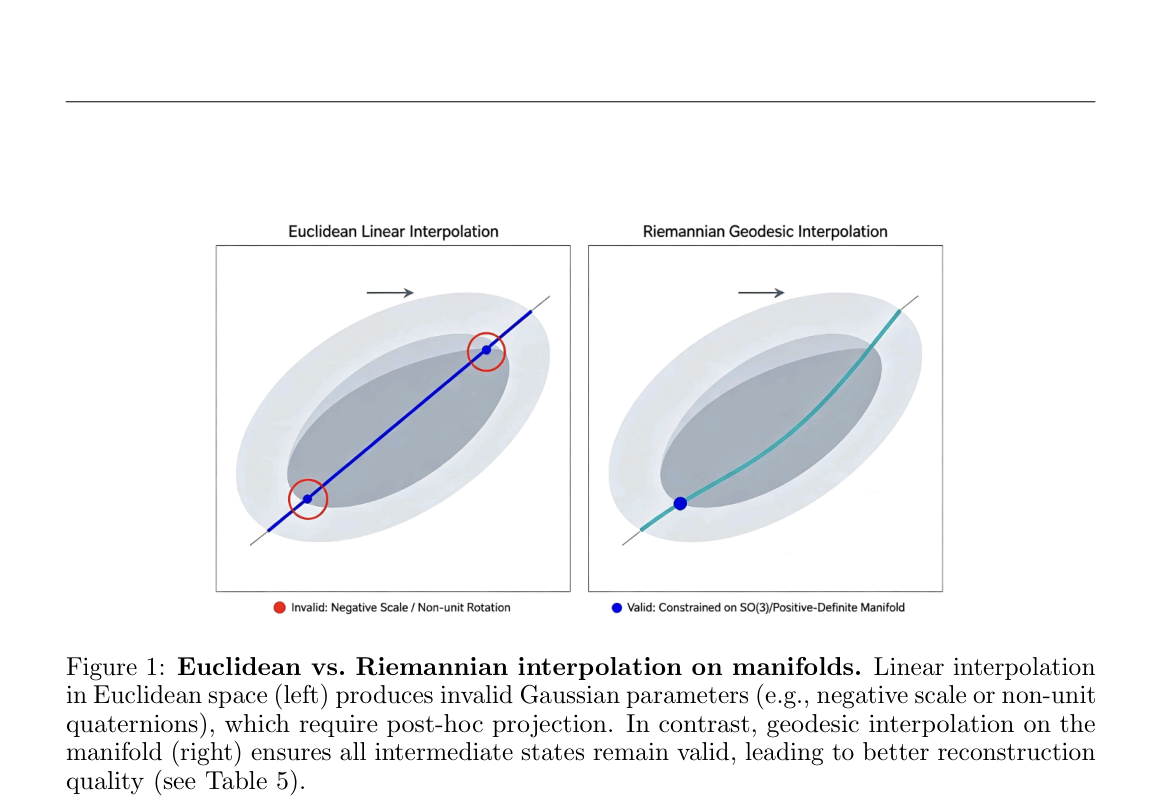
该图对比了欧几里得空间线性插值与黎曼流形测地线插值的效果。左侧欧几里得插值产生无效高斯参数(负尺度或非单位四元数),需要后处理投影;右侧测地线插值保证所有中间状态有效。这一对比直接支撑了论文的核心论点:几何空间的选择决定了参数有效性。
研究空白:几何空间被忽视
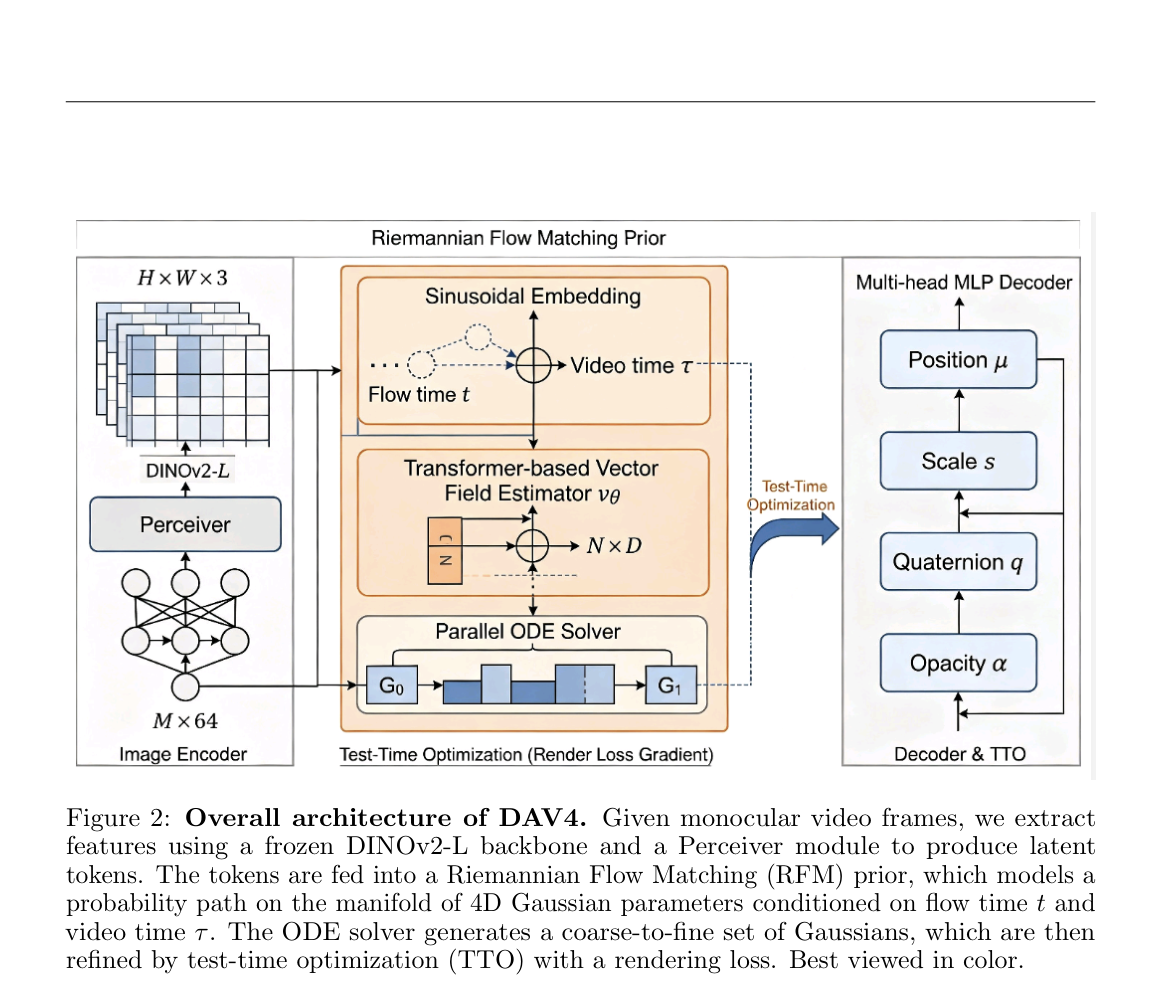
该图展示了DAV4的完整架构流程:从单目视频帧经DINOv2-L和Perceiver提取特征,到RFM先验建模概率路径,再到ODE求解器粗到细采样,最后经TTO细化。理解这一流程的关键在于RFM先验同时以流时间t和视频时间τ为条件,这是DAV4区别于静态先验的核心设计。
最强结论:几何正确性本身就有价值
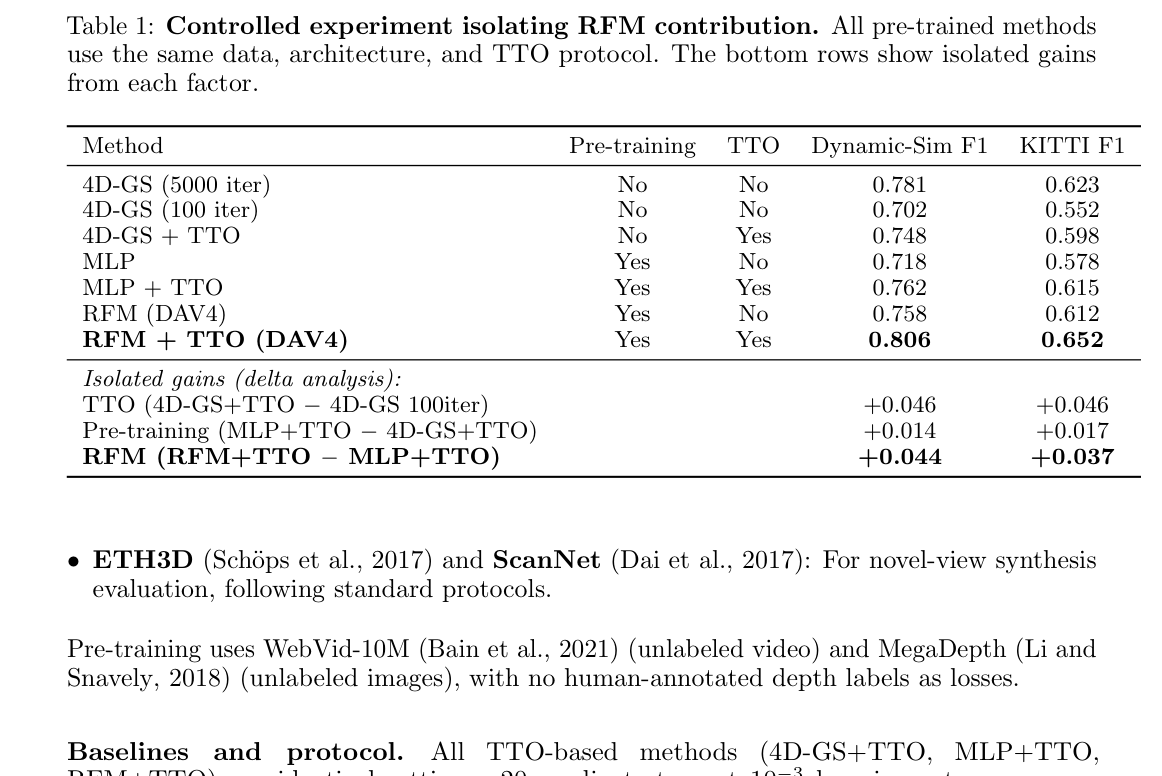
该表是论文最重要的受控实验,通过六种配置的对比隔离出TTO、预训练和RFM各自的贡献。重点观察RFM+TTO相对MLP+TTO的增益(+0.044),这是RFM独立于预训练和TTO的净贡献,是论文核心论点的直接证据。
实验如何设计?
- 受控实验在Dynamic-Sim和KITTI Dynamic数据集上进行,比较4D-GS、4D-GS+TTO、MLP、MLP+TTO、RFM、RFM+TTO六种配置,以隔离TTO、预训练和RFM各因素的独立贡献。
- 新视角合成实验在ETH3D和ScanNet上与3D-GS对比,3D-GS使用20步TTO和5000迭代全优化两种配置。DAV4使用预训练初始化,3D-GS使用随机初始化,这一初始化偏差在论文中被作者承认。
- 时间条件消融实验移除视频时间τ,比较F-score和时序一致性(TC)的变化,以验证时序建模的必要性。
- 不确定性校准实验与MC-Dropout和Ensemble方法对比,使用NGLL和ECE指标评估校准质量。
- 欧几里得vs黎曼流匹配实验比较F-score和无效高斯百分比,直接验证流形选择的几何影响。
- 计算成本分析报告预训练360 GPU-hours,并按场景数N进行摊销,比较DAV4与4D-GS全优化的推理效率。
关键结果与论文证据
- RFM+TTO在Dynamic-Sim上F-score为0.806,较MLP+TTO的0.762提升+0.044;KITTI Dynamic上为0.652 vs 0.615,提升+0.037(Table 1, p.5)。这一增益是RFM相对确定性MLP基线的独立贡献。
- TTO单独贡献+0.046(4D-GS 100 iter 0.702 → 4D-GS+TTO 0.748),预训练贡献+0.014(4D-GS+TTO 0.748 → MLP+TTO 0.762)(Table 1, p.5)。RFM的贡献大于预训练,但小于TTO。
- ETH3D上DAV4 PSNR为25.13 dB,超过3D-GS 20步TTO的22.34 dB(+2.79 dB)和全优化3D-GS的24.12 dB;ScanNet上为23.82 dB vs 21.58 dB(+2.24 dB)(Table 2, p.6)。
- 时间条件消融:有τ时F-score为0.806、TC为0.92;无τ时F-score降至0.742、TC降至0.78(Table 3, p.7)。视频时间条件对时序一致性至关重要。
- 不确定性校准:DAV4 NGLL为−1.58、ECE为0.058;MC-Dropout NGLL为−0.82、ECE为0.18;Ensemble NGLL为−1.15、ECE为0.12(Table 4, p.8)。DAV4的校准质量显著优于基线。
- 欧几里得FM+投影F-score为0.684、无效高斯12.3%;黎曼FM F-score为0.806、无效高斯仅0.01%(Table 5, p.8)。流形选择直接决定了参数有效性和重建质量。
- DAV4单场景推理420ms,为DA3的38ms的11倍;N=10,000场景时摊销成本约550ms,优于4D-GS全优化的2100ms(Table 6, p.9)。
- Figure 4(p.8)显示DAV4在20步TTO内达到高F-score,而per-scene 4D-GS需要超过500次迭代才能达到类似性能,证明了学习到的黎曼先验的收敛优势。
阅读时需要注意
- 420ms推理时间不适合实时机器人或自动驾驶应用,相比DA3的38ms有显著差距。
- 预训练需360 GPU-hours,计算资源需求高,限制了方法的可复现性和广泛采用。
- NVS对比中3D-GS用随机初始化而DAV4用预训练初始化,存在固有初始化偏差,作者已在论文中承认。
- 渲染梯度不是保守向量场,TTO引导缺乏严格的基于能量的解释,理论根基尚不完整。
- 表6中N=1000时DAV4摊销成本1716ms高于4D-GS+TTO的420ms,仅在N>10,000时才有成本优势,实际部署需极大规模。
关联工作
- Depth Anything V1–V3(Yang et al., 2024a;b; 2025)是DAV4的前作,从半监督到合成数据精化到多视图几何推理,均为判别式回归范式。DAV4的转向标志着该系列从点估计向概率式4D重建的范式转变。
- 3D Gaussian Splatting(Kerbl et al., 2023)是基础表示,DAV4在其参数流形上定义RFM。4D Gaussian Splatting(Wu et al., 2024)提供S(x,τ)=S3D(x)⊕∆ϕ(x,τ)的表示公式,DAV4采用这一公式。
- Flow Matching(Lipman et al., 2023)和Riemannian Flow Matching(Tong et al., 2024)是DAV4的生成建模理论基础。RFM将Flow Matching推广到黎曼流形,使概率路径可以直接定义在非欧几里得空间上。
- Deformable-GS(Lin et al., 2024)和Dynamic 3DGS(Yang et al., 2024c)是替代的动态高斯表示方案,DAV4选择4D-GS公式作为其表示基础。
- RAFT(Teed and Deng, 2020)用于教师训练中光流一致性损失,以消解时序动态歧义。DINOv2(Oquab et al., 2024)作为冻结骨干网络,提供密集预测的语义特征。
- MC-Dropout(Gal and Ghahramani, 2016)和Ensemble(Lakshminarayanan et al., 2017)是不确定性量化对比基线,DAV4的多假设采样在NGLL和ECE上均优于这两种方法。