快速导读:STEP 通过将姿态序列投影到白化 PCA 空间并结合置信度加权,解决了去噪分数匹配在原始关节坐标上的结构坍塌问题,在 UBnormal 上以 90.1% AUROC 刷新骨架 VAD 纪录。
骨架视频异常检测通常采用单类分类范式:只用正常数据训练,测试时把偏离正常流形的样本判为异常。近期方法用 Denoising Score Matching(DSM)训练 Energy-Based Model(EBM),以样本能量作为异常分数。STEP 的核心主张是:直接在原始关节坐标上做 DSM 会破坏人体运动学结构,产生物理不可能的姿势,并且这种结构坍塌会随时序窗口扩大而急剧恶化。
STEP 的解决方案分两步:先把姿态序列投影到白化 PCA 空间,让注入的高斯噪声对应语义合理的动作变化;再引入序列级置信度加权,在训练和测试中按姿态估计器的平均置信度缩放,抑制跟踪噪声。配合 σ-modulated Residual MLP 架构,STEP 在 UBnormal 上刷新纪录,并在 ShanghaiTech 上与 STG-NF 持平。
英文题目:STEP: Score-Based Temporal Energy for Human Pose Video Anomaly Detection
论文出处:arXiv 每日论文精选 · arXiv:2608.19987
原始论文:PDF / 论文页面
这篇论文解决什么问题?
MULDE 首次把 DSM 引入视频异常检测,在原始关节坐标上估计能量。但 STEP 的消融揭示了一个此前未被注意的现象:MULDE 基线在 T=1 时达到 80.6% AUROC,已经超过 SeeKer 的 77.9%;然而当时序窗口扩展到 T=32 时,性能骤降至 70.6%,下降约 10%。这说明原始坐标空间中的高维密度估计存在根本性困难。
结构坍塌的根源在于 DSM 的噪声注入方式。DSM 在输入上添加各向同性高斯噪声,再让网络预测噪声方向。在原始关节坐标中,这种噪声会独立扰动每个关节,产生骨骼长度扭曲、关节错位等物理不可能的姿势。随着时序窗口 T 扩大,输入维度线性增长,噪声对运动学结构的破坏被放大,模型学到的能量景观随之恶化。
第二个被忽视的问题是姿态估计器的不确定性。现有方法把姿态序列当作完美真值,但实际跟踪中存在遮挡、运动模糊和检测失败。STEP 的实验表明,仅在原始坐标上加入置信度加权,就能把 T=2 的性能从 80.7% 提升到 87.2%,说明 EBM 对噪声姿态极其敏感。但置信度加权无法阻止高维坍塌:T=32 时仍降至 73.1%。
核心创新
- PC-Space Density Estimation:将 DSM 从原始坐标空间迁移到白化 PCA 空间,使注入噪声对应语义合理的动作变化,解决结构坍塌
- Confidence-Aware Anomaly Scoring:在 DSM 训练目标和测试评分中引入序列级软置信度加权,抑制跟踪噪声对能量景观的扭曲
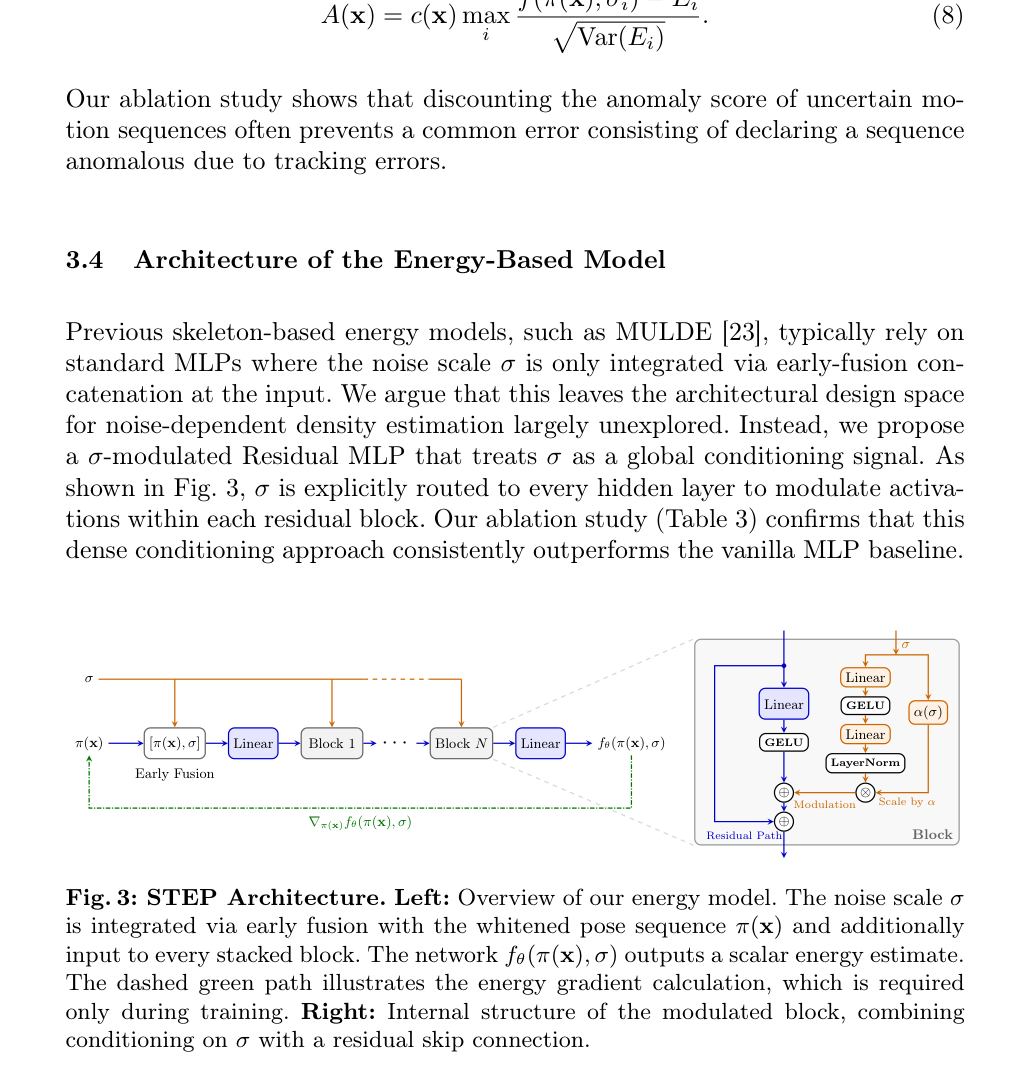
- σ-modulated Residual MLP:将噪声尺度 σ 作为全局条件信号路由到每个隐藏层进行调制,配合残差跳跃连接,优于传统 early-fusion MLP
方法概览
STEP 用 PCA 将姿态序列投影到紧凑的白化 PC 空间,在该空间内用 DSM 训练 EBM 估计能量;引入序列级置信度加权机制,在训练损失和测试评分中按姿态估计器平均置信度 c(x) 缩放;采用 σ-modulated Residual MLP 架构,将噪声尺度 σ 通过 early fusion 和逐层调制注入每个残差块。测试时对多尺度能量估计进行标准化后取最大值,再乘以置信度得到最终异常分数。
- PCA 投影:STEP 用 PCA 把姿态序列投影到紧凑的白化 PC 空间。白化通过特征值缩放使各维度方差归一为各向同性,这样注入的高斯噪声在各维度上具有一致的尺度意义。论文图 2 显示,沿前两个主成分移动静态姿态,PC1 对应横向行走,PC2 对应朝向或远离相机行走,说明 PC 空间中的扰动对应语义合理的动作变化。
- 置信度加权:STEP 引入序列级软置信度加权,在 DSM 训练损失和测试评分中按姿态估计器平均置信度 c(x) 缩放。与硬阈值过滤不同,软加权保留所有样本但降低低置信度样本的影响,避免丢弃训练数据。消融显示硬过滤 conf<0.4 在 UBnormal 上下降 4.5%,证明软加权更优。
- σ-modulated Residual MLP:网络 fθ(π(x), σ) 接收白化姿态序列和噪声尺度 σ,输出标量能量。σ 通过 early fusion 与姿态序列拼接,同时作为全局条件信号注入每个残差块进行逐层调制。残差跳跃连接帮助梯度流动。消融显示用 Vanilla MLP 替代该架构在 UBnormal 上下降 1.1%。
- 多尺度能量聚合:测试时对多个噪声尺度 σ 分别估计能量,标准化后取最大值(Agg-Max),再乘以置信度得到最终异常分数。Agg-Max 优于 Agg-Sum 和 Best Individual,因为不同异常在不同噪声尺度上最易区分。
- 训练目标:沿用 Vincent 的 DSM 公式,将分数匹配转化为可高效计算的去噪目标。网络学习预测注入噪声的方向,能量梯度仅在训练时需要计算(图 3 绿色虚线路径)。
逐图理解论文
一个具体的失败案例
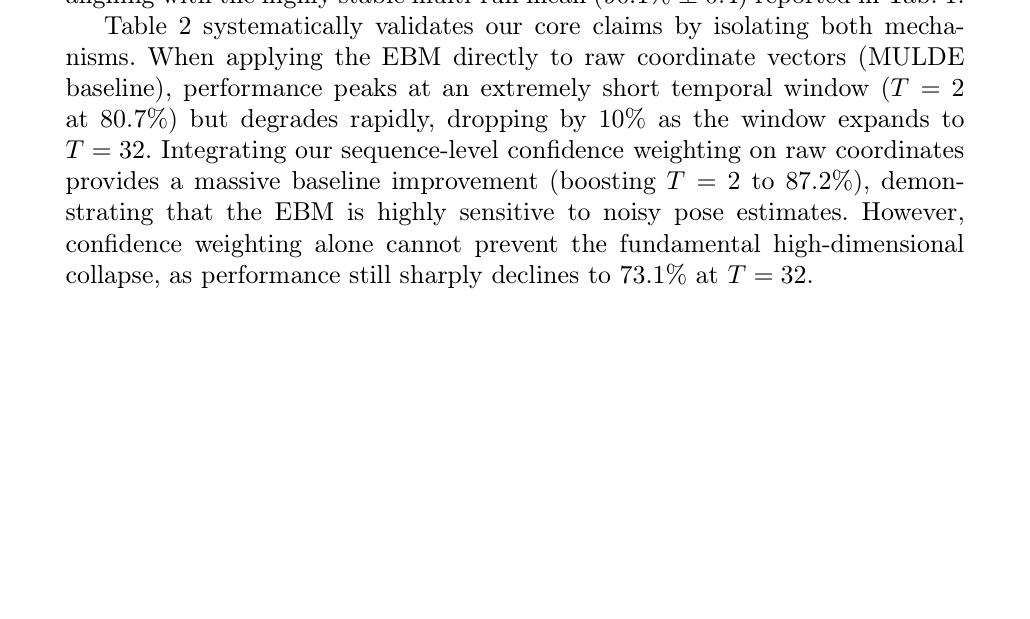
表 2 上半部分隔离两种机制:原始坐标加置信度加权在 T=2 时达 87.2%,但 T=32 时降至 73.1%,证明置信度加权无法阻止高维坍塌。
核心贡献:换一个空间做密度估计
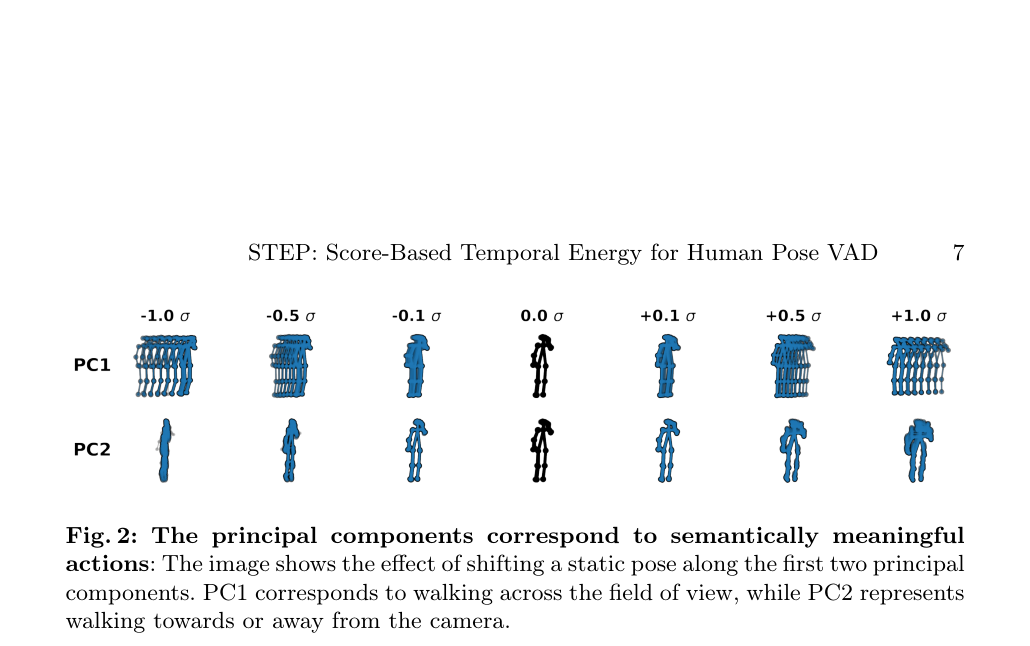
观察沿前两个主成分移动静态姿态的效果:PC1 对应横向行走,PC2 对应朝向或远离相机行走。这直接支持 STEP 的核心主张——PC 空间中的扰动对应语义合理的动作变化,而非物理不可能的姿势。
最强结论
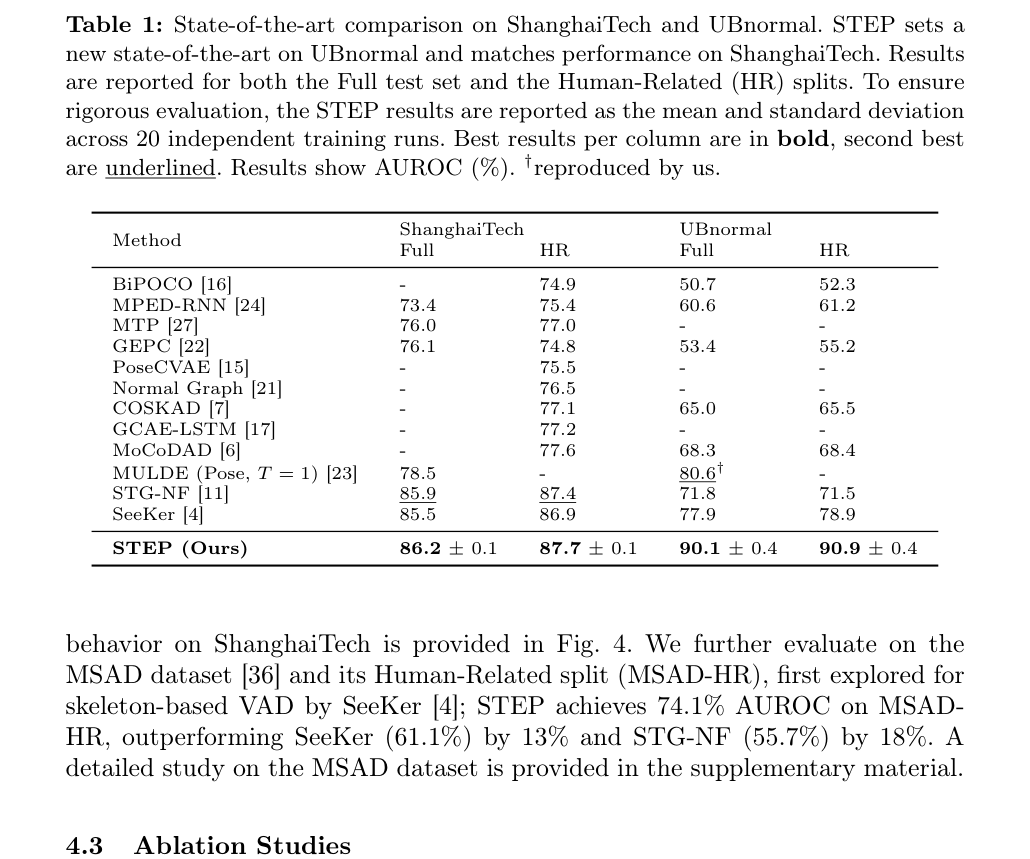
表 1 完整对比显示 STEP 在 UBnormal 上刷新纪录(90.1%),在 ShanghaiTech 上与 STG-NF 持平(86.2%)。20 次运行的标准差仅 ±0.1–0.4,结果稳定。
意义与局限
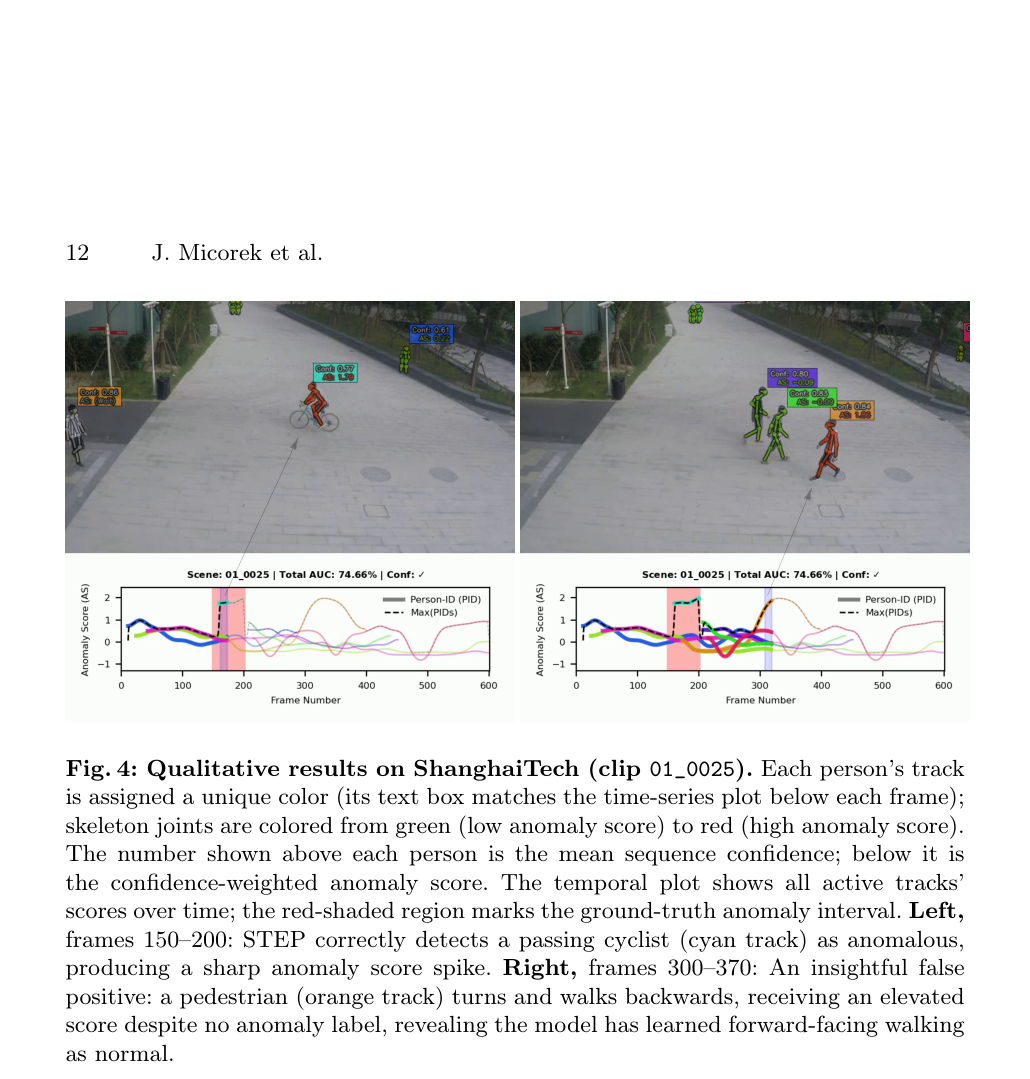
定性结果展示两个案例:左侧骑自行车者被正确检测为异常(青色轨迹分数尖峰);右侧倒走行人被误判为异常(橙色轨迹),揭示模型学到前向行走为正常的先验。
实验如何设计?
- 数据集:ShanghaiTech 和 UBnormal,报告 Full 和 Human-Related(HR)分割的 AUROC。UBnormal 是当前骨架 VAD 的标准基准,HR 分割仅含人类动作相关异常。
- 对比方法:与 12 种骨架 VAD 方法对比,包括 STG-NF、SeeKer、MULDE 等。MULDE 作为直接方法学基线,SeeKer 是 UBnormal 上前 SOTA(77.9%),STG-NF 是 ShanghaiTech 上前 SOTA(85.9%)。
- 姿态提取:使用 AlphaPose 提取 18 点骨架。STEP 结果基于 20 次独立训练运行的均值和标准差(±0.1–0.4),消融实验使用固定随机种子。
- 超参数:T=12、K=48 基于 UBnormal 验证集选择。消融覆盖 T=1–32、K=16–128 的组合,以及噪声边界 σlow/σhigh 的敏感性。
- 效率评估:在 NVIDIA GTX 1080 上对已跟踪姿态评分,50 人/帧延迟小于 1 ms(约 1026 FPS),模型内存 32.6 MB。注意这不含姿态提取耗时。
关键结果与论文证据
- {'text': 'UBnormal Full 达到 90.1 ± 0.4 AUROC,HR 达到 90.9 ± 0.4,超越 SeeKer 12.2%,刷新骨架 VAD 纪录(第 11 页,表 1)。', 'page': 11}(第 11 页)
- {'text': 'ShanghaiTech Full 达到 86.2 ± 0.1 AUROC,HR 达到 87.7 ± 0.1,与 STG-NF 持平(第 11 页,表 1)。', 'page': 11}(第 11 页)
- {'text': '结构坍塌证据:MULDE 原始坐标基线从 T=1 的 80.6% 降至 T=32 的 70.6%,下降 10%;加入置信度加权后仍从 T=2 的 87.2% 降至 T=32 的 73.1%(第 13 页,表 2)。', 'page': 13}(第 13 页)
- {'text': 'PC 空间无置信度加权(K=48)约 84%,且随时序窗口扩展保持稳定,证明投影本身解决了坍塌(第 13 页,表 2)。', 'page': 13}(第 13 页)
- {'text': '去除白化在 UBnormal 上下降 2.2%,ShanghaiTech 下降 0.8%,证明白化的必要性(第 14 页,表 3)。', 'page': 14}(第 14 页)
- {'text': 'MSAD-HR 上 STEP 达 74.1% AUROC,超过 SeeKer 13%、STG-NF 18%,显示跨数据集泛化优势(第 11 页)。', 'page': 11}(第 11 页)
- {'text': '跨数据集泛化:ShanghaiTech 训练模型在 UBnormal 上达 82.4% AUROC(补充材料,第 32 页)。', 'page': 32}(第 32 页)
- {'text': "定性分析(图 4):STEP 正确检测到骑自行车者穿过场景的异常,同时对倒走行人产生假阳性,揭示模型学到'前向行走为正常'的先验(第 12 页)。", 'page': 12}(第 12 页)
阅读时需要注意
- 依赖上游姿态估计器:完全遮挡时无法提取骨架,性能受限于姿态提取可靠性。
- 纯姿态表述难以检测多人交互异常(如非法物品交换)或物体操作异常(如弃置包裹),若底层姿态保持正常。
- 模型学到'前向行走为正常'的先验,可能将倒走等罕见但未标注的正常行为误判为异常(图 4 假阳性)。
- T=12、K=48 基于 UBnormal 验证集选择,跨数据集最优配置可能不同;消融使用固定种子,单次结果可能有波动。
关联工作
- MULDE:最直接的方法学基线,首次将 DSM 用于视频异常检测的能量估计。STEP 揭示其在原始坐标上的结构坍塌并加以解决。
- SeeKer:基于自回归关键点分解和逐关键点似然的概率密度估计方法,UBnormal 上前 SOTA(77.9%)。STEP 超越其 12.2%。
- STG-NF:ST-GCN 与 Normalizing Flows 结合的密度估计方法,ShanghaiTech 上前 SOTA(85.9%)。STEP 与之持平。
- MoCoDAD:扩散模型预测未来姿态但最终用坐标重建误差评分,非真正概率密度估计,与 STEP 的能量估计范式不同。
- Denoising Score Matching(Vincent):STEP 训练目标的理论基础,将分数匹配转化为可高效计算的去噪目标。