快速导读:SEFS 提出一种无风格编码器的扩散风格化框架,通过随机低分辨率裁剪构建风格 token,结合目标结构条件、重归一化与跨块跳跃融合,在保持目标几何的同时迁移参考外观。
参考式扩散风格化面临一个核心矛盾:既要迁移参考图像的视觉风格,又不能把参考图像的全局布局、物体语义等不可迁移结构复制到生成结果中。现有方法要么依赖内容-风格-目标对齐三元组进行端到端调优,要么借助预训练视觉编码器提取风格嵌入,两者都容易将参考图像的结构信息泄漏进生成结果。
SEFS(Style-Encoder-Free Stylization)提出一个不同的思路:不训练风格编码器,而是通过数据构造本身实现内容与风格的分离。训练时从单张图像随机裁剪并缩放到 64×64 作为风格视图,用 Canny 边缘与 SAM 分割图作为内容条件,让模型在非配对单图像上学会区分可迁移的外观统计与不可迁移的几何结构。
英文题目:Scale-Separated Conditioning for Style-Encoder-Free Diffusion Stylization
论文出处:arXiv 每日论文精选 · arXiv:2608.19719
原始论文:PDF / 论文页面
这篇论文解决什么问题?
扩散 Transformer 已成为可控图像生成的主流骨干,但参考式风格化的难点在于风格与语义的纠缠。CSGO 等端到端调优方法依赖三元组数据,数据成本高且难以泛化到任意内容-风格对;StyleShot 通过专用预训练编码器和两阶段训练解耦内容与风格,但编码器本身可能成为结构泄漏的通道。
IP-Adapter 类方法使用预训练视觉编码器提取图像提示嵌入,ControlNet 类方法提供空间条件适配,但这些范式都假设一个强大的通用视觉表示足以描述风格。SEFS 的作者质疑这一假设:通用视觉编码器擅长捕捉语义和布局,恰恰可能把不可迁移的结构信息带入风格通路。
关键观察是:风格在低分辨率下依然可感知,而全局布局和物体语义在低分辨率下被严重削弱。如果强制风格通路只能通过一个极低分辨率的瓶颈观察参考图像,模型就无法依赖参考的全局结构,只能学习局部外观统计。
这一观察引出了尺度分离条件的思想:内容条件保持高分辨率结构信息,风格条件被限制在低分辨率局部统计,二者在信息尺度上天然分离。
核心创新
- 提出尺度分离条件框架 SEFS,用随机低分辨率裁剪瓶颈替代辅助风格编码器,从非配对单图像学习风格表示
- 设计风格到去噪的重归一化模块,对齐异构 token 统计量以稳定融合
- 引入跨块跳跃融合,将浅层结构特征传递到深层块以增强内容保持
- 构建同图到跨图的泛化训练范式:训练用单图伪实例,推理测试任意内容-风格对
方法概览
SEFS 以 SD3-Medium 为骨干,仅训练 LoRA、条件投影、重归一化与跳跃融合参数。训练时从单张图像随机裁剪并缩放到 64×64 作为风格视图,Canny 边缘与 SAM 分割图作为内容条件,经冻结 VAE 编码后与噪声 latent 拼接。风格 token 与去噪 token 拼接后按去噪 token 统计量进行重归一化,并在后半部分 Transformer 块中引入跨块跳跃融合。推理时风格参考经同一低分辨率通路输入。
- SEFS 以 SD3-Medium 为骨干,仅训练 LoRA、条件投影、重归一化与跳跃融合参数,可训练参数约 42.7M,保持参数高效。
- 训练时从单张图像随机裁剪并缩放到 64×64 作为风格视图,经冻结 VAE 编码后得到风格 token 序列;Canny 边缘与 SAM 分割图作为内容条件,与噪声 latent 拼接后输入去噪网络。
- 风格 token 与去噪 token 拼接后,按去噪 token 的统计量(均值 µd、方差 vd)对风格 token 进行重归一化,对齐异构 token 的分布,稳定融合过程。
- 在后半部分 Transformer 块中引入跨块跳跃融合,将浅层结构特征传递到深层块,增强目标几何的保持能力。
- 推理时风格参考经同一低分辨率通路输入,无需额外编码器或反演步骤,单张 A100 推理约 3.9 秒。
- 训练范式为同图到跨图的泛化:训练用单图伪实例(同一图像的风格视图与内容条件配对),推理测试任意内容-风格对,避免了三元组数据需求。
逐图理解论文
失败案例与直觉
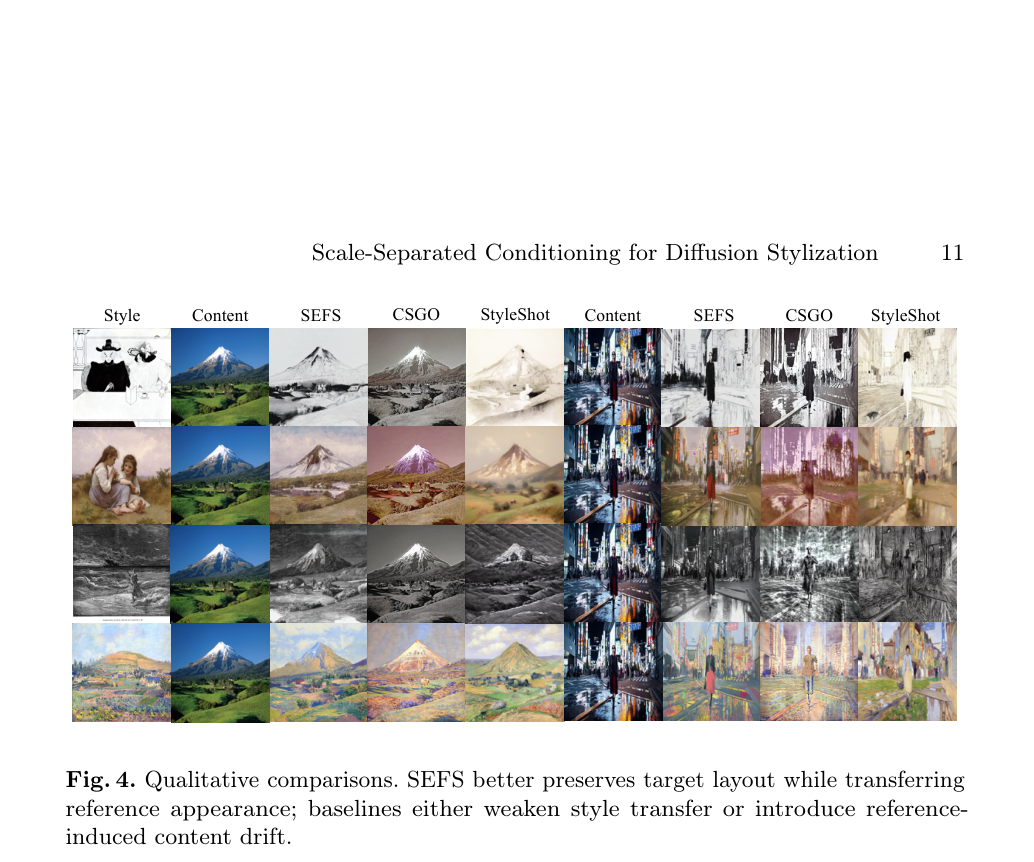
定性对比中注意 SEFS 如何在保持目标布局的同时迁移参考的调色板、纹理和笔触统计,而基线方法要么弱化风格迁移,要么引入参考诱导的内容漂移。
研究缺口
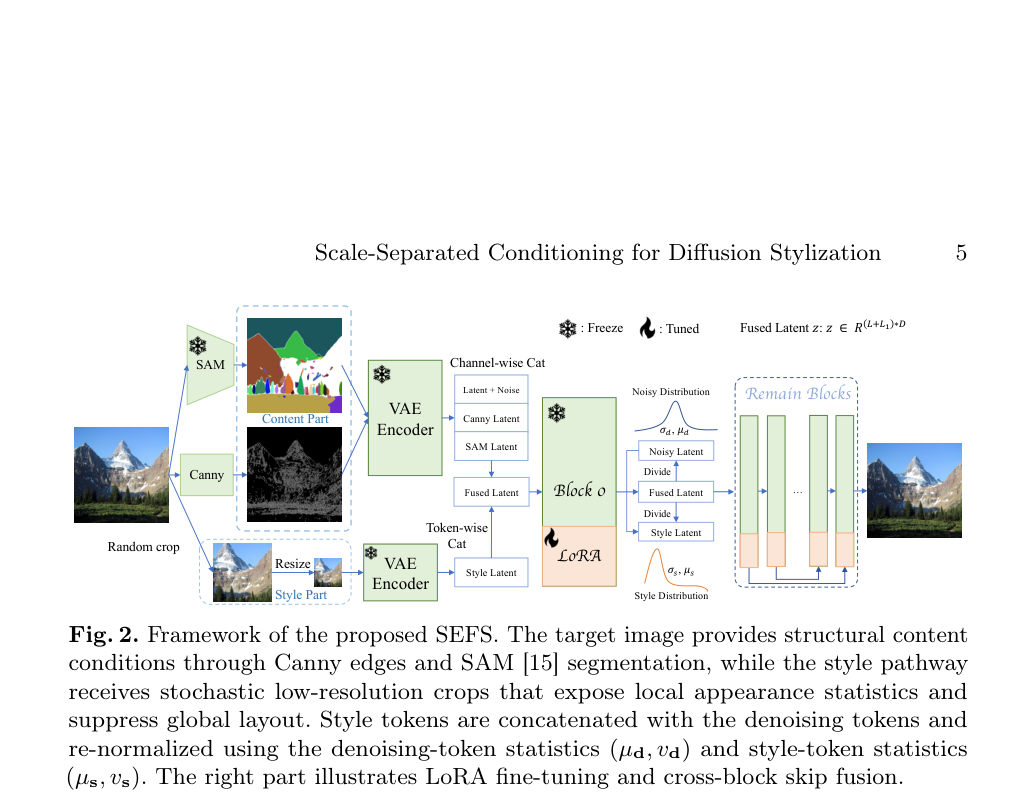
观察框架图时,重点看风格通路如何通过低分辨率裁剪进入 VAE,以及风格 token 与去噪 token 拼接后的重归一化模块。右侧的 LoRA 与跨块跳跃融合标注说明了参数高效训练与结构保持机制的位置。
机制验证
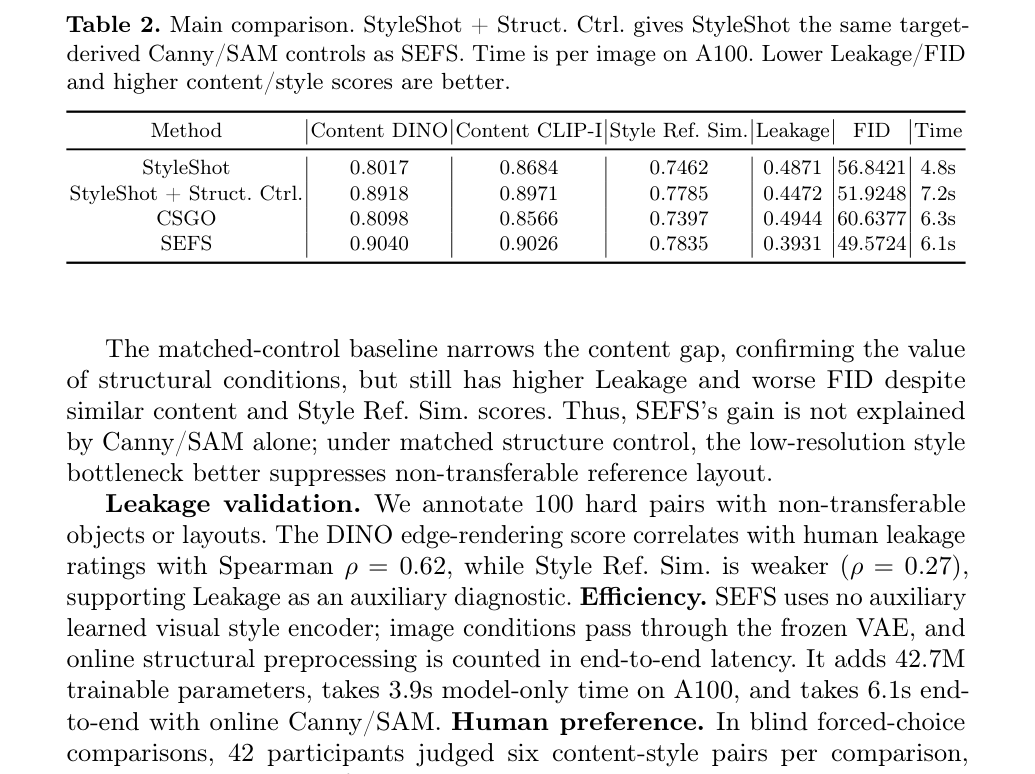
主对比表中,关注 Leakage 列与 Content DINO 列的关系:SEFS 在两者上同时最优,而 StyleShot + Struct. Ctrl. 虽然内容指标接近,但 Leakage 明显更高,说明结构控制不足以替代尺度分离。
实验如何设计?
- 主对比在 1,000 个固定跨图内容-风格对上与 StyleShot、CSGO 及 StyleShot + Struct. Ctrl. 进行,后者给 StyleShot 加上与 SEFS 相同的目标派生 Canny/SAM 控制分支,以隔离内容控制的混淆因素。
- 在 WikiArt 上对内容条件(Canny/SAM)与跳跃融合进行消融,所有变体使用 30k 步、batch size 32、学习率 2×10⁻⁵。
- 跨图机制控制实验包括:移除或打乱风格 token、替换为 CLIP 编码器、去除重归一化、高分辨率风格 token 变体。
- 对重归一化、风格视图分辨率(64/128/256)与 CLIP 风格编码器替代进行消融。
- 100 个困难对的泄漏人工标注验证,以及 42 人盲选人类偏好评估。
关键结果与论文证据
- 主对比中 SEFS 在 Content DINO(0.9040)和 Content CLIP-I(0.9026)上优于所有基线,同时 Leakage 最低(0.3931),表明内容保持与结构泄漏抑制同时改善(Table 2, p.11)。
- StyleShot + Struct. Ctrl. 的 Content DINO 达到 0.8918,接近 SEFS,但 Leakage 仍为 0.4472,说明仅加结构控制不足以阻止参考结构泄漏,低分辨率风格通路是关键(Table 2, p.11)。
- 去除 Canny 导致 FID 从 48.7677 恶化到 59.1620,CLIP-I 从 0.9063 降到 0.8294,是内容条件中影响最大的组件(Table 1, p.10)。
- 去除重归一化使 IS 从 9.4697 降到 9.0913,FID 从 54.1585 恶化到 66.9413,CLIP-I 从 0.8821 降到 0.8191,证明统计对齐对融合稳定性至关重要(Table 4, p.13)。
- 64×64 风格视图分辨率表现最佳,更高分辨率削弱瓶颈,使风格通路更易依赖参考结构(Table 4, p.13)。
- CLIP 编码器替代变体未优于裁剪 token,说明更强的通用视觉表示不一定是更好的风格表示(Table 4, p.13)。
- 人类偏好评估中 SEFS 胜 StyleShot 64.3%、胜 CSGO 72.2%、胜 StyleShot + Struct. Ctrl. 62.7%(p.12)。
- 移除或打乱风格 token 保持内容但降低风格参考相似度,证实风格通路确实承载可迁移外观(Table 3, p.12)。
阅读时需要注意
- 低分辨率风格 token 压缩会抑制依赖符号母题、可读文字、物体级形状或精确布局的风格迁移。
- 继承结构预处理误差:Canny 边缘或 SAM 掩码不准确会削弱内容保持。
- 自动指标仅作为诊断信号,风格化质量缺乏完整定义;Style Ref. Sim. 与泄漏人工评分的 Spearman 相关性仅 0.27,风格相似度指标需谨慎解读。
- 高分辨率风格 token 变体在评估时先降采样到 64×64 再放大到训练分辨率,结论仅针对学习到的分辨率通路。
关联工作
- CSGO 是端到端调优扩散风格化方法,依赖内容-风格-目标三元组和图像编码器;SEFS 用非配对单图像与裁剪 token 替代,消除了三元组数据需求。
- StyleShot 通过专用预训练编码器和两阶段训练解耦内容与风格;SEFS 通过数据构造与 token 设计而非编码器容量实现分离。
- IP-Adapter 使用预训练视觉编码器提取嵌入;SEFS 避免辅助风格编码器,从架构上切断了编码器带来的结构泄漏通道。
- AdaIN 的经典特征统计风格迁移思路与 SEFS 的重归一化在 token 统计对齐上相关,但 SEFS 将其应用于扩散 Transformer 的异构 token 融合。