快速导读:提出 InstaBind-Lite 基准,将 LVLM 把可见同类实例的属性错误归属到另一实例的 DSCAM 失败形式化为可测量类别,并揭示其邻接结构与干预效果。
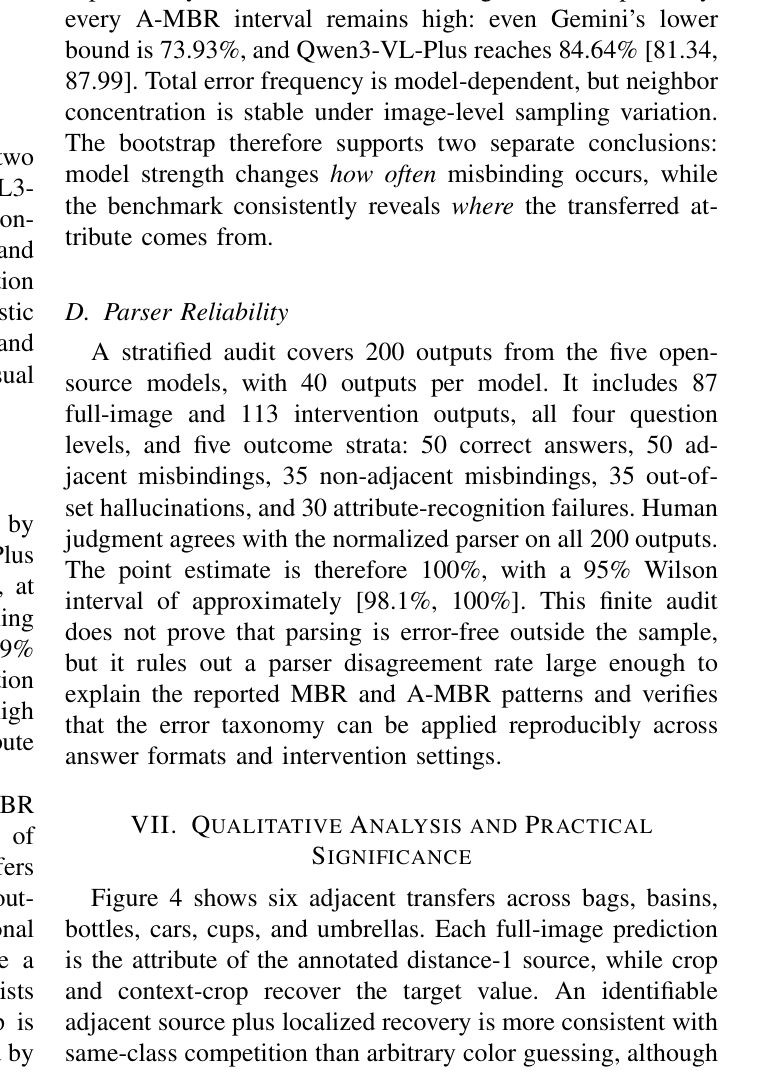
大视觉语言模型(LVLM)在拥挤场景中常常能正确识别对象和属性,却把正确感知到的属性绑定到错误的同类实例上。例如,画面中有两个杯子,一个红色一个蓝色,模型回答'红色杯子'时指向的却是蓝色杯子。这种失败形式在本文中被命名为稠密同类属性误绑定(DSCAM),它与传统的对象幻觉不同:答案中的属性和类别在图像中都是可见的,只是归属关系错了。
本文的核心论点是:现有 VQA 准确率与对象幻觉指标无法区分'属性识别失败'与'属性被复制到错误同类实例',导致聚合分数掩盖了实例-属性对应可靠性问题。为此,作者构建了 InstaBind-Lite 诊断基准,通过源实例标注将错误分解为相邻/非相邻误绑定、识别失败与集外幻觉,并定义 MBR、Err-MBR、A-MBR、Distance-MBR 等绑定导向指标。
英文题目:InstaBind-Lite: Diagnosing Dense Same-Class Attribute Misbinding in Large Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2608.16805
原始论文:PDF / 论文页面
这篇论文解决什么问题?
对象幻觉基准如 CHAIR 和 POPE 主要检测内容是否在图像中存在,即无支撑生成。但 DSCAM 的答案在图像中确实存在,只是归属到了错误的实体。当所有类别和颜色在图中可见时,in-image 答案仍可能指向错误实体,因此对象存在性检查无法标记错误归属。
指代表达基准如 RefCOCO 和 MAttNet 评估区域定位能力,但定位正确仍可能回答邻居属性。模型可能准确找到了目标实例的位置,却在回答属性时从相邻实例复制了颜色。这说明定位与属性绑定是两个可分离的能力维度。
Winoground 的最小对原则启发了本文的设计:固定同类集合与词汇,仅改变查询实例,从而隔离出绑定错误。ARO 的关系敏感性则启发了 L3 层级与序数距离分析。MultiBind 研究图像生成中的跨主体属性转移,本文提出的是 LVLM 阅读自然图像时的互补行为问题。
核心创新
- 将 Dense Same-Class Attribute Misbinding (DSCAM) 形式化为独立失败类别,区分无支撑幻觉、属性识别失败与可见属性错误归属
- 构建高纯度诊断基准 InstaBind-Lite,含受控同类组、有序邻居链接与源实例标注,使错误实例绑定可确定性测量
- 提出绑定导向指标 MBR、Err-MBR、A-MBR、Distance-MBR,量化转移频率、错误占比、邻接集中度与序数距离分布
- 引入 crop/context-crop 定位干预与 instance-first prompting,测试减少视觉竞争或显式枚举实例-属性对是否修复绑定错误
方法概览
构建 InstaBind-Lite 诊断基准:524 张图像、529 个同类组、1773 个标注实例、9580 个问题,含 L1 位置到属性、L2 属性到位置、L3 关系干扰、L4 命题验证四个层级;通过源实例标注将错误分解为相邻/非相邻误绑定、识别失败与集外幻觉,并定义 MBR、Err-MBR、A-MBR、Distance-MBR 及干预差距指标。
- InstaBind-Lite 包含 524 张图像、529 个同类组、1773 个标注实例和 9580 个问题,属性范围限定为颜色与上装颜色,以保证高纯度标注。
- 基准分为四个层级:L1 位置到属性(给定位置问属性)、L2 属性到位置(给定属性问位置)、L3 关系干扰(加入关系描述干扰)、L4 命题验证(判断命题真假)。
- 通过源实例标注,每个错误答案被分解为三类:相邻误绑定(答案来自距离为 1 的同类实例)、非相邻误绑定(来自更远实例)、识别失败(属性不在任何同类实例上)与集外幻觉(属性不匹配任何实例)。
- 绑定导向指标包括:MBR(误绑定数占全部问题比例)、Err-MBR(误绑定占错误答案比例)、A-MBR(误绑定中距离为 1 的占比)、Distance-MBR(按序数距离分布的误绑定分析)。
- 干预实验包括 crop oracle(真值目标框加 15% padding)与 context crop(50% padding 保留更多局部上下文),以及 instance-first prompting(先枚举同类实例及属性再回答)。
- 统计验证采用 1000 次图像聚类 bootstrap 重采样计算 95% 置信区间,并对 200 个输出进行分层人工审计验证解析器可靠性。
逐图理解论文
一个具体失败案例
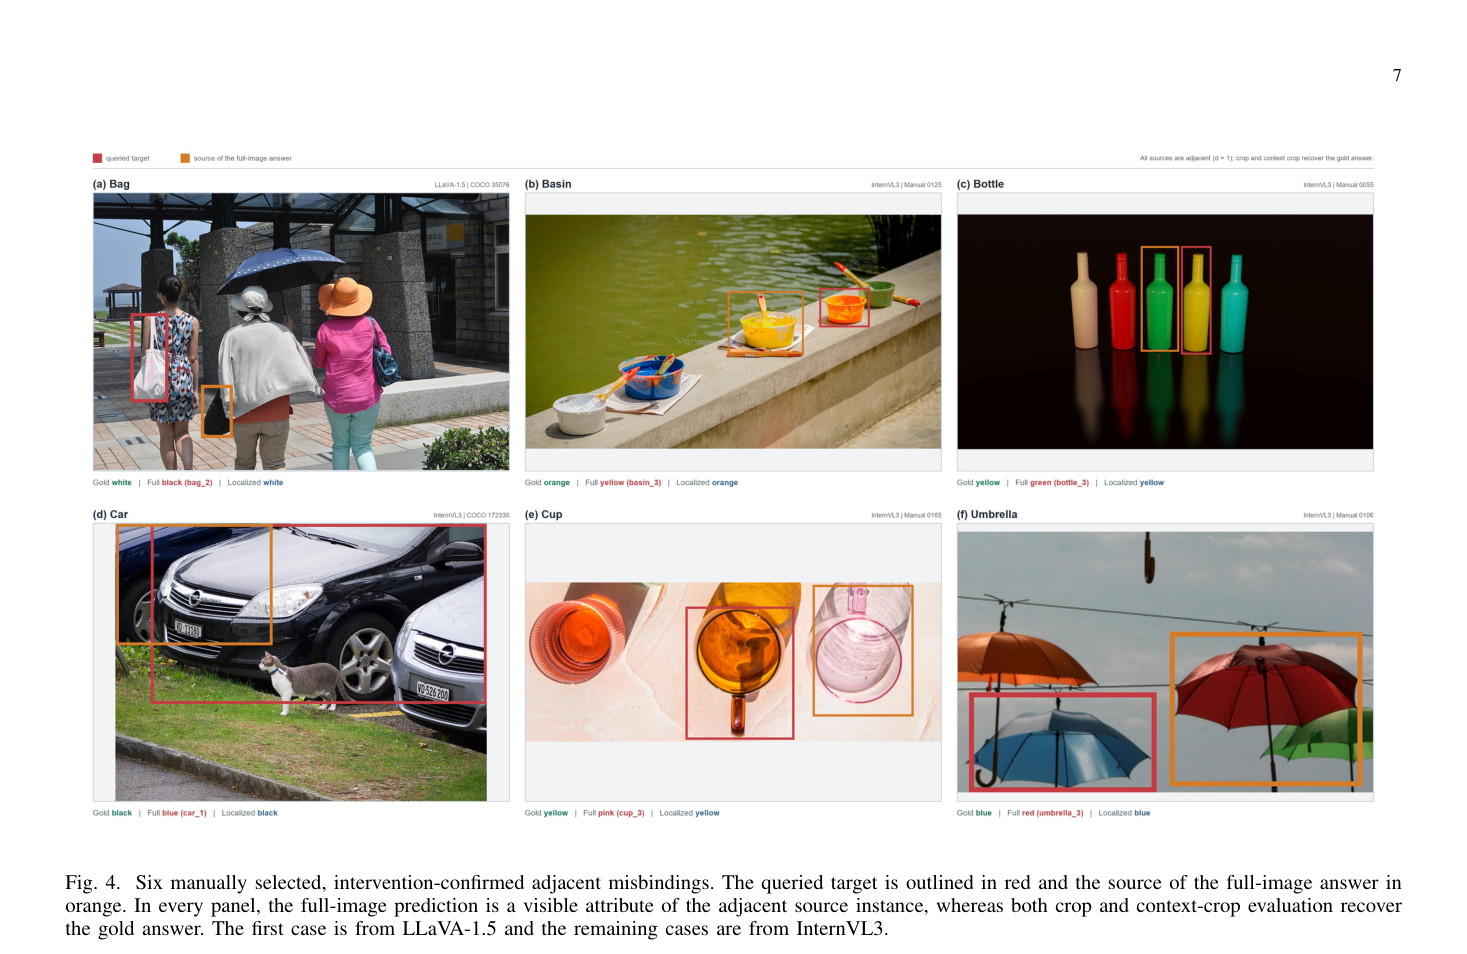
该图展示六个经干预确认的相邻误绑定案例,目标实例用红色框标注,全图答案的来源实例用橙色框标注。重点观察全图预测是相邻来源实例的可见属性,而 crop 与 context-crop 均恢复正确答案。
研究缺口:绑定错误被聚合分数掩盖
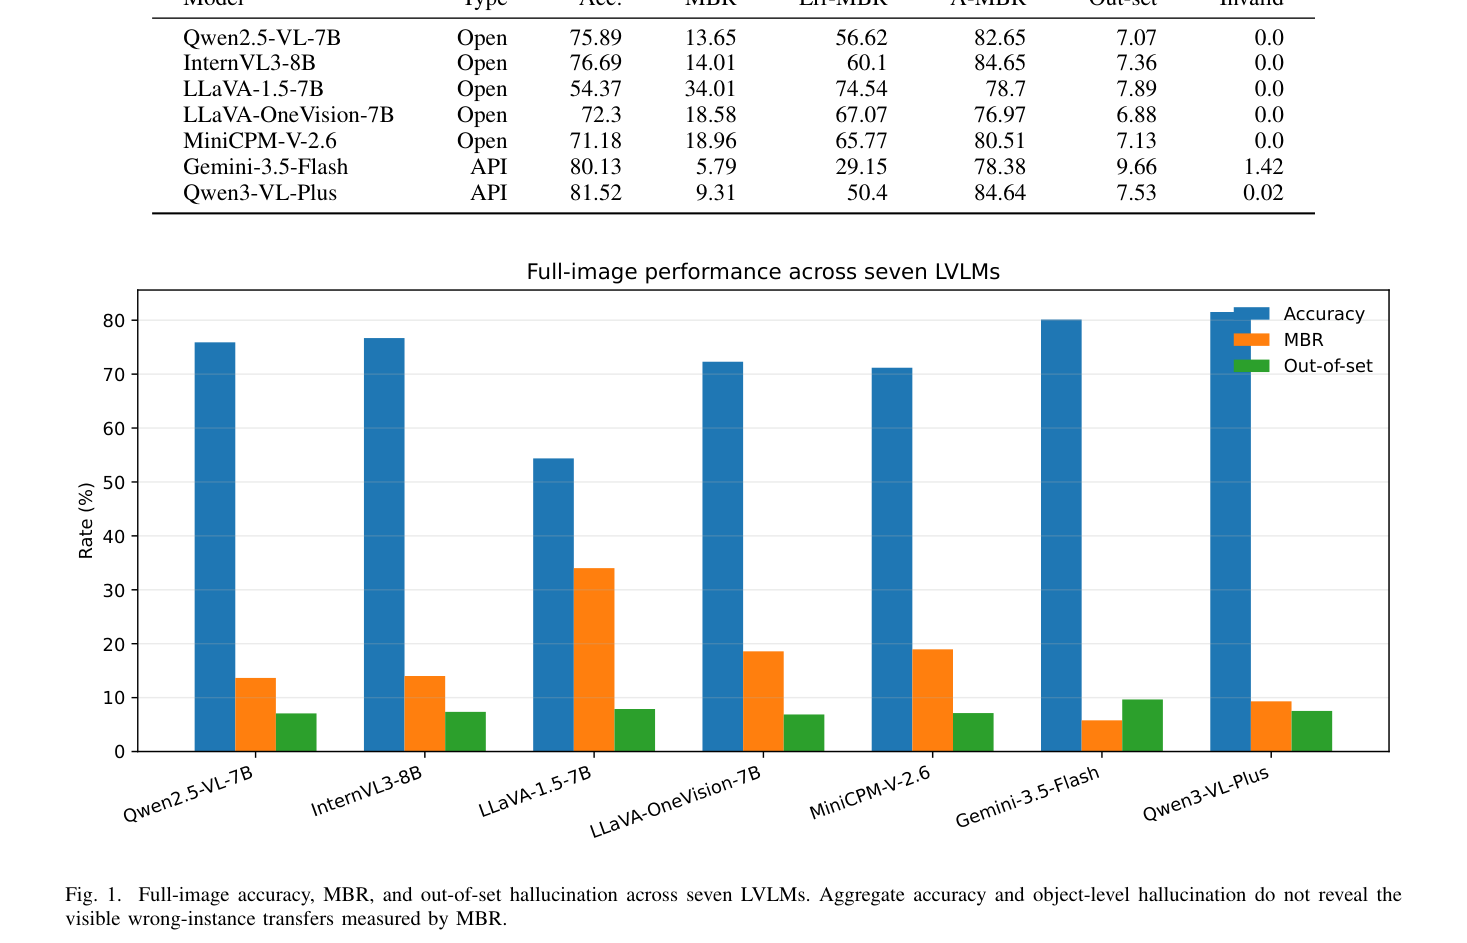
该图对比七个 LVLM 的全图准确率、MBR 和集外幻觉率。重点观察:聚合准确率与 MBR 之间没有简单对应关系,高准确率模型仍可能有可测的误绑定,说明聚合分数掩盖了实例-属性对应可靠性问题。
论文贡献:可测量的误绑定诊断
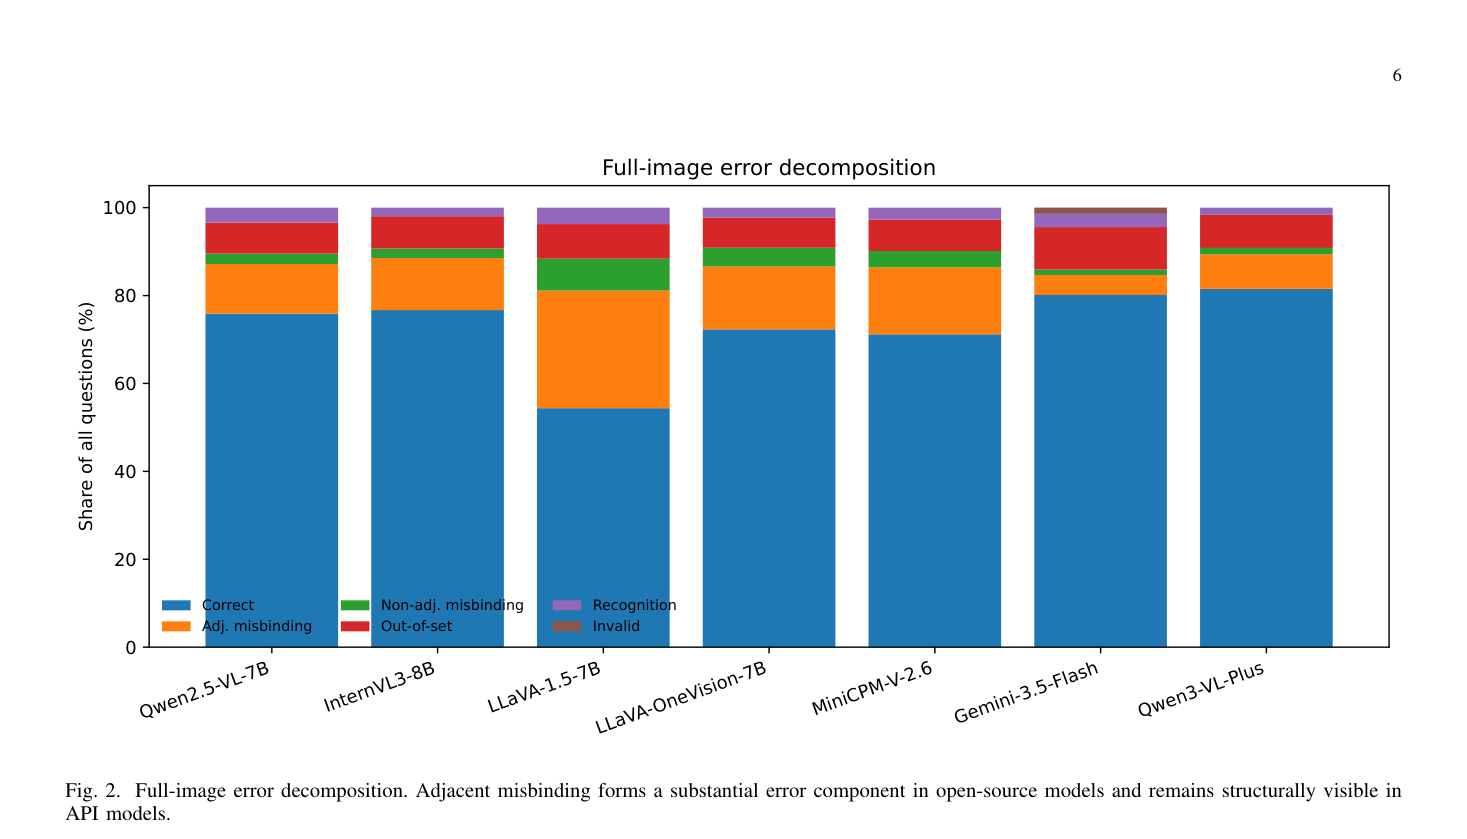
该图展示全图错误分解,将错误分为相邻误绑定、非相邻误绑定、识别失败与集外幻觉。重点观察相邻误绑定在开源模型中构成实质性错误成分,在 API 模型中仍结构可见。
最强结论:误绑定高度邻接
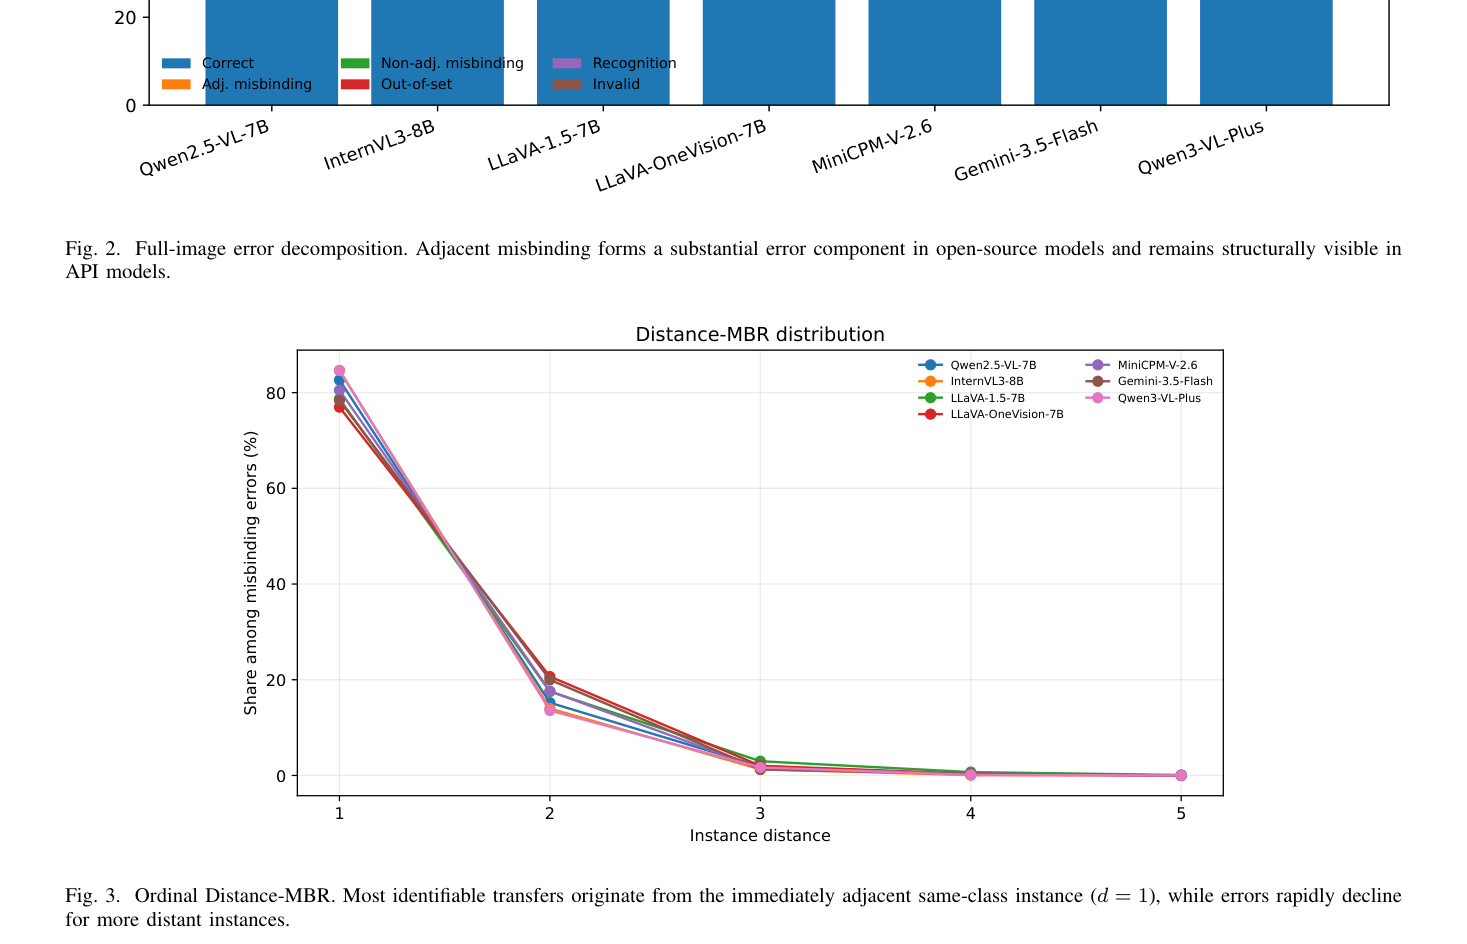
该图展示序数 Distance-MBR 分布。重点观察大多数可识别转移来自距离为 1 的相邻同类实例,错误随距离增加迅速下降,支持同类竞争而非任意猜测的解释。
干预实验揭示的机制与局限
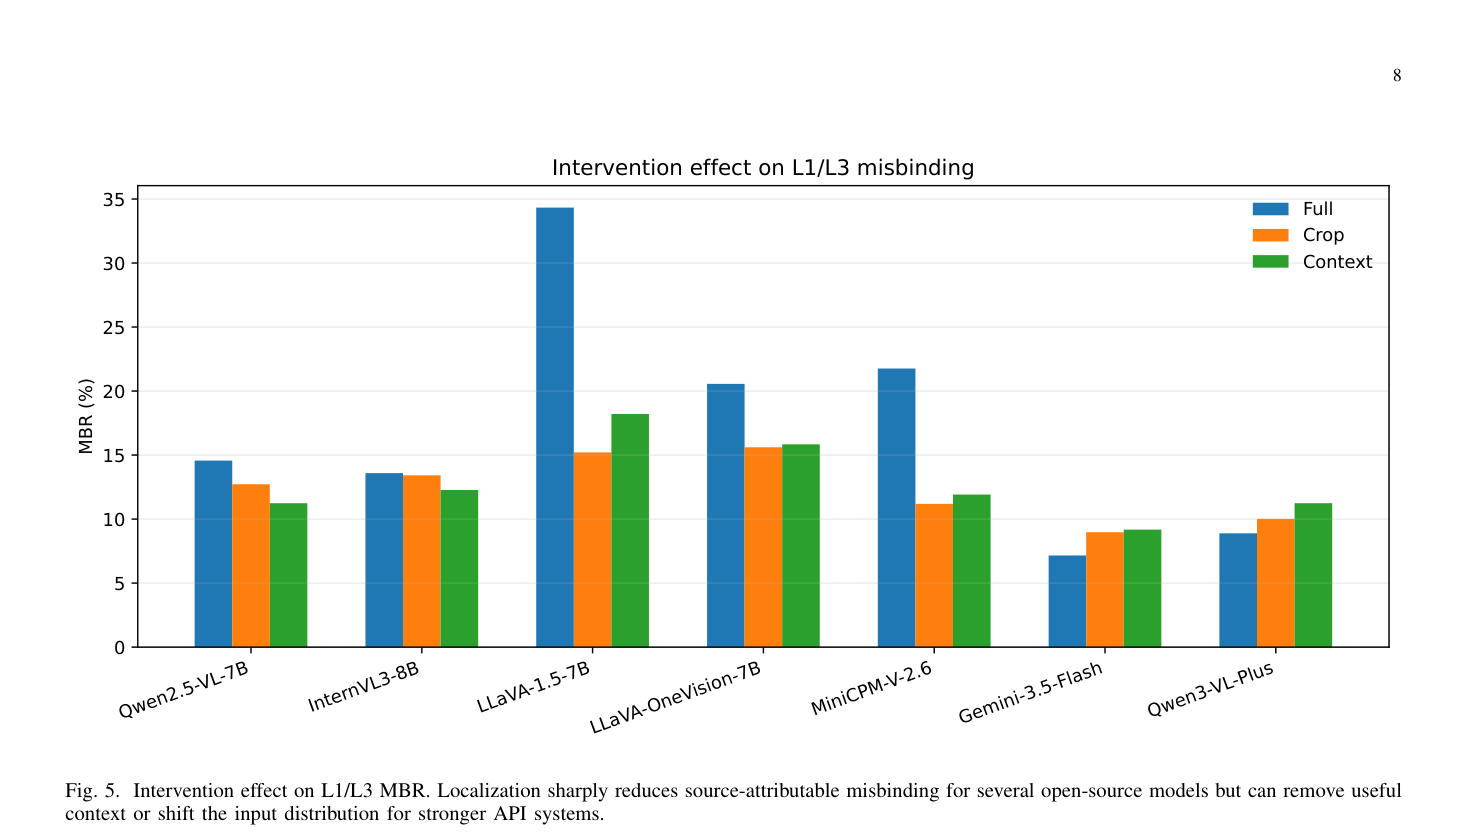
该图展示定位干预对 L1/L3 MBR 的影响。重点观察定位干预对部分开源模型显著降低源可归因误绑定,但对强 API 系统可能移除有用上下文或改变输入分布。
实验如何设计?
- 在 5 个开源 LVLM(Qwen2.5-VL-7B、InternVL3-8B、LLaVA-1.5-7B、LLaVA-OneVision-7B、MiniCPM-V-2.6)与 2 个 API 模型(Gemini-3.5-Flash、Qwen3-VL-Plus)上评估全图性能与误绑定指标。
- 对 4261 个 L1/L3 问题应用 crop oracle 与 context crop 干预,比较全图、裁剪与上下文裁剪下的准确率和 MBR。
- 对开源模型应用 instance-first prompting,先枚举同类实例及属性再回答原问题,测量准确率与 MBR 变化。
- 1000 次图像聚类 bootstrap 重采样计算 95% 置信区间,验证 MBR 与 A-MBR 的统计稳定性。
- 对 200 个输出进行分层人工审计(5 个开源模型 × 40 输出,覆盖 5 种结果层级),验证解析器可靠性。
关键结果与论文证据
- 开源模型平均 MBR 为 19.84%,API 模型平均 MBR 为 7.55%,说明误绑定在所有模型中普遍存在(第 1 页)。
- 可识别转移中相邻实例占比:开源 80.70%,API 81.51%,表明误绑定高度集中在距离为 1 的邻居实例(第 1 页)。
- LLaVA-1.5-7B 的 Acc 为 54.37%,MBR 为 34.01%,Err-MBR 为 74.54%,A-MBR 为 78.70%,是最严重的误绑定模型(第 5 页)。
- Gemini-3.5-Flash 的 Acc 为 80.13%,MBR 为 5.79%,A-MBR 为 78.38%;Qwen3-VL-Plus 的 Acc 为 81.52%,MBR 为 9.31%,A-MBR 为 84.64%(第 5 页)。
- 6/7 模型的 MBR 超过集外幻觉率,说明误绑定比无支撑幻觉更常见(第 4 页)。
- LLaVA-1.5 的 crop oracle 干预使 Acc 提升 20.14 点、MBR 下降 19.12 点;MiniCPM-V-2.6 的 Acc 提升 9.22 点、MBR 下降 10.57 点(第 6 页)。
- Gemini-3.5-Flash 的 crop 干预使 MBR 增加 1.81 点,Qwen3-VL-Plus 增加 1.13 点,说明定位干预对强 API 模型可能产生负向效果(第 7 页)。
- Instance-first prompting 对 InternVL3 使 Acc 提升 1.54 且 MBR 下降 4.36,对 MiniCPM-V 使 Acc 提升 2.17 且 MBR 下降 3.46,但对 LLaVA-1.5 使 Acc 下降 22.58 且 MBR 上升 1.15(第 8 页)。
阅读时需要注意
- 属性范围仅限颜色与上装颜色,不能假设动作、材质、纹理、形状、状态等语义具有相同误绑定率。
- 序数距离分析无法区分序数邻接与物理欧氏距离的因果作用,需补充归一化中心距离、边界距离与重叠度。
- crop 干预是视觉与查询的联合干预,不能单独归因于视觉竞争减少。
- API 模型因专有预处理无法分离全局上下文移除与裁剪引起的尺度/分布偏移。
- instance-first prompting 对部分模型(如 LLaVA-1.5)严重损害准确率,非通用缓解方案。
关联工作
- CHAIR 检测图像描述中的缺席对象,针对无支撑生成而非错误实例归属;POPE 测试对象存在性,无法判断属性是否绑定到正确实例;AMBER 是无 LLM 评判的多维幻觉基准,仍以内容是否受图像支持为核心。
- HallusionBench 耦合语言幻觉与视觉错觉,不追踪错误属性的来源实例;RefCOCO 和 MAttNet 评估指代表达的区域定位,定位正确仍可能回答邻居属性。
- Winoground 的最小对原则启发固定同类集合与词汇、仅改变查询实例的设计;ARO 的关系敏感性启发 L3 层级与序数距离分析;MultiBind 研究图像生成中的跨主体属性转移,本文提出 LVLM 阅读自然图像时的互补行为问题。