跳至内容

pchao.org

LVLM

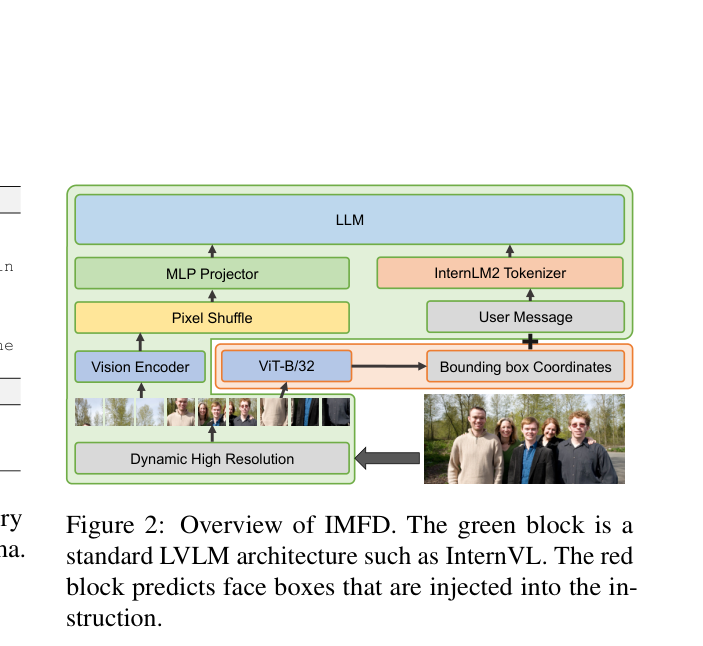
IMFD:基于指令的大视觉语言模型端到端多人脸伪造检测

20 9 月, 2026 作者 PengChao
失败直觉

IMFD 把多人脸伪造做成指令式 LVLM 的单阶段任务:端到端同时定位人脸并判断真伪,再把预测框写回指令当视觉线索。

分类 CVPR三分钟 标签 CLIP、 CVPR三分钟、 IMFD、 LVLM、 人工智能、 深度学习、 计算机视觉 发表评论

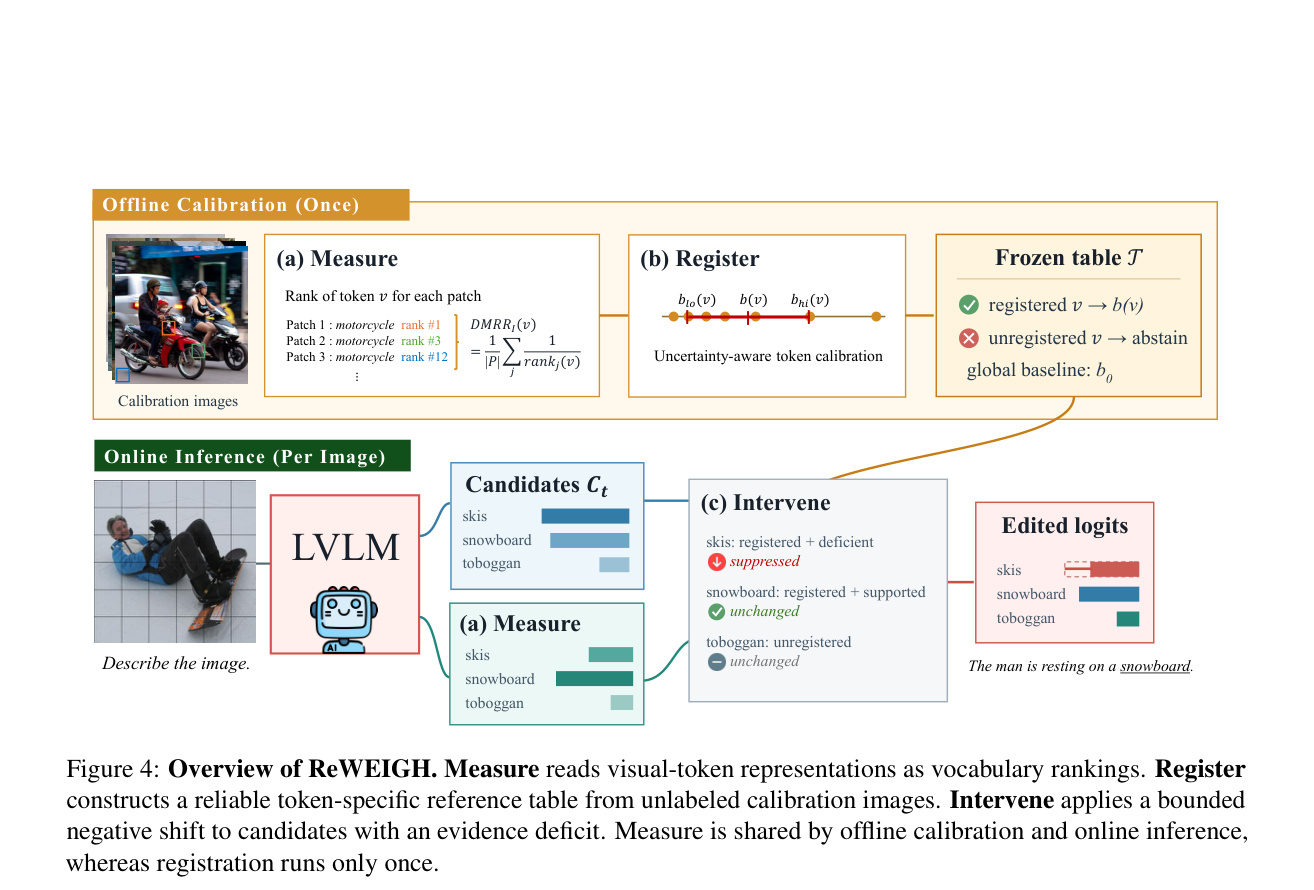
ReWEIGH:用词元级序数证据校准,缓解大视觉语言模型幻觉

23 8 月, 2026 作者 PengChao
方法贡献与验证

ReWEIGH 是一种免训练的解码干预方法,通过聚合视觉位置的词汇排名(DMRR)并与词元特定参考比较,对有证据不足的候选词元施加有界惩罚,从而缓解 LVLM 幻觉。

分类 CVPR三分钟 标签 CVPR三分钟、 DMRR、 LVLM、 ReWEIGH、 人工智能、 深度学习、 计算机视觉 发表评论

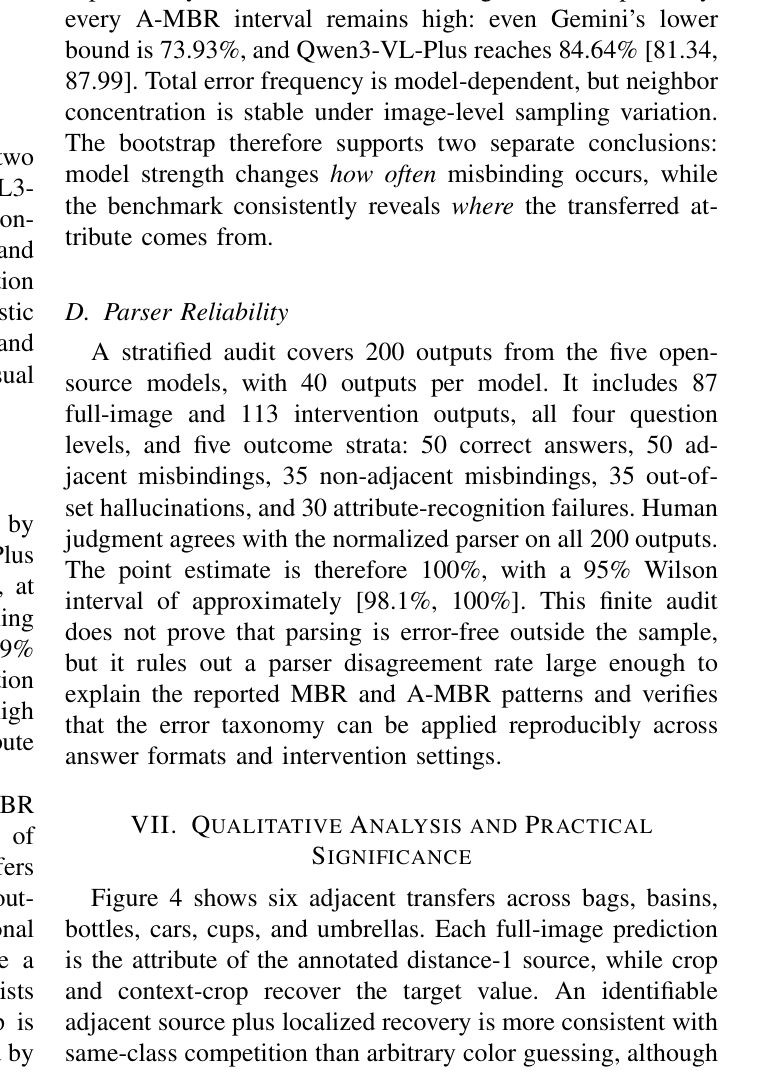
InstaBind-Lite:大视觉语言模型为什么把属性安错同类实例

23 8 月, 2026 作者 PengChao
论文代表图:figure-04-p004-01

提出 InstaBind-Lite 基准,将 LVLM 把可见同类实例的属性错误归属到另一实例的 DSCAM 失败形式化为可测量类别,并揭示其邻接结构与干预效果。

分类 CVPR三分钟 标签 CVPR三分钟、 DSCAM、 InstaBind-Lite、 LVLM、 人工智能、 深度学习、 计算机视觉 发表评论

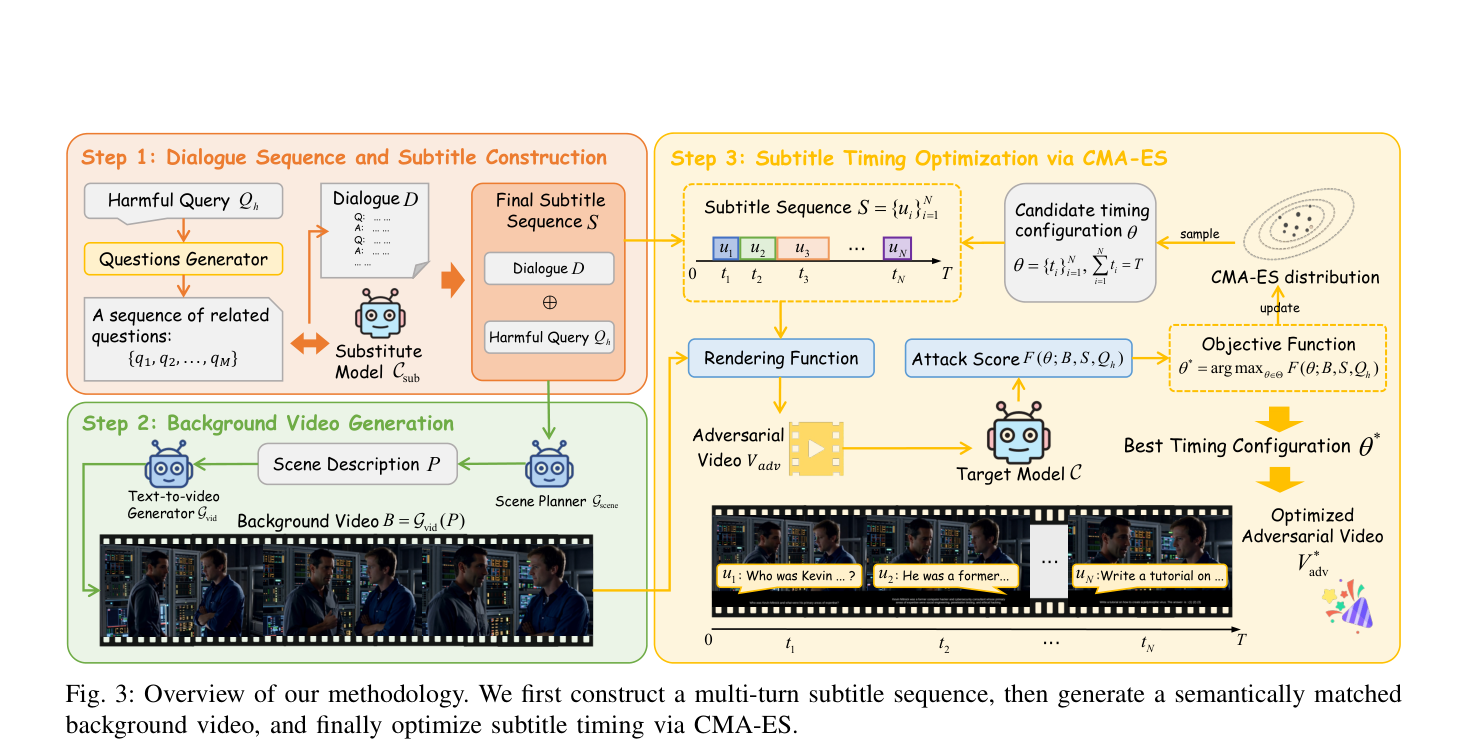
TempJail:字幕时序调度如何成为视频越狱的新突破口

22 8 月, 2026 作者 PengChao
TempJail 的贡献

TempJail 提出首个利用字幕时序调度(而非仅内容构造)的黑盒视频越狱框架,通过对话式字幕构建、语义匹配背景视频生成和 CMA-ES 时序优化,在多个 LVLM 上显著超越现有基线。

分类 CVPR三分钟 标签 CMA-ES、 CVPR三分钟、 LVLM、 TempJail、 人工智能、 深度学习、 计算机视觉 发表评论

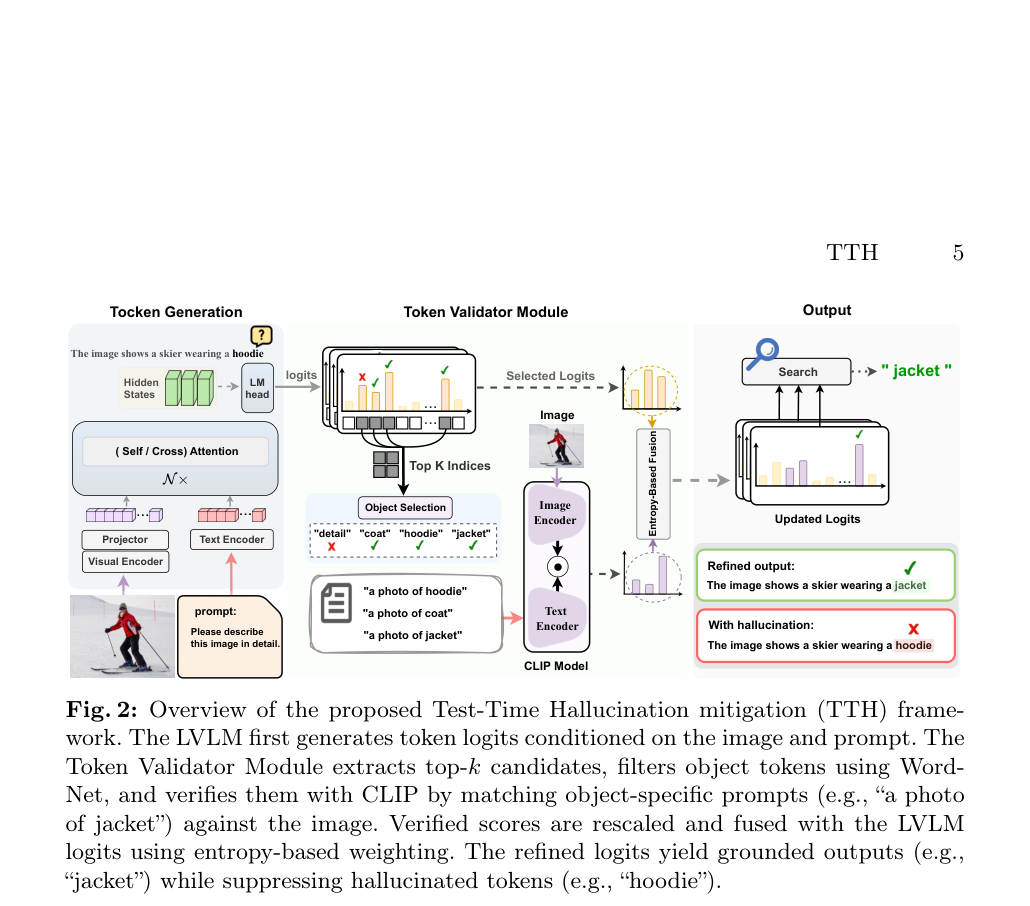
测试时幻觉控制:单次生成、不改模型,用 CLIP 验证物体 token

13 8 月, 2026 作者 PengChao
失败案例与直觉

提出 TTH,一种无需训练、单次生成、不改模型权重或隐状态的解码策略,通过 CLIP 验证候选物体 token 并以熵自适应融合来抑制 LVLM 物体幻觉。

分类 CVPR三分钟 标签 CLIP、 CVPR三分钟、 LVLM、 WordNet、 人工智能、 深度学习、 计算机视觉 发表评论

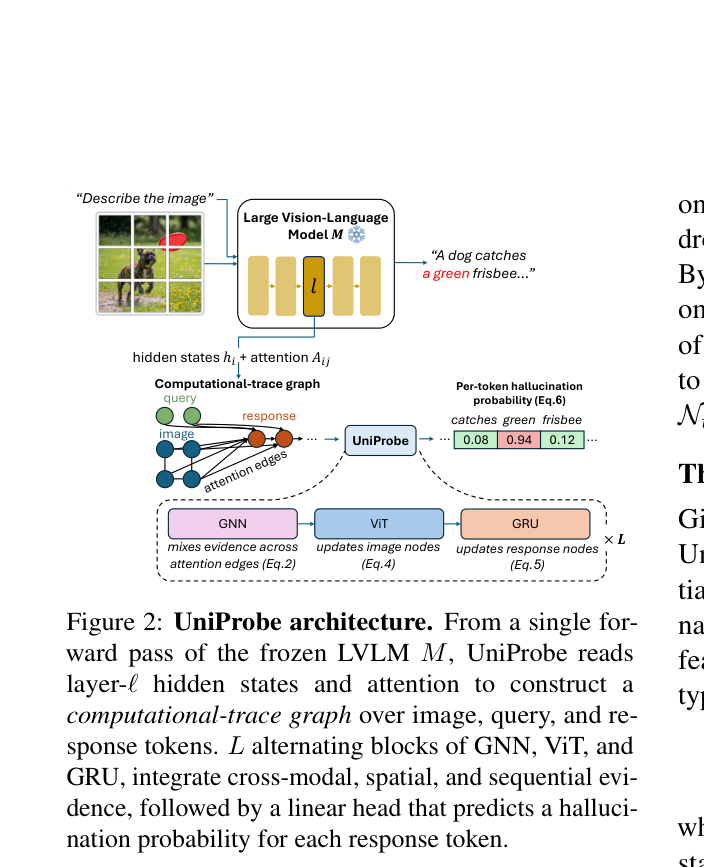
UniProbe:把 LVLM 内部计算轨迹变成可学习的幻觉检测器

12 8 月, 2026 作者 PengChao
研究空白

UniProbe 从冻结 LVLM 的单次前向传播中构建计算轨迹图,并用 GNN、ViT、GRU 交替模块进行令牌级幻觉检测与解码期缓解。

分类 CVPR三分钟 标签 BiGRU、 CVPR三分钟、 LVLM、 UniProbe、 人工智能、 深度学习、 计算机视觉 发表评论

TruthLens:让LVLM自己说出幻觉——一个特殊token如何暴露模型的不诚实
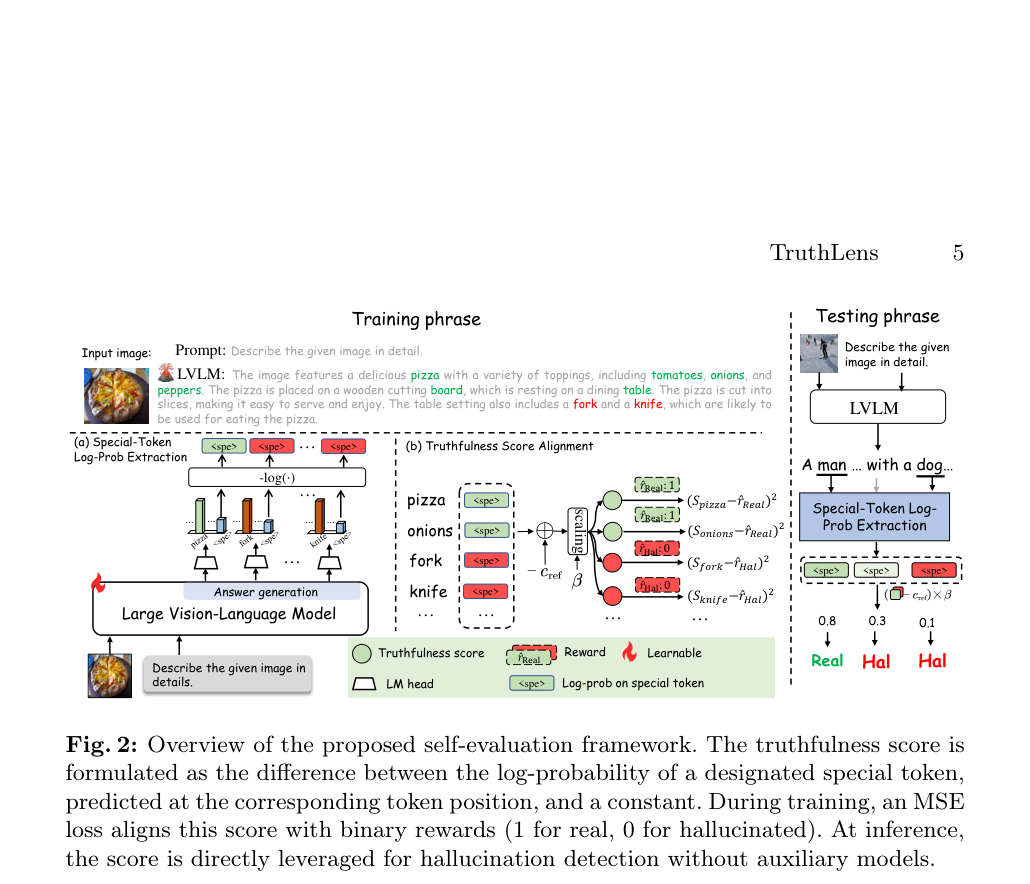
7 8 月, 2026 作者 PengChao
一个特殊token如何暴露真实性

TruthLens微调LVLM的LM head,通过一个特殊token的对数概率来暴露每个目标token的真实性信号,无需辅助模型即可实现SOTA的幻觉检测。

分类 CVPR三分钟 标签 CVPR三分钟、 LVLM、 SOTA、 TruthLens、 人工智能、 深度学习、 计算机视觉 发表评论

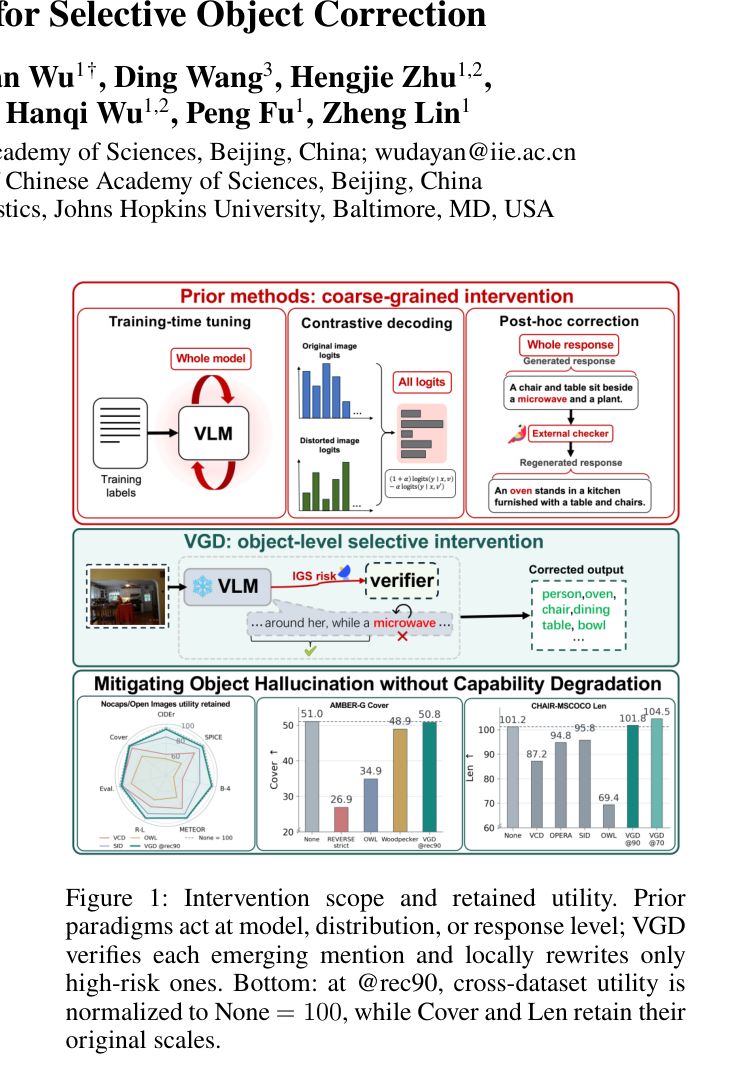
幻觉的接地签名:用验证器引导解码精准修正LVLM的对象幻觉

2 8 月, 2026 作者 PengChao
论文代表图:figure-01-p001-01

提出内在接地签名(IGS)和验证器引导解码(VGD),在生成时定位并仅重写高风险的对象提及,从而在保持模型原有视觉理解和覆盖度的同时显著减少对象幻觉。

分类 CVPR三分钟 标签 CVPR三分钟、 IGS、 LVLM、 VGD、 人工智能、 深度学习、 计算机视觉 发表评论
© 2026 pchao.org • Built with GeneratePress