快速导读:提出将多参考图像生成分解为 Anchor、Disentangle、Apply、Compose 四个原子算子的能力导向基准 TRACE-Bench,支持算子级评估与诊断树故障定位。
多参考图像生成要求模型同时条件化于多个视觉元素,是虚拟试穿、合影排版等实际工作流的关键能力。然而,现有多参考基准(如 MultiBanana、MICON-Bench、MacroBench)按预定义任务类型组织,整体评分无法区分身份保持、属性提取、属性绑定等具体失败来源。TRACE-Bench 提出一种能力导向的替代方案:将多参考生成形式化为四个原子算子 Anchor、Disentangle、Apply、Compose,并用组合公式表征任意多参考提示。
基于该公式体系,作者构建了约1600个评测用例(slot 1–8),采用算子对齐的 VLM 评判协议逐能力打分,并通过诊断树递归分解定位失败来源。在9个代表性模型上的评估显示,闭源模型 Nano Banana 2 平均分最高,而开源最佳 Emu3.5 在 Disentangle 上明显落后;诊断树分析进一步揭示 Joint Composition 是 f/g/⊕ 的主导失败源。
英文题目:TRACE-Bench: Decomposing and Diagnosing Multi-Reference Image Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.16765
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有多参考基准沿用任务导向设计:MultiBanana 扩展到8参考图并引入难度因子,但按任务组织、整体评分;MICON-Bench 定义六类组合任务;MacroBench 覆盖4000样本、四个任务维度、最多10参考图。这些基准的共同局限是:覆盖不全、无法定位具体能力故障、结构复杂度不可控。
从实际工作流看,多参考生成的核心难点在于模型必须同时完成多个子能力:从参考图中定位特定实体并保持身份(Anchor)、提取可迁移属性并剥离无关属性(Disentangle)、将属性绑定到指定目标(Apply)、按关系约束合成连贯场景(Compose)。整体评分会掩盖这些子能力的差异。
单参考个性化方法(DreamBooth、Textual Inversion、IP-Adapter、ControlNet)和文本到图像组合性基准(GenEval、T2I-CompBench)均未覆盖多参考设置,无法直接迁移。因此需要一个能力导向、结构复杂度可控、支持故障定位的新基准。
核心创新
- 提出能力导向的四算子分解(Anchor/Disentangle/Apply/Compose)及组合公式表征,覆盖任意多参考场景
- 构建 TRACE-Bench:约1600用例、631公式模板、约4000参考图像,以 slot 数(1–8)系统控制结构复杂度
- 设计算子对齐评估协议,将每个公式项映射为细粒度能力检查项,由 VLM judge 二元打分
- 提出诊断树分析方法,递归剥离全局参考、组合、关系、属性等成分以定位失败来源
方法概览
将多参考生成形式化为四个原子算子 Anchor(f)、Disentangle(g)、Apply(⊕)、Compose(C),用组合公式表示任意多参考提示;基于公式模板采样构建约1600个评测用例(slot 1–8),采用算子对齐的 VLM 评判协议逐能力打分,并通过诊断树递归分解定位失败来源。
- 四算子形式化:Anchor(f) 从参考图中定位特定实体并保持身份;Disentangle(g) 提取可迁移属性并剥离无关属性;Apply(⊕) 将解耦属性绑定到目标实体;Compose(C) 将多个内容按关系约束合成连贯场景。任意多参考提示可表示为这些算子的组合公式。
- slot count 定义为公式中锚定项与解耦项数量之和,用于控制结构复杂度。基准覆盖 slot 1–8,共631个公式模板。
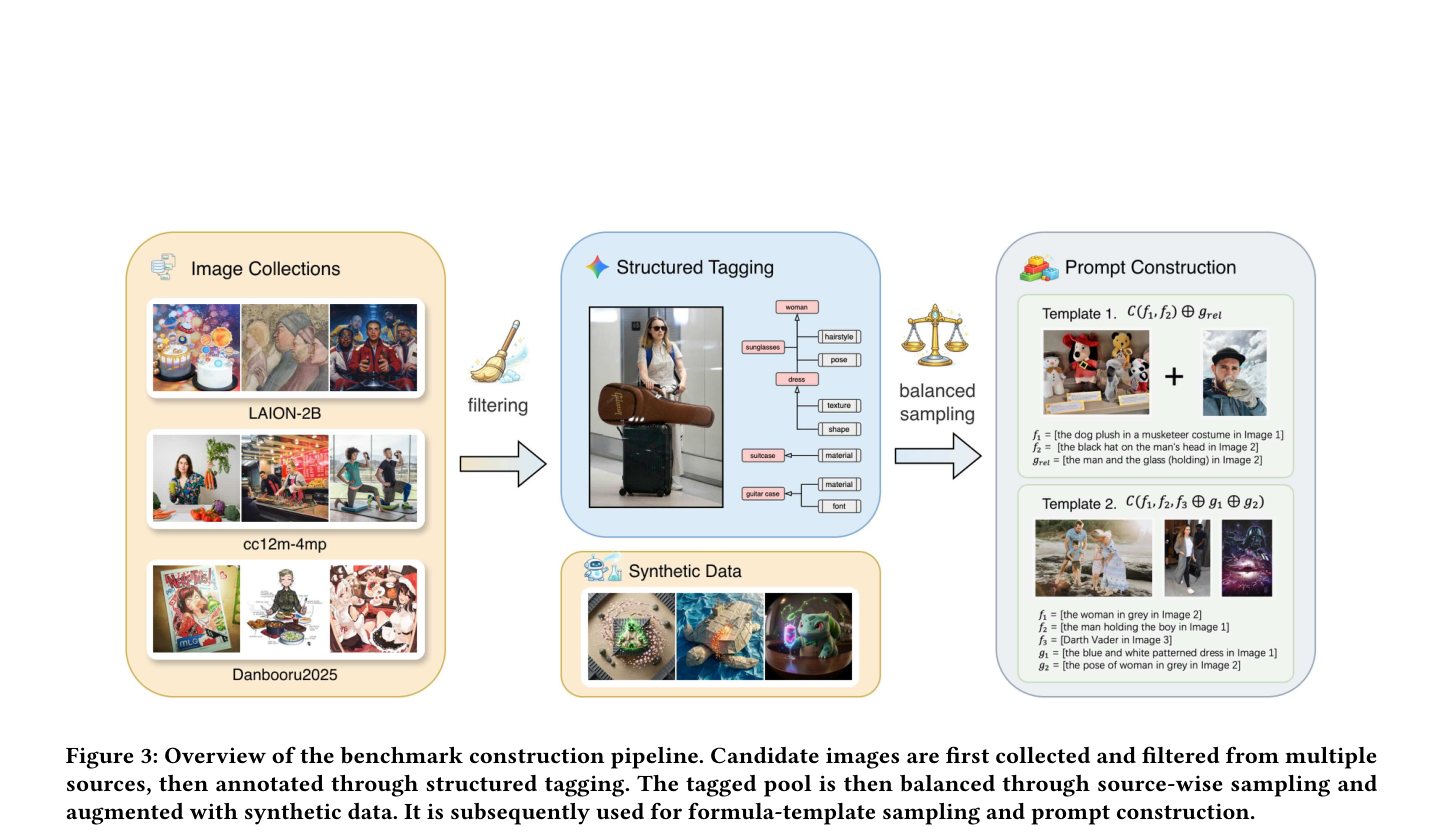
- 基准构建流程:从多个来源收集并过滤候选图像,经结构化标注形成标签池,通过源分布采样平衡并补充合成数据,最后基于公式模板采样生成提示。参考图池约8%通过筛选。
- 算子对齐评估协议:将每个公式项映射为细粒度能力检查项,由 VLM judge(Gemini-2.5-Pro)二元打分。附录 Table 7 报告了 VLM judge 集成与人工标注的一致性。
- 诊断树分析:从完整用例出发,递归应用全局参考剥离、组合展平、关系简化、属性移除等规则,将失败来源定位到 Global Reference、Joint Composition、Relation/Attribute 等类别。
- 应用抽象:虚拟试穿和合影排版可分别用公式表征,验证了四算子框架对实际工作流的覆盖能力。
逐图理解论文
一个失败案例
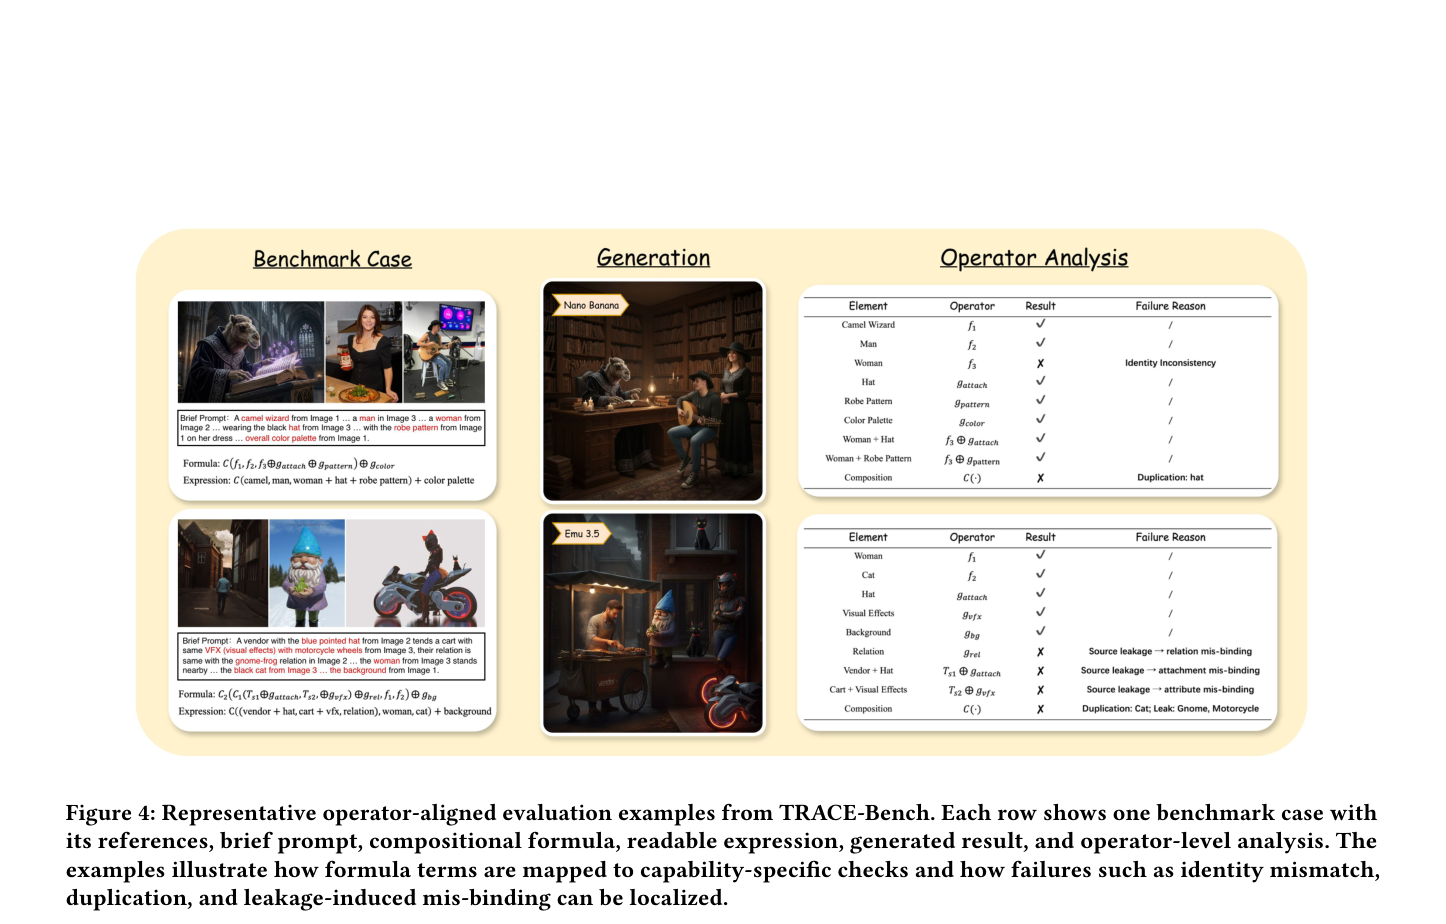
算子对齐评估的典型示例,每行展示参考图、提示、组合公式、可读表达式、生成结果和算子级分析。重点观察身份不匹配、重复、泄漏导致的错误绑定如何被定位到具体算子。
研究缺口
现有多参考基准,比如 MultiBanana 和 MICON-Bench,都是按预定义任务类型组织的。它们能告诉你模型在'虚拟试穿'或'合影排版'上的总分,但无法定位具体是哪个子能力出了问题。更关键的是,这些基准的结构复杂度不可控——你无法系统性地知道,当参考图从两张增加到五张时,模型到底在哪一步开始崩。
四算子分解与诊断树
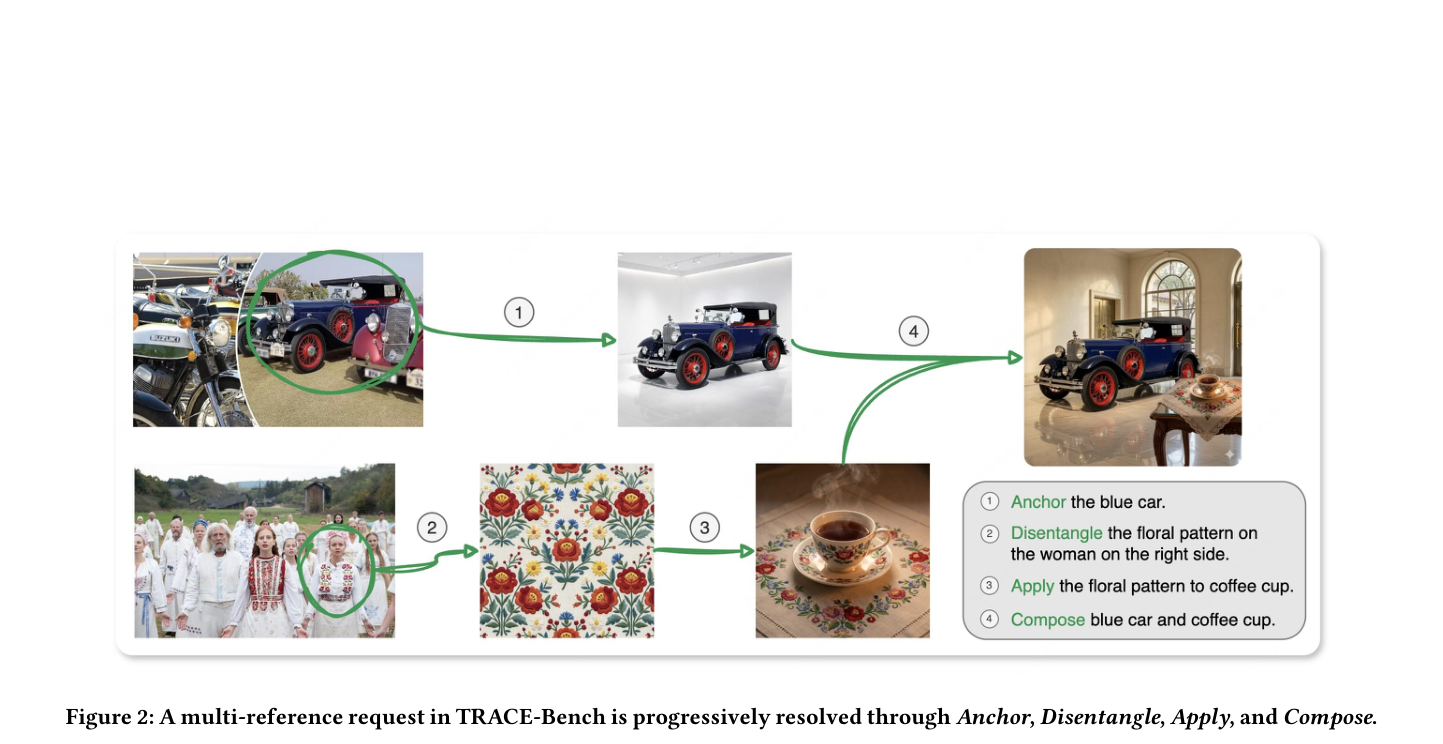
该图展示一个多参考请求如何逐步通过 Anchor、Disentangle、Apply、Compose 四个算子解析。注意每个算子对应的视觉元素变化,理解公式表征与生成过程的对应关系。
最强结论
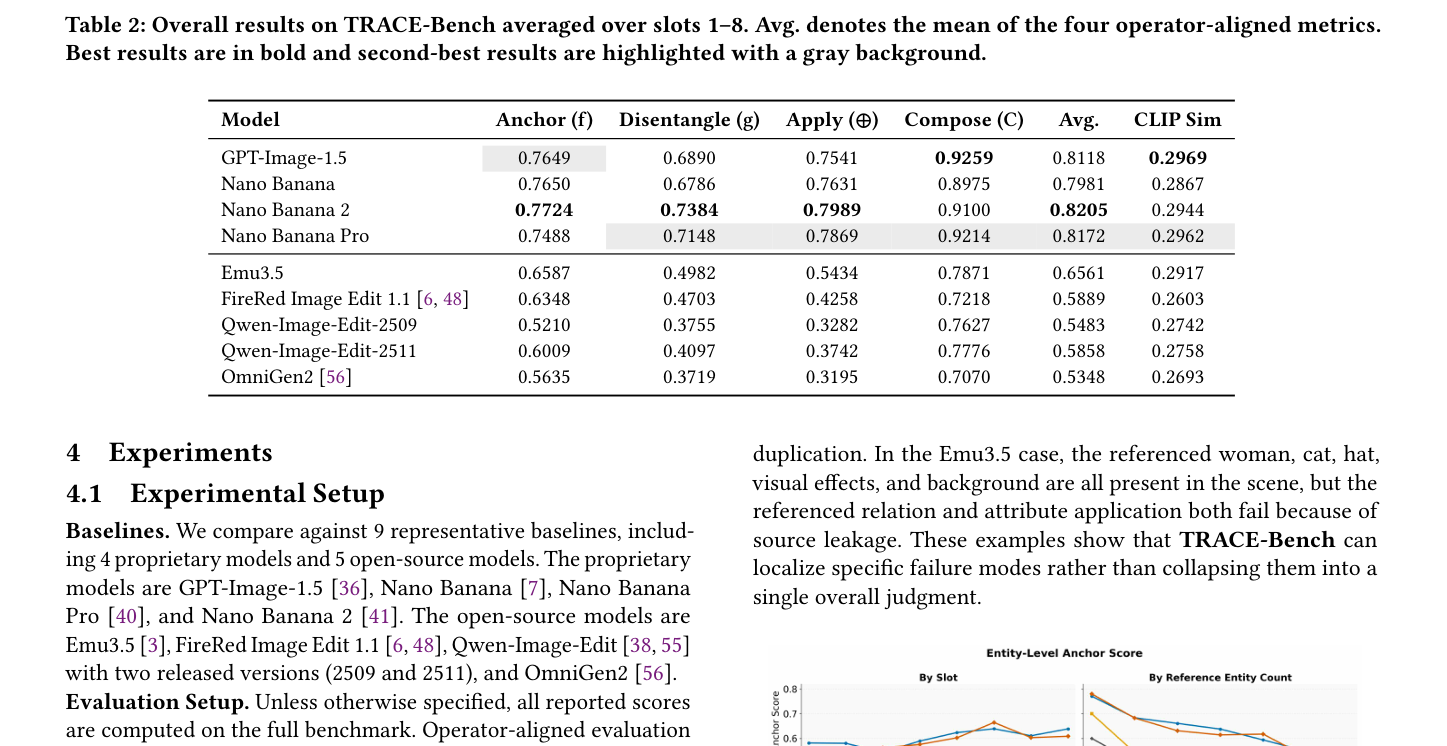
全量基准上9个模型的四算子指标与平均分。对比闭源与开源模型在各算子上的差距,特别关注 Disentangle 的普遍低分。
意义与局限
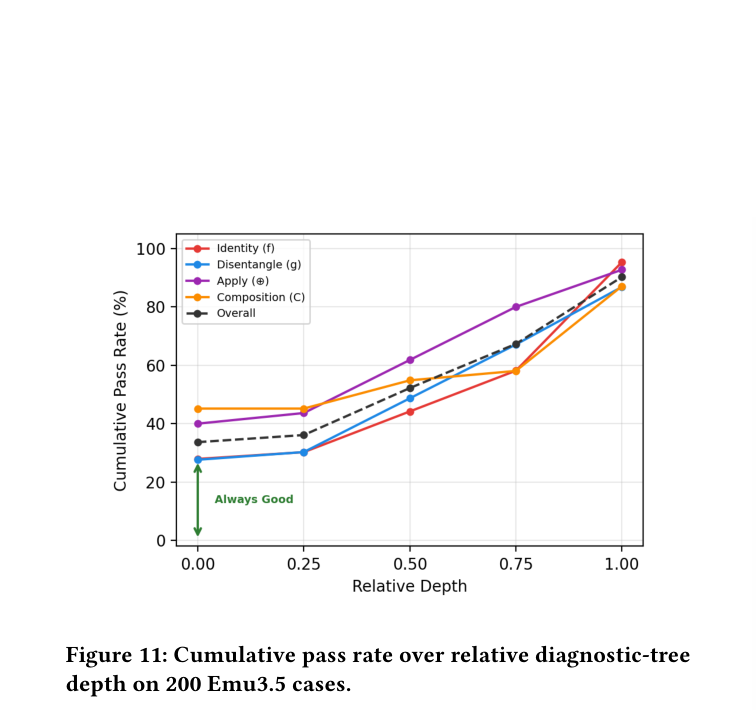
200个 Emu3.5 用例在诊断树相对深度上的累计通过率。观察曲线上升速度,判断哪些失败可通过简化消除、哪些是持久失败。
实验如何设计?
- 在 TRACE-Bench 全量基准上评估9个代表性模型(4个闭源、5个开源),报告四算子指标及 CLIP Sim 作为补充。
- 分析 Anchor 性能随 slot 数与参考图实体数的变化趋势(Figure 6)。
- 对200个 Emu3.5 用例构建诊断树,统计失败来源分布(Table 3)。
- 附录中报告跨 slot 性能(Figure 13)、disentangle 细粒度属性子类型分解(Figure 14)、诊断树相对深度上的累计通过率(Figure 11)。
- VLM judge 与人工标注一致性在200个采样用例上评估(Table 7)。
关键结果与论文证据
- Nano Banana 2 平均分最高(0.8205),GPT-Image-1.5 的 Compose 最高(0.9259),开源最佳 Emu3.5 平均 0.6561,其中 Disentangle 仅 0.4982(Table 2, p.7)。
- 诊断树200例中,Joint Composition 是 f/g/⊕ 的主导失败源(48.8%/43.4%/41.1%),而 C 的主导失败源为 Global Reference(29.0%)(Table 3, p.8)。
- Stable Success 总体 33.7%,Persistent Failure 总体 9.8%,说明多数失败可通过简化公式消除(Table 3, p.8)。
- Anchor 性能随 slot 数和参考图实体数增加而下降,支持 slot count 作为结构复杂度的可控度量(Figure 6, p.7)。
- 跨 slot 性能总体随 slot 数增加而下降(Figure 13, p.17)。
- Disentangle 在细粒度属性子类型上表现不均,部分子类型明显更弱(Figure 14, p.17)。
- VLM judge 集成与人工标注一致性非完美,评估结果受 judge 偏差影响(Table 7, p.15)。
- CLIP Sim 对属性是否绑定到正确目标不敏感,仅作补充指标(p.7)。
阅读时需要注意
- slot 数只度量公式结构,不完全决定用例难度。
- VLM judge 为二元打分,可能无法捕捉部分失败的严重程度。
- 诊断树分析仅在200个 Emu3.5 用例上统计,模型覆盖有限。
- 参考图池约8%通过筛选,可能存在分布偏差。
- 论文中 GPT-5.4 用于提示过滤,该模型名称未在参考文献中说明,需谨慎对待。
关联工作
- MultiBanana:多参考生成基准,扩展到8参考图并引入难度因子,但按任务组织、整体评分(p.3)。
- MICON-Bench:定义六类组合任务的多图上下文生成基准,任务导向(p.3)。
- MacroBench:4000样本、四个任务维度、最多10参考图,评估与构造逻辑部分对齐(p.3)。
- OmniContext:8类任务类别的上下文生成基准,范围限于主体中心组合(p.3)。
- DreamBooth / Textual Inversion:单参考个性化方法,非多参考原生设计(p.3)。
- GenEval / T2I-CompBench:文本到图像对齐与组合性基准,未覆盖多参考设置(p.3)。