快速导读:关键区别在这里:此前的方法最多只提取一种信号。有的用渲染像素做条件,有的注入学习到的特征,有的只传位姿。但没有一个方法同时利用渲染图像、可见性信息与重建token这三路信号。而这三路信号恰好互补:渲染图提供粗糙但确定的空间布局,可见性告诉模型哪些参考视角真正看得见目标区域,token则携带全局场景语义。SplatGuide的核心主张就是:把同一个3D高斯场景里的三路信号全部桥接给扩散模型,才能补上信息断裂。
SplatGuide 解决的是无位姿新视角合成中的一个结构性浪费:前馈重建模型已经产出了完整的3D高斯场景,但下游扩散模型通常只接收预测位姿,其余几何信息全部丢弃。论文将这种现象命名为信息断裂,并主张同时桥接渲染图像、可见性感知选帧与重建token三路信号来弥合它。
方法上,SplatGuide 分三阶段:前馈重建产出带源视角索引的3DGS场景;可见性感知选帧通过首次命中深度测试将索引渲染为目标视角投票图;扩散模型接收渲染图与重建token作为条件。实验证明,在固定生成器的前提下,仅更换选帧策略就能带来数dB的差距,且训练好的模型可零样本迁移到不同重建骨干。
英文题目:SplatGuide: Geometric Priors from 3D Gaussians for Pose-Free Novel View Synthesis
论文出处:arXiv 每日论文精选 · arXiv:2608.16863
原始论文:PDF / 论文页面
这篇论文解决什么问题?
无位姿新视角合成的难点在于:多视角扩散模型能生成逼真图像,但对位姿误差极其敏感;前馈重建模型能一次性恢复位姿和3DGS场景,却无法幻觉未观测内容。两者的结合是自然思路,但此前的工作只打通了单一信息通道。
SEVA 将预测位姿直接传给扩散模型,是位姿通道的代表;ViewCrafter 将DUSt3R点图渲染为像素级条件,是渲染通道的代表;Gen3C 通过交叉注意力注入密集特征,是特征通道的代表。但没有一个方法同时利用渲染图、可见性与特征token。
可见性信息尤其被忽视。参考视角选择通常依赖位姿距离或时间顺序的启发式规则,完全不考虑遮挡。一个视角可能位姿上离目标很近,但视线被遮挡物挡住,对生成毫无帮助甚至有害。
SplatGuide 的出发点正是:同一个3DGS场景里已经包含了渲染几何、逐高斯可见性线索与学习到的特征,把它们全部桥接给扩散模型,才是对重建结果最充分的利用。
核心创新
方法概览
关键区别在这里:此前的方法最多只提取一种信号。有的用渲染像素做条件,有的注入学习到的特征,有的只传位姿。但没有一个方法同时利用渲染图像、可见性信息与重建token这三路信号。而这三路信号恰好互补:渲染图提供粗糙但确定的空间布局,可见性告诉模型哪些参考视角真正看得见目标区域,token则携带全局场景语义。SplatGuide的核心主张就是:把同一个3D高斯场景里的三路信号全部桥接给扩散模型,才能补上信息断裂。
- 前馈重建阶段使用 WorldMirror 作为主骨干,输入N张无位姿图像,输出3D高斯场景、相机位姿、相机token与寄存器token。每个高斯额外携带一个源视角索引,记录它主要来自哪张输入图。
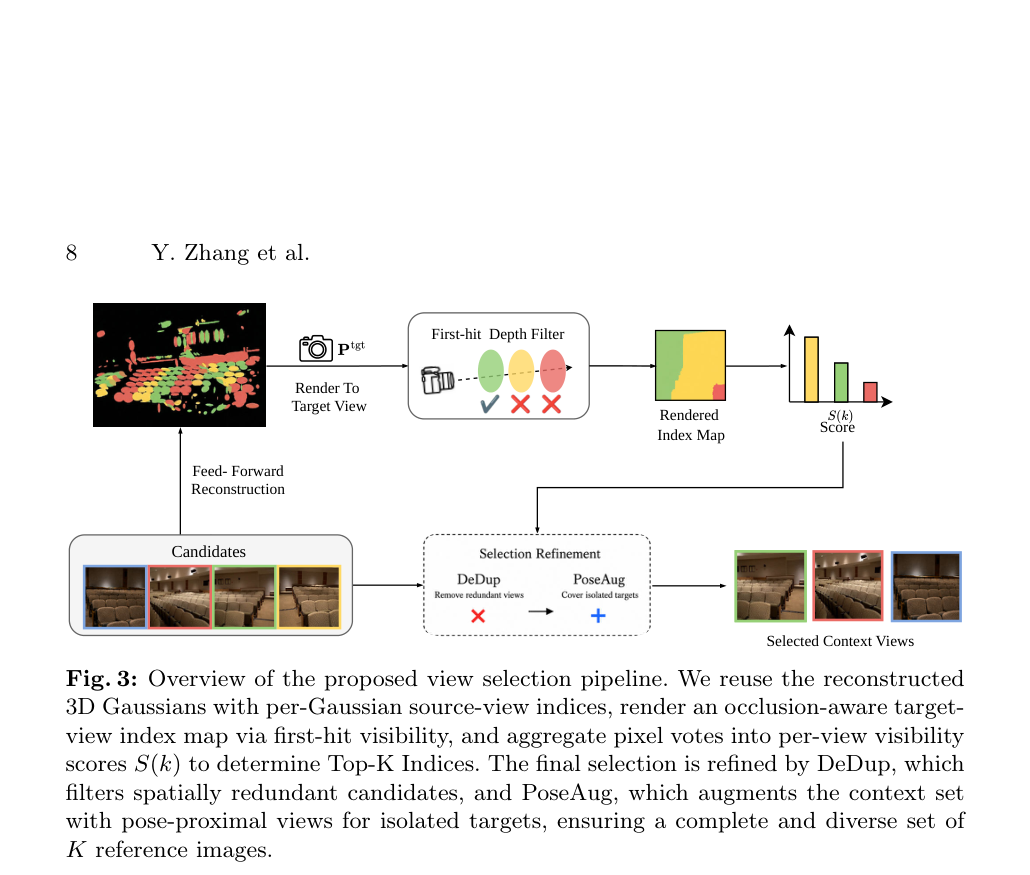
- 可见性感知选帧的核心操作是:将每个高斯的源视角索引渲染到目标视角,渲染时做首次命中深度测试,只保留沿每条光线最近的高斯。这样得到的索引图中,每个像素的值就是该像素真正可见的源视角编号。
- 对索引图做像素级投票,汇总得到每个源视角的可见性得分S(k)。得分高的视角意味着在目标视角下有更多可见像素,是更可靠的参考。
- DeDup 组件过滤空间冗余候选:按空间位置分块,用边际增益衡量每个候选视角带来的新增可见区域,避免选中一堆视角都覆盖同一块区域。
- PoseAug 组件处理孤立目标:当选出的视角无法覆盖目标区域时,用位姿邻近的视角补充上下文,保证参考集完整。
- 生成阶段基于 SEVA 的扩散框架:渲染的目标RGB、噪声与目标Plücker坐标在通道维拼接,选中的参考视角RGB与Plücker坐标作为上下文输入,重建token通过交叉注意力注入。
- 整个选帧过程的推理开销仅0.006秒,相比扩散采样的数十秒可以忽略不计。
逐图理解论文
失败案例:位姿之外的几何被浪费
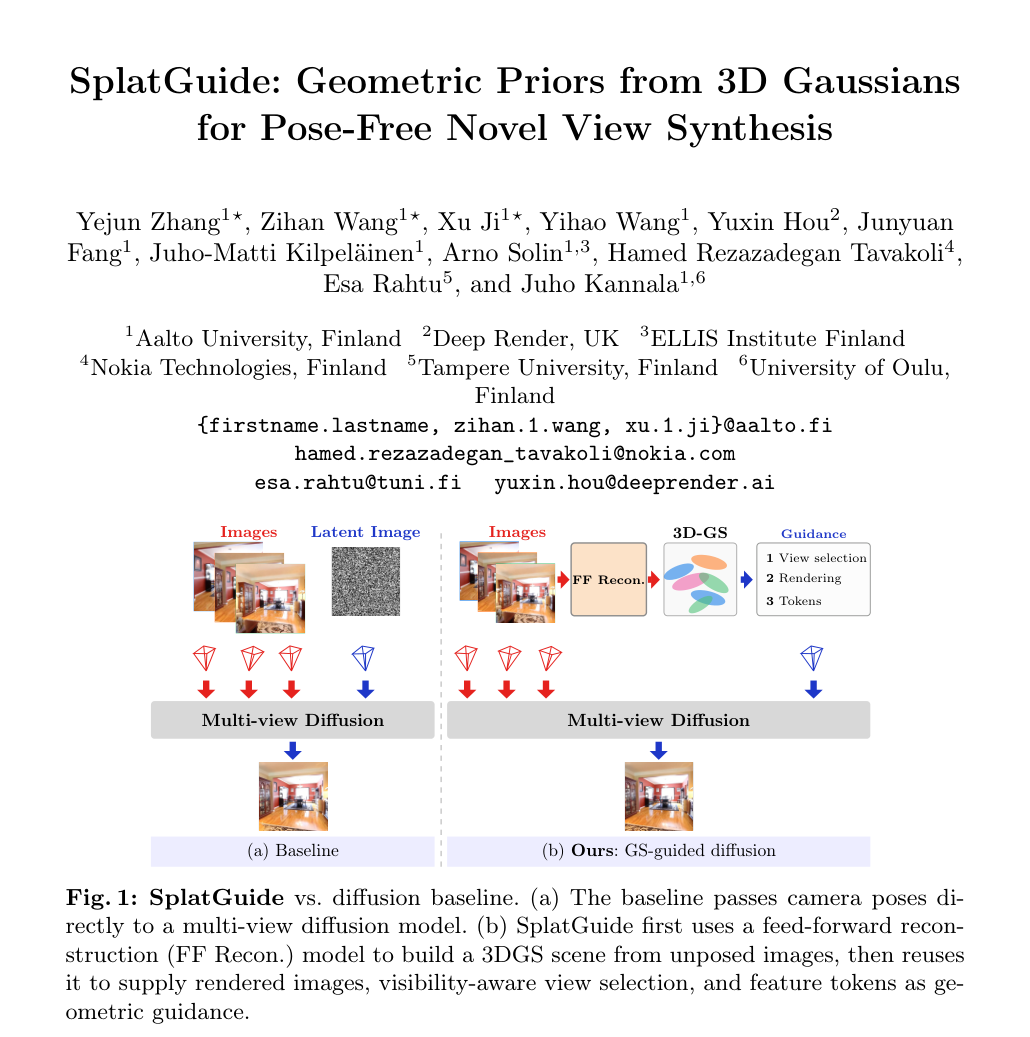
对比基线(仅传位姿)与 SplatGuide(复用渲染图、可见性选帧与特征token)的流程差异,直观展示信息断裂与三路桥接的核心主张。
研究缺口:三路信号同时桥接
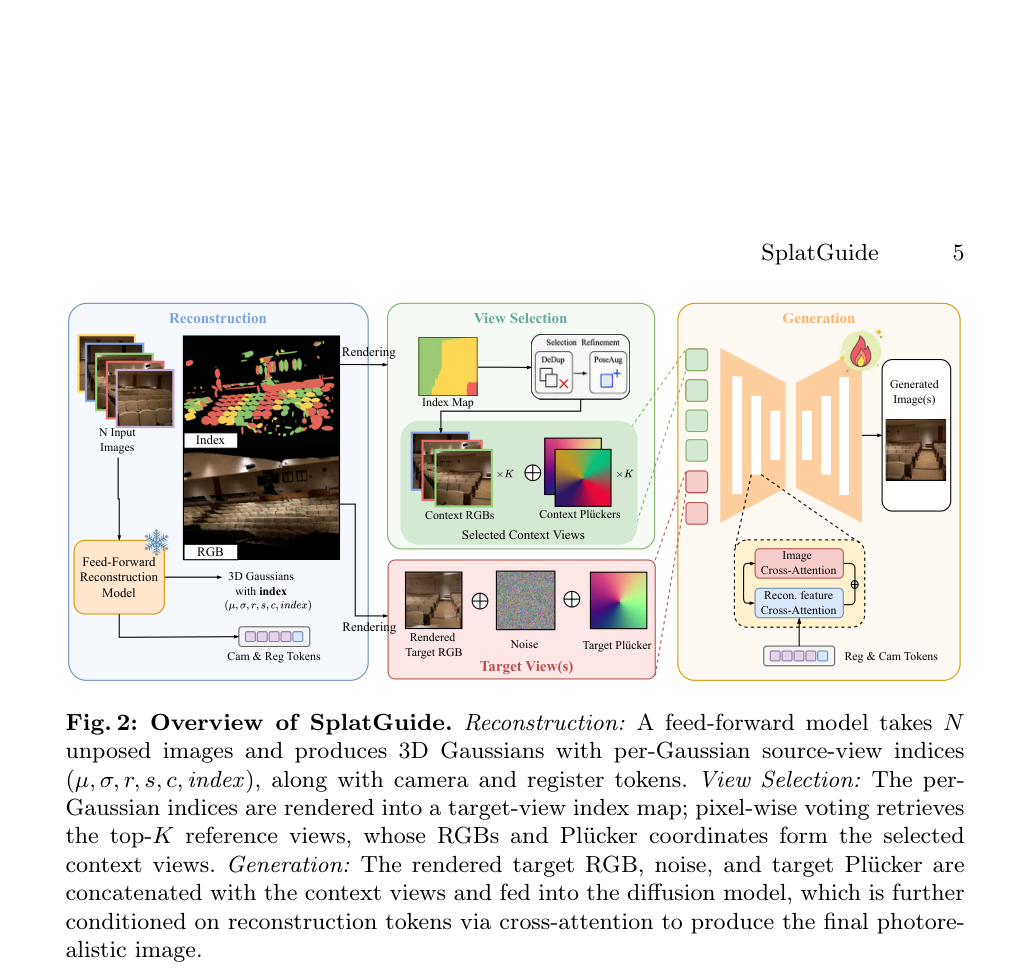
完整管线图:重建阶段输出带索引的高斯与token,选帧阶段渲染索引图并投票,生成阶段拼接渲染图与Plücker坐标并注入token,是理解方法全貌的关键图。
验证:选帧策略本身决定生成质量
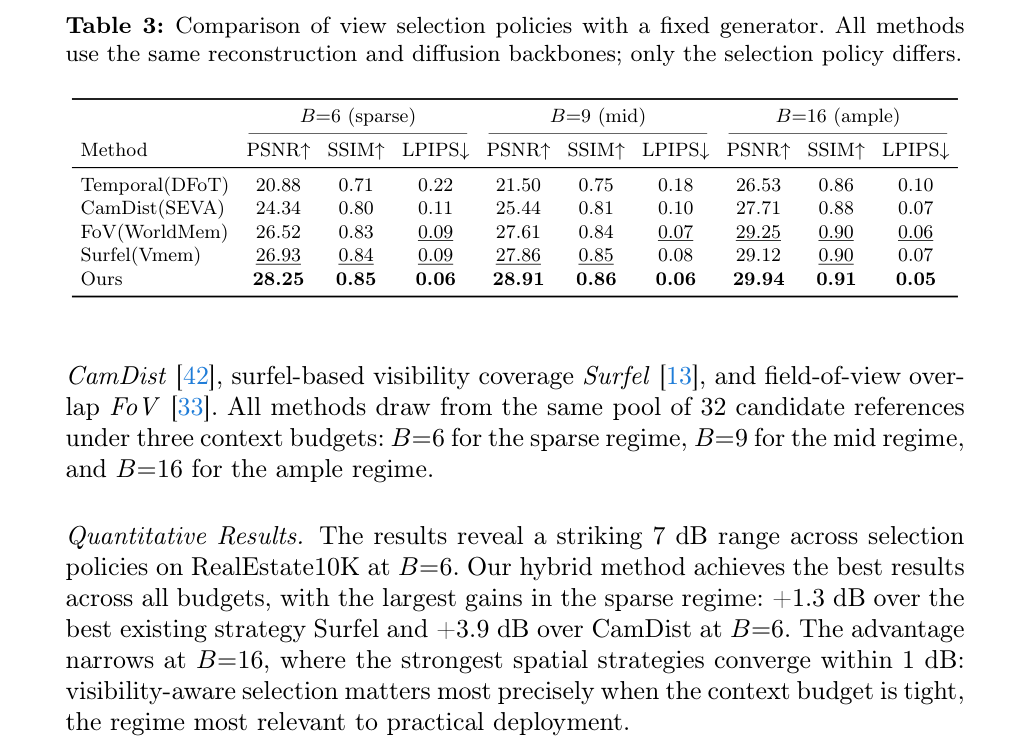
论文用了一个很干净的设计来验证核心主张:固定生成器不变,只换选帧策略。结果差距大到惊人——在同样的预算下,不同策略之间能差出七个dB。可见性感知选帧大幅领先基于位姿距离、时间顺序和视野覆盖的启发式方法。消融实验也证实,逐步加入渲染图和重建token,质量单调提升。更关键的是,用WorldMirror训练的扩散模型,换成AnySplat做重建骨干,不重新训练就能直接工作,说明这套几何指南是模块化的。
实验如何设计?
- 域内评测在 RealEstate10K 和 DL3DV 上进行,视角数分别为3、6、9,对比 SEVA、AnySplat、WorldMirror、Fillerbuster、ViewCrafter、RayZer、Matrix3D 等方法。
- 域外评测在 Tanks-and-Temples 和 Mip-NeRF 360 上进行,所有方法均不使用真值位姿。
- 选帧策略对比实验固定生成器不变,只更换选帧策略,在 RealEstate10K 上以预算B=6/9/16对比 Temporal、CamDist、FoV、Surfel 与 SplatGuide 的可见性感知选帧。
- 消融实验在 DL3DV 上以9视角逐步加入渲染图、相机token与寄存器token,测量每个组件的贡献。
- 零样本迁移实验用 WorldMirror 训练的扩散模型直接搭配 AnySplat 重建骨干,在 RealEstate10K 上评测,不进行任何微调。
- 补充实验包括候选池从32扩展到128的缩放测试、100+输入图像的大规模场景评测,以及选帧组件变体消融。
关键结果与论文证据
- RealEstate10K 3视角下,SplatGuide 的 PSNR 为26.52 dB,显著高于无位姿 SEVA 的23.47 dB;9视角下达到30.00 dB,超过使用真值位姿的 SEVA(27.57 dB),见第10页表1。
- DL3DV 9视角下,SplatGuide 的 LPIPS 为0.27,在所有视角数下均为最优,见第10页表1。
- 选帧策略对比中,预算B=6时 SplatGuide 的 PSNR 为28.25 dB,而 Surfel 为26.93 dB、FoV 为26.52 dB、CamDist 为24.34 dB、Temporal 仅20.88 dB,策略间差距达7 dB以上,见第12页表3。
- 消融实验显示,DL3DV 9视角下基线 PSNR 为15.64 dB,加入渲染图后提升至16.30 dB,再加入token后达到16.63 dB,LPIPS 相对降低16%,见第13页表4。
- 候选池从32扩展到128时,Tanks-and-Temples 长轨迹场景的 PSNR 从16.06 dB提升至17.21 dB,增益1.15 dB,见第14页表5。
- 零样本迁移实验中,AnySplat 骨干搭配 WorldMirror 训练的扩散模型在 RealEstate10K 9视角下达到31.29 dB,超过 WorldMirror 自身的30.00 dB,见第14页表6。
- 选帧组件消融显示,去掉 PoseAug 下降1.75 dB,同时去掉 PoseAug 和 DeDup 下降3.12 dB,见第22页补充材料。
- 推理开销方面,选帧仅需0.006秒,扩散采样71.8秒,端到端75.5秒,相比 SEVA 的62.9秒采样时间增加有限,见第23页补充材料。
阅读时需要注意
- 三路信号全部来自同一个重建结果,当重建骨干在纹理缺失、宽基线、重复结构或动态场景下退化时,所有信号同时失效,没有独立的几何线索兜底。
- 动态场景是最尖锐的失败案例:运动破坏重建一致性,也破坏首次命中深度测试背后的对应关系。
- 条件接口沿用 SEVA 的 Plücker 与掩码布局及上下文窗口长度设计,未验证其他多视角扩散骨干的兼容性。
- RayZer 在 DL3DV 上的高 PSNR 受低分辨率评测与输入填充影响,存在膨胀;ViewCrafter 的官方评测协议存在目标视角信息泄漏问题,相关对比需谨慎解读。
关联工作
- NoPo-Splat 是无位姿新视角合成的转折点,首次在单次前向中同时重建3DGS并合成新视角,但无法幻觉未观测内容。
- CAT3D 直接接收预测位姿,但因训练时使用真值位姿,对预测位姿的误差极为敏感,性能退化严重。
- VMem 使用 surfel 索引做可见性选帧,但需要对3D基元做激进下采样,几何判别力粗糙。
- Gen3C 通过交叉注意力注入密集 VGGT 特征,但需要真值位姿且计算开销大,与无位姿设定不可直接对比。
- WorldMirror 与 AnySplat 是两种前馈重建骨干,SplatGuide 的扩散模型用前者训练,零样本迁移到后者验证了模块化设计。