快速导读:HarnessEval-W 提出一种智能体化评估流水线,将世界模型评测分解为可验证的子问题,由专用子智能体推理并生成透明证据树,在 330 个案例上评估 18 个世界模型。
HarnessEval-W 的核心主张是:世界模型评测不应只输出一个标量分数,而应像人类评估者一样,把评测过程变成可解释、可验证的推理链。论文将 LLM 生态中成熟的 harness 范式引入交互式世界模型评测,提出 agentified evaluation 流水线,在 330 个案例上评估 18 个代表性世界模型。
该工作的关键设计是分层智能体架构:顶层 planner 根据案例上下文将评测路由到 skill library 中的适用技能,每个技能把评测问题分解为可测量的子问题,由专用 sub-agent 使用 VLM 后端回答,父智能体验证证据后聚合为最终分数。整个过程形成透明的 evidence tree,使分数可以追溯到具体失败的子问题。
英文题目:HarnessEval-W: Agentifying the Evaluation of Visual Worlds
论文出处:arXiv 每日论文精选 · arXiv:2608.16859
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有世界模型基准(如 VBench、VideoPhy、WorldScore)大多输出标量分数,缺乏可解释的推理链。当模型得分低时,研究者无法知道它到底在哪个环节失败:是渲染质量差、物理转移错误,还是长时演化中世界状态不连贯。这种不透明性严重限制了基准对模型改进的指导价值。
更根本的问题在于评测标准本身。交互式世界评估高度依赖上下文:同一个动作在不同场景下可能有完全不同的正确性标准。固定评分流水线(如 VLMEvalKit 代表的范式)难以适应这种上下文相关性,导致评测结果与人类判断偏差较大。
论文从 LLM 评测生态中找到了可借鉴的思路。Agent-as-a-Judge 范式已经证明,将评测过程建模为智能体的证据收集与推理工作流,可以显著提升评测的可解释性和可靠性。HarnessEval-W 将这一思路迁移到世界模型评测,填补了该领域在智能体化评测上的空白。
论文还给出了世界模型的形式化定义,将世界模型能力分解为三个评测轴:Observation Quality(观测质量)、Transition Correctness(转移正确性)、World Persistence(世界持续性)。这一分解为后续的智能体工作流提供了理论基础。
核心创新
- 首次将 LLM 生态的 harness 范式引入世界模型基准,实现智能体化评测流水线
- 分层智能体架构:案例特定技能路由 + 子智能体分解推理 + 父智能体验证聚合
- 每次评测生成透明证据树,分数可追溯到具体失败的子问题
- 基于世界模型因子分解(式1)构建三轴八设置的评测体系
- 智能体化案例构建流水线,含场景分类学采样与验证循环
- 可扩展技能库设计,支持新技能和案例的持续增长
方法概览
HarnessEval-W 采用分层智能体工作流:顶层根据案例上下文将评测路由到技能库中的适用技能,每个技能将评测问题分解为可测量的子问题并交由专用子智能体(使用 VLM 后端)回答,父智能体验证证据后聚合为最终分数,形成可追溯的透明证据树。评测围绕三个轴:Observation Quality、Transition Correctness、World Persistence,共 8 个详细设置。案例构建采用智能体流水线:场景分类采样、探针族分配、图像生成、图像接地规划与案例验证。
- 顶层 planner 接收案例的 prompt 和评测设置,从 skill library 中路由到适用技能,并为每个激活或跳过的技能记录 evidence-grounded 的理由。例如,当所有请求动作都保持可见时,Offscreen Evolution Verifier 会被跳过并记录原因。
- 每个激活的技能将评测问题分解为可测量的子问题。以 Intentional Change Verifier 为例,它将评测分解为八个子问题,每个子问题由专用 sub-agent 回答,sub-agent 检查 rollout 证据并返回离散分数及推理过程。
- 父智能体负责验证 sub-agent 收集的证据,确保推理链的可靠性,然后聚合为各维度分数和可解释的最终分数。整个流程形成 evidence tree,记录测试内容、视觉接地工具和完整逻辑链。
- 评测体系围绕三个轴展开,共八个详细设置。Observation Quality 评测渲染观测是否视觉可靠;Transition Correctness 评测状态转移是否忠实执行请求动作;World Persistence 评测状态序列在长时演化中是否保持连贯。
- 案例构建采用智能体流水线:从预定义的 scene taxonomy 和 probe family 采样初始世界设置,然后依次使用智能体进行世界生成、动作规划和案例验证,确保案例质量和评测有效性。
- skill library 设计为可扩展结构,每个技能定义适用性、证据、评分、验证与聚合规则,支持新技能和案例的持续增长,使基准能够适应未来更复杂的世界模型场景。
逐图理解论文
失败案例与直觉
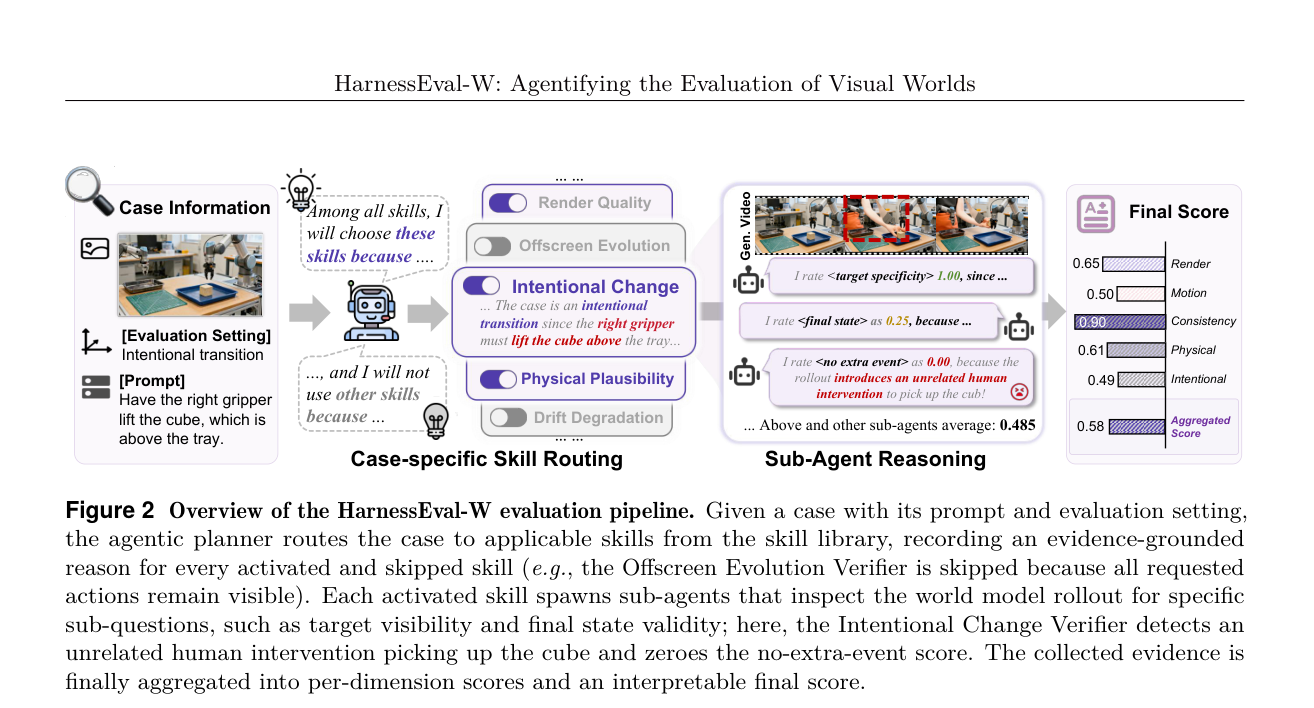
该图展示了完整评测流水线的一个具体案例:planner 为每个技能记录激活或跳过的理由,Intentional Change Verifier 检测到无关人类干预并将 no-extra-event 分数置零。注意证据如何被收集并聚合为可解释的最终分数。
核心贡献与方法
HarnessEval-W 的贡献是把评测过程本身变成智能体工作流。顶层 planner 根据案例上下文将评测路由到 skill library 中的适用技能,每个技能把评测问题分解为可测量的子问题,由专用 sub-agent 使用 VLM 后端回答,父智能体验证证据后聚合为最终分数。整个过程形成透明的 evidence tree,分数可以追溯到具体失败的子问题。评测围绕三个轴展开:Observation Quality、Transition Correctness 和 World Persistence,共八个详细设置。
验证与证据
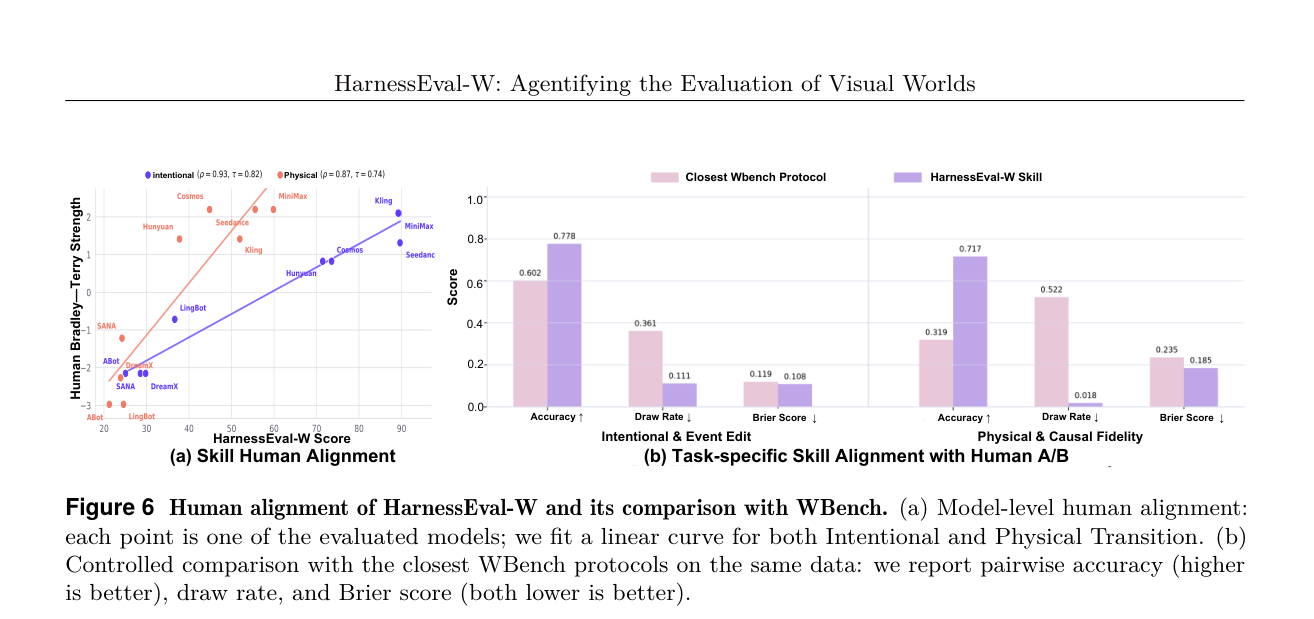
该图对比了 HarnessEval-W 与 WBench 的人类对齐和受控对比结果。左图显示模型级人类对齐的线性拟合,右图报告 pairwise accuracy、draw rate 和 Brier score,直观展示了智能体化评测的优越性。
结论与意义
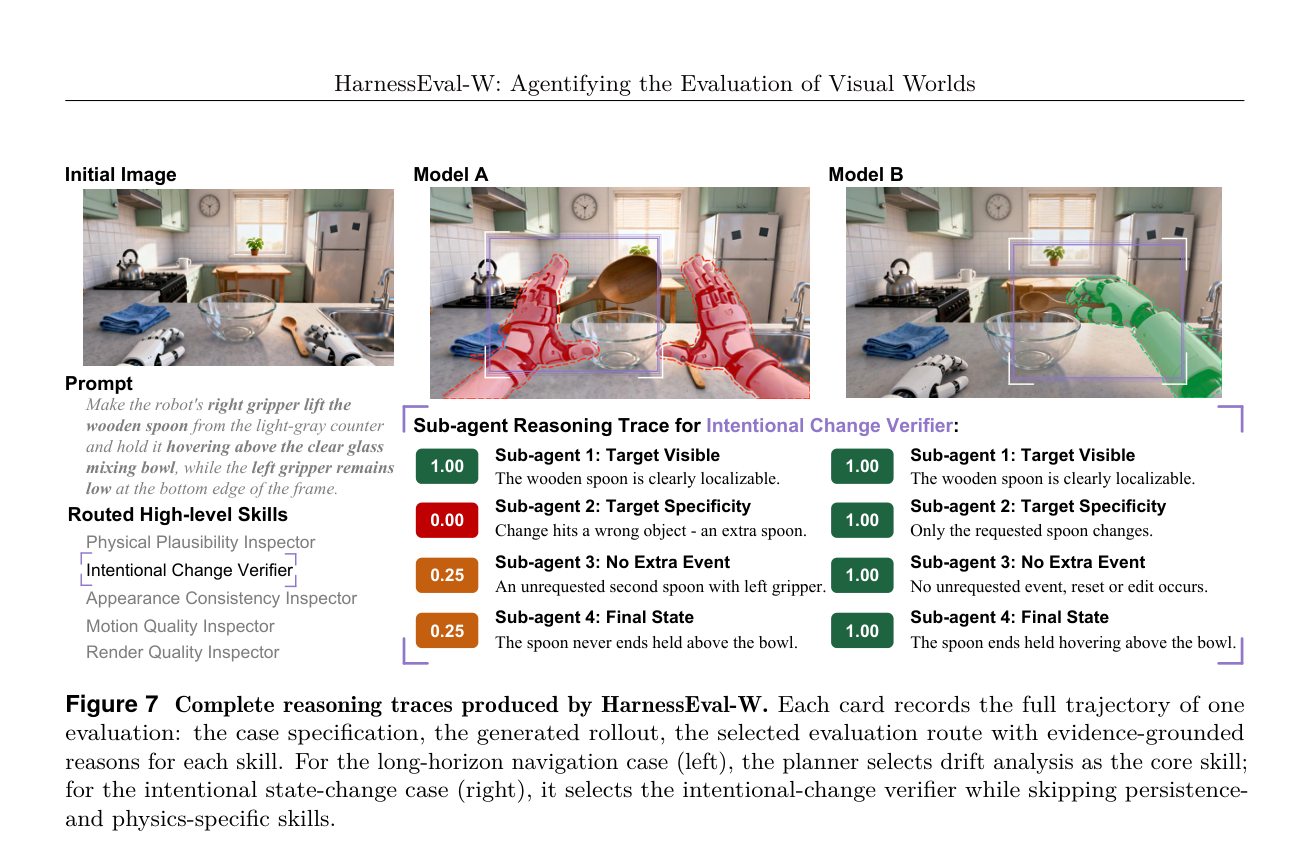
HarnessEval-W 证明了智能体化评测是世界模型基准的正确方向:它让分数从黑箱变成可追溯的证据链,让研究者能够定位模型失败的具体子问题。这一思路的价值超越了单一基准——它提供了一种可扩展的评测范式,skill library 可以持续增长以适应未来更复杂的世界模型。当然,评测质量仍受限于 VLM 后端的能力上限,这是当前方法的一个诚实边界。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在 330 个案例上评估 18 个代表性世界模型,涵盖文本驱动视频生成器、原生动作模型和相机位姿模型三类 conditioning interface。
- 人类对齐研究:收集 5000 条 A/B 判断,使用 Bradley-Terry 模型聚合人类偏好,计算 Spearman 和 Kendall 相关性来评估评测器与人类判断的一致性。
- 与 WBench 的 Event Edit 和 Causal Fidelity 协议在相同数据上做受控对比,报告 pairwise accuracy、draw rate 和 Brier score。
- 评测器鲁棒性实验:在 GPT-5.5 后端温度 0 下运行三次,比较 HarnessEval-W 与 WBench 的稳定性。
- 八评测轴间 Pearson 相关性分析,以及微调能力迁移分析(Wan 2.2→DreamX-World 与 HunyuanVideo 1.5→HY-WorldPlay 1.5)。
关键结果与论文证据
- 主榜单显示 Seedance 2.0 以 Overall 75.5 排名第一,Wan 2.7 以 75.0 紧随其后,Kling 3.0 和 MiniMax H3 分别以 74.4 和 74.3 位列第三、第四(第 10 页)。
- 人类对齐方面,Intentional Transition 的 Spearman ρ=0.93、Kendall τ=0.82,Physical Transition 的 ρ=0.87、τ=0.74,表明评测器与人类判断高度一致(第 11 页)。
- 对比 WBench,Physical 上 pairwise accuracy 从 31.9% 提升至 71.7%,draw rate 从 52.2% 降至 1.8%;Intentional 上 accuracy 从 60.2% 提升至 77.8%,draws 从 36.1% 降至 11.1%(第 11 页)。
- 鲁棒性方面,HarnessEval-W 三次运行拟合包络跨度仅 0.33 Bradley-Terry 单位,而 WBench 为 1.61 单位,即 HarnessEval-W 的包络窄 4.9 倍;相关性范围 0.928–0.964,远优于 WBench 的 0.646–0.780(第 11 页)。
- 相关性分析显示 Intentional 与 Physical Transition 强耦合(r=0.98),而 Exploratory Transition 与二者几乎无关(r=-0.15 和 r=-0.18),Render Quality 与 Physical Observation 几乎无相关(r=-0.04),说明评测轴捕捉到了不同的能力维度(第 13 页)。
- 微调能力迁移分析发现 DreamX-World 在 Intentional 上损失 11.9 分、Physical 损失 7.2 分,但 Revisit 增益 7.8 分;HY-WorldPlay 在 Intentional 上损失 24.2 分、Physical 损失 11.2 分,Revisit 增益 8.4 分,揭示了微调中的能力权衡(第 13 页)。
阅读时需要注意
- 评测依赖 VLM 后端(GPT-5.5),其能力上限可能约束评测质量,尤其在需要精细视觉推理的场景。
- 案例构建依赖文本到图像生成模型,初始图像质量可能影响评测有效性。
- 当前 skill library 覆盖范围有限,面对未来更复杂的世界模型场景可能不足。
- 人类对齐研究仅覆盖 Intentional 和 Physical Transition 两个设置,其他评测轴的人类对齐尚未验证。
- 论文为 arXiv 预印本,未经同行评审;部分被评测模型为闭源 API,结果可能受 API 版本变化影响。
关联工作
- VBench 将视频生成质量分解为多个维度进行评测,为 HarnessEval-W 的 Observation Quality 轴提供了参照。
- WBench 是多轮交互式视频世界模型基准,HarnessEval-W 与其 Event Edit 和 Causal Fidelity 协议做了直接对比,验证了智能体化评测的优势。
- MemoBench 测试动态变化环境中的世界建模,关注 offscreen 更新与重观察正确性,与 World Persistence 轴相关。
- Agent-as-a-Judge 范式在 LLM 评测中已证明智能体化评判的有效性,为 HarnessEval-W 的设计提供了先例。