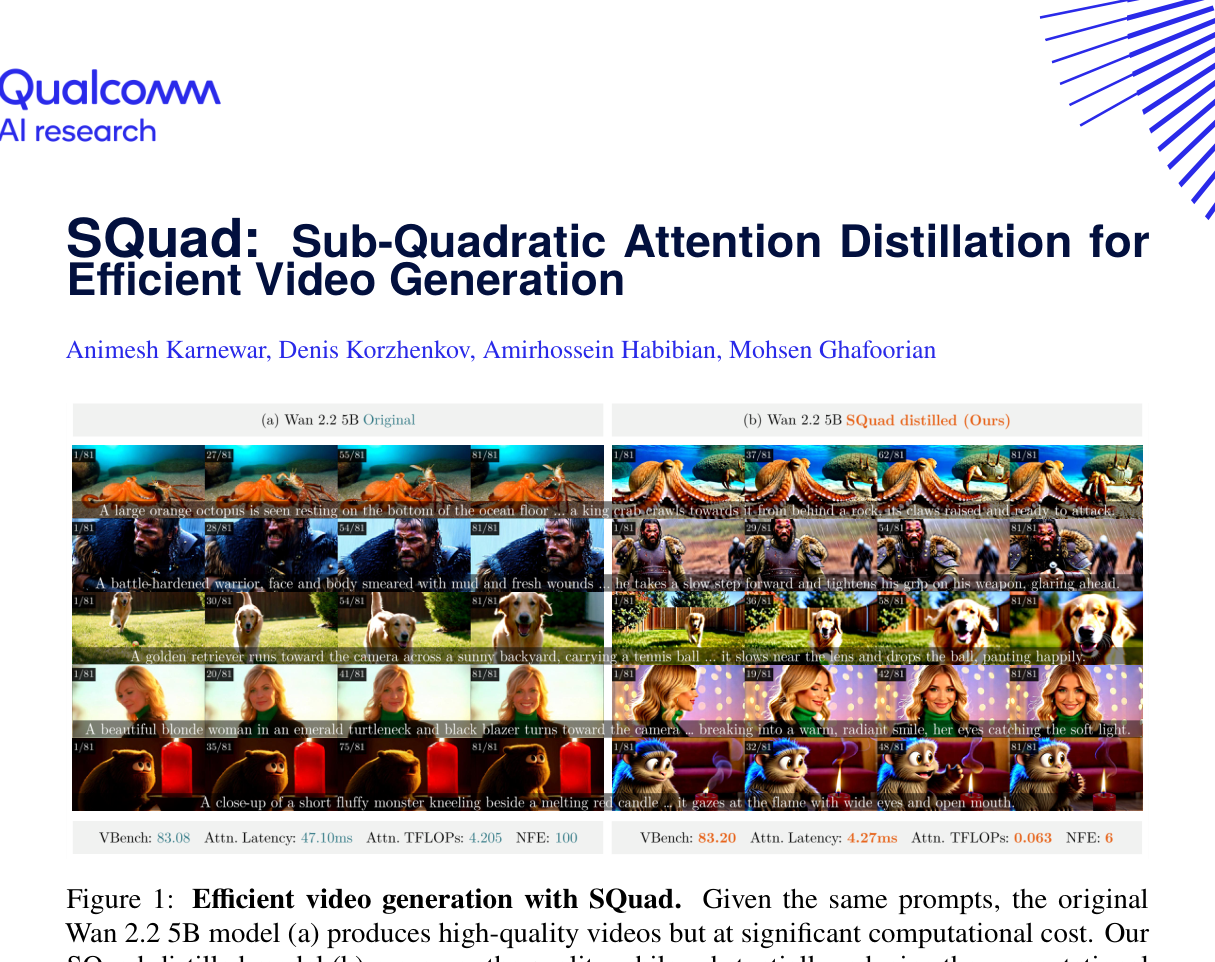
快速导读:SQuad 将视频 DiT 中的全 softmax 自注意力分解为局部窗口内与跨窗口全局两次 softmax 注意力,以 O(n√n) 复杂度蒸馏预训练模型,在 Wan 2.2 5B 上以 6 NFE 匹配原模型 VBench 质量并大幅降低计算成本。
视频生成模型普遍采用潜空间视频 DiT,自注意力是主要计算瓶颈。随着分辨率和时长提升,token 数 n 迅速增大,全 softmax 自注意力的 O(n²) 复杂度主导了计算与显存。SQuad 提出一种亚二次注意力蒸馏框架,将全 softmax 自注意力分解为局部窗口内与跨窗口全局两次标准 softmax 注意力,以 O(n√n) 复杂度蒸馏预训练模型,在 Wan 2.2 5B 上以 6 NFE 匹配原模型 VBench 质量并大幅降低计算成本。
论文的核心论点是:高效注意力不必牺牲 softmax 的表达力。过去的方法要么用线性或低秩代理替换 softmax,存在顽固的质量差距;要么用稀疏掩码保留 softmax,但引入数据依赖的 token 选择或专用 kernel。SQuad 证明,通过两次真实 softmax 注意力的组合,可以在保留全感受野的同时实现亚二次复杂度,且零新增参数、纯重索引实现。
英文题目:SQuad: Sub-Quadratic Attention Distillation for Efficient Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.16585
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视频 DiT 的自注意力复杂度为 O(n²)。在 Wan 2.2 5B 的典型配置 81×704×1280 下,token 数 n 达到 18480,注意力计算成为端到端延迟的主要来源。论文第 1 页指出,注意力 FLOPs 从 4.205 降至 0.063 TFLOPs,约 67 倍减少,说明注意力在原始模型中的占比之高。
现有高效注意力方法大致分三类。第一类用线性或低秩代理替换 softmax,如 ReHyAt 混合 softmax 与线性注意力,softmax 部分用 chunk-wise recurrence;这类方法损失了 softmax 的表达力,质量差距顽固。第二类用稀疏掩码保留 softmax,如 Radial Attention 基于时空能量衰减做静态 O(n log n) 稀疏掩码,VBench 总分虽高但延迟和 TFLOPs 更差;VSA 用可训练稀疏注意力,粗阶段定位关键区域、细阶段计算 token 级注意力,但携带 72–283M 额外权重。第三类采用混合架构,如 Attention Surgery 将预训练视频 DiT 的 softmax 注意力蒸馏为混合 softmax/线性形式。
这些方法的共同困境是:要么放弃 softmax 的表达力,要么引入数据依赖的 token 选择或专用 kernel。SQuad 的出发点正是打破这个二选一。
核心创新
- 提出 SQuad-Attention:将全 softmax 自注意力分解为局部窗口内 + 跨窗口全局两次标准 softmax 注意力的组合,全程保留真实 softmax,复杂度 O(n√n),零新增参数
- 证明单层 SQuad 通过两次 pass 的组合即可恢复全感受野(补充材料 D 节),而非依赖深度累积
- 推导最优窗口大小 w=√n,使局部与全局 pass 成本平衡(补充材料 F 节)
- 两阶段蒸馏方案:Flow-Matching SFT + DMD2,同时实现注意力替换适配与步数蒸馏(100→6 NFE)
- 纯重索引实现,无需自定义 CUDA kernel,可直接用 torch.compile 获得额外加速
方法概览
SQuad 将 SelfAttn 替换为 SQuadAttn:先将 Q/K/V 重排为局部视图(窗口内序列)和全局视图(跨窗口序列),先做局部 softmax 注意力(窗口大小 w≈√n),再做全局 softmax 注意力(跨窗口同位置 token),两次均为标准 softmax 注意力,仅通过纯重索引连接。蒸馏分两阶段:Stage 1 用 Flow-Matching SFT 在 VIPE 1M 数据集上重新适配权重;Stage 2 用 DMD2 分布匹配蒸馏恢复质量并将采样降至 6 NFE。
- SQuad-Attention 的核心操作:先将 Q/K/V 重排为局部视图(窗口内序列)和全局视图(跨窗口序列),先做局部 softmax 注意力(窗口大小 w≈√n),再做全局 softmax 注意力(跨窗口同位置 token),两次均为标准 softmax 注意力,仅通过纯重索引连接(第 5 页)。
- 两次 pass 不融合、不池化、不求和。局部输出进入全局 pass 的 value 槽位,全局混合作用在已经局部混合过的 token 上,因此单层 SQuad 通过两次 pass 的组合即可恢复全感受野,而非依赖深度累积(第 6 页,补充材料 D 节)。
- 窗口大小 w=√n 的推导:使局部与全局 pass 的成本平衡,复杂度为 O(n√n)(补充材料 F 节)。
- 零新增参数:与 VSA、Attention Surgery、ReHyAt 携带 72–283M 额外权重不同,SQuad 不引入任何可学习参数(第 8 页)。
- 纯重索引实现:无需自定义 CUDA kernel,可直接用 torch.compile(max-autotune)获得额外加速(第 10 页)。
- 两阶段蒸馏:Stage 1 用 Flow-Matching SFT 在 VIPE 1M 数据集上重新适配权重;Stage 2 用 DMD2 分布匹配蒸馏恢复质量并将采样降至 6 NFE(第 4 页)。
逐图理解论文
失败案例与直觉
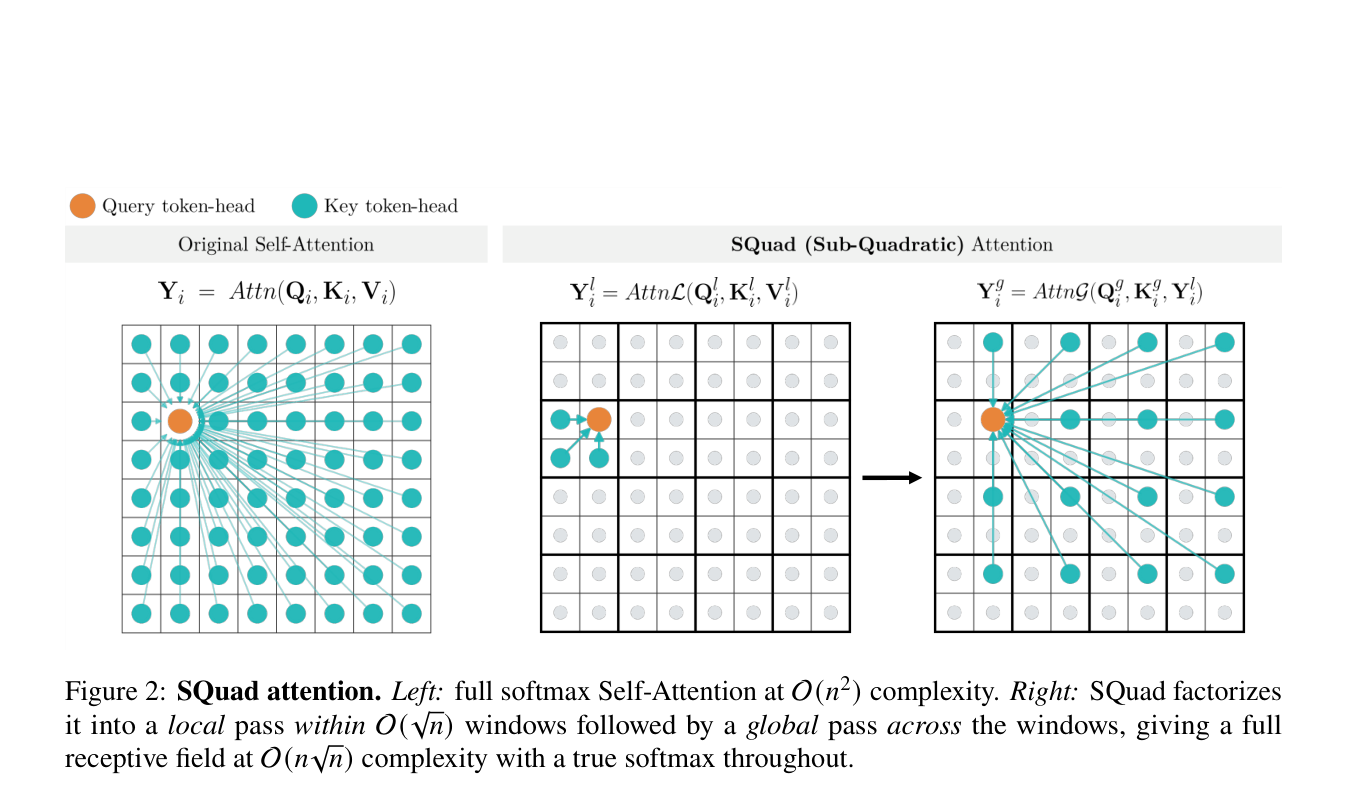
左侧展示全 softmax 自注意力的 O(n²) 复杂度,右侧展示 SQuad 的分解方式:局部窗口内 pass 加跨窗口全局 pass。注意右侧两次 pass 都是真实 softmax,这是与线性近似的本质区别。
核心区分:两次真实 softmax
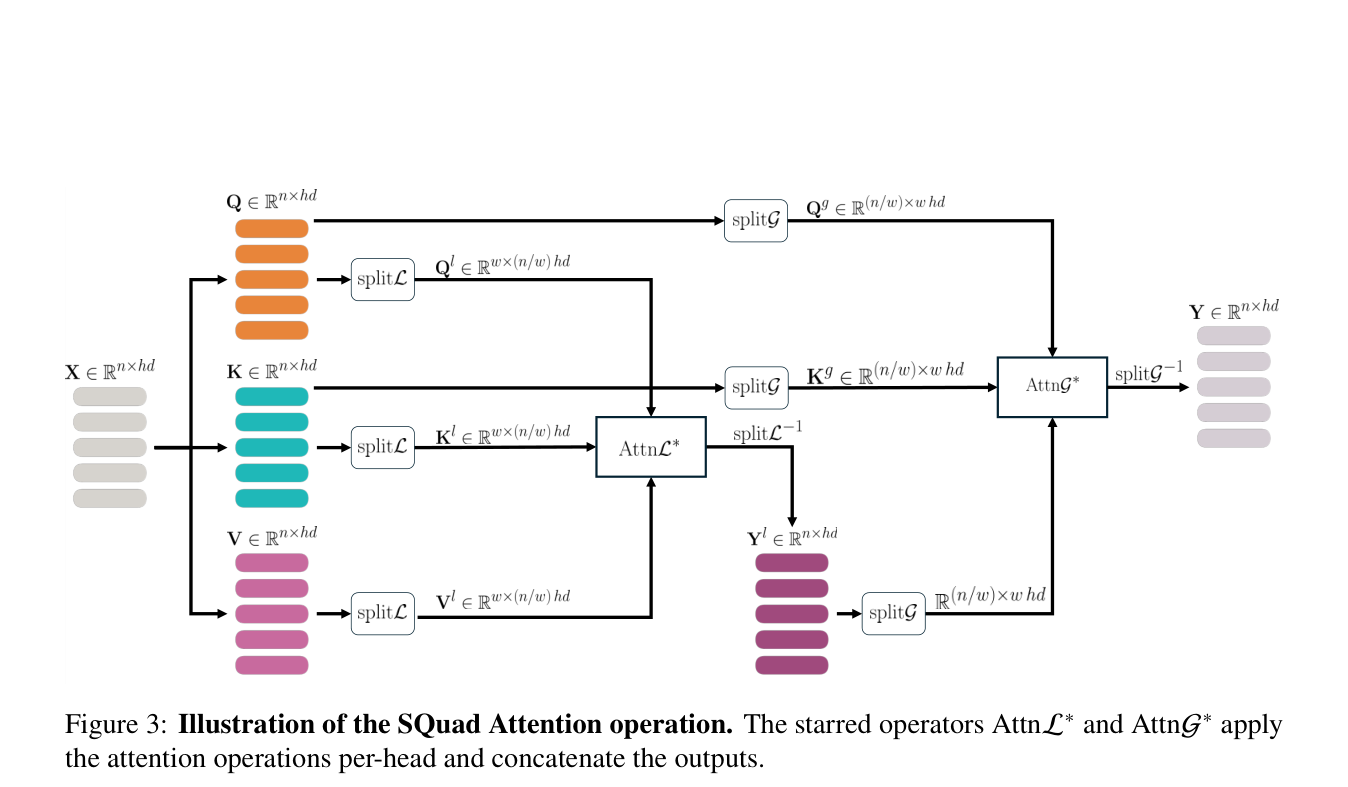
这张图展示 SQuad Attention 的具体操作流程,包括 Q/K/V 的重排和两次注意力操作。重点看局部输出如何进入全局 pass 的 value 槽位,这是恢复全感受野的关键机制。
论文的贡献与验证方式
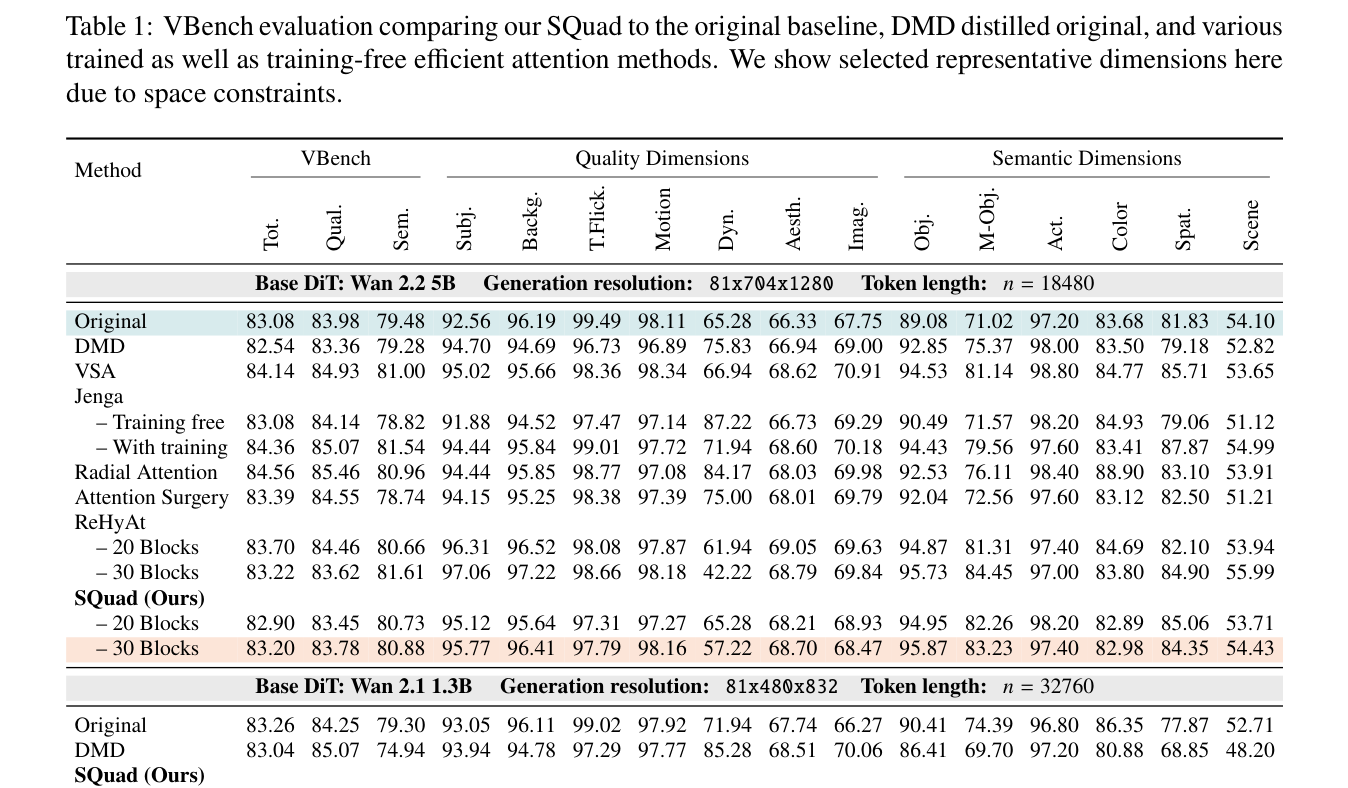
VBench 对比表显示 SQuad 与原模型、DMD 基线及多种高效注意力方法的质量对比。注意 SQuad 的 VBench Total 与原模型基本持平,而其他方法存在不同程度的质量差距。
最强结论
效率对比表显示 SQuad 在每 block 延迟和 TFLOPs 上的显著降低,且零新增参数。对比 VSA、Attention Surgery、ReHyAt 的额外权重,SQuad 的简洁性一目了然。
实验如何设计?
- 在 Wan 2.2 5B(81×704×1280,n=18480)和 Wan 2.1 1.3B(81×480×832,n=32760)上做 VBench 质量评估与效率对比(第 7 页)。
- 与 VSA、Jenga、Radial Attention、Attention Surgery、ReHyAt 等高效注意力方法对比(第 7 页)。
- 在 Wan 2.1 14B 上做效率评估,无蒸馏实验(第 8 页)。
- 1,179 对人工用户偏好研究:24 人,648 prompts,1,036 videos(第 9 页)。
- PyTorch eager 与 torch.compile(max-autotune)两种模式下的端到端 DiT 前向延迟测量(第 10 页)。
- 消融:SFT/DMD 两阶段必要性、局部/全局 pass 顺序、窗口几何形状(AR-preserving、spatial、temporal、isotropic)(第 9、11 页)。
关键结果与论文证据
- Wan 2.2 5B 上 SQuad 30 Blocks VBench Total 83.20 vs Original 83.08,质量基本持平(第 7 页,Table 1)。
- 注意力 FLOPs 从 4.205 降至 0.063 TFLOPs,约 67 倍减少(第 1 页)。
- 注意力延迟从 47.10ms 降至 4.27ms,约 11 倍加速(第 1 页)。
- 每 block 延迟从 62.01ms 降至 19.04ms(3.3 倍加速),TFLOPs 从 9.681 降至 5.548(1.7 倍减少)(第 8 页,Table 4)。
- 端到端 DiT 延迟 eager 模式 520ms vs Original 870ms(1.67 倍),compiled 模式 314ms vs 667ms(2.12 倍)(第 10 页,Table 5)。
- 用户研究:35% 偏好 SQuad,31% 无偏好,33% 偏好 DMD 基线,基本打平(第 9 页,Table 2)。
- 消融:SFT alone VBench 73.03,DMD alone 80.91,两者结合 82.99(30 Blocks),说明两阶段缺一不可(第 9 页,Table 3)。
- FLOPs 扩展性:5B 上注意力 FLOPs 减少从 67 倍(n=18480)增至 129 倍(n=73920),收益随序列长度增长(第 24 页)。
阅读时需要注意
- 蒸馏策略与步数蒸馏(DMD2)耦合,无法单独隔离注意力替换的贡献;纯 Flow-Matching 版本是下一步工作(第 11 页)。
- 仅探索了两 pass 组合,更多 pass 的深度组合可能进一步降低成本或提升表达力(第 11 页)。
- 未在视频以外的模态和领域验证泛化性。
- Wan 2.1 14B 上仅做了效率评估,未做蒸馏实验(第 8 页)。
- 论文中 SQuad 的 VBench 83.20 是在 6 NFE 下取得,而 Original 83.08 是 100 NFE,两者采样步数不同,需谨慎解读。
关联工作
- Attention Surgery:将预训练视频 DiT 的 softmax 注意力蒸馏为混合 softmax/线性形式,SQuad 与其对比效率与质量(第 3 页)。
- ReHyAt:混合 softmax 与线性注意力,softmax 部分用 chunk-wise recurrence,SQuad 与其对比(第 3 页)。
- VSA:可训练稀疏注意力,粗阶段定位关键区域、细阶段计算 token 级注意力,携带额外权重(第 3 页)。
- Radial Attention:静态 O(n log n) 稀疏掩码,基于时空能量衰减,VBench 总分高于 SQuad 但延迟/TFLOPs 更差(第 3 页)。
- DMD2:SQuad Stage 2 采用的分布匹配蒸馏方法,同时恢复质量并减少 NFE(第 4 页)。