快速导读:提出以能力为中心的数据基础设施,通过三个专用且互操作的数据引擎与能力对齐的分阶段课程调度,从零训练3B/6B多模态扩散模型。
本文提出一个核心问题:通用图像生成器的数据管线,究竟应该围绕'语料'还是围绕'能力'来组织?传统大规模图像生成的数据工作,如LAION-5B、COYO-700M的筛选,以及DALL-E 3的重标注,都在回答'如何构建更好的语料'。但本文认为,通用生成器需要同时掌握文本到图像生成、图像编辑、知识接地生成等多种能力,而这些能力之间存在依赖关系——例如,编辑指令的理解依赖于T2I阶段建立的视觉概念词汇。孤立优化每个任务的数据集,会忽视这种依赖,导致能力无法协同演化。本文的答案是:以能力为中心组织数据,让数据基础设施本身反映能力获取的依赖顺序。
英文题目:From Corpora to Co-Evolving Capabilities: Capability-Centric Data Design for Generalist Image Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.18076
原始论文:PDF / 论文页面
这篇论文解决什么问题?
传统图像生成数据管线将任务特定数据集孤立优化。T2I数据管线专注于图像-文本对齐质量,编辑数据管线专注于图像对构建,知识接地数据则独立收集实体-图像关联。这种分离带来两个问题:第一,每个任务的数据构建都从零开始,无法复用其他任务已经建立的概念空间;第二,训练时的数据混合比例是固定的,无法根据模型当前的能力状态动态调整。本文指出,现有工作如Qwen-Image和Seedream虽然在大规模数据管线上取得了显著进展,但本质上仍是在'语料'维度上优化,没有系统回答'能力依赖顺序'这一更根本的问题。
核心创新
- 能力特定数据管线:将数据构建按目标能力分离为T2I、编辑、知识接地三个互操作引擎,同时通过共享预处理和标注专家保持概念迁移
- 能力对齐课程调度:五阶段课程沿能力获取依赖顺序联合演化任务组成、概念分布、质量与分辨率,而非固定数据混合
- 跨任务标注桥接:编辑指令继承T2I标注的视觉词汇与描述结构,实现概念从T2I到编辑的迁移
- 多粒度T2I重标注:同一图像生成实体描述、标签、短提示、中长标注、长标注和密集描述的中英双语多风格监督
- 自然视觉关联挖掘:从网页共现、视频相邻帧、多面板合成图等自然关联图像中挖掘真实编辑对,补充合成变换的不足
- 缺陷感知数据保留:保留受控比例的退化图像并显式描述缺陷,使模型学会识别并避免生成视觉缺陷
- 能力差距驱动的主动反馈闭环:评估失败案例驱动邻近数据检索、专家构建和差距感知重采样
方法概览
构建能力驱动的数据基础设施:三个专用数据引擎(T2I、图像编辑、知识接地)分别构建文本-图像对齐、图像间变换和图像-知识关联监督;共享的VLM标注专家(Qwen3.5-27B初始化)统一T2I标注与编辑指令的词汇和描述结构;五阶段课程调度沿能力获取依赖顺序联合演化任务组成、视觉概念分布、数据质量和分辨率(256px→1024px);能力感知评估驱动定向检索、专家构建和差距感知重采样形成闭环。
- 三个专用数据引擎:T2I引擎构建文本-图像对齐监督,编辑引擎构建图像间变换监督,知识接地引擎构建图像-知识关联监督。三个引擎在数据收集和预处理阶段共享基础设施,但在监督构建上按能力分离。
- 共享VLM标注专家:以Qwen3.5-27B初始化的视觉语言模型统一T2I标注与编辑指令的词汇和描述结构,使编辑指令继承T2I标注中建立的视觉概念,实现概念从生成到编辑的迁移。
- 多粒度T2I重标注:同一图像生成实体描述、标签、短提示、中长标注、长标注和密集描述的多层级监督,覆盖不同粒度的提示跟随需求。
- 自然视觉关联挖掘:从网页共现、视频相邻帧、多面板合成图等自然关联图像中挖掘真实编辑对,补充合成变换的不足,使编辑监督更贴近真实用户意图。
- 缺陷感知数据保留:保留受控比例的退化图像并显式描述缺陷,使模型学会识别并避免生成视觉缺陷,同时支持退化感知修复能力。
- 五阶段课程调度:沿能力获取依赖顺序联合演化任务组成、视觉概念分布、数据质量和分辨率(256px到1024px),而非使用固定数据混合。
- 能力差距驱动的主动反馈闭环:能力感知评估识别失败案例,驱动邻近数据检索、专家构建和差距感知重采样,使数据优化从被动过滤转向主动定向。
逐图理解论文
失败案例与直觉
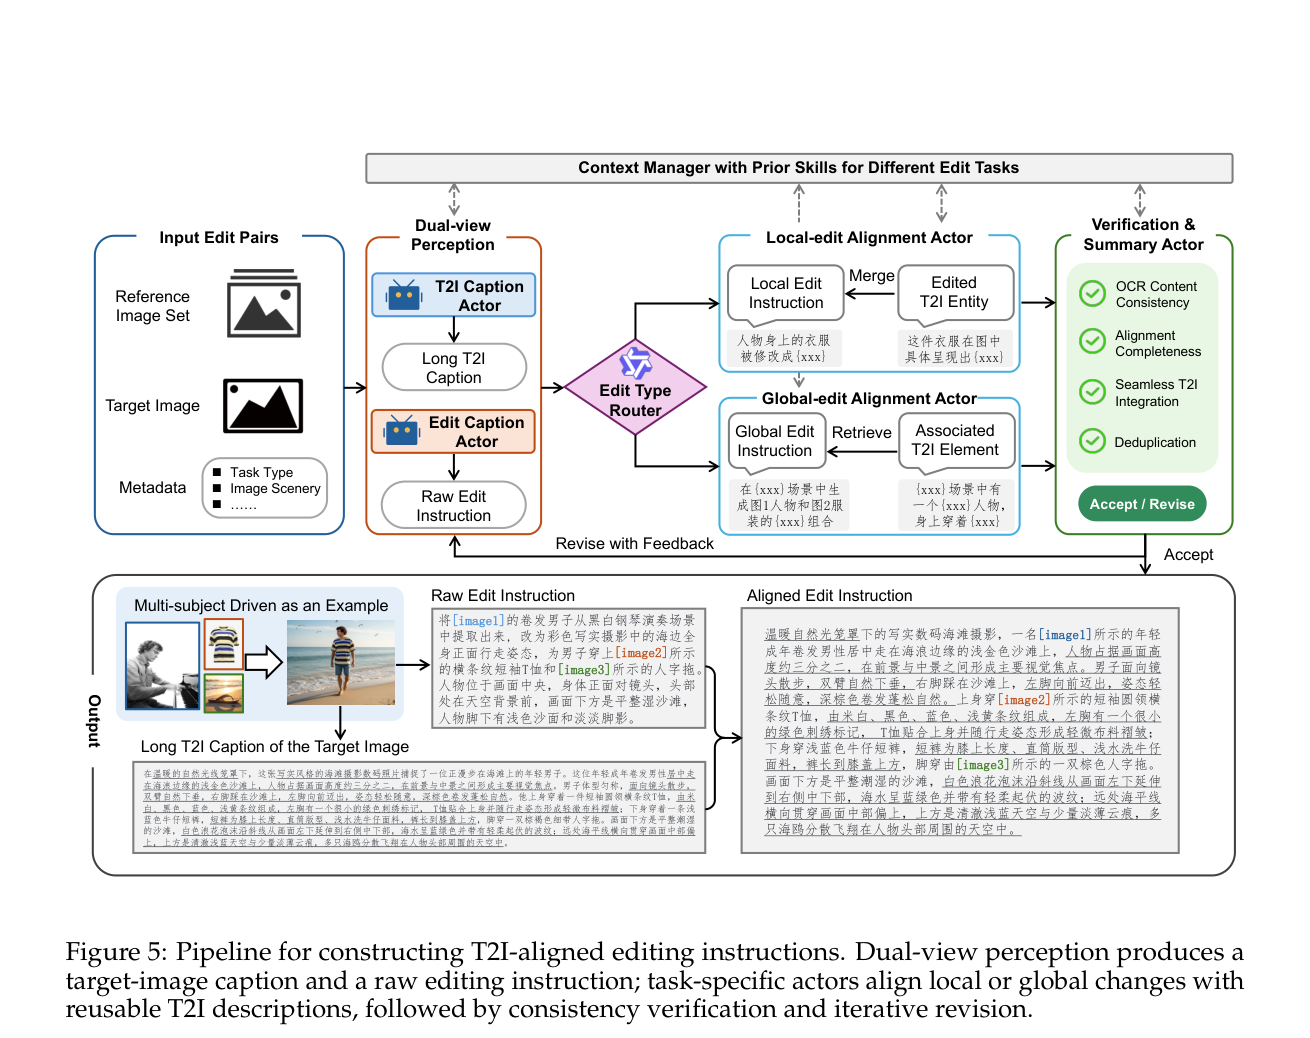
图5展示了T2I对齐编辑指令的构建管线。重点观察双视图感知如何同时产生目标图像标注和原始编辑指令,以及任务特定执行者如何将局部或全局变化与可复用的T2I描述对齐。
研究缺口
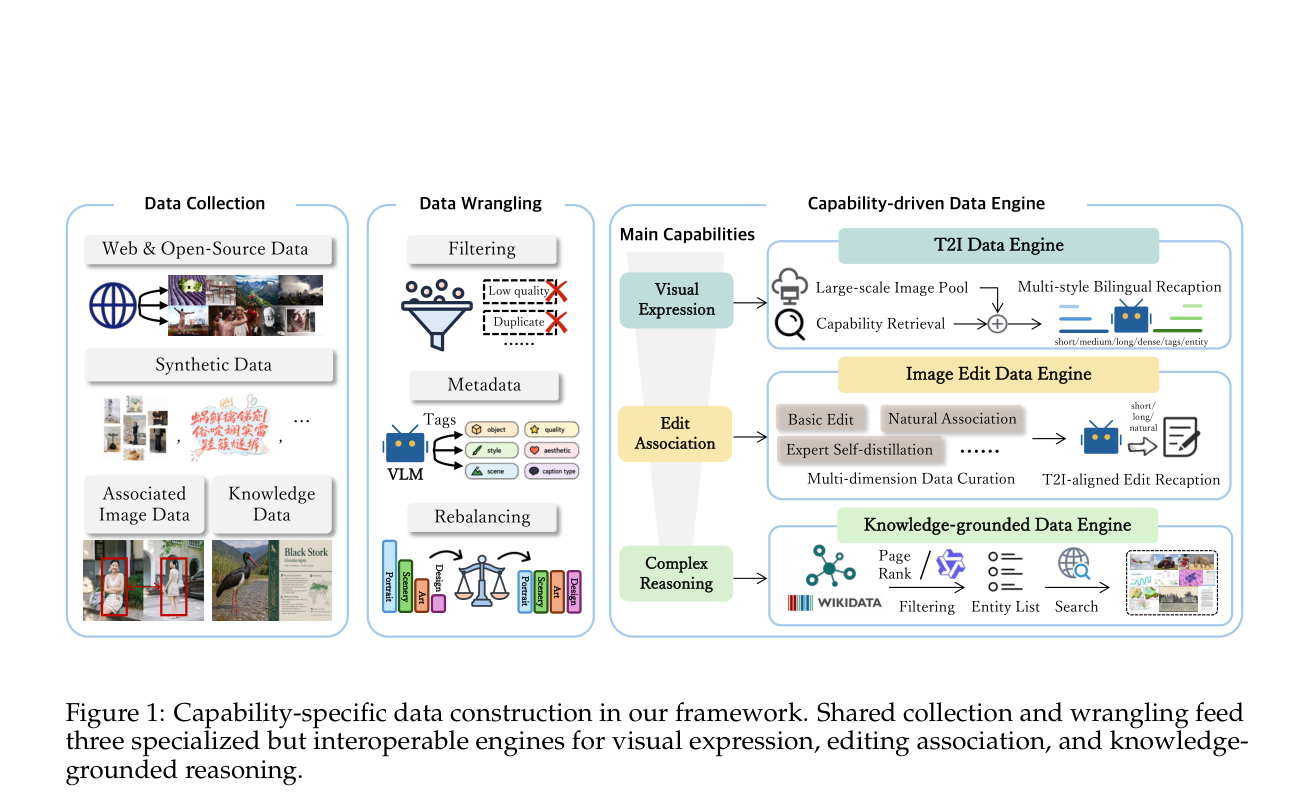
图1展示了能力特定数据构建的整体框架。重点观察共享收集与预处理如何同时服务于三个专用引擎,以及三个引擎之间的互操作关系——这体现了'分离构建但共享基础'的核心设计。
最强结论
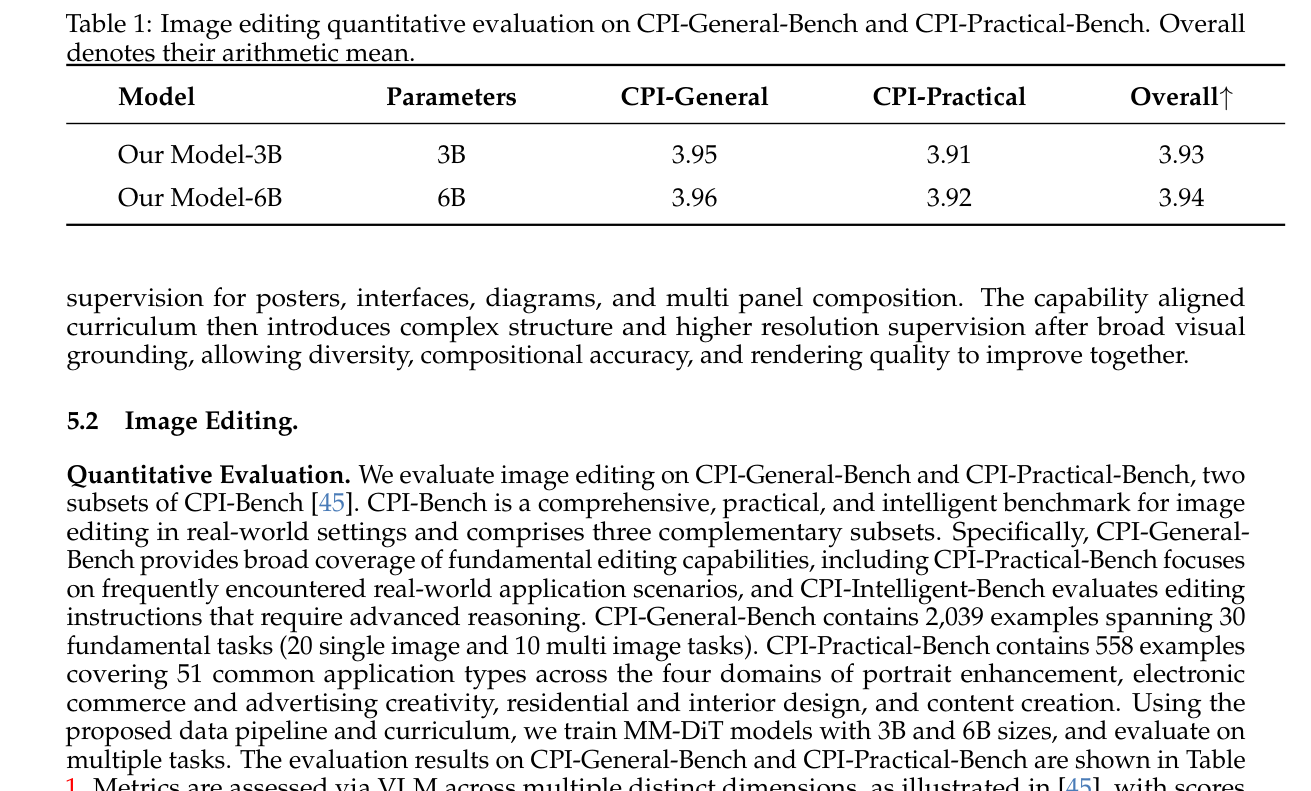
表1展示了CPI-Bench上的定量评估结果。可观察3B和6B模型在General和Practical两个子基准上的分数差异,以及综合分数的计算方式。
实验如何设计?
- 从零训练3B和6B两种规模的MM-DiT多模态扩散模型,验证数据基础设施的可扩展性。
- 在CPI-General-Bench和CPI-Practical-Bench上定量评估图像编辑能力,两个基准分别覆盖通用编辑和实用编辑场景。
- 定性评估T2I生成能力,覆盖插画、平面设计、知识可视化、人像、风景、多面板构图和摄影风格控制七类场景。
- 定性评估单图编辑能力,包括混合编辑、推理变换、目标分割和风格迁移四类挑战性任务。
- 定性评估多图编辑能力,包括视角对齐、参考关系理解和多主体组合,并区分含/不含显式图像索引两种设置。
- 定性评估退化感知修复能力,覆盖老照片修复、清晰度增强和运动模糊去除三类退化类型。
关键结果与论文证据
- 3B模型在CPI-General-Bench上取得3.95分,CPI-Practical-Bench上取得3.91分,综合3.93分(第12页,表1)。
- 6B模型在CPI-General-Bench上取得3.96分,CPI-Practical-Bench上取得3.92分,综合3.94分(第12页,表1)。
- T2I语料规模达到440M图像,编辑对规模达到120M高质量图像编辑对,图像-实体对规模约27M(第2页)。
- 知识实体筛选从100M+ Wikidata实体中筛选出约3M高显著性实体,确保知识接地监督的可靠性(第6页)。
- 定性结果显示模型在插画、平面设计和知识可视化等T2I场景中表现出稳定的风格控制和布局理解(第10页,图7)。
- 单图编辑定性对比显示模型在混合编辑和推理变换上优于对比基线,但在极端风格迁移上仍有改进空间(第11页,图8)。
- 多图编辑定性结果显示模型在视角对齐和参考关系理解上表现突出,显式图像索引设置下多主体组合更稳定(第13页,图10)。
- 退化感知修复定性结果显示模型能有效处理老照片和运动模糊,同时避免将有效内容误判为缺陷(第12页,图9)。
阅读时需要注意
- 论文仅报告CPI-Bench上的定量结果,缺乏与其他基线模型(如Qwen-Image-Edit、FireRed-Image-Edit、Flux.2-klein-9B)的定量对比,定性对比可能存在选择性展示。
- 未报告T2I生成能力的定量评估结果,仅有定性展示,无法量化T2I能力的实际水平。
- 未提供训练成本、数据管线计算开销等效率指标,难以评估方法的实际部署可行性。
- CPI-Bench为作者团队提出的基准,存在自评估偏差风险,定量结果的独立性需要外部验证。
关联工作
- LAION-5B、COYO-700M、MMC4等大规模图像-文本语料为本文提供了基础数据来源,本文从中筛选构建T2I语料。
- DataComp系统研究了固定候选池上的过滤与选择,本文将其扩展为能力驱动的数据组织,引入能力依赖维度。
- DALL-E 3证明了高描述性标注显著提升提示跟随能力,本文借鉴其重标注思想并扩展到多粒度监督。
- AnyEdit、OmniEdit、DreamOmni等图像编辑数据构建方法,本文结合操作特定构建与自然关联挖掘,形成更全面的编辑监督。
- DoReMi等数据混合优化方法依赖代理模型优化,本文以能力差距驱动替代,使数据混合直接响应模型的实际失败模式。