快速导读:提出CoinVE-200K数据集、CoinVE-Bench基准和CoinVE-Edit模型,系统解决多指令组合式视频编辑中指令干扰、区域定位和时序一致性问题。
指令引导视频编辑的核心挑战,在于让模型在同一段视频中同时理解并忠实执行多个编辑意图。现有数据集如OpenVE、Ditto大多聚焦单一编辑操作,指令短、目标单一,导致模型在面对组合指令时容易修改无关区域或忽略部分指令。CoinVE-200K的提出,正是为了填补这一数据与评测的系统性空白。
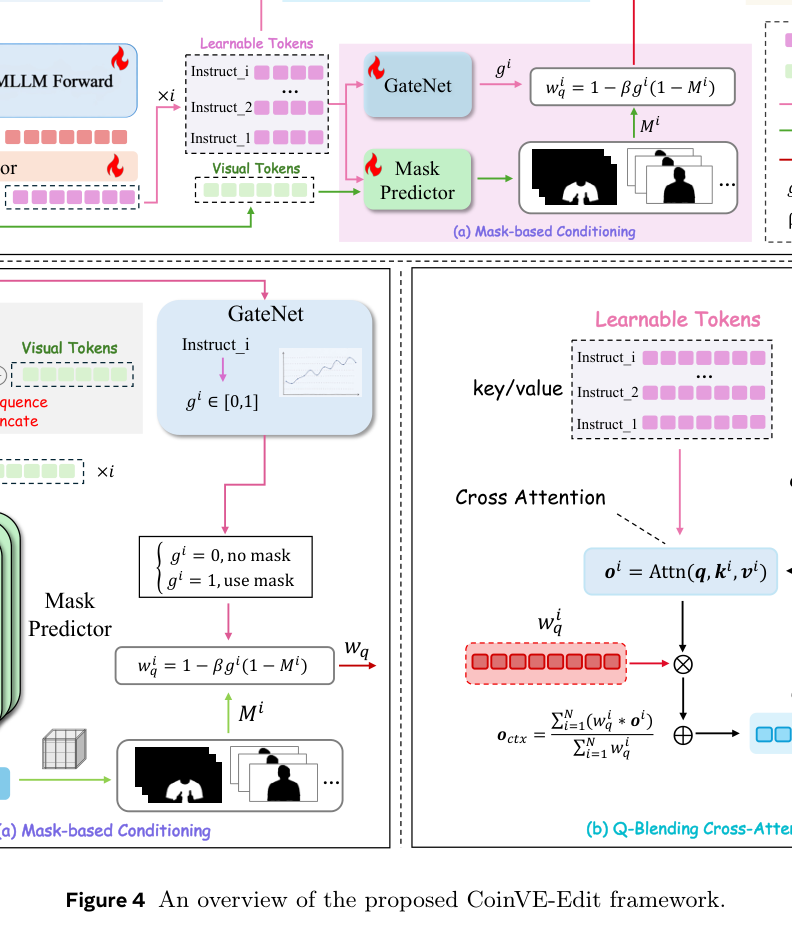
论文的贡献不止于数据。作者进一步提出CoinVE-Edit模型,通过Mask Predictor、GateNet与Q-Blending Cross-Attention三个模块,将多指令编辑从简单的文本拼接升级为区域感知的注意力解耦。配合CoinVE-Bench的十一项细粒度指标,论文构建了从数据、模型到评测的完整闭环。
英文题目:CoinVE-200K: A Large-Scale High-Quality Dataset for Compositional Instruction-Guided Video Editing
论文出处:arXiv 每日论文精选 · arXiv:2608.17566
原始论文:PDF / 论文页面
这篇论文解决什么问题?
指令引导图像编辑的成功,很大程度上依赖大规模高质量数据集的支撑。视频编辑在此基础上还需额外保证跨帧时序一致性,数据构建难度成倍增加。现有视频编辑数据集普遍存在指令短、目标单一、缺乏组合编辑标注的问题,导致模型在多操作编辑时出现编辑泄漏(Editing Leakage)和指令干扰(Instruction Interference)。
编辑泄漏指的是局部编辑错误地扩散为全局修改,例如要求只替换背景却连带改变了主体外观。指令干扰则表现为多条指令之间相互影响,模型可能只执行其中一条而忽略其余。这两个问题的根源在于:现有方法通常将多条指令简单拼接后注入模型,缺乏对每条指令作用区域的显式建模。
从模型角度看,基于DiT架构的视频编辑模型在交叉注意力层处理文本条件时,所有指令的语义信息被混合在一起。当指令数量增加时,注意力权重无法有效区分不同指令对应的空间区域,导致编辑结果出现串扰。这一结构性缺陷,是组合式编辑难以突破的根本原因。
核心创新
- 构建CoinVE-200K:200K个1080p视频编辑对,每样本含2-5个原子编辑操作,覆盖添加、移除、修改、风格化等类型
- 提出CoinVE-Edit:22B组合式视频编辑模型,通过区域感知注意力解耦实现多区域精确编辑
- 设计Q-Blending Cross-Attention:以软加权方式融合多指令注意力输出,避免硬掩码破坏预训练DiT特征分布
- 建立CoinVE-Bench:361个高质量源视频,11个细粒度指标覆盖编辑准确性、物理自然性、语义保持和视频质量四个维度
- 三阶段渐进训练策略:特征对齐预训练、单指令训练、组合指令微调,其中Mask Predictor和GateNet先离线训练再端到端联合优化
方法概览
CoinVE-200K通过三阶段流水线构建:基于Qwen3.6-27B解析视频内容分类(主体/物体/背景)并生成组合指令;利用SAM3关键帧分割和SAM2掩码传播实现掩码引导的视频合成(HunyuanImage-3.0/Nano Banana编辑关键帧,Wan2.2-Animate或VACE生成视频);经Gemini 2.5 Pro多维度质量过滤。CoinVE-Edit基于Wan2.1-T2V-14B和Qwen3-VL-8B,通过Mask Predictor预测时空编辑掩码、GateNet判断局部/全局编辑,Q-Blending Cross-Attention以软加权方式将多指令上下文注入DiT交叉注意力。
- 数据构建采用三阶段流水线:首先用Qwen3.6-27B解析视频内容,将场景分解为主体、物体、背景三类元素,并生成2-5条原子编辑指令;其次利用SAM3进行关键帧分割,通过SAM2实现跨帧掩码传播,以掩码引导的方式用HunyuanImage-3.0或Nano Banana编辑关键帧,再用Wan2.2-Animate或VACE生成完整视频;最后经Gemini 2.5 Pro进行多维度质量过滤。
- CoinVE-Edit基于Wan2.1-T2V-14B作为视频DiT生成骨干,以Qwen3-VL-8B作为多模态大语言模型基础。模型接收源视频与多条编辑指令,输出编辑后的视频。
- Mask Predictor负责将每条指令定位到具体的时空编辑区域,输出与视频帧对应的编辑掩码。该模块离线训练后IoU达到0.71,为后续的区域感知注意力提供精确的空间约束。
- GateNet是一个二分类门控网络,判断每条指令属于局部编辑还是全局风格化操作。其离线训练准确率为0.95,有效避免了风格化指令被错误地限制在局部区域。
- Q-Blending Cross-Attention是核心创新。与硬掩码偏置注入(Q-Bias)不同,它按查询token对多条指令的注意力输出进行软加权融合,避免破坏预训练DiT的特征分布。公式层面,每个查询token的注意力输出由各指令的注意力结果按其对应的掩码权重加权求和得到。
- 训练采用三阶段渐进策略:第一阶段用约2M图像编辑样本进行特征对齐预训练,第二阶段用0.9M视频编辑样本进行单指令训练,第三阶段在CoinVE-200K上进行组合指令微调。Mask Predictor和GateNet先离线训练,再与主干网络端到端联合优化。
逐图理解论文
失败案例与直觉
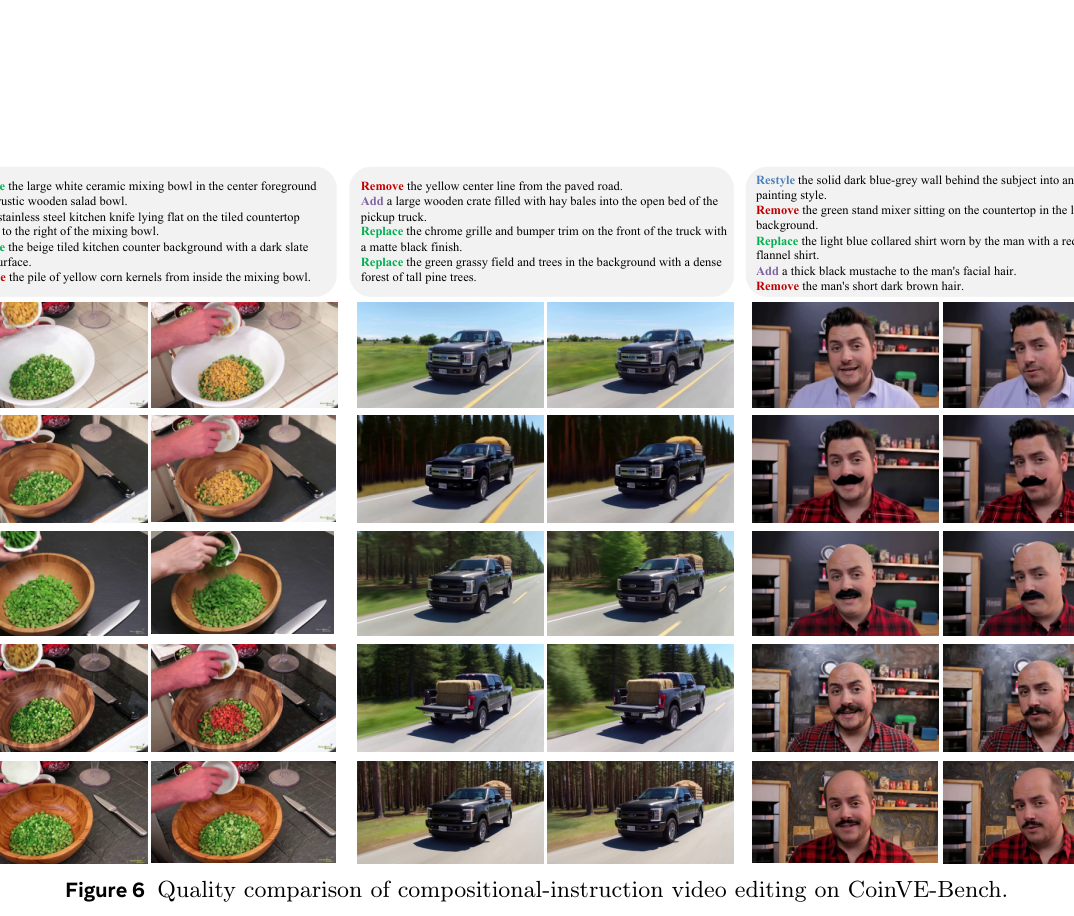
想象你要求模型同时完成两件事:把背景换成雪景,再把人物的外套改成红色。现有方法通常把这两条指令简单拼在一起,结果往往是背景换好了,外套却纹丝不动;或者外套变红了,背景却莫名其妙地跟着变色。这种编辑泄漏和指令干扰的根源,在于模型无法区分每条指令到底该作用于画面的哪个区域。
研究空白
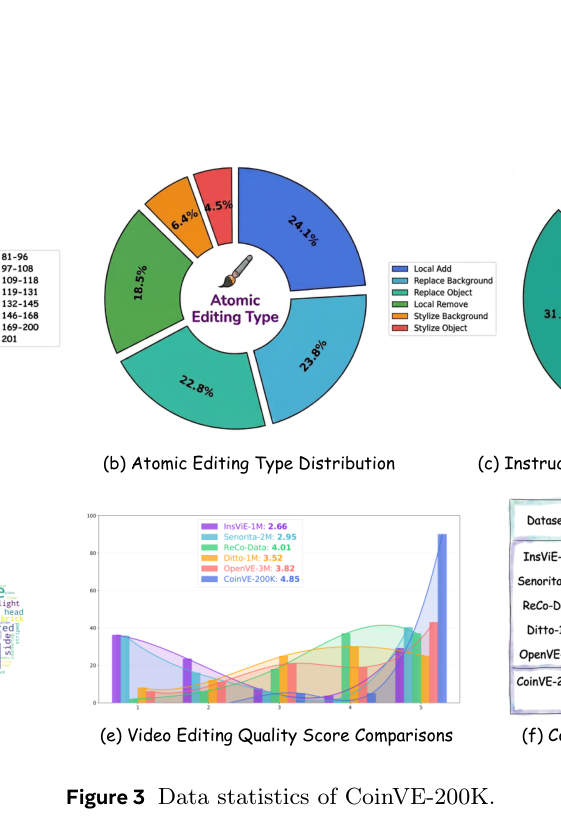
展示CoinVE-200K的数据统计分布,包括原子编辑类型占比和指令数量分布。此图说明数据集的组合性特征:平均2.55条指令/视频,2条指令占比57.7%。
论文贡献与验证
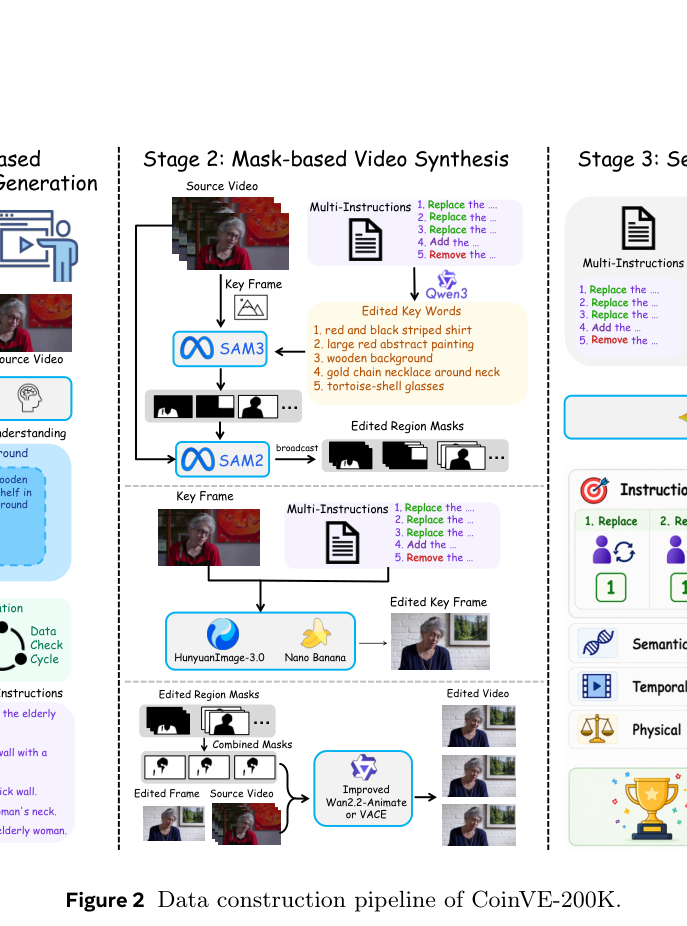
展示三阶段数据构建流水线:内容解析与指令生成、掩码引导的视频合成、多维度质量过滤。观察此图可理解数据从原始视频到高质量编辑对的完整转换过程。
消融证据
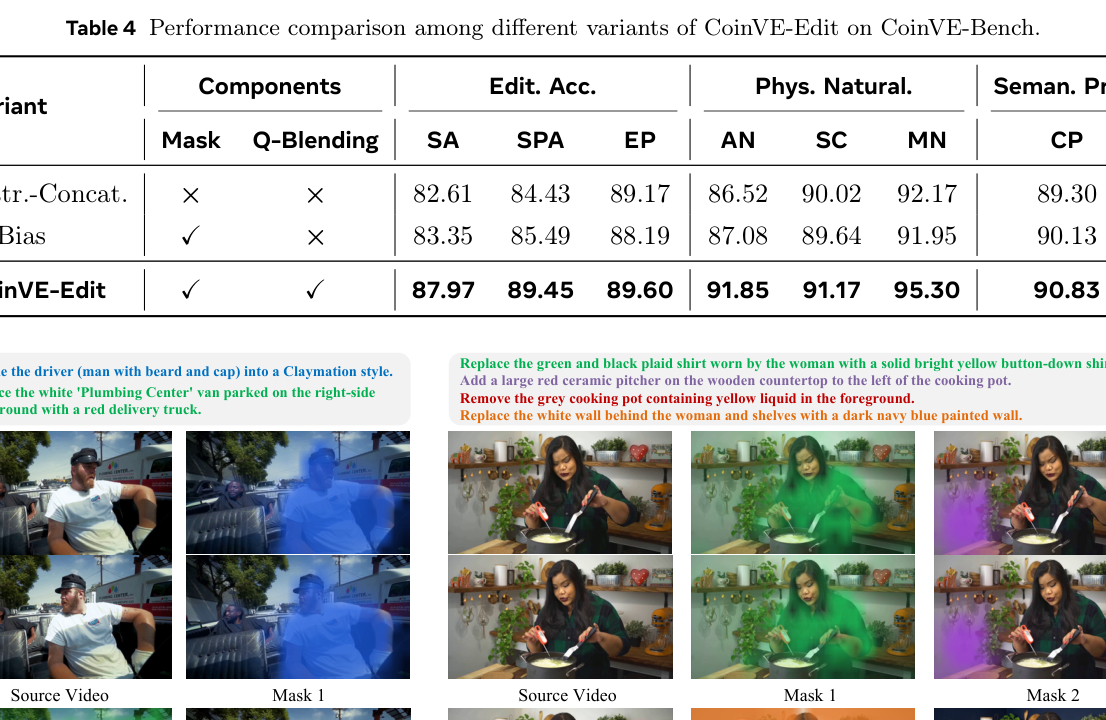
展示消融实验结果,对比Instr.-Concat.、Q-Bias与完整CoinVE-Edit的性能差异。此表证明Q-Blending软加权融合是性能提升的关键因素。
实验如何设计?
- 单指令编辑评测在OpenVE-Bench上进行,与VACE、Ditto、OpenVE-Edit、VINO、OmniWeaving、KiwiEdit、SAMA、Runway等基线对比,由Gemini 2.5 Pro自动打分。
- 组合指令编辑评测在自建的CoinVE-Bench上进行,对比Seedance 2.0、Kling O3等闭源模型以及VACE、Ditto、VINO、OmniWeaving、KiwiEdit、SAMA等开源方法。
- 消融实验对比三种变体:Instr.-Concat.(指令拼接)、Q-Bias(硬掩码偏置注入)与完整CoinVE-Edit(Q-Blending),以验证软加权融合的必要性。
- CoinVE-Bench包含361个高质量源视频,评测指标分为MLLM-based checklist evaluation和specialized evaluator-based evaluation两大类,覆盖编辑准确性、物理自然性、语义保持和视频质量四个维度。
- 训练在32块NVIDIA H200 GPU上进行,三阶段分别使用约2M图像编辑样本、0.9M视频编辑样本和CoinVE-200K。
关键结果与论文证据
- 在OpenVE-Bench上,CoinVE-Edit总体得分3.41,为开源方法最高;在Background Change(3.11)和Local Remove(3.81)两个需要精确区域定位的任务上优势尤为明显(第14页)。
- 在CoinVE-Bench的组合指令评测中,CoinVE-Edit的SPA(Semantic Preservation Accuracy)达到89.45,超越最佳竞品Seedance 2.0(87.71)1.74分(第14页)。
- 消融实验显示,Instr.-Concat.的SA=82.61/SPA=84.43,Q-Bias的SA=83.35/SPA=85.49,完整CoinVE-Edit的SA=87.97/SPA=89.45,证明Q-Blending软加权融合显著优于拼接和硬掩码方案(第16页)。
- Mask Predictor离线训练后IoU=0.71,GateNet二分类准确率0.95,表明区域定位和编辑类型判断模块均达到可用精度(第11页)。
- CoinVE-200K的平均编辑质量得分4.85,高于现有单指令数据集,说明数据过滤流水线有效保证了标注质量(第8页)。
- 数据统计显示,原子编辑类型分布为:局部添加24.1%、背景替换23.8%、物体替换22.8%、局部移除18.5%、背景风格化6.4%、物体风格化4.5%;指令数分布为2条57.7%、3条31.7%、4条8.5%、5条2.1%,平均2.55条/视频(第7页)。
- 掩码可视化(Figure 7)展示了每条指令对应的预测编辑掩码,验证了多指令区域解耦能力的定性效果(第16页)。
阅读时需要注意
- CoinVE-200K未覆盖参考图编辑、细粒度运动编辑、复杂相机控制等场景,数据多样性仍有扩展空间。
- 长视频和高度交互场景下的高效组合编辑仍具挑战,当前方法主要面向短视频片段。
- 模型规模22B,训练需32块H200 GPU,推理成本较高,限制了在资源受限环境下的部署。
- CoinVE-Bench的MLLM评估依赖Gemini 3.6 Flash自动打分,可能存在评估偏差。
- 与闭源模型对比时,开源基线采用逗号拼接多指令的方式,可能低估其组合编辑能力。
关联工作
- OpenVE-3M是现有的大规模指令引导视频编辑数据集,用于单指令训练和OpenVE-Bench评估,但其指令以单一操作为主。
- Ditto提供高质量合成视频编辑数据,同样用于单指令训练阶段,缺乏组合编辑标注。
- VACE作为全功能视频创建与编辑模型,在本文中既作为数据合成工具,也作为对比基线。
- TokenFlow是早期基于扩散特征传播的时序一致视频编辑方法,代表了无掩码引导的技术路线。
- ReCo提供区域约束指令视频编辑数据,用于单指令训练,但其区域约束方式与本文的掩码引导不同。