快速导读:EditBridge 提出基于扩散桥的粗到细框架,利用先验引导的块级稀疏注意力,将低分辨率编辑结果精炼为高保真超高分辨率输出。
超高分辨率图像编辑面临一个根本性矛盾:直接在高分辨率上训练或推理扩散编辑模型,注意力机制的二次复杂度会让计算成本迅速失控;而先做低分辨率编辑、再接独立超分模型的两阶段管线,又会在超分阶段失去原始高分辨率源的引导,导致细节幻觉与纹理退化。EditBridge 的出发点正是弥合这一矛盾。
EditBridge 将高分辨率精炼建模为一个扩散桥(Diffusion Bridge)过程:源端点是低分辨率编辑结果,目标端点是高分辨率输出,同时以原始 HR 源图像为条件。为了让跨图像交互在超高分辨率下可行,作者从第一阶段编辑的注意力图中提取语义对应先验,并据此约束注意力到空间对齐的局部窗口,形成先验引导块级稀疏注意力(PG-BSA)。
英文题目:EditBridge: Towards Faithful and Efficient Ultra-High-Resolution Image Editing
论文出处:arXiv 每日论文精选 · arXiv:2608.18063
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有高分辨率编辑的默认范式是两阶段:先在低分辨率上完成语义编辑,再调用一个独立的超分模型放大。问题在于,超分模型只看到低分辨率编辑结果,没有原始 HR 源作为参照,因此它倾向于凭空补出细节。这些补出的细节可能与 HR 源中真实存在的内容不一致,作者称之为信息发散(Information Divergence)。
与此同时,超分模型还会引入纹理退化(Texture Degradation):要么过度平滑,抹掉本应保留的高频结构;要么过度锐化,产生不自然的边缘和伪影。这两种失效模式在 1K 以上的分辨率下尤为明显,因为低分辨率编辑结果中丢失的信息越多,超分模型需要猜测的部分就越大。
直接在高分辨率上训练编辑模型看似可以绕过两阶段问题,但扩散 Transformer(DiT)的自注意力复杂度随 token 数量平方增长。从 1K 到 4K,token 数量成倍增加,显存和计算时间都会变得不可接受。因此,问题的关键不是要不要高分辨率,而是如何在可控的计算代价下,让高分辨率输出忠实于原始 HR 源。
核心创新
- 提出基于扩散桥的 HR 精炼框架,将低分辨率编辑结果作为桥的源端点,保留结构信息并缩短生成轨迹
- 提出先验引导块级稀疏注意力(PG-BSA),利用第一阶段编辑的注意力对应先验约束跨图像交互,将复杂度从 O(N²) 降至 O(N·k²)
- 实现单步推理即可达到最优感知质量,在 1K/2K/4K 分辨率下高效完成高保真编辑
方法概览
EditBridge 将 HR 精炼建模为从低分辨率编辑结果到 HR 输出的扩散桥数据到数据翻译,并以原始 HR 源图像为条件;通过从第一阶段编辑注意力图提取语义对应先验,约束跨图像注意力到空间对齐的局部窗口,实现先验引导块级稀疏注意力(PG-BSA)。
- 扩散桥建模:EditBridge 不把高分辨率精炼看作从噪声到数据的生成,而是看作从低分辨率编辑结果到高分辨率输出的数据到数据翻译。布朗桥(Brownian Bridge)定义了这两个端点之间的随机插值路径,源端点本身就携带了编辑后的结构信息,因此生成轨迹更短,推理步数可以大幅减少。
- 条件设计:扩散桥的目标端点是 HR 输出,条件信号是原始 HR 源图像。这样,精炼过程始终有 HR 源作为参照,超分阶段常见的细节幻觉在机制上被抑制。
- 对应先验提取:作者从第一阶段低分辨率编辑的注意力图中提取源-目标空间对应关系,即 Correspondence Prior。这个先验告诉模型:目标图像中的某个区域,应该参考源图像中的哪个对应区域。
- PG-BSA 机制:先验引导块级稀疏注意力(Prior-Guided Block-wise Sparse Attention)利用对应先验,把跨图像注意力约束到空间对齐的局部窗口内,而不是让每个 token 关注所有 token。复杂度从 O(N²) 降到 O(N·k²),其中 k 是局部窗口大小,远小于 N。
- 实现基础:EditBridge 以 Qwen-Image-Edit 为基础编辑模型,并借助 VMoBA 框架实现稀疏注意力。这种组合让方法可以直接应用于 DiT 架构,而不需要回到 U-Net 路线。
- 单步推理:由于扩散桥的源端点已经包含编辑后的结构,精炼过程不需要多步去噪。实验表明单步推理(T=1)即可达到最优感知质量,这进一步压缩了推理时间。
逐图理解论文
两阶段管线的失效
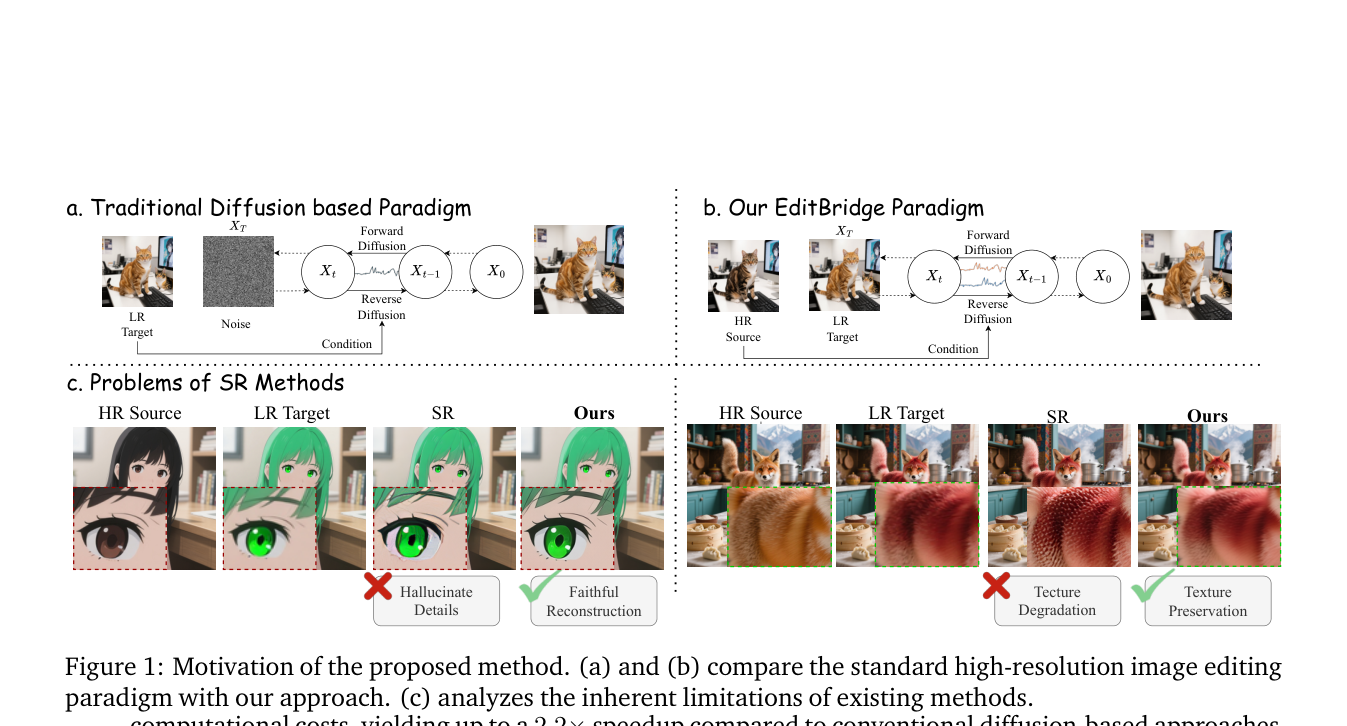
图 1 对比了标准高分辨率编辑范式与 EditBridge 的差异,并分析了现有方法的固有限制。重点观察两阶段管线中信息发散和纹理退化的示意,这是全文动机的直观来源。
扩散桥的视角转换
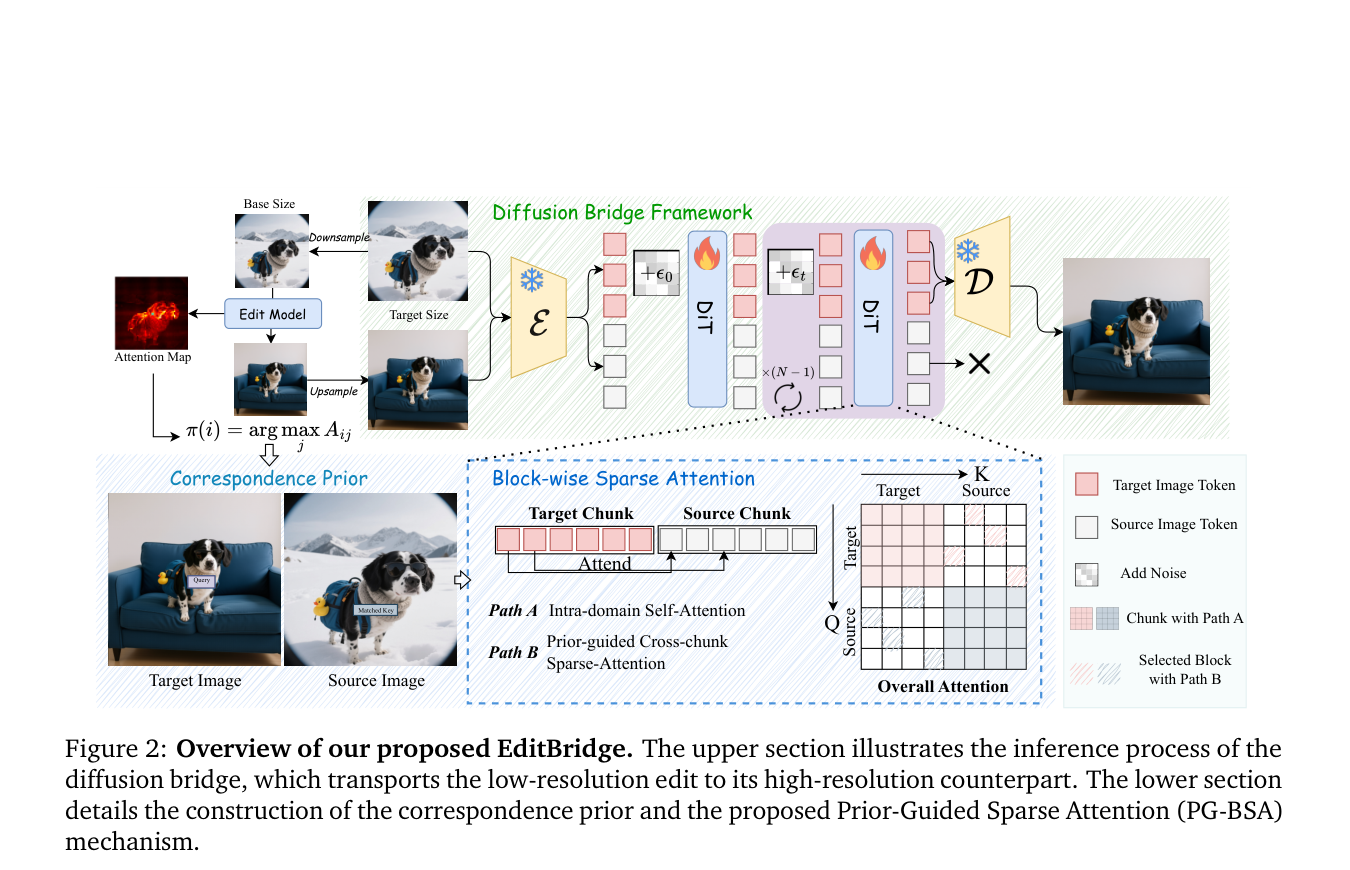
图 2 展示了 EditBridge 的整体框架:上半部分是扩散桥的推理过程,下半部分是对应先验的构建与 PG-BSA 机制。建议先看上半部分的端点定义,再理解下半部分如何约束注意力。
单步推理与伪影陷阱
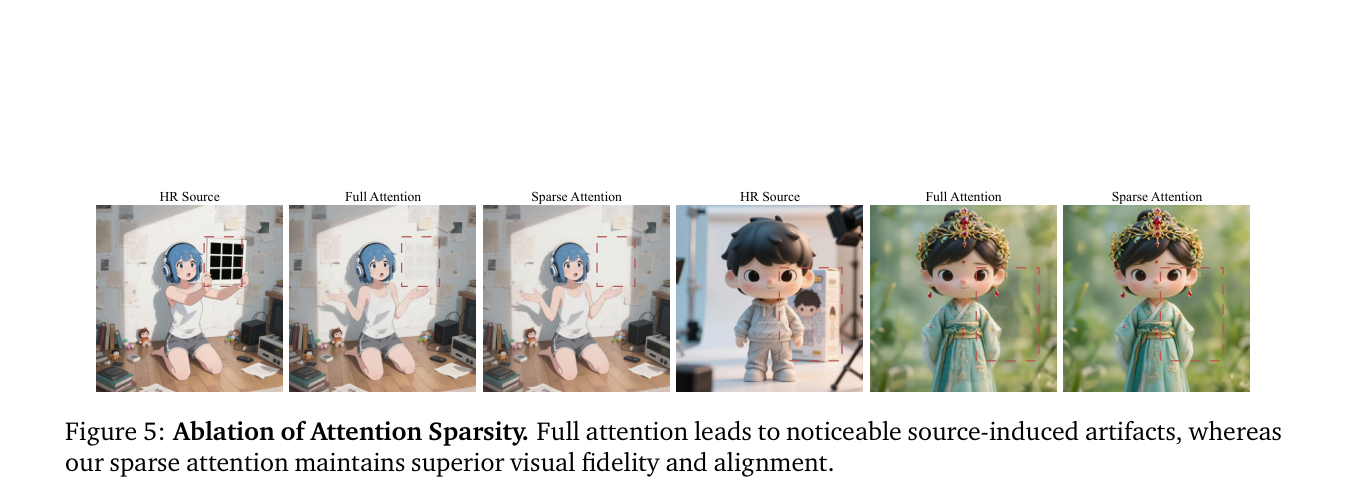
图 5 展示了注意力稀疏性的消融结果。Full Attention 产生明显的源诱导伪影,而稀疏注意力保持了视觉保真度和对齐性。
实验如何设计?
- 在 1K、2K、4K 三个分辨率上与 DiT-SR、DiT4SR、PiSA-SR、TSD-SR、HiFlow、ScaleEdit 以及 Direct Inference 进行定量与定性对比。
- 消融实验一:PG-BSA 与 Full Attention 在 1K 和 2K 下的性能与效率对比,考察稀疏注意力是否牺牲质量。
- 消融实验二:推理步数(1/5/10 步)对感知质量与效率的影响,验证扩散桥的短轨迹假设。
- 用户研究:30 名参与者对 50 组图像在细节保持、真实感、美学三个维度进行盲评,作为感知质量的主观证据。
关键结果与论文证据
- 在 1K 分辨率下,EditBridge 的 HaarPSI 达到 0.4992,mLPIPS 为 0.3829,推理时间仅 0.84 秒(第 7 页表 1)。
- 在 2K 分辨率下,EditBridge 相比扩散 SR 方法加速 3.6–8.4 倍,同时保持相当的感知质量(第 8 页)。
- 在 4K 分辨率下,EditBridge 相比直接推理加速 11 倍,mLPIPS 为 0.2112(第 7 页表 1、第 8 页)。
- 用户研究中,EditBridge 在细节保持、真实感、美学三个维度分别获得 52%、58%、65% 的偏好率,均优于所有基线(第 15 页图 7)。
- 单步推理(N=1)的 HaarPSI 为 0.4991,优于 5 步的 0.4131 和 10 步的 0.4020,说明多步采样在极端分辨率下反而因量化误差累积而变差(第 10 页图 6)。
- Full Attention 在像素级重建指标(PSNR、HaarPSI)上略高于 PG-BSA,但会引入源诱导伪影,定量优势在局部编辑场景下具有欺骗性(第 9 页表 2、第 10 页图 5)。
阅读时需要注意
- 方法依赖预定义的索引先验,需要在翻译过程前提取或合成,先验精度直接限制最终输出质量。
- 扩散桥采样过程仍存在不可忽略的计算开销,尤其在高分辨率或多步过渡场景。
- 多步采样(5/10 步)反而比单步推理质量更差,可能因极端分辨率下量化误差累积,这限制了通过增加步数换取质量的可能性。
关联工作
- ScaleEdit 采用测试时逐块优化的方式处理高分辨率编辑,是本文的对比基线之一,但其优化过程与扩散桥的端到端精炼思路不同。
- HiFlow 是训练无关的高分辨率图像生成加速框架,作为通用放大与保真编辑差异的对比基线。
- DiT-SR、DiT4SR、PiSA-SR、TSD-SR 是基于扩散 Transformer 的超分辨率模型,代表两阶段管线中 SR 组件的典型选择。
- MobilePicasso 是基于 U-Net 的高分辨率编辑混合管线,无法直接应用于 DiT 框架,这凸显了 EditBridge 在 DiT 架构上的适配价值。
- BBDM 和 Denoising Diffusion Bridge Models 为扩散桥图像翻译提供了理论基础,EditBridge 将这一理论首次系统性地应用于超高分辨率编辑精炼。