快速导读:提出PathoArgus-Bench基准与PathoArgus读取器,系统评估并揭示当前MLLM在全切片病理问答中证据获取与证据响应之间的显著差距。
PathoArgus 的核心主张是:在全切片病理问答中,最终答案准确率无法证明模型真正使用了所供应的组织证据。现有基准大多只报告行级准确率,而语言先验、选项语义偏差和基准规律都可能让模型在没有图像的情况下仍然答对。PathoArgus 将这一问题形式化为证据链,从可用性、可及性、使用到响应性四个阶段逐一检验,并据此构建了 PathoArgus-Bench 基准与 PathoArgus 读取器。
论文的实证起点是一个无图像审计:作者对 8 个基线系统只提供问题和选项、不提供任何切片图像,发现 SlideBench 文本-only 准确率最高达 71.06%,WSI-Bench 四选一部分达 80.20%,远超随机基线。这说明仅凭准确率无法区分模型是在读图还是在猜题。PathoArgus 的贡献在于把这种怀疑变成可测量的评估协议,并揭示当前最强模型在证据响应性上的系统性失败。
英文题目:PathoArgus: Advancing Evidence-Grounded Long-Context Visual Reasoning across Gigapixel Whole-Slide and Multi-Slide Case Contexts
论文出处:arXiv 每日论文精选 · arXiv:2608.17607
原始论文:PDF / 论文页面
这篇论文解决什么问题?
全切片病理推理的输入规模远超普通视觉问答:一张 WSI 可能包含数万到数十万 patch,问题可能涉及全局识别、区域形态、稀疏细粒度证据、跨切片整合等多种能力。模型必须在有限的读取预算内找到与问题相关的组织区域,同时排除大量无关上下文。这一证据获取过程本身就是一个瓶颈,但现有基准大多只关心最终答案是否正确。
作者对 SlideBench、WSI-Bench 和 WSI-VQA 三个基准做了文本-only 控制实验,发现多个模型在完全没有图像输入的情况下仍能取得远高于随机的准确率。这一结果与 MIRAGE 在医学 VQA 中的发现一致:语言先验和选项分布本身携带了大量可被利用的信号。因此,行级准确率作为评估指标存在根本性缺陷。
更深层的问题是证据响应性:即使模型在某个问题上答对了,也无法证明它的预测会随着证据集的变化而改变。一个真正证据基的模型,应该在目标 WSI 被移除或替换时给出不同的答案;而一个依赖语言先验的模型,则可能对证据变化无动于衷。PathoArgus 的 ESG 协议正是为测量这一性质而设计。
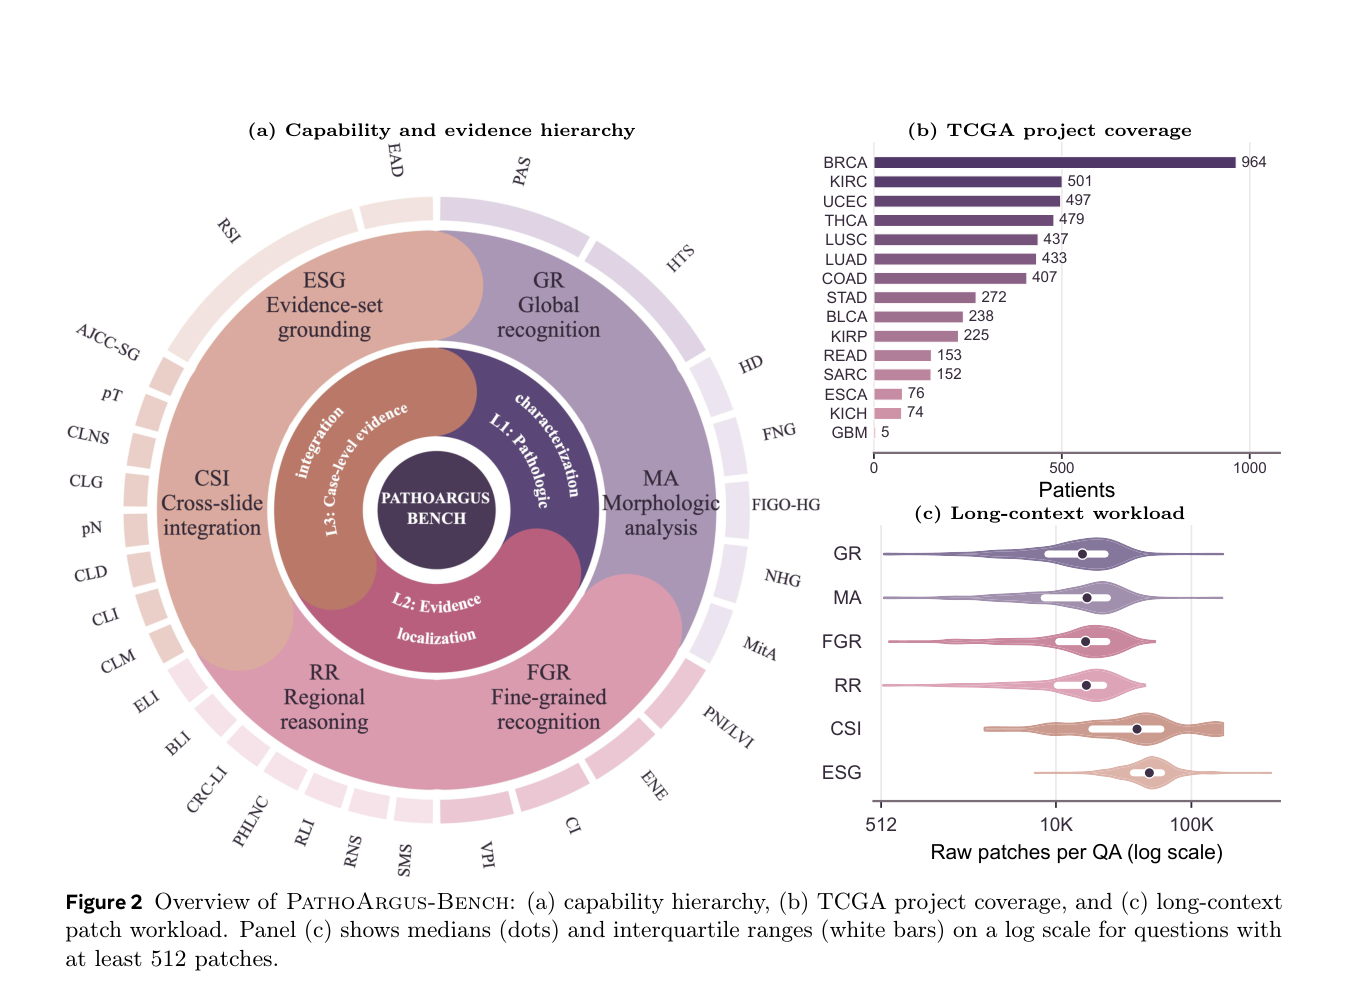
此外,完整 WSI 上下文在有限读取预算下存在证据可及性瓶颈。基准中平均每问有 33,743 个 patch 特征,最大达 388,637,而固定预算 K=512 意味着保留率仅 1.51%。模型必须在极低的采样率下找到关键证据,这对证据获取策略提出了极高要求。
核心创新
- 将完整上下文WSI问答形式化为证据链(可用性、可及性、使用、响应性)并据此设计评估协议
- 构建ESG证据状态四元组,固定问题文本而移动/移除目标WSI集,以QExact量化证据响应性
- 提出PathoArgus固定预算读取器,通过候选集-切片-空间区域层级路由与相关性-覆盖双分支选择保留证据结构
- 在统一固定预算协议下覆盖密集、区域、稀疏、跨切片、多集合五类证据组织方式
方法概览
PathoArgus-Bench包含22,078道四选一问题,来自4,913名患者、15个TCGA项目,覆盖GR、MA、FGR、RR、CSI、ESG六种能力,在固定读取预算K=512下评估证据链。ESG通过483个四元组固定问题文本、移动/移除目标WSI集,以QExact衡量证据响应性。PathoArgus读取器按候选集→切片→空间区域→patch的层级路由分配预算,结合问题相关性与空间覆盖选择patch。
- PathoArgus-Bench 包含 22,078 道四选一问题,来自 4,913 名患者、15 个 TCGA 项目,覆盖 GR、MA、FGR、RR、CSI、ESG 六种能力。其中 ESG 是证据响应性能力,通过 483 个四元组实现。
- ESG 四元组的设计是:固定问题文本和选项,只改变目标 WSI 集——包括原始证据集、移动目标集、移除目标集等四种证据状态。模型必须对四种状态分别作答,QExact 要求四元组全部答对才计分。
- 证据链四阶段的形式化:可用性指证据是否存在于输入中;可及性指证据能否在读取预算内被选中;使用指模型是否实际利用所选证据;响应性指模型预测是否随证据集变化而改变。PathoArgus-Bench 是首个同时覆盖这四个阶段的基准。
- PathoArgus 读取器采用层级路由分配固定预算:先在候选集层面选择相关切片,再在切片内选择空间区域,最后在区域内选择 patch。选择过程结合问题相关性与空间覆盖两个分支,以保留证据的空间结构。
- 基准的 patch 特征由 CONCH 提取,这是一个计算病理视觉-语言基础模型。所有系统在统一固定预算 K=512 下评估,确保比较的公平性。
- 文本-only 控制实验使用 Qwen2.5-7B,只提供问题和选项,用于估计非视觉推理的上限。这一控制是区分视觉证据使用与语言先验的关键。
逐图理解论文
一个令人不安的实验
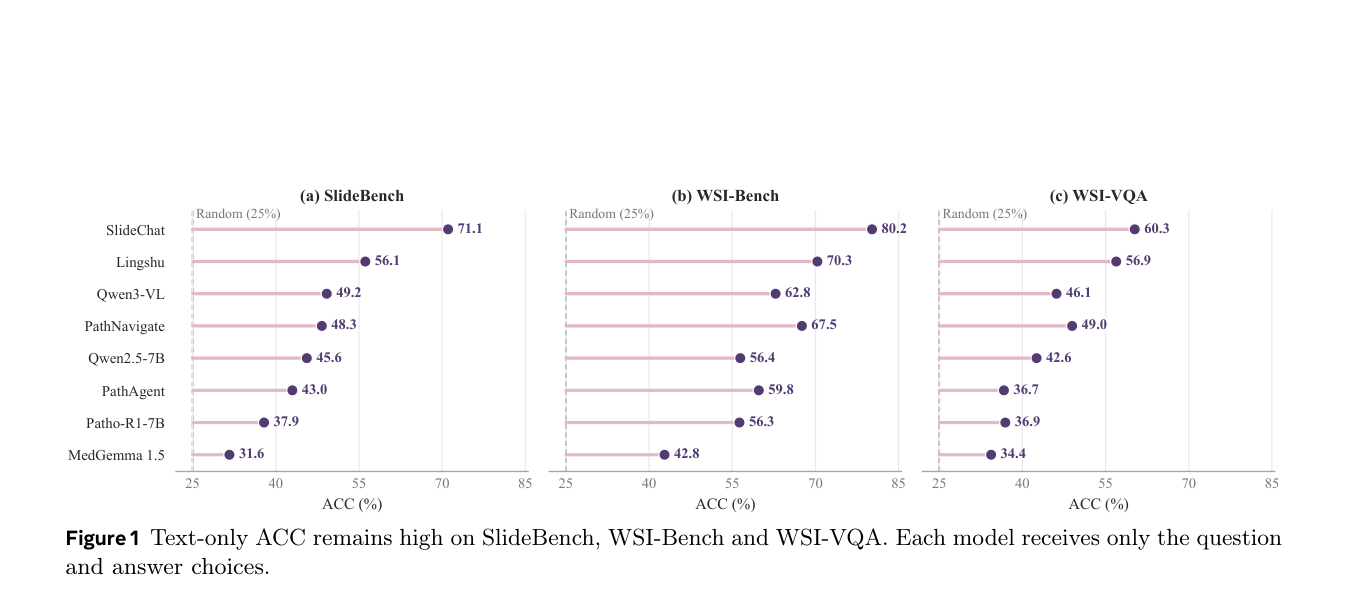
该图展示文本-only 审计结果:多个模型在 SlideBench、WSI-Bench 和 WSI-VQA 上仅凭问题和选项就取得远高于随机的准确率。应关注各基准的文本-only 准确率与随机基线的差距,这直接支持论文的核心论点——行级准确率不能证明视觉证据使用。
证据链与核心差距
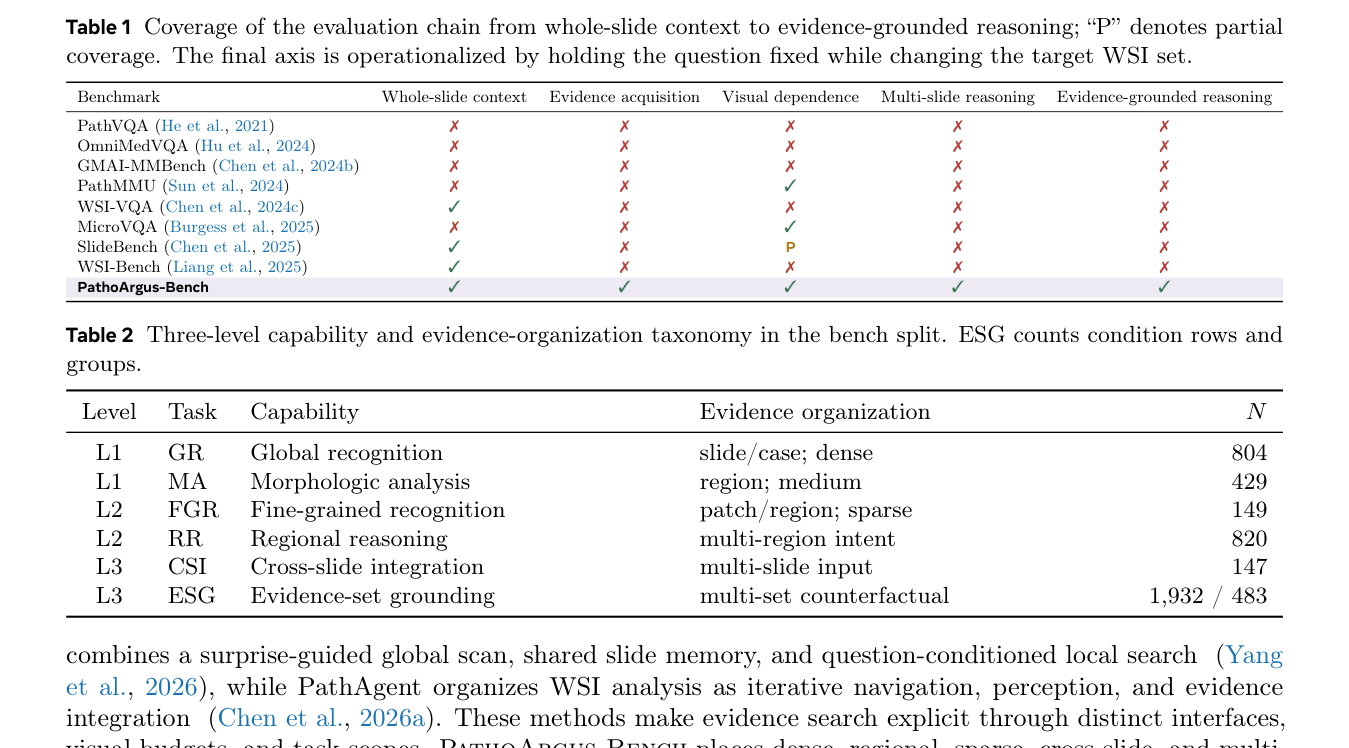
该表对比现有基准在证据链四阶段上的覆盖情况,PathoArgus-Bench 是唯一完整覆盖响应性阶段的基准。应关注最后一列,理解 ESG 协议如何通过固定问题文本、改变目标 WSI 集来操作化证据响应性。
ESG 协议与 PathoArgus 读取器
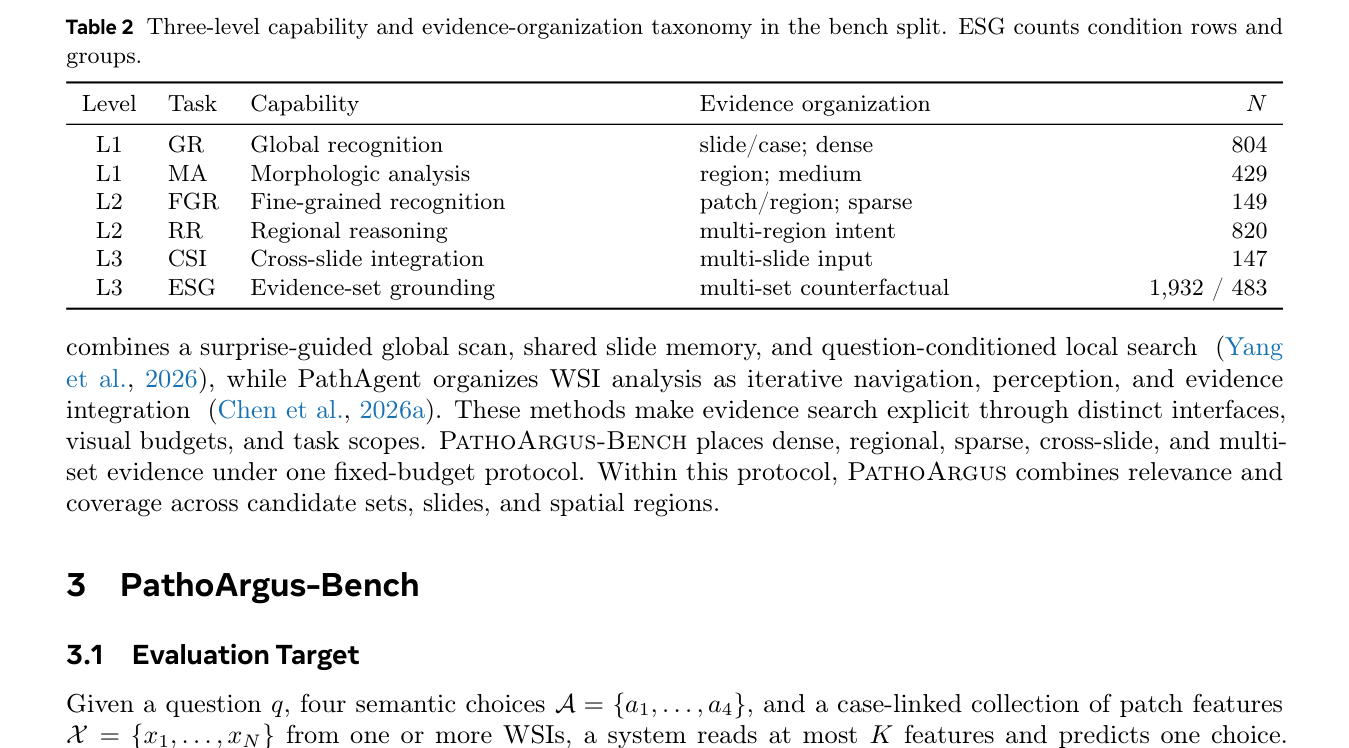
该表展示三级能力与证据组织分类法,ESG 行显示条件行和组数。应关注六种能力的证据组织方式差异,理解密集、区域、稀疏、跨切片、多集合五类证据组织如何对应不同推理难度。
最有力的发现
该表展示 PathoArgus-Bench 上所有系统的主要结果。应关注 Overall 准确率与 QExact 之间的巨大落差,特别是 GPT-5.6 的 57.09% 对 3.93%,这是论文最强有力的实证发现。
实验如何设计?
- 在 4,281 题的 bench split 上对 20 个通用、医学、病理专用系统进行闭集 A-D 评估,包括 GPT-5.6、Lingshu-32B、WSI-LLaVA 等。
- 文本-only 控制实验:Qwen2.5-7B 只接收问题和选项,不接收任何图像特征,用于测量语言先验的贡献。
- ESG 四元组评估:对 483 个四元组计算 QExact,即四元组完全正确率,作为证据响应性的核心指标。
- PathoArgus 读取器在 K=512 预算下与各基线对比,验证层级路由和相关性-覆盖双分支选择的有效性。
- 监督微调基线(SFT)用于检验训练集能否传递证据响应能力,结果显示 SFT 的 QExact 为 0%。
关键结果与论文证据
- GPT-5.6 在 Overall 上取得 57.09%,ESG 准确率 57.04%,但 QExact 仅 3.93%(19/483),说明即使最强模型也几乎不具备证据响应性(第 8 页)。
- PathoArgus 读取器 Overall 50.39%,ESG 46.17%,QExact 1.86%,改进上下文分配并未带来一致的证据条件预测(第 8 页)。
- 最强开源模型 Lingshu-32B Overall 36.74%,QExact 0.83%;最强病理专用模型 WSI-LLaVA Overall 30.46%,QExact 0.00%(第 8 页)。
- GPT-5.6 在 GR 上达 85.20%,但 FGR 仅 24.16%,细粒度识别是普遍瓶颈(第 7 页)。
- 文本-only 控制 ESG 准确率 24.95%,QExact 0%,且 96.07% 的四元组呈现恒定预测,证实语言先验无法产生证据响应(第 8 页)。
- 基准中 85.52% 的问题超过 10,000 个 patch 特征,22.70% 超过 50,000,证据可及性压力极大(第 5 页)。
- 监督微调基线 SFT 的 Overall 仅 32.36%,QExact 为 0%,说明现有训练集未有效传递证据响应能力(第 8 页)。
阅读时需要注意
- PathoArgus 的 QExact 仅 1.86%,层级路由和相关性-覆盖选择并未带来一致的证据条件预测,方法本身仍远未解决证据响应性问题。
- 监督微调基线 QExact 为 0%,训练集未有效传递证据响应能力,说明现有数据构建方式需要根本性改变。
- FGR 任务在所有模型中表现普遍偏低,GPT-5.6 仅 24.16%,细粒度识别仍是病理 MLLM 的核心瓶颈。
- 基准基于 TCGA 结构化报告字段构建,临床真实问答分布可能不同,结论的外推需要谨慎。
关联工作
- WSI-VQA 将切片级病理任务重构为生成式问答,但未评估证据获取与多切片推理。SlideBench 和 SlideChat 覆盖显微镜、诊断、临床场景,但仅部分覆盖视觉依赖性。
- WSI-Bench 和 WSI-LLaVA 构建了约 180K 问答对的形态感知基准,但未评估证据获取。PathMMU 包含文本-only 快捷控制,但限于单图像。
- GIANT 和 MultiPathQA 将证据搜索显式化,但接口与预算协议不同。PathNavigate 和 PathAgent 将 WSI 分析组织为迭代导航的 agent 推理,与 PathoArgus 的固定预算读取器形成对比。
- MIRAGE 揭示 MLLM 无图像输入时仍保留医学 VQA 性能,是 PathoArgus 文本-only 审计的直接动机来源。