快速导读:提出DynaForcing训练框架,通过混合强制、动态感知奖励正则化和参考图像扰动三种策略,解决自强制蒸馏在流式数字人生成中的动态坍缩问题。
流式数字人生成的核心矛盾在于:实时性要求模型以因果、少步的方式自回归生成,而视觉质量与时间动态往往难以兼得。自强制蒸馏(self-forcing distillation)将大规模视频扩散模型压缩为实时生成器,却暴露出一个隐蔽而严重的失败模式——动态坍缩(dynamic collapse):模型输出的每一帧都很好看,但唇形几乎不动、表情冻结,音画同步这一数字人任务的根本需求被悄然牺牲。
DynaForcing的贡献在于首次系统性地形式化并表征了这一现象,将其归因于反向KL散度的mode-seeking特性与无锚定自条件化的复合效应,并在训练流程的输入、损失、条件三个层面分别提出Hybrid Forcing、Dynamics-Aware Reward Regularization和Reference Perturbation三种策略加以克服。
英文题目:DynaForcing: Overcoming Dynamic Collapse in Self-Forcing Distillation for Streaming Avatar Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.17707
原始论文:PDF / 论文页面
这篇论文解决什么问题?
自强制蒸馏的运作方式是:学生模型以自身先前生成的输出构建KV缓存,作为后续块的条件输入。这种设计在推理时是必要的——流式生成无法访问未来帧——但在训练时却制造了一个危险的反馈回路:学生早期的轻微运动抑制会被缓存放大,因为下一块的条件输入本身就缺乏动态。
DMD蒸馏的反向KL目标具有mode-seeking特性:它惩罚学生分布超出教师支撑的质量,却不惩罚忽略教师分布中的某些模式。对于数字人任务,静态场景先验使得零运动输出即可满足大部分视觉质量指标,因此mode-seeking天然偏向低运动模式。
论文通过诊断消融证明了关键一点:将自强制替换为GT-anchored训练(以加噪真值帧为条件)后,动态指标显著恢复,说明坍缩的主因是条件来源而非DMD蒸馏本身。这一发现将问题从“蒸馏目标函数”重新定位到“自条件化的反馈结构”,为后续干预指明了方向。
核心创新
- 首次系统形式化并表征自强制蒸馏中的动态坍缩现象,归因于反向KL mode-seeking与无锚定自条件化的复合效应
- 提出Hybrid Forcing:概率性地以加噪真值潜变量替代纯噪声作为rollout起点,在数据层面提供真值锚定
- 提出Dynamics-Aware Reward Regularization:基于DMD的RL解释引入显式动态奖励(Sync-C、ExpVar)指数重加权梯度
- 提出Reference Perturbation:语义编辑参考图解耦身份与静态细节,配合ArcFace过滤和SSIM分桶的相似度校准采样
- 提出计算图剪枝与逐块梯度重放,将自强制训练GPU需求从128卡降至8卡(约10.7×GPU小时缩减)
方法概览
DynaForcing在训练流程三个层面介入:(1) Hybrid Forcing以概率p_data用加噪真值潜变量替代纯噪声作为rollout起点,提供真值锚定打破反馈回路;(2) Dynamics-Aware Reward Regularization利用DMD的RL解释,以Sync-C和ExpVar构成动态奖励R_dyn指数重加权DMD梯度;(3) Reference Perturbation用Qwen-Image-Edit生成保留身份但改变背景/光照/视角的扰动参考图,经ArcFace过滤和SSIM分桶采样,迫使模型依赖音频生成运动。另引入计算图剪枝和逐块梯度重放,将GPU需求降低约10倍。
- Hybrid Forcing在输入层面介入:以概率p_data用加噪真值潜变量替代纯噪声作为rollout起点,为训练轨迹提供真值锚定。p_data=0.3时取得最佳平衡,既打破反馈回路,又保留足够的自条件化暴露以维持推理一致性。
- Dynamics-Aware Reward Regularization在损失层面介入:利用DMD的RL解释(Diff-Instruct++框架),以Sync-C(唇形同步置信度)和ExpVar(表情方差)构成动态奖励R_dyn,对DMD梯度做指数重加权,直接对抗mode-seeking对低运动模式的偏好。
- Reference Perturbation在条件层面介入:用Qwen-Image-Edit生成保留身份但改变背景、光照、视角的扰动参考图,破坏参考帧与目标帧之间的像素级对应关系,迫使模型真正依赖音频来生成运动,而非复制参考帧。
- 相似度校准采样(similarity-calibrated sampling)是Reference Perturbation的关键配套:ArcFace过滤掉身份偏离过大的扰动图,SSIM分桶确保不同相似度区间的样本均衡出现,避免模型重新学会复制主导(copy-dominance)的捷径。
- 计算图剪枝断开KV缓存的跨块梯度依赖,逐块梯度重放则先无梯度生成整段序列再逐块重放前向计算梯度,两者结合将GPU需求从128×H100降至8×H100,GPU小时缩减约10.7倍,使自强制训练在学术计算资源下可行。
- 奖励强度α=0.1最佳,起始步分布集中于t1(p(t1)=0.70)优于均匀分布,这些超参数选择反映了在动态恢复与视觉质量之间保持微妙平衡的必要性。
逐图理解论文
失败案例与直觉
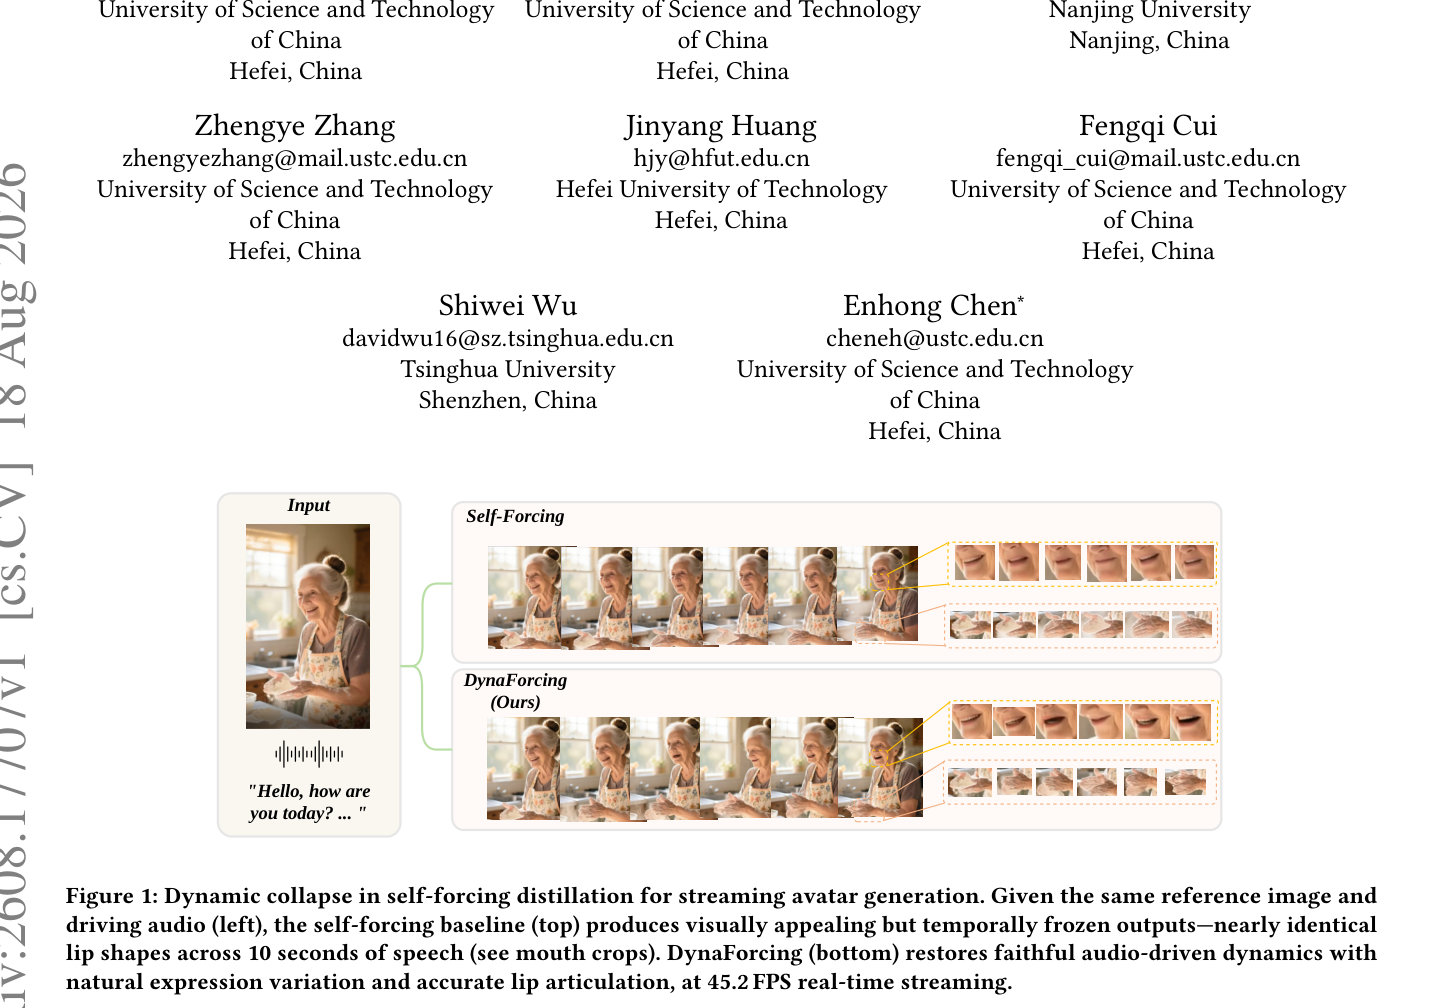
这张图是论文的核心motivation展示:同一参考图和音频下,自强制基线输出的嘴部裁剪在10秒内几乎完全相同,而DynaForcing恢复了自然的唇形变化和表情动态。观察嘴部裁剪的差异是理解动态坍缩最直观的方式。
坍缩的根源
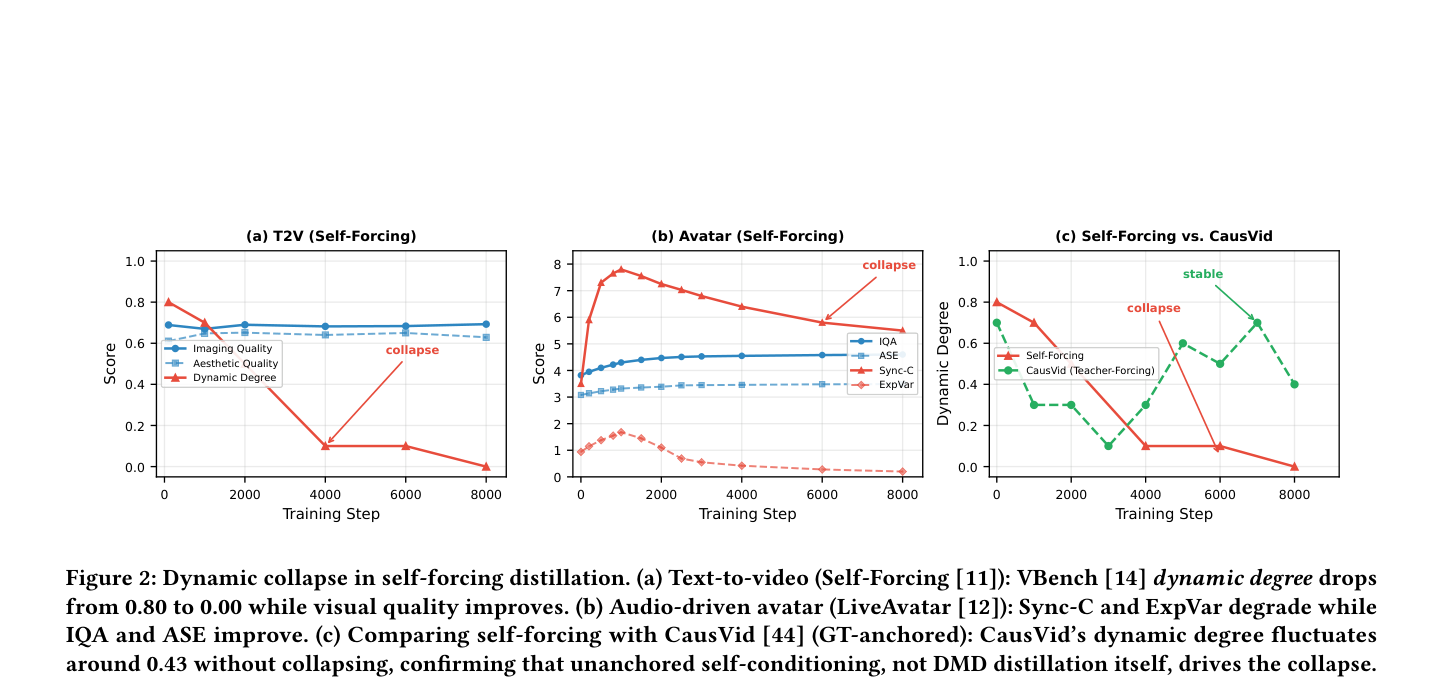
该图从三个角度表征动态坍缩:文本到视频中动态程度从0.80骤降到0.00,数字人任务中Sync-C和ExpVar退化而视觉质量反而提升,以及GT-anchored训练不坍缩的对照。第三组对照是论文归因论证的关键证据。
三层干预
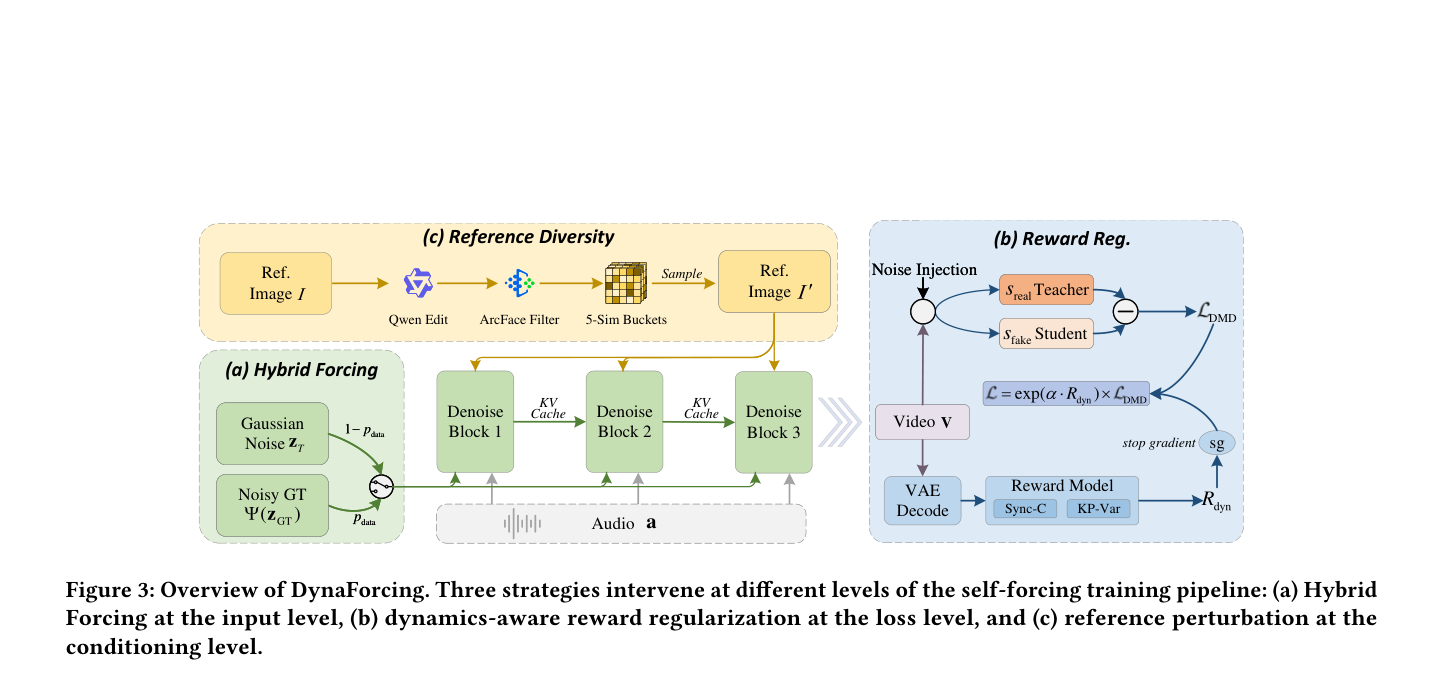
方法总览图展示了三种策略在训练流程中的介入位置:Hybrid Forcing在输入层、奖励正则化在损失层、参考扰动在条件层。理解这张图有助于把握三个组件如何协同而非孤立地起作用。
证据与验证
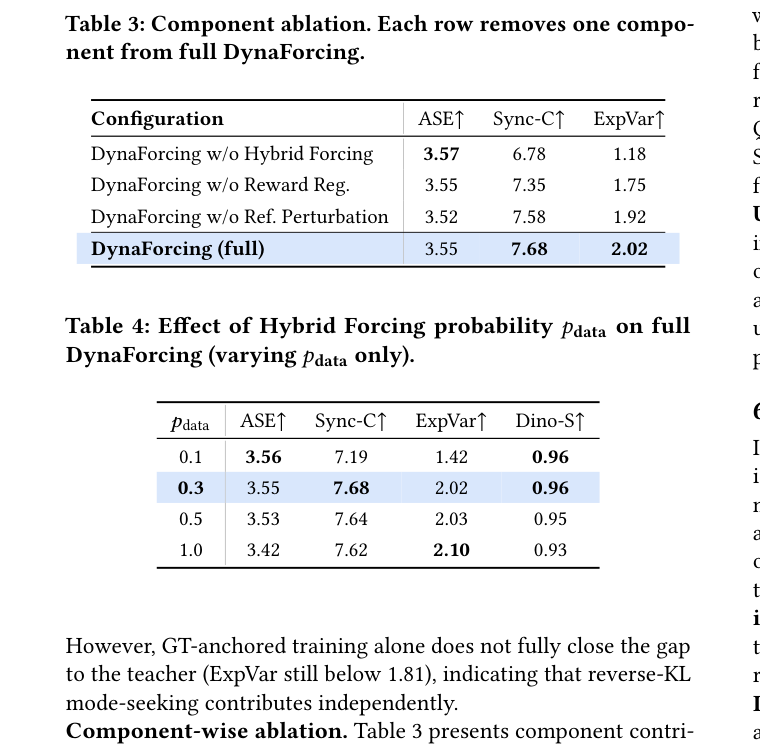
验证分三层。组件消融显示移除Hybrid Forcing对动态的损害最大,说明真值锚定是核心。奖励无关评估用三个未参与训练的指标确认动态恢复不是reward hacking。用户研究中,DynaForcing在运动自然性上以约八成的偏好率胜出,但在视觉质量上优势最小——这恰恰说明方法的收益集中在它真正瞄准的维度。
实验如何设计?
- 主实验在GenBench-ShortVideo(约10秒,100样本)和GenBench-LongVideo(>5分钟,15样本)上进行,对比非实时多步扩散模型(WanS2V、OmniAvatar、Hallo3等)和实时流式模型(Ditto、LiveAvatar、SoulX-FlashTalk)。
- 诊断消融对比self-forcing与GT-anchored训练,隔离rollout反馈的影响,证明条件来源是坍缩主因。
- 组件消融逐一移除Hybrid Forcing、Reward Regularization、Reference Perturbation,量化各组件的独立贡献。
- 奖励无关动态评估使用Dyn-Deg、Lip-Vel、Lip-Jit三个未参与训练优化的指标,排除reward hacking的可能性。
- 用户研究招募25名参与者,与LiveAvatar和SoulX-FlashTalk两两对比,在运动自然性、唇形同步、视觉质量等维度收集偏好率。
关键结果与论文证据
- DynaForcing在GenBench-ShortVideo上将Dyn-Deg从LiveAvatar的0.31恢复到0.73,接近教师WanS2V的0.72,同时保持45.2 FPS的实时性(Table 1, p.6)。
- 诊断消融显示GT-anchored训练使ExpVar从0.69提升到1.36、Dyn-Deg从0.31提升到0.52、Sync-C从5.48提升到6.85,证明条件来源而非DMD蒸馏本身是坍缩主因(Table 2, p.7)。
- 组件消融中移除Hybrid Forcing使ExpVar从2.02降至1.18、Sync-C降至6.78,是三个组件中对动态影响最大的(Table 3, p.8)。
- p_data=0.3取得最佳平衡:ASE 3.55、Sync-C 7.68、ExpVar 2.02、Dino-S 0.96;p_data=1.0时ASE降至3.42、Dino-S降至0.93,说明过度锚定会损害视觉质量和身份保持(Table 4, p.8)。
- 奖励无关评估中DynaForcing full的Dyn-Deg为0.73、Lip-Vel为3.78,而w/o Reward Reg.为0.55、3.41,LiveAvatar为0.31、3.50,证明动态恢复不是reward hacking的产物(Table 11, p.11)。
- 用户研究中DynaForcing在运动自然性上以80.6%(vs LiveAvatar)和74.2%(vs SoulX-FlashTalk)的偏好率胜出,但在视觉质量维度偏好率最低(58.4%/55.2%),说明方法的核心收益集中在动态维度(Table 12, p.12)。
- 训练动态曲线显示DynaForcing的Sync-C和ExpVar在约1K步后稳定且不再退化,而vanilla self-forcing持续恶化,证明方法从根源上改变了训练轨迹(Figure 5, p.7)。
- 效率优化将GPU需求从128×H100降至8×H100,GPU小时从7,111降至667,ASE仅差0.01、Sync-C差0.02,说明效率优化几乎不牺牲性能(Table 5, p.8)。
阅读时需要注意
- 动态奖励依赖预训练SyncNet和3DMM模型,这些模型的偏差可能通过奖励信号传导到学生模型,影响训练稳定性。
- 分析以数字人生成为中心,数据层组件(Hybrid Forcing、Reference Perturbation)预期可迁移到其他自回归生成任务,但尚未在其他任务上系统验证。
- 梯度重放带来约1.5倍的每步墙钟时间开销,虽然GPU需求大幅降低,但单步时间成本仍有优化空间。
- ExpVar略超教师(2.02 vs 1.81)可能反映DMD蒸馏的分布集中倾向,论文通过Lip-Jit基本不变(4.23 vs 4.26)论证非高频抖动所致,但这一解释仍需更多独立验证。
关联工作
- Reward Forcing提出reward-weighted DMD蒸馏,本文的Dynamics-Aware Reward Regularization沿用其指数重加权框架,但将奖励从通用质量指标替换为任务特定的动态指标。
- DiagDistill独立观察到自强制中的运动幅度衰减问题并提出对角强制缓解,与本文形成互补:DiagDistill关注衰减的数学机制,DynaForcing关注坍缩的归因与系统性干预。
- CausVid的GT-anchored自回归蒸馏在本文中作为诊断工具使用,其存在本身就暗示了自条件化的问题,但此前未被系统性地与动态坍缩联系起来。
- LiveAvatar是本文方法的应用载体,DynaForcing在其Stage-2蒸馏阶段介入,说明该方法可以作为现有自强制流程的即插即用改进。