快速导读:LinCa 提出基于可学习可逆网络的特征缓存框架,将缓存特征分解为不同连续性的子分量并施加差异化阶数预测,在 FLUX、Qwen-Image、HunyuanVideo 等模型上实现 5–7× 近无损加速。
扩散模型的高质量生成依赖多步迭代去噪,计算成本高昂。特征缓存(Feature Caching)作为一类加速手段,通过在部分时间步执行完整前向并缓存中间特征、其余步骤复用或预测特征来跳过计算,近年来在 DiT 架构上展现出显著潜力。然而,现有方法如 FORA、ToCa、TaylorSeer 均为 training-free,对所有时间步、所有模型和所有特征维度施加统一的预测策略,忽视了扩散模型隐藏特征在演化过程中的异质性。
LinCa 的核心论点是:扩散模型隐藏特征的动态特性在不同层面存在显著的 dynamics mismatch——跨时间步、跨模型、跨特征维度皆然。基于这一观察,LinCa 提出可学习的 Decompose-Predict-Reconstruct 管线:用轻量可逆网络将缓存特征分解为不同连续性的子分量,对不稳定分量做 0 阶复用,对连续性好的分量施加匹配阶数的 Hermite 外推,再通过可逆网络的逆映射无损重建回原始特征空间。训练仅需 100–200 个预生成特征样本,单卡 12GB 显存约 1 小时完成,无需加载扩散模型权重。
英文题目:LinCa: Accelerating Diffusion Models via Learnable Decomposed Feature Caching
论文出处:arXiv 每日论文精选 · arXiv:2608.17973
原始论文:PDF / 论文页面
这篇论文解决什么问题?
扩散模型(如 FLUX、Qwen-Image、HunyuanVideo)的采样过程通常需要数十步去噪迭代,每一步都涉及完整的 Transformer 前向计算。特征缓存的基本思想是:每 N 步执行一次完整前向并缓存中间特征,其余 N-1 步跳过计算,利用历史缓存特征进行复用或预测。这一思路在直觉上合理,因为相邻时间步的去噪特征往往高度相关。
然而,现有 training-free 方法的一个共同缺陷是“一刀切”。它们对所有时间步、所有模型和所有特征维度采用相同的预测策略,例如统一的多项式外推阶数或统一的复用规则。论文第 2 页的 Fig. 2 通过 PCA 可视化揭示了问题的本质:在 FLUX.1-dev 和 Qwen-Image 中,去噪轨迹的连续性存在显著差异;即使在同一模型、同一去噪阶段内,不同特征维度也表现出截然不同的连续性——部分维度呈现低连续性和突变,部分维度则高度稳定。
这种 dynamics mismatch 意味着:对连续性好的维度,高阶外推可以安全地预测更远的未来;对突变频繁的维度,任何外推都可能引入不可控误差。统一策略要么在稳定维度上过于保守(浪费加速潜力),要么在不稳定维度上过于激进(引入伪影)。这正是 LinCa 要解决的研究缺口。
值得注意的是,已有少数 training-based 方法(如 LESA)尝试学习阶段感知的预测器,但它们仍将特征视为整体进行预测,没有触及维度层面的异质性。LinCa 的独特之处在于将“区别对待”下沉到特征维度内部。
核心创新
- 揭示扩散模型隐藏特征在跨时间步、跨模型和跨特征维度三个层面存在显著的动态不匹配(dynamics mismatch)
- 提出基于可学习可逆网络的 Decompose-Predict-Reconstruct 特征缓存管线,严格可逆性保证无损重建
- 差异化多阶预测策略:将特征分解为不同连续性子空间,分别施加 0 阶复用、1 阶和 2 阶 Hermite 外推
- 按时间步段分段训练独立预测器,以极小训练开销适应不同模型和去噪阶段的特征动态
方法概览
LinCa 采用轻量可逆网络将缓存特征沿特征维分解为 M=3 个子分量,对不稳定分量做 0 阶复用,对连续性好的分量施加匹配阶数的 Hermite 多项式外推,再通过可逆网络的逆映射无损重建回原始特征空间。将去噪过程划分为 S=3 个时间步段,每段独立训练同构但参数独立的预测器。训练仅需 100–200 个预生成特征样本,单卡 12GB 显存约 1 小时完成,无需加载扩散模型权重。
- 可逆投影架构:LinCa 采用轻量可逆网络将缓存特征投影到分解空间。每个可逆块由一个可逆 1×1 卷积和一个 additive coupling layer 组成,后者包含轻量 MLP F 和 G。严格可逆性保证从分解空间到原始特征空间的映射是无损的,这是“Decompose-Predict-Reconstruct”管线中 Reconstruct 环节的数学基础。
- 特征分解:缓存特征沿特征维被分解为 M=3 个子分量,分别对应不同的连续性水平。分解由可逆网络学习得到,而非手工设计,因此能自适应不同模型和不同去噪阶段的特征动态。
- 差异化阶数预测:对连续性最差的分量施加 0 阶预测(即直接复用历史缓存值),对连续性较好的分量分别施加 1 阶和 2 阶 Hermite 外推。Hermite 插值利用函数值和导数值进行多项式外推,比纯函数值外推(如 Taylor)在特征轨迹预测上更稳健。
- 时间步分段训练:将去噪过程划分为 S=3 个时间步段,每段独立训练同构但参数独立的预测器。这解决了跨时间步的 dynamics mismatch——早期去噪阶段特征变化剧烈,后期趋于平缓,不同阶段需要不同的预测行为。
- 极低训练开销:训练仅需 100–200 个预生成特征样本,单卡 12GB 显存约 1 小时完成。关键设计是训练过程完全解耦于扩散模型本身——只需缓存特征作为监督信号,无需加载扩散模型权重,也无需反向传播穿过扩散模型。
- 推理开销可忽略:论文第 22 页报告,单次缓存预测开销仅 0.02 TFLOPs,而完整去噪计算为 74.39 TFLOPs。这意味着 LinCa 的预测器本身几乎不消耗额外算力,加速收益几乎全部转化为实际推理加速。
- 与现有方法的本质区别:FORA、ToCa 属于 reuse-based 方法,直接复用缓存特征;TaylorSeer、FoCa、HyCa 属于 predict-based 方法,但采用统一预测策略。LinCa 是首个将可学习分解与差异化阶数预测结合的框架,且严格可逆性保证了重建环节的零信息损失。
- 高阶预测器选择:论文第 25 页的 Table 6 对比了 Hermite、Taylor、Chebyshev、Lagrange、Laguerre 五种高阶预测器。Hermite 在同等加速比下表现最优,这与其同时利用函数值和导数值的特性有关——去噪轨迹的导数信息对预测未来特征具有额外价值。
逐图理解论文
失败案例与直觉
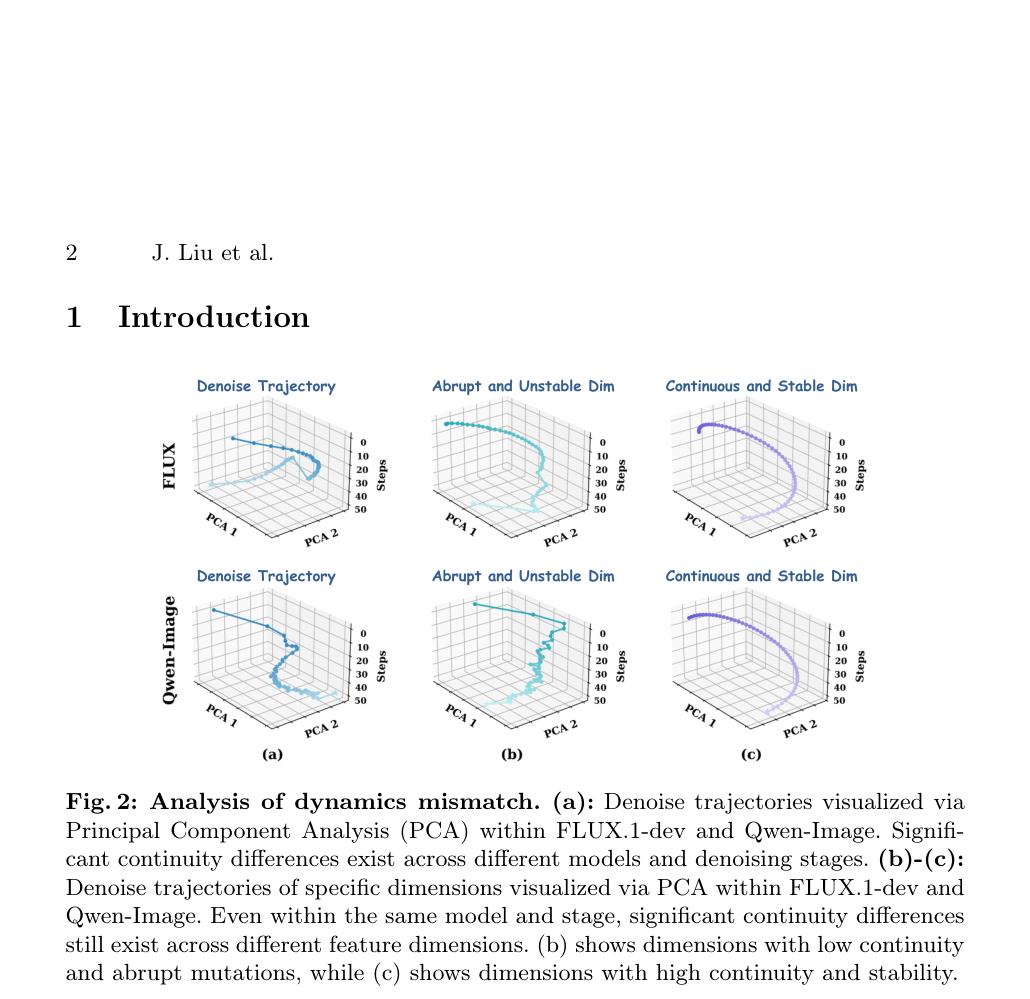
这张图是理解 LinCa 动机的关键。左图展示 FLUX.1-dev 和 Qwen-Image 的去噪轨迹在 PCA 空间中的形态差异,说明不同模型的连续性不同;右两图展示同一模型内不同特征维度的轨迹,部分维度突变频繁,部分维度高度平滑。这直接支撑了“统一预测策略必然顾此失彼”的核心论点。
LinCa 的贡献与验证
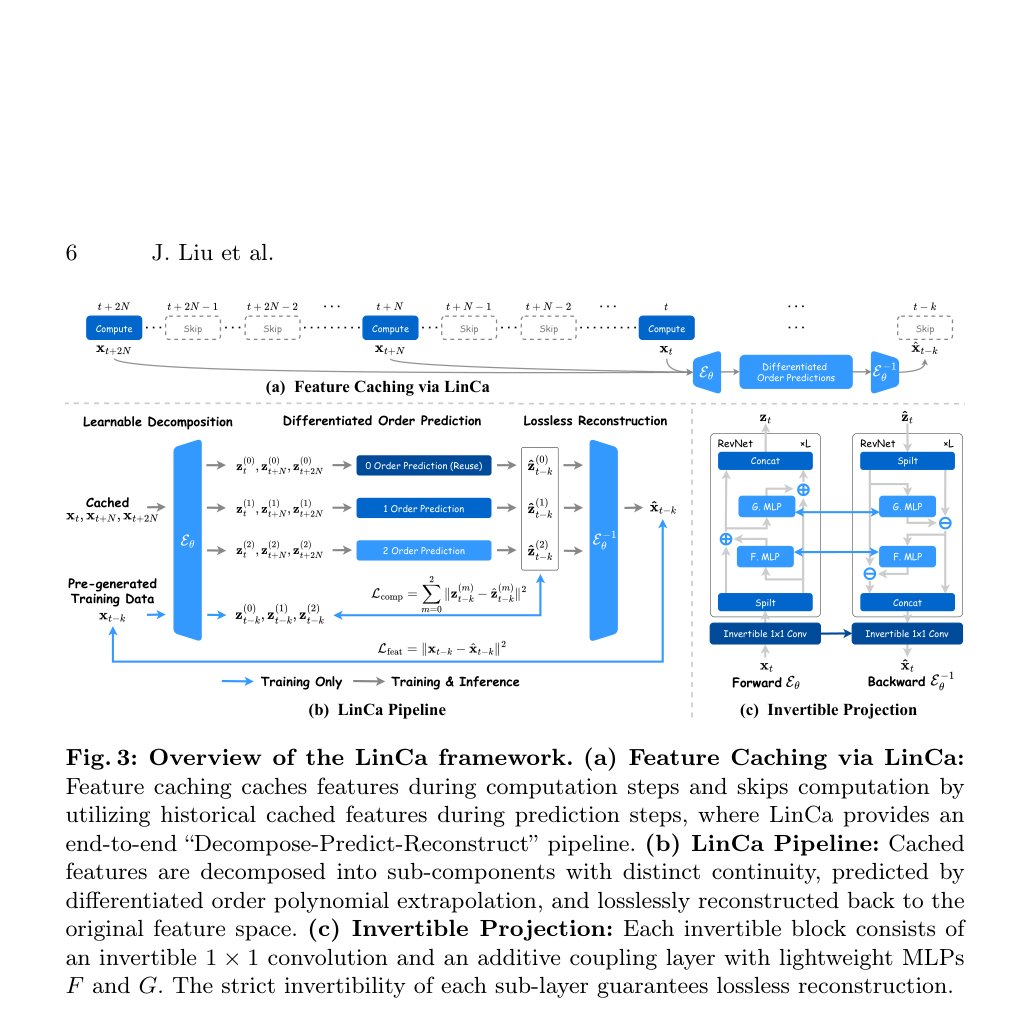
LinCa 框架总览图。子图 (a) 展示特征缓存在计算步和预测步之间的交替机制;子图 (b) 展示 Decompose-Predict-Reconstruct 管线的完整流程;子图 (c) 展示可逆块的结构细节,包括可逆 1×1 卷积和 additive coupling layer。注意可逆性是如何在架构层面被保证的。
核心结论
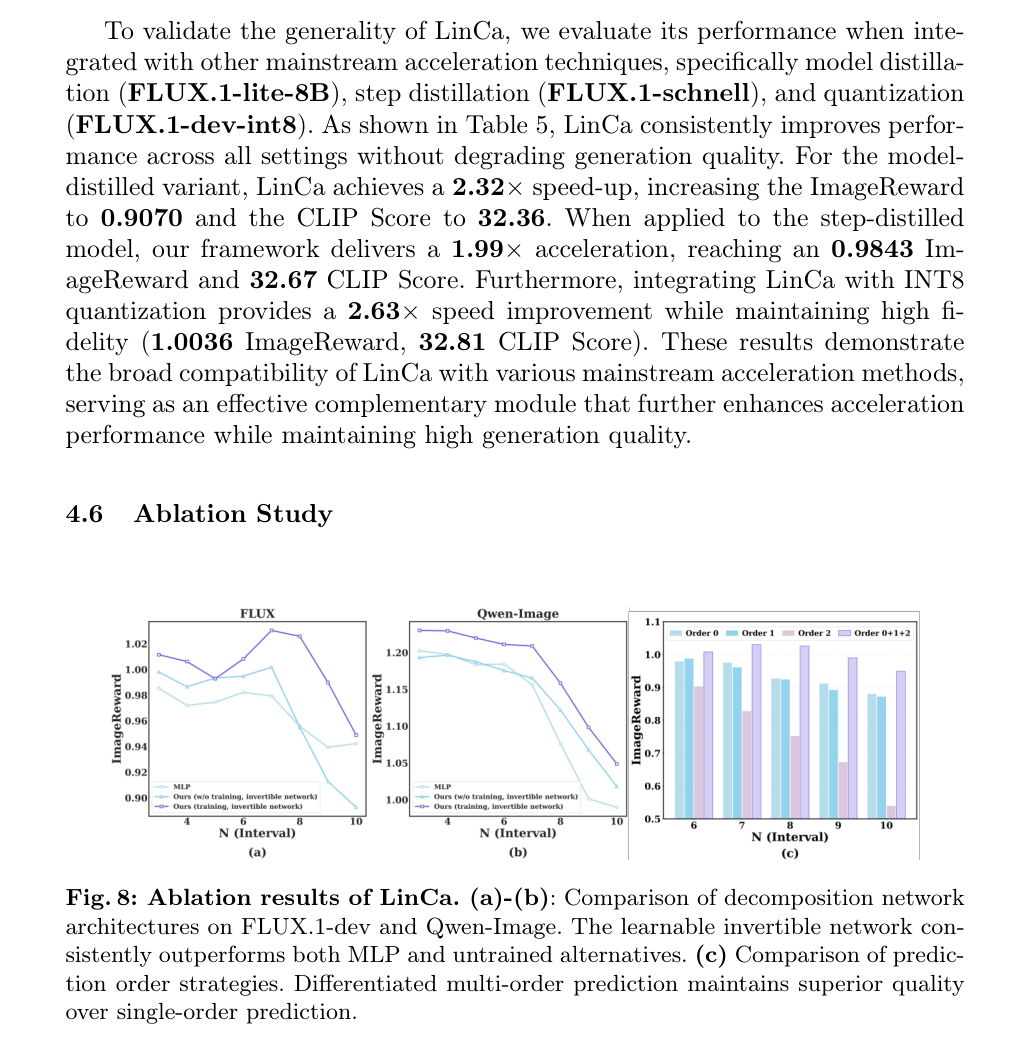
消融实验结果。子图 (a)-(b) 对比可逆网络、MLP 和非学习分解在 FLUX.1-dev 和 Qwen-Image 上的表现,可逆网络一致最优;子图 (c) 对比单阶预测和多阶预测,差异化多阶策略一致优于单阶。这张图直接验证了论文的两个核心设计选择。
意义与局限
LinCa 的意义在于,它把特征缓存从“手工规则”推进到了“可学习、可分解”的范式,而且训练开销小到可以忽略。但它并非万能:在极少数步的蒸馏模型上,可利用的冗余有限,额外加速只有两倍左右;而且每个新模型都需要重新训练预测器,并非完全即插即用。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 文本到图像生成:在 FLUX.1-dev 和 Qwen-Image 上进行对比实验,使用 DrawBench 200 prompts 作为评测集,对比 FORA、ToCa、TaylorSeer、FoCa、HyCa 等基线方法。
- 文本到视频生成:在 HunyuanVideo 上使用 VBench 946 prompts 进行评测,验证 LinCa 在时序生成任务上的泛化能力。
- 图像编辑:在 Qwen-Image-Edit 上使用 GEdit-Bench 1212 prompts 进行评测,考察 LinCa 对非编辑区域一致性的保持能力。
- 兼容性验证:在 FLUX.1-lite-8B、FLUX.1-schnell、FLUX.1-dev-int8 上验证与蒸馏模型和量化模型的兼容性;在 Qwen-Image-Lightning(8 步)上验证与少步蒸馏的叠加加速;在 Wan2.1-1.3B 上验证视频生成的跨模型泛化。
- 消融实验:对比分解网络架构(可逆网络 vs MLP vs 非学习)、预测阶数策略(单阶 vs 多阶),验证两个核心设计选择的必要性。
- 超参数敏感性:分析时间步段数 S、损失系数 λ、可逆块数 L 和隐藏维度 h 的影响,确定 S=3、λ=1、L=2、h=128 为最优配置。
关键结果与论文证据
- FLUX.1-dev 上 N=8 时实现 5.51× 加速,ImageReward 1.0162(相对原始模型 +2.3%),CLIP Score 32.72(+0.3%),在加速的同时略微提升偏好类指标(第 9 页 Table 1)。
- Qwen-Image 上 N=10 时实现 6.95× 加速,ImageReward 1.0524(相对原始模型 −16.0%),PSNR 29.10,SSIM 0.69,LPIPS 0.39;虽优于所有基线,但高加速比下并非严格“近无损”(第 10 页 Table 2)。
- HunyuanVideo 上 N=6 时实现 5.50× 加速,VBench Score 80.16(相对原始模型仅 −0.6%),在视频生成任务上保持高质量(第 11 页 Table 3)。
- Qwen-Image-Edit 上 N=10 时实现 7.08× 加速,GEdit-CN OS 7.27,GEdit-EN OS 7.40,验证了图像编辑场景下非编辑区域的一致性保持(第 12 页 Table 4)。
- 与蒸馏/量化模型兼容:FLUX.1-lite-8B 上 2.32× 加速且 ImageReward +1.5%,FLUX.1-schnell 上 1.99× 加速且 ImageReward +1.6%,FLUX.1-dev-int8 上 2.63× 加速且 ImageReward +3.0%(第 13 页 Table 5)。
- 消融实验证实两个核心设计的必要性:可学习可逆网络一致优于 MLP 和非学习替代方案;差异化多阶预测一致优于单阶预测(第 13 页 Fig. 8)。
- 高阶预测器对比中,Hermite 在 5.51× 加速下 ImageReward 1.0162,优于 Taylor(1.0139)、Chebyshev(1.0023)、Lagrange(1.0144)、Laguerre(0.9264)(第 25 页 Table 6)。
- 少步蒸馏场景下冗余有限:8 步 Qwen-Image-Lightning 上额外加速仅 2.00×,但 ImageReward 保持 1.26,GenEval 略升至 0.85(第 27 页 Table 9)。
阅读时需要注意
- 特征缓存主要适用于追求高质量的多步去噪模型,在极少数步(如 8 步 Qwen-Image-Lightning)设置下可利用的冗余有限,额外加速仅 2.00×。
- 需要为不同模型和时间步段分别训练预测器,虽训练成本低(单卡约 1 小时)但仍非完全 training-free,部署到新模型时需要额外的特征采集和训练步骤。
- 加速后的变体在偏好类指标(如 ImageReward)上偶尔略超原始模型,作者归因于特征预测的隐式时间正则化,但这一现象可能影响指标解读的可靠性——它暗示评测指标本身对生成质量的敏感度有限。
- Qwen-Image 上高加速比时 ImageReward 相对原始模型下降 16%,虽优于所有基线但并非严格“近无损”,用户需根据任务对质量的敏感度选择合适的加速比。
关联工作
- FORA(第 5 页):基于缓存块输出的 DiT 特征缓存方法,属于 reuse-based 基线,直接复用缓存特征而不做预测。
- ToCa(第 5 页):token-wise 自适应特征缓存方法,根据 token 重要性动态决定缓存策略,但仍属于 reuse-based 范畴。
- TaylorSeer(第 5 页):基于多项式外推的 predict-based 特征缓存方法,是 LinCa 的主要对比基线,采用统一的 Taylor 外推策略。
- FoCa(第 5 页):将特征缓存建模为 ODE 的预测-校准方法,在预测后引入校准步骤修正误差。
- HyCa(第 5 页):基于混合 ODE 建模的维度级缓存方法,在多个实验中为第二优基线,说明维度级处理方向的有效性。
- LESA(第 26 页):可学习阶段感知预测器的 training-based 加速方法,作为 training-based 对比,但未触及维度内部分解。
- RevNet(第 7 页):可逆残差网络,LinCa 可逆投影架构的参考来源,其 additive coupling layer 设计保证了严格可逆性。