快速导读:SAM2Dual 是一种无需训练、即插即用的推理期增强框架,通过双记忆结构与文本感知记忆模块提升 SAM2 在长视频目标分割中的长期稳定性。
SAM2 的流式记忆在长视频中容易受到近期不可靠预测的主导,导致误差逐步累积,最终表现为目标漂移甚至身份丢失。SAM2Dual 针对这一问题提出了一种完全无训练、即插即用的推理期增强框架,在不更新 SAM2 权重的前提下,通过重组记忆结构来提升长时视频目标分割的稳定性。
其核心思想可以概括为两点:一是用 Dual Memory 把单一流式记忆显式分离为短期记忆和长期记忆,并通过门控融合平衡快速适应与长期身份保持;二是用 Text-Aware Memory 从早期帧提取词级语义线索,对记忆键值进行语义兼容性重加权,在视觉证据较弱时提供额外的身份锚定。
英文题目:SAM2Dual: Training-Free, Dual Memory for Long-Term Video Object Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2608.18640
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长时视频目标分割的难点在于,目标可能经历遮挡、重现、尺度与姿态剧烈变化,而模型必须在数百甚至上千帧内持续保持对同一实例的准确覆盖。SAM2 作为零样本视频分割的代表性骨干,其流式记忆机制虽然高效,但本质上是一个不断被近期预测覆盖的有限容量缓冲。
当近期预测出现偏差时,这些偏差会被写入记忆,并在后续帧中被反复读取和放大,形成误差累积。论文中的定性对比清楚地展示了这一现象:在超过 1300 帧的长序列中,SAM2 在后期帧逐渐漂移并丢失目标,而 SAM2Dual 能够保持一致的覆盖。
这一失败模式揭示了一个关键的研究空白:单一流式记忆难以同时满足短期适应与长期身份保持这两个相互冲突的需求。短期适应要求记忆快速反映最新外观变化,而长期身份保持则要求记忆不被近期噪声主导。
此外,纯视觉匹配在弱视觉证据下存在固有不足。当目标外观与背景或其他实例相似时,仅靠视觉特征很难做出可靠判断。SAM2Dual 的文本感知记忆正是针对这一不足引入的补充信号。
核心创新
- 提出 Dual Memory 设计,在推理期将单一流式记忆显式分离为短期与长期记忆库,并通过门控融合平衡快速适应与长期身份保持
- 提出 Text-Aware Memory (TAM),利用词级语义线索对记忆键值进行语义兼容性重加权,在视觉证据弱时锚定身份
- 整体框架完全无训练、即插即用,不更新 SAM2 权重,仅重组推理期记忆结构
方法概览
SAM2Dual 在冻结的 SAM2 骨干上引入两个推理期模块:(1) Dual Memory 将流式记忆重构为短期记忆(最近 K 个槽)和长期记忆(每 m 帧间隔采样,最多 L 个槽),通过门控融合系数 α 组合两路注意力响应;(2) Text-Aware Memory (TAM) 从前 N 帧用 BLIP 提取词级语义线索,经 JINA-CLIP 嵌入后与记忆键计算余弦相似度,以 λword 调制强度对语义兼容的记忆键值进行残差式上加权。
- Dual Memory 将 SAM2 原有的流式记忆重构为两个记忆库:短期记忆保留最近 K 个槽,长期记忆以每 m 帧间隔采样、最多保留 L 个槽。这种设计借鉴了 XMem 基于 Atkinson-Shiffrin 记忆模型的显式分离原则,但完全在推理期实现。
- 两路记忆分别产生注意力响应,通过门控融合系数 α 组合。α 控制短期与长期响应的相对权重,使模型在快速适应与长期稳定之间取得平衡。
- Text-Aware Memory(TAM)从前 N 帧用 BLIP 提取词级语义线索,经 JINA-CLIP 嵌入后与记忆键计算余弦相似度。JINA-CLIP 采用 Matryoshka 式训练,其紧凑嵌入在保留语义信息的同时降低了计算开销。
- TAM 以 λword 调制强度对语义兼容的记忆键值进行残差式上加权。这意味着与文本线索语义一致的记忆槽会被增强,而不一致的槽则相对抑制,从而在视觉证据弱时锚定目标身份。
- 整个框架不更新 SAM2 的任何权重,只重组推理期的记忆读取与融合方式,因此可以即插即用地部署到现有 SAM2 系统中。
- 超参数在 DAVIS train 和 LVOSv2 train 上联合调优,论文报告的最佳设置为 λword=0.10、α=0.63、m=10。
逐图理解论文
失败案例与直觉
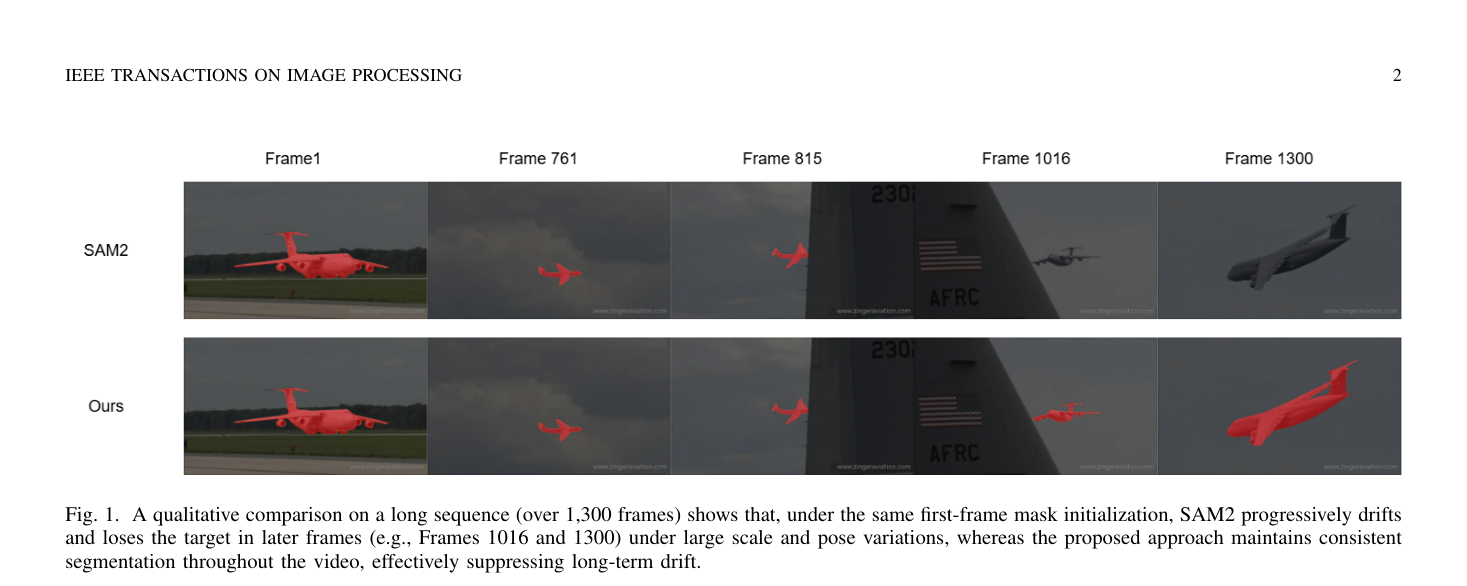
该图对比了超过 1300 帧长序列中 SAM2 与 SAM2Dual 的定性表现。应重点观察后期帧(如第 1016 帧和第 1300 帧)中 SAM2 的掩码如何逐渐漂移并丢失目标,而 SAM2Dual 保持稳定覆盖,这直接支撑了论文的核心论点。
研究空白与核心区分
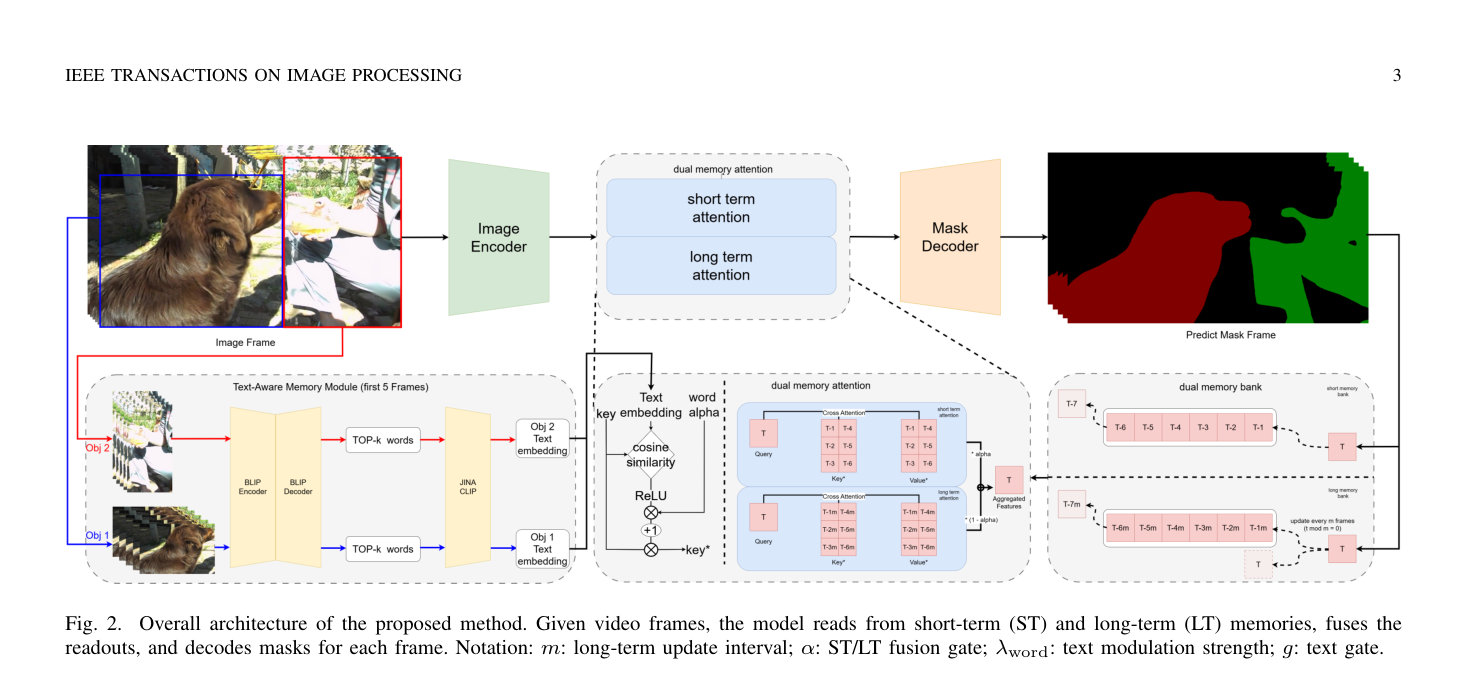
该图展示了整体架构,包括短期与长期记忆的读取、门控融合和文本调制路径。应关注 α 如何组合两路响应,以及 λword 如何通过文本门控影响记忆键值,这是理解方法机制的关键。
消融与定性证据
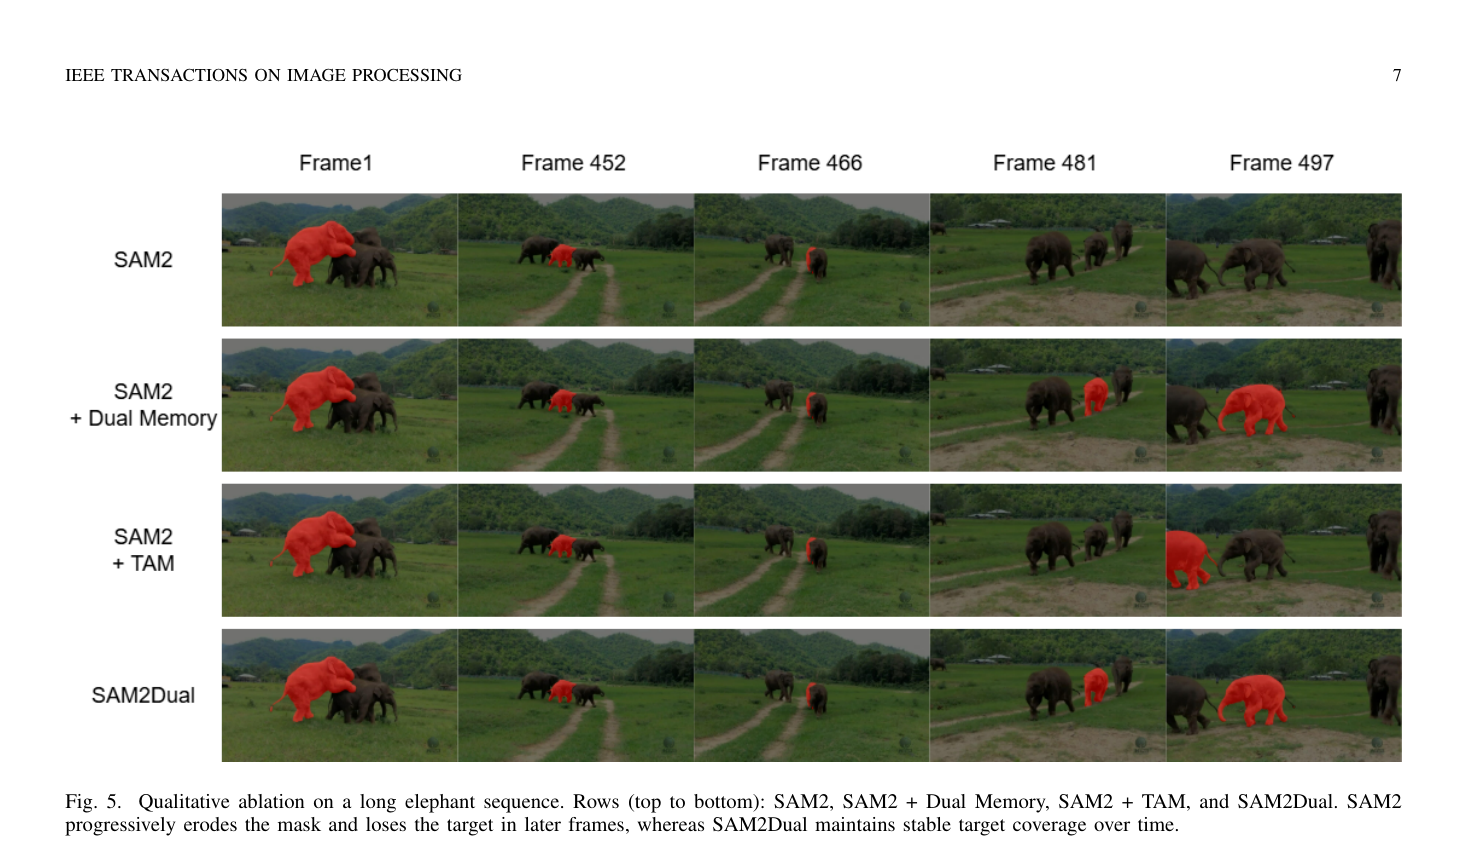
该图展示大象长序列上的定性消融,四行分别对应 SAM2、SAM2+Dual、SAM2+TAM 和 SAM2Dual。应对比后期帧中各行掩码的完整性与稳定性,观察 Dual 和 TAM 各自及组合的贡献。
结论与局限
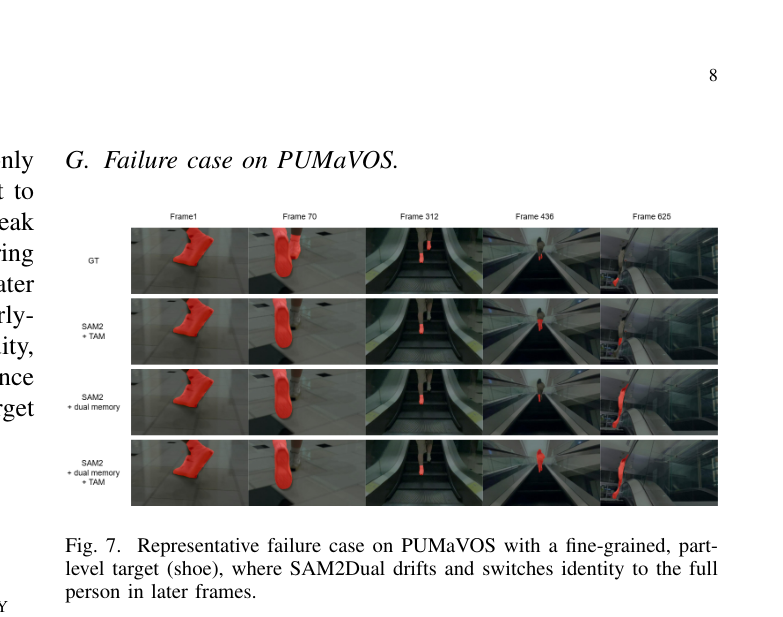
该图展示 PUMaVOS 上的代表性失败案例,目标是细粒度部件级的鞋子。应观察 SAM2Dual 如何在后期帧漂移并切换到整个人,这揭示了方法在部件级目标上的局限。
实验如何设计?
- 主实验在 MOSEv2、LVOSv2 val、PUMaVOS val 三个长时基准上进行,与 DeAOT、XMem++、Cutie、SAM2、SAMURAI、HiM2SAM 对比。
- 在 MOSEv2 最长 10% 序列上按序列长度分析逐序列 J 和 F 分数,以检验方法在极端长序列上的表现。
- 消融实验分别评估 Dual Memory only、TAM only 和 Dual+TAM 在三个基准上的贡献。
- 在 LVOSv2 train 和 DAVIS train 上对 λword、α、m 进行超参数敏感性扫描。
- 定性消融在长序列大象和赛车场景中对比 SAM2、SAM2+Dual、SAM2+TAM 和 SAM2Dual 的逐帧表现。
关键结果与论文证据
- SAM2Dual 在 MOSEv2 上 J&F 从 SAM2 的 49.33 提升至 50.65(第 5 页),表明在最具挑战性的长时基准上取得了稳定增益。
- 在 LVOSv2 上 J&F 从 82.1 提升至 83.1(第 5 页),进一步验证了方法的有效性。
- 在 PUMaVOS 上 J&F 为 80.6,略低于 SAM2 的 81.0(第 5 页),说明方法并非在所有基准上都占优。
- 消融显示 Dual only 在 MOSEv2 上为 50.4,TAM only 为 49.33,Dual+TAM 为 50.65(第 6 页),表明双记忆是主要贡献来源,TAM 的增益在组合中才充分体现。
- 按序列长度分析显示,SAM2Dual 的优势在最长序列上更为明显(第 6 页图 3、图 4),与抑制长期漂移的核心论点一致。
- 定性消融中,SAM2 在后期帧逐渐侵蚀掩码并丢失目标,而 SAM2Dual 保持稳定覆盖(第 7 页图 5、图 6)。
- 超参数扫描在 LVOSv2 train 上最佳设置达 J&F 92.80,基线为 92.3;在 DAVIS train 上达 90.90,基线为 90.5(第 8 页)。
- 附录中报告了先前设置下的补充结果:DAVIS 89.40、YouTube-VOS 88.56、LVOSv1 80.41(第 9 页),但需注意这些结果与主表参考设置不可直接比较。
阅读时需要注意
- 在 PUMaVOS 上整体 J&F 略低于 SAM2 基线,说明方法并非在所有场景下都有效。
- 固定周期长期记忆更新策略在细粒度部件级目标上可能写入不准确的中间预测,导致漂移到更大的语义相关实例。
- TAM 的类别级语义线索在多个相似实例同时存在时可能引发身份切换。
- 超参数在 DAVIS train 和 LVOSv2 train 上联合调优,可能对特定数据集分布存在偏好。
- DeAOT 在三个长时基准上均 OOM,其对比意义有限。
关联工作
- SAM2 作为骨干模型提供流式记忆的零样本视频分割能力,SAM2Dual 在其上做推理期增强,不改变其训练范式。
- XMem 基于 Atkinson-Shiffrin 记忆模型的长时 VOS 框架,启发了显式分离短期与长期记忆的设计原则。
- CLIP 提供对齐的图像-文本嵌入,为 TAM 的语义锚定提供轻量信号来源;JINA-CLIP 则通过 Matryoshka 式训练获得紧凑且保留语义的文本嵌入。
- SAMURAI 和 HiM2SAM 作为 SAM 系列的增强方法被纳入对比,分别代表面向跟踪的适配和层次运动估计与记忆优化的路线。