快速导读:USR-Drive提出一个统一生成框架,将稠密3D高斯几何与稀疏3D检测框作为共同演化的潜在变量,通过多模态扩散Transformer联合去噪,实现动态重建与3D检测的相互增强。
USR-Drive的核心主张是:动态场景重建与3D检测不应被当作两个独立任务,而应被建模为同一个生成过程中共同演化的两个状态变量。论文将稠密3D高斯几何与稀疏3D检测框分别编码为潜在token,送入基于Wan2.1-1.3B初始化的MMDiT进行联合整流流去噪,使几何与布局在共享自注意力中实现双向正则化。
这一设计直接回应了自动驾驶空间表示学习中的一个长期割裂:前馈重建方法缺乏实例级结构约束,而检测方法缺乏稠密几何的度量级空间锚定。USR-Drive的答案是让两者在同一个去噪轨迹上互相提供约束——几何为框提供空间接地,框为几何提供运动先验。
英文题目:USR-Drive: Unified Driving Scene Representation via Joint Denoising of 3D Gaussians and Boxes
论文出处:arXiv 每日论文精选 · arXiv:2608.19036
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有动态场景重建方法(如DGGT、STORM)在处理快速运动物体时容易出现时序拖影(temporal smearing),因为稠密几何在时序上欠约束,缺乏实例级运动先验来区分前景与背景。
另一方面,3D检测方法(如BEVFormer、RoPETR)虽然能输出实例级框,但框的空间定位缺乏稠密几何的度量级锚定,导致框与场景几何之间可能存在物理不一致。
生成式世界模型(如MagicDrive-V2)虽然将3D框作为条件引入视频生成,但框只是外部输入,不可从几何中推断,因此无法实现稠密几何与稀疏布局之间的双向信息流动。
USR-Drive的研究空白在于:没有任何现有方法将稠密几何与稀疏布局建模为同一去噪过程中的共同演化状态变量,从而让两者在生成过程中互相增强。
核心创新
- 提出统一场景表示,将稠密3D高斯与稀疏3D框建模为共同演化的状态变量,而非外部条件或分离模块
- 设计双分支自编码器框架,分别压缩稠密几何与槽对齐3D框序列,形成解耦但对齐的潜在空间
- 提出统一位置编码(UPE),通过共享的度量时空傅里叶特征将异构token锚定到同一3D度量坐标系
- 开发基于MMDiT的联合去噪框架,使几何与布局token在共享自注意力中实现双向正则化
- 引入辅助布局token(置信度c、锚点相对偏移δ、速度v、动态属性a)作为独立去噪分支,增强检测精度与运动感知
方法概览
USR-Drive分两阶段:Stage I采用双分支自编码器,几何分支基于冻结的Depth Anything V3 Base编码器与RAE瓶颈压缩稠密高斯几何为潜在z_geo,框分支将槽对齐的3D框序列编码为潜在z_box;Stage II通过统一位置编码(UPE)将两类异构token锚定到共享度量时空坐标系,送入基于Wan2.1-1.3B的MMDiT进行联合整流流去噪,条件为Wan-VAE编码的参考视频潜在,最终由DPT解码器和框解码器分别输出动态3DGS与3D检测框。
- Stage I采用双分支自编码器:几何分支基于冻结的Depth Anything 3 Base编码器与RAE瓶颈,将稠密高斯几何压缩为潜在z_geo;框分支将槽对齐的3D框序列编码为潜在z_box,形成解耦但对齐的潜在空间。
- 统一位置编码(UPE)是连接异构token的关键:通过共享的度量时空傅里叶特征,将稠密几何token与框token锚定到同一3D度量坐标系,使跨模态注意力具有物理意义。
- Stage II基于Wan2.1-1.3B的MMDiT进行联合整流流去噪,条件为Wan-VAE编码的参考视频潜在,几何与布局token在共享自注意力中实现双向正则化。
- 辅助布局token(置信度c、锚点相对偏移δ、速度v、动态属性a)作为独立去噪分支,增强检测精度与运动感知,使框不仅包含位置信息,还包含运动状态。
- 推理时从纯噪声出发,MMDiT迭代去噪联合潜在流,最终由DPT解码器和框解码器分别输出动态3DGS与3D检测框,无需真值框或轨迹标注。
- 训练采用高噪声课程策略与λ_box权重平衡,确保几何保真度与布局精度之间的最优权衡。
逐图理解论文
失败案例与直觉
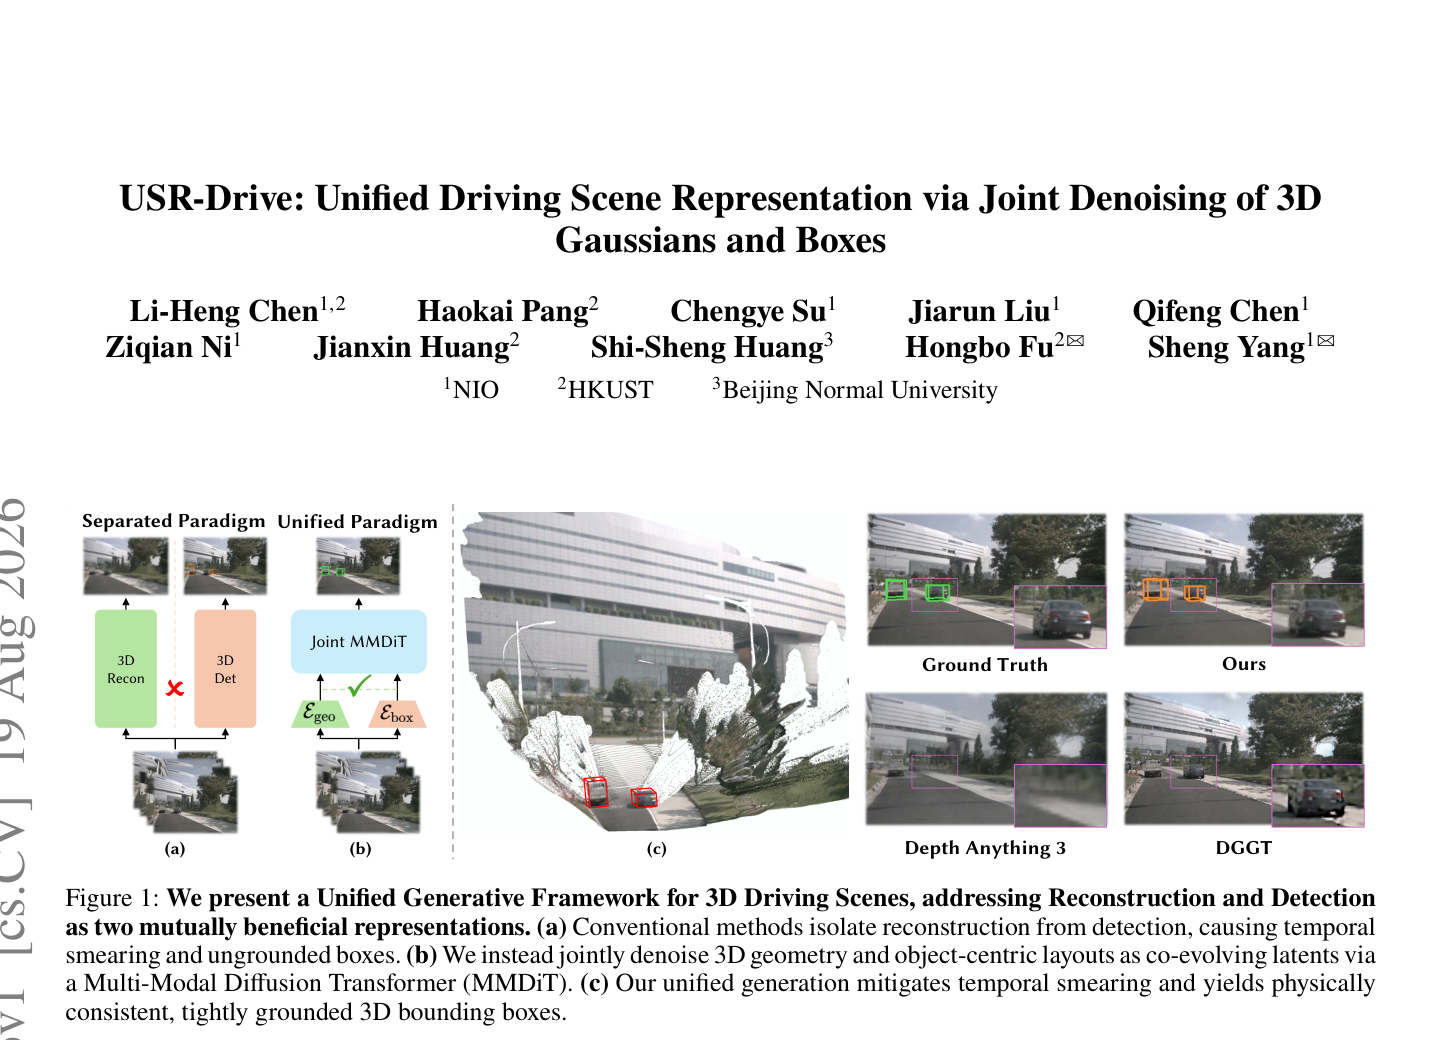
图1对比了传统分离式方法与USR-Drive的统一生成框架。注意观察传统方法中动态物体的时序拖影和框与几何的不一致,以及USR-Drive如何通过联合去噪同时改善两者。
研究空白
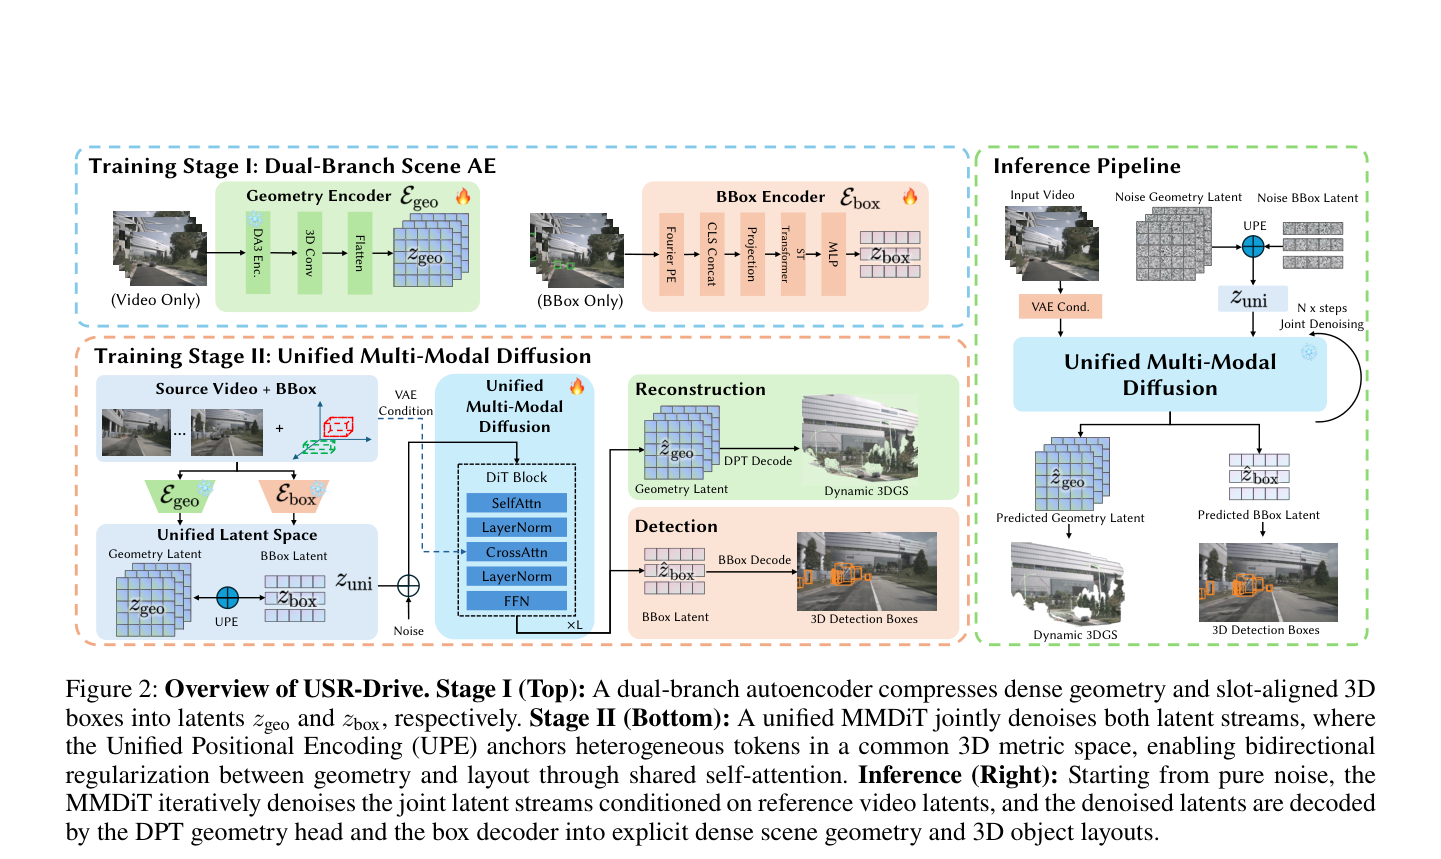
图2展示了完整的两阶段架构。重点观察Stage I的双分支自编码器如何分别压缩几何与框,以及Stage II中UPE如何将异构token锚定到共享坐标系后送入MMDiT。
验证与消融
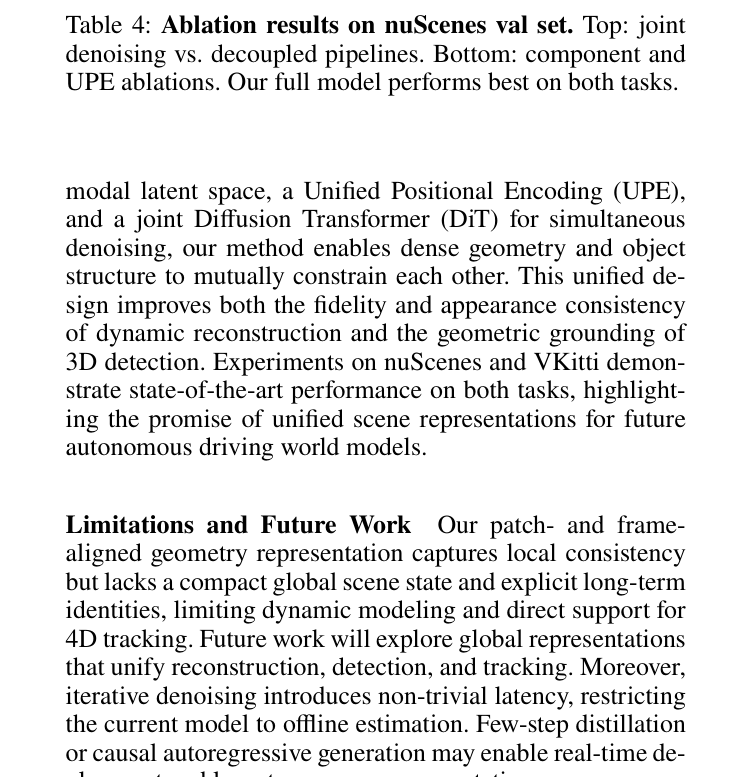
表4的消融实验是理解联合去噪价值的关键。对比完整模型与解耦流水线、仅几何、仅框、无UPE的差异,可以直观看到双向正则化的贡献。
实验如何设计?
- 在nuScenes数据集上进行动态场景重建与3D检测的全面评估,使用6路环视相机、T=8帧时序片段、112×168分辨率。
- 在VKitti数据集上进行零样本重建与3D检测评估,采样400个案例,验证跨数据集泛化能力。
- 与重建基线(VGGT、DA3、Pi-3、AnySplat、STORM、DGGT)和检测基线(BEVDepth、BEVFormer、PETRv2、HoP、StreamPETR、RayDN、RoPETR)对比。
- 消融实验覆盖联合去噪vs解耦流水线、组件消融(仅几何/仅框/无UPE)、辅助布局token放置方式、训练超参数(λ_box与高噪声课程)、MMDiT隐藏维度。
关键结果与论文证据
- nuScenes场景级重建:PSNR 27.55、SSIM 0.853、LPIPS 0.076、D-RMSE 4.59,均优于所有基线(第7页Table 1)。
- nuScenes前景动态物体重建:PSNR 24.45,显著优于DGGT(PSNR 19.73)和STORM(PSNR 20.97),验证联合去噪对动态物体的时序约束效果(第7页Table 1)。
- nuScenes 3D检测:NDS 0.625、mAP 0.552,超越RoPETR(NDS 0.614)和RayDN(NDS 0.563),证明几何分支为检测提供了有效的空间接地(第7页Table 2)。
- VKitti零样本:重建PSNR 26.45、检测mAP 0.518,表明统一框架具备跨数据集泛化能力(第7页Table 3)。
- 消融实验显示解耦两阶段流水线PSNR降至21.47、mAP降至0.473,证明联合去噪的双向正则化是关键贡献(第7页Table 4)。
- 无UPE时mAP降至0.214,说明统一位置编码对跨模态对齐至关重要(第7页Table 4)。
- 仅框分支时mAP仅0.012,说明框分支无法独立完成检测任务,必须依赖几何分支提供的空间上下文(第7页Table 4)。
- 推理效率:单H800 GPU处理6相机×8帧片段需45.2秒、峰值显存58.5GB,其中50步迭代去噪占主导(第11页)。
阅读时需要注意
- 补丁与帧对齐的几何表示缺乏紧凑的全局场景状态和显式长期身份,限制动态建模与4D跟踪支持。
- 迭代去噪引入显著延迟(单片段45.2秒),当前仅适用于离线估计,无法实时部署。
- VGGT和Pi-3仅产生3D点云,渲染图像质量指标未报告,对比时需注意公平性。
- 检测基线结果继承自官方论文报告值,非统一复现环境下的对比。
- VKitti零样本评估仅采样400个案例,样本量有限。
关联工作
- VGGT和Pi-3代表静态场景前馈几何重建路线,仅输出3D点云,缺乏实例级语义。
- DGGT和STORM代表动态前馈4D重建路线,具有动态头解耦运动代理,但仍缺乏实例级结构约束。
- MagicDrive-V2将3D框作为外部条件引导多视图视频生成,但布局不可从几何中推断,与USR-Drive的可推断状态变量设计形成对比。
- UniScene联合生成3D语义占用与视频,但使用粗体素网格限制渲染保真度,USR-Drive的3D高斯表示在渲染质量上更具优势。
- Wan 2.1提供MMDiT骨干初始化权重与视觉VAE条件编码器,是USR-Drive的重要基础设施。