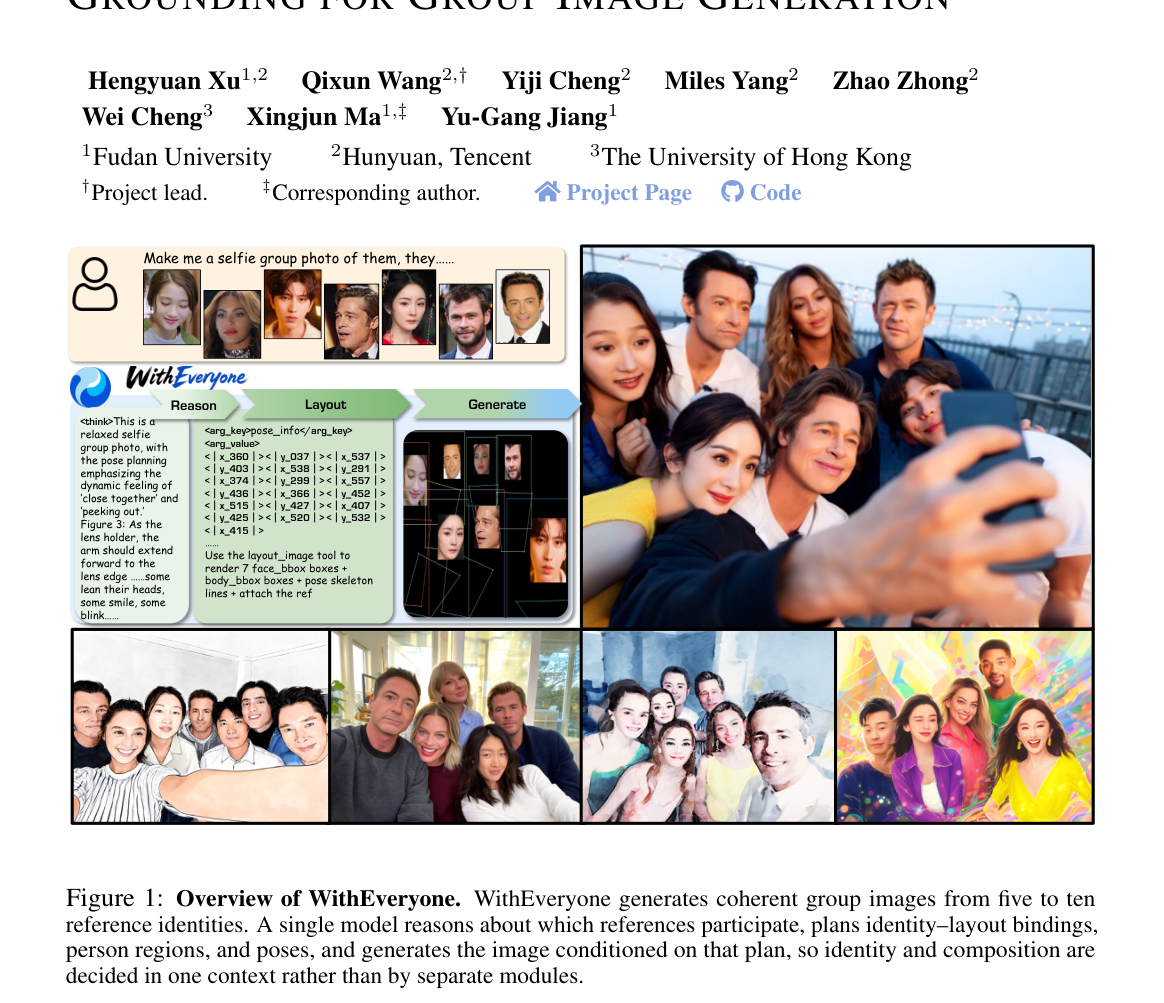
快速导读:WithEveryone 提出统一多模态框架,通过身份-布局联合规划与 Layout-Grounded ID Loss,实现 5–10 人参考身份的连贯群体图像生成。
WithEveryone 解决的核心问题是:当参考身份从一两人扩展到五到十人时,现有多身份图像生成方法会出现身份相似度下降、人脸重复或身份混淆。论文的答案不是更强的编码器或更大的模型,而是把身份与布局的决策从生成过程中剥离出来,放到一个统一的规划阶段。
这篇论文的贡献可以概括为三点:在单一统一多模态模型(UMM)中交错进行身份与布局推理;提出 Layout-Grounded ID Loss(LG-ID Loss),用标注人脸区域直接监督目标身份,避免训练期嵌入匹配的不可靠性;以及构建 210 例 5–10 人身份不相交基准,系统评估群体图像生成。
英文题目:WithEveryone: Unified Planning and Identity Grounding for Group Image Generation
论文出处:arXiv 每日论文精选 · arXiv:2608.20336
原始论文:PDF / 论文页面
这篇论文解决什么问题?
身份保持生成从单人扩展到多人时,学术方法通常只支持 1–5 人。WithAnyone 使用嵌入匹配的 Hungarian 分配,最多支持两人;UMO 报告最多三人。当人数继续增加,身份相似度下降、人脸重复或身份混淆成为普遍现象。
训练期身份损失依赖嵌入匹配是一个被忽视的瓶颈。嵌入匹配在训练时是不可靠的:它需要把生成的人脸与参考身份一一对应,但对应关系本身正是模型要学习的内容。当人数增多,匹配错误的概率上升,身份监督信号随之退化。
统一多模态模型(UMM)支持文本与图像共享上下文,为生成前规划提供了条件。ATLAS 已经展示了布局感知推理规划的有效性,但尚未扩展到身份感知设置。WithEveryone 的关键判断是:身份与布局的决策应该在同一个上下文中完成,而不是由分离的模块分别处理。
核心创新
- 在单一统一模型中交错进行身份与布局推理,ID token 与 Layout CoT 联合决定身份与构图
- 提出 Layout-Grounded ID Loss(LG-ID Loss),用布局标注替代嵌入匹配建立身份对应,使输出侧身份监督可扩展到 5–10 人
- ID Representation Forcing 在图像合成前对每个身份进行监督表征预测,增强身份可寻址性
- 构建 5–10 人身份不相交基准(210 例),系统评估群体图像生成
方法概览
WithEveryone 将每个参考身份编码为 ID token,自回归预测结构化 Layout CoT(身份-布局绑定、人脸/身体区域、姿态关键点),渲染为视觉条件;ID Representation Forcing 在合成前监督每个身份的表征预测;LG-ID Loss 利用标注人脸区域直接监督目标身份,避免嵌入匹配。
- 每个参考身份被编码为 ID token,由 ArcFace 嵌入投影得到紧凑身份表示。模型自回归预测结构化 Layout CoT,包含身份-布局绑定、人脸/身体区域和姿态关键点。
- Layout CoT 被渲染为视觉布局条件,作为图像生成的条件输入。这样身份与构图在生成前就被显式决定,而不是在生成过程中隐式涌现。
- ID Representation Forcing 在图像合成前监督每个身份的表征预测,灵感来自 Representation Forcing。它让模型在生成像素之前先“说出”每个身份应该是什么,增强身份可寻址性。
- LG-ID Loss 是核心创新。它利用标注人脸区域直接监督目标身份,避免嵌入匹配。因为每个身份在其标注区域内被监督,损失函数同时携带身份信号和空间信号——把正确的人放在正确的位置。
- 模型采用 transfusion 风格多模态架构,自回归推理与 flow matching 图像生成通过 modality-switch token 标记边界。
- 训练语料包含 400K 群体图像样本,参考数分布覆盖 5–10 人评估范围,包含真实照片、拼贴和海报图像。
逐图理解论文
失败案例与直觉
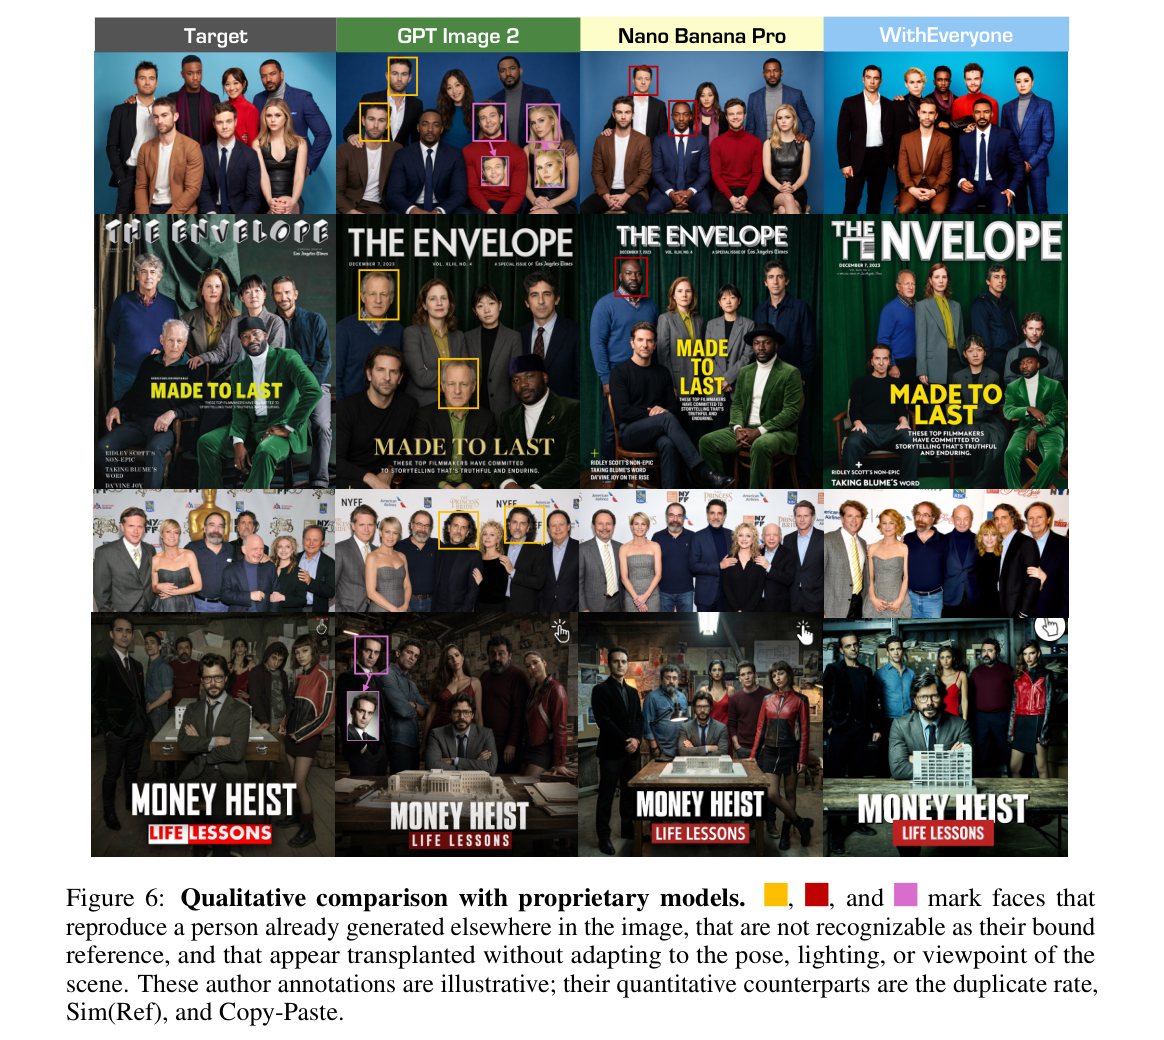
定性对比中标注了重复人脸、不可识别身份和移植伪影。这些标注是说明性的,定量对应是 Dup、Sim(Ref) 和 Copy-Paste。
核心贡献与验证方式
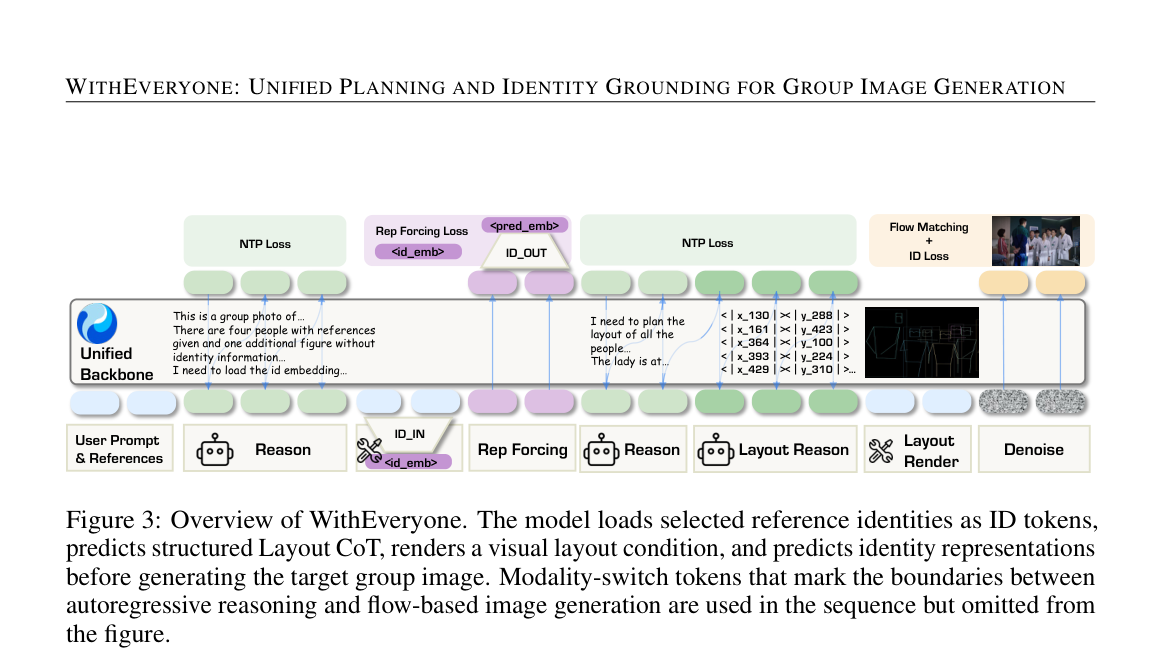
关注序列结构:ID token 之后是 Layout CoT 的自回归预测,渲染为视觉条件,再进入 flow matching 图像生成。Representation Forcing 发生在图像合成之前。
最强结论
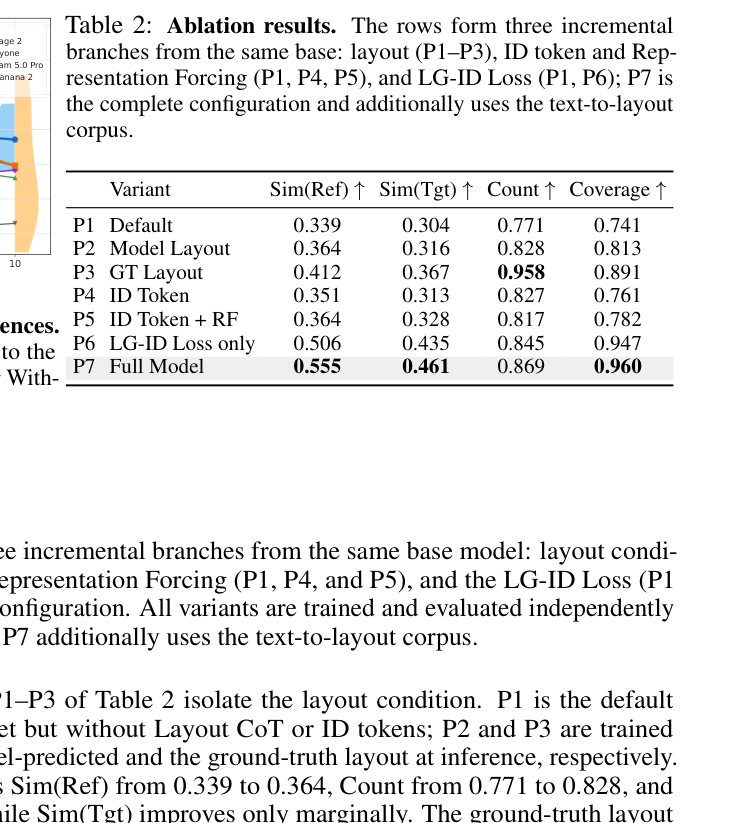
消融的三个分支分别隔离布局、ID token 与 Representation Forcing、LG-ID Loss 的贡献。LG-ID Loss 的增益最大,是核心组件。
意义与局限
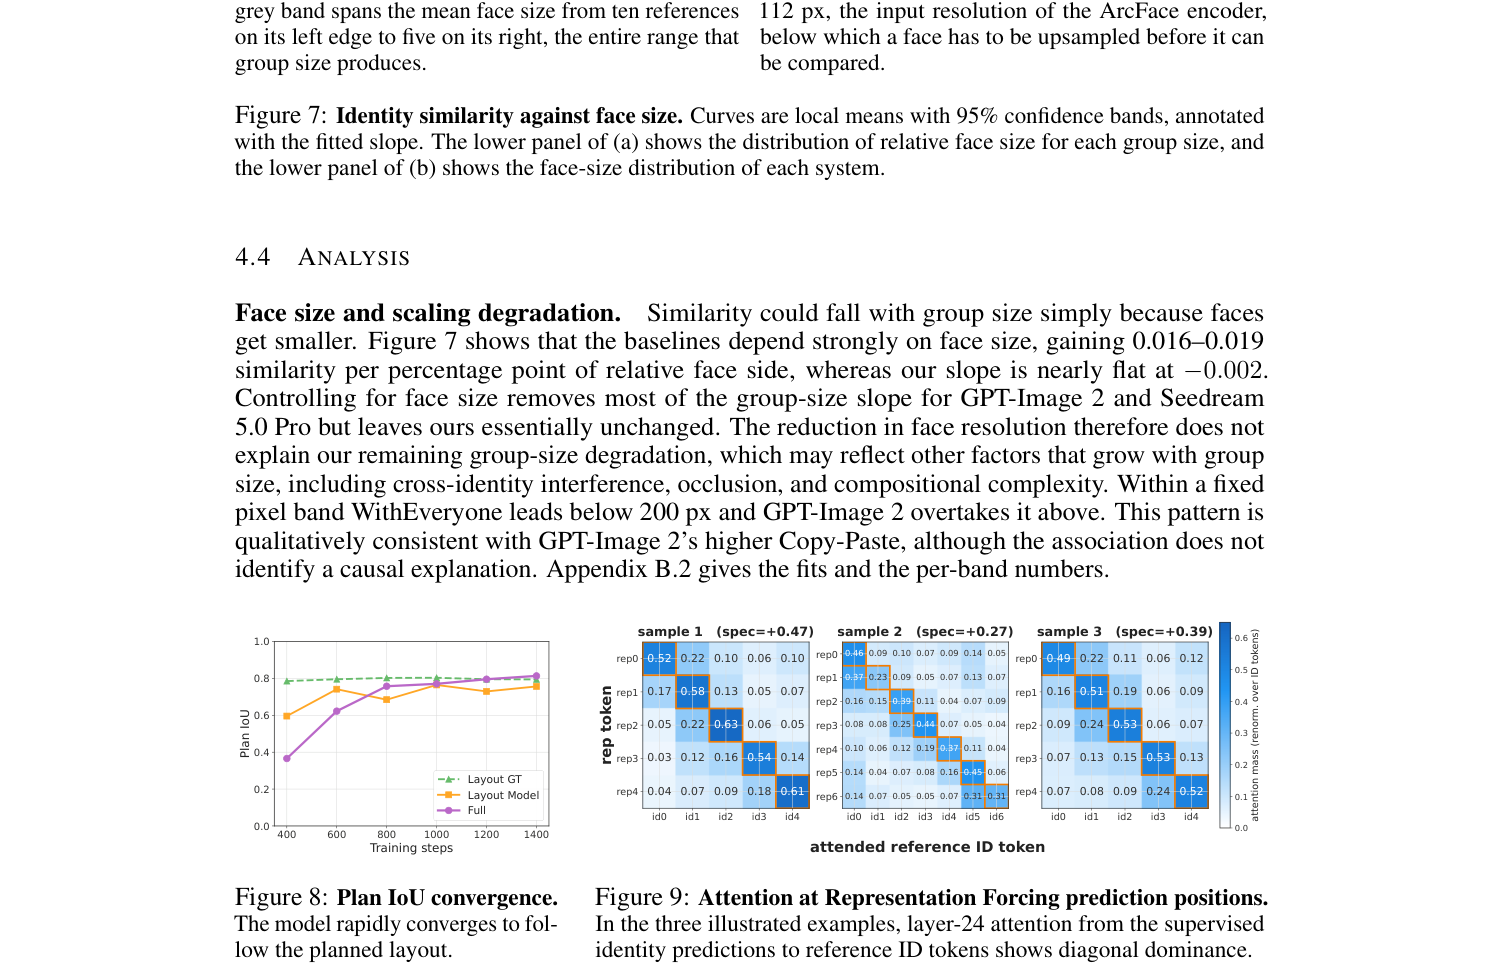
Plan IoU 快速收敛到 0.8 以上,说明模型能执行自身规划。但规划质量仍是剩余误差来源,需要结合身份相似度一起解读。
实验如何设计?
- 在 210 例 5–10 人身份不相交基准上与学术方法(UMO、WithAnyone、UniPortrait、DreamO、ID-Patch)、开源模型(FLUX.2 Klein、Qwen-Image-Edit、LongCat-Image-Edit、OmniGen2、SenseNova U1、BAGEL、HiDream-O1)及专有系统(Nano Banana Pro/2、GPT-Image 2、Seedream 4.5/5.0 Pro)对比。
- 消融实验分三个增量分支:布局条件(P1–P3)、ID token 与 Representation Forcing(P1/P4/P5)、LG-ID Loss(P1/P6),完整配置为 P7。
- 分析实验包括人脸尺寸与群体规模退化、Plan IoU 规划与执行分离、Representation Forcing 注意力机制、高分辨率训练对比。
- 主协议使用三个面部编码器平均身份相似度,单编码器 ArcFace 协议结果不可直接比较。
关键结果与论文证据
- Sim(Tgt) 0.499 优于 GPT-Image 2 的 0.462(第 8 页),说明生成人脸与目标上下文中身份的一致性更强。
- Copy-Paste 0.055 低于 GPT-Image 2 的 0.169(第 8 页),表明生成人脸不是简单复制参考人脸。
- Coverage 0.973,Dup 0.028(第 8 页),几乎所有参考身份都被生成且几乎没有身份坍缩。
- LG-ID Loss 单独将 Sim(Ref) 从 0.339 提升至 0.506,Sim(Tgt) 从 0.304 提升至 0.435(第 9 页),是最大的单项身份增益。
- ArcFace 相似度随参考数从 5 到 10 仅从 0.629 降至 0.571,而 GPT-Image 2 从 0.593 降至 0.496(第 9 页),WithEveryone 的退化更平缓。
- Plan IoU 达 0.773,完整模型收敛至 0.814(第 11 页),模型能较好地执行自身规划。
- Representation Forcing 的端到端增益较小(Sim(Ref) +0.013,Sim(Tgt) +0.015),但注意力图显示对角占优(第 11 页),说明身份预测确实对应到正确的 ID token。
- CLIP-T 文本对齐分数 0.273 低于 ID-Patch 的 0.331 和 UniPortrait 的 0.301,文本遵循能力是短板。
阅读时需要注意
- 规划质量而非规划执行是剩余误差的主要来源:Plan IoU 高但身份相似度仍有下降空间,说明模型规划出的布局本身可能不够好。
- CLIP-T 文本对齐分数偏低,文本指令遵循能力弱于部分基线。
- Representation Forcing 的端到端增益较小,其价值更多体现在可解释性和身份可寻址性上。
- 群体规模增大时身份相似度仍会下降,可能源于跨身份干扰、遮挡和构图复杂度。
- P7 同时加入多个组件和额外语料,无法归因于单一因素;P3 使用 ground-truth 布局是 oracle 上界。
关联工作
- WithAnyone 是身份保持生成与 Copy-Paste 指标的来源,使用嵌入匹配的 Hungarian 分配,最多支持两人。
- PuLID 提供输出侧身份监督,但仅处理单一身份。
- ATLAS 展示布局感知推理规划,WithEveryone 将其扩展到身份感知设置。
- UMO 是多身份一致性生成基线,报告最多三人。
- Transfusion 是 WithEveryone 采用的 transfusion 风格多模态架构基础。