快速导读:DyG2T通过空间补全与时间解耦增强关键点表示,并利用粒子图Transformer建模多尺度交互,实现从稀疏视角视频中准确预测动态物体运动轨迹。
物体动力学建模是具身智能、数字孪生和机器人操作中的基础能力:给定一段稀疏视角视频,系统需要预测物体在未来时刻的几何形变与运动轨迹。现有方法大致分为两类:强物理先验方法依赖材料本构方程或连续介质力学,泛化性受限;可微网络方法则从数据中学习运动规律,但普遍依赖FPS下采样得到的稀疏关键点,并在局部邻域内传播特征,导致细粒度局部细节丢失和特征同质化。
DyG2T的核心论点是:关键点表示之所以退化,不是因为网络容量不足,而是因为关键点本身携带的信息不完整,且时间维度上相邻帧的表示过于相似。论文从空间补全和时间解耦两个方向同时增强关键点表示,再用全局注意力的粒子图Transformer建模多尺度交互,从而在轨迹预测和外观重建两个层面都取得显著提升。
英文题目:DyG2T: Modeling Object Dynamics with 3D Gaussian Temporal-Spatial Particle Graph Transformer
论文出处:arXiv 每日论文精选 · arXiv:2608.18498
原始论文:PDF / 论文页面
这篇论文解决什么问题?
可微网络方法的典型流程是:先用Dyn3DGS从多视角视频重建可追踪的原始粒子序列,再通过FPS下采样得到少量关键点,用MLP或GNN在关键点图上建模运动。问题在于,FPS下采样天然丢弃了原始粒子的细粒度几何信息,而GNN的局部消息传递机制又使得相邻关键点的表示逐渐趋同。
这种表示坍缩在时间维度上同样存在。相邻帧之间物体的位移往往很小,关键点特征在跨帧比较时高度相似,网络难以从中提取有效的运动信号。论文将这一现象称为'跨帧语义坍缩',它直接导致预测轨迹漂移和外观伪影。
一个直观的失败案例是下落的香蕉:基于关键点空间属性和节点级传播的方法在碰撞帧附近出现明显的轨迹偏移和外观撕裂,而DyG2T通过补全粒子特征和全局交互建模,能够保持轨迹的连续性和外观的完整性。
核心创新
- 提出DyG2T框架,通过空间补全和时间解耦增强关键点表示,缓解轨迹预测偏差
- 粒子级空间语义补全:聚合邻域原始粒子位置恢复细粒度局部细节,显式编码关键点相对偏移增强几何结构感知
- 时间解耦网络(TDN):估计主导解耦方向上的偏移,放大帧间差异,缓解跨帧语义坍缩
- 粒子图Transformer:利用全局注意力直接建模多尺度长程依赖,配合门控残差连接防止表示同质化
方法概览
DyG2T首先用Dyn3DGS从多视角视频重建可追踪的原始粒子序列,经FPS采样关键点后,通过粒子级空间语义补全(PointNet聚合邻域原始粒子位置、PosDiff编码关键点相对偏移、位置感知注意力)和物体级动态时间聚合(TDN估计跨帧解耦偏移以放大帧间差异,再用时间注意力聚合)增强关键点表示;随后粒子图Transformer利用全局注意力建模关键点间多尺度长程依赖,经门控残差连接防止过平滑,最终MLP解码位移场,通过LBS插值得到下一帧原始粒子位置。
- 动态重建模块基于Dyn3DGS,从多视角视频中提取可追踪的原始粒子序列,为后续所有操作提供稠密的粒子级真值。
- 粒子级空间语义补全:对每个FPS关键点,用PointNet聚合其邻域内原始粒子的位置信息,恢复被下采样丢弃的局部几何细节;同时用PosDiff Encoder显式编码关键点之间的成对相对偏移,增强几何结构感知;最后通过位置感知注意力融合这些信息。
- 物体级动态时间聚合:TDN(Temporal Disentangling Network)估计主导解耦方向上的偏移,将相邻帧的关键点特征沿该方向拉开,放大帧间差异;随后用时间注意力聚合观测窗口内的多帧信息。
- 粒子图Transformer:将增强后的关键点作为节点,利用全局注意力直接建模任意关键点对之间的长程依赖,不再受限于局部邻域;层间使用门控残差连接,选择性保留信息信号,防止过平滑。
- 解码阶段:Transformer输出的关键点位移场通过MLP解码,再经LBS(Linear Blend Skinning)插值传播到所有原始粒子,得到下一帧的完整粒子位置。
- 训练策略:采用预测窗口机制,在观测窗口内进行多步自回归预测,用Chamfer Distance和EMD等几何度量作为损失函数。
逐图理解论文
失败案例与直觉
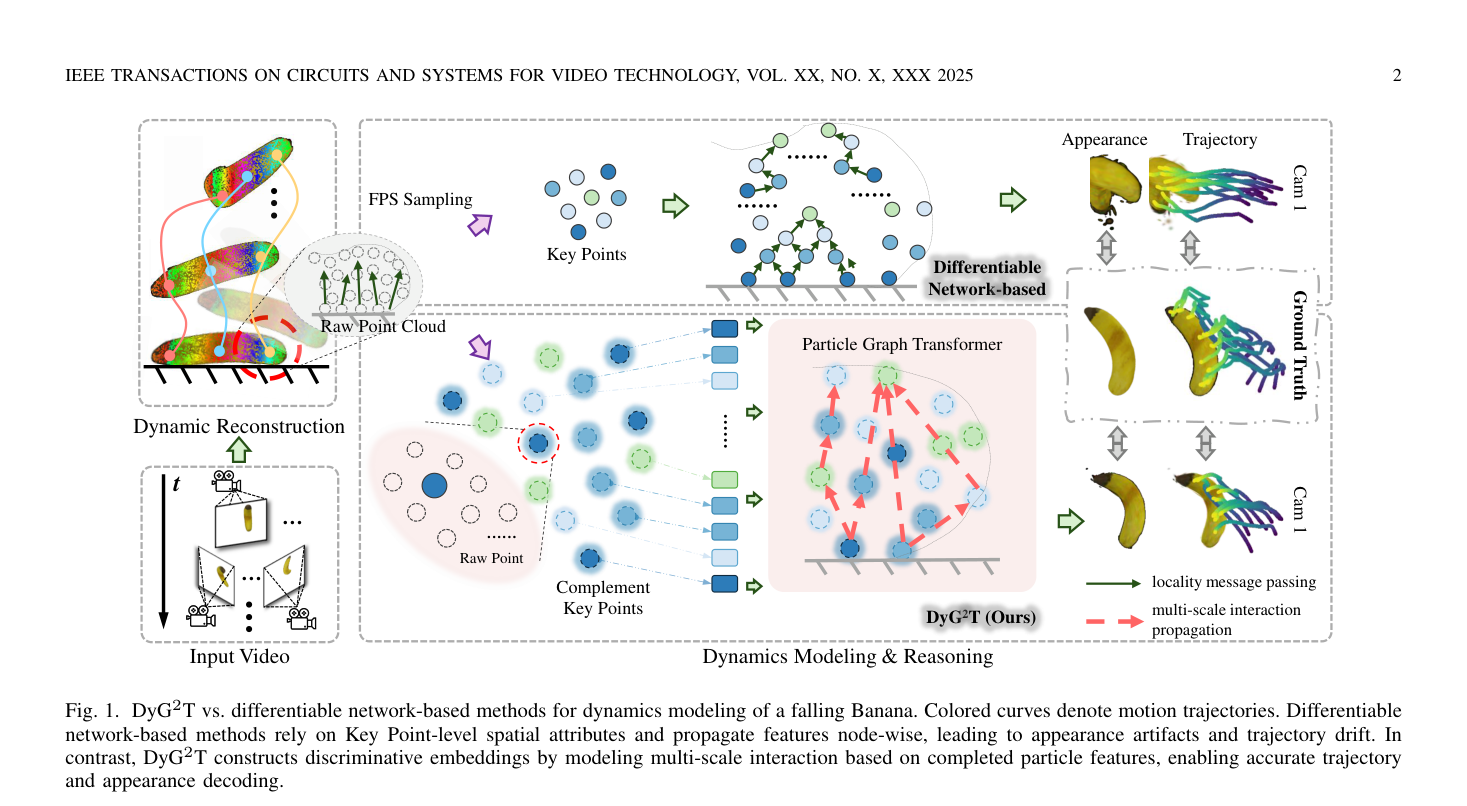
图1对比了DyG2T与可微网络方法在下落香蕉上的表现。注意观察彩色运动轨迹:基线方法的轨迹在碰撞附近出现明显漂移,而DyG2T的轨迹保持连续。这直接展示了论文要解决的核心问题——关键点级空间属性和节点级传播导致的轨迹漂移与外观伪影。
研究缺口:空间信息丢失与时间语义坍缩
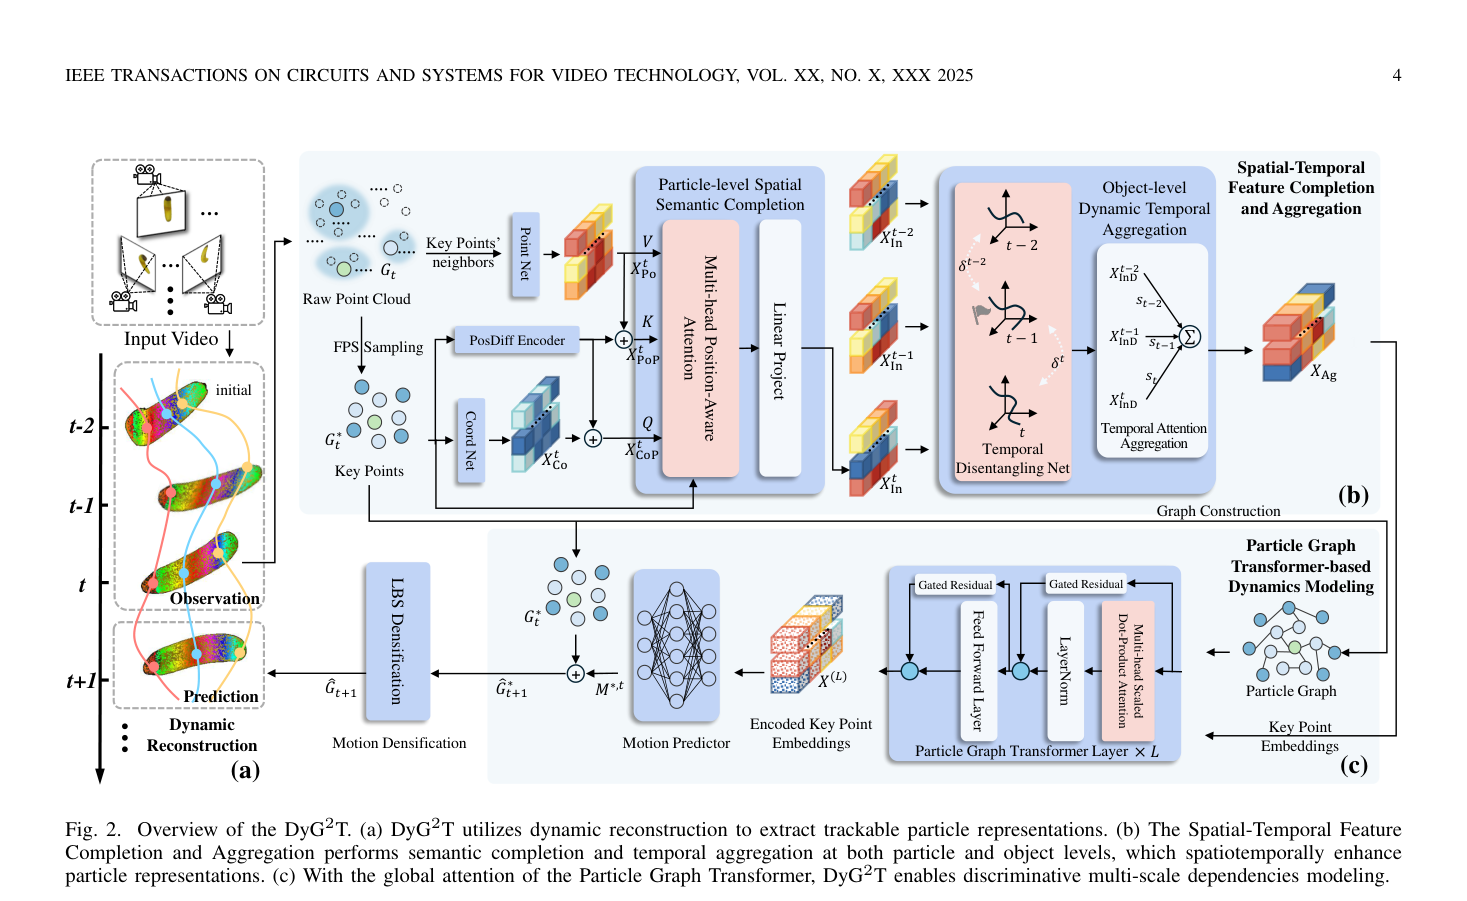
图2是DyG2T的整体框架图,分为三个部分:(a)动态重建提取可追踪粒子,(b)时空特征补全与聚合在粒子级和物体级同时增强表示,(c)粒子图Transformer通过全局注意力建模多尺度依赖。建议关注(b)部分的空间补全和时间解耦两个分支,这是论文的核心创新所在。
最强结论
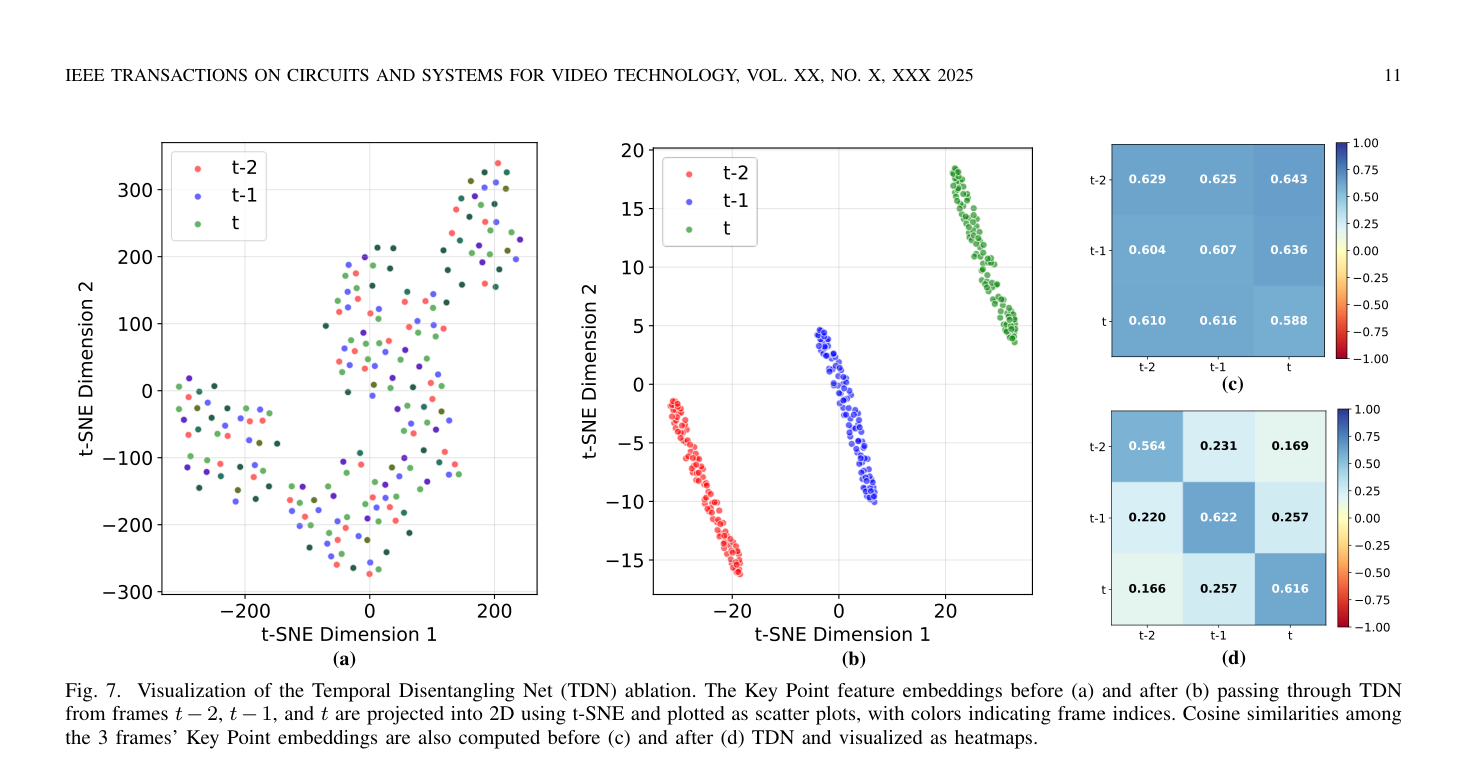
图7是TDN消融的可视化,用t-SNE将相邻三帧的关键点特征投影到2D。对比(a)和(b)可以看到,经过TDN后,不同帧的特征在空间中明显分离;对比(c)和(d)的余弦相似度热图,TDN显著降低了跨帧特征相似度,直接验证了时间解耦的有效性。
实验如何设计?
- 数据集:Spring-Gaus合成数据集(由Material Point Method生成3D真值轨迹)、Spring-Gaus真实世界子集、Unity3D-H数据集、Heterogeneous Torus异质材料数据集。
- 基线:Spring-Gaus(弹簧-质量模型)、GS-Dynamics(Dyn3DGS+GNN)、PAC-NeRF和GIC(强物理先验方法)。
- 评估指标:几何指标CD(Chamfer Distance)和EMD(Earth Mover's Distance),外观指标PSNR、SSIM、LPIPS,以及物理一致性指标LSE、SPC、ACE。
- 消融设置:模块级消融(空间补全、时间解耦、Transformer)、粒子级空间补全消融(邻域大小k、池化策略、PosDiff、PosAware)、物体级时间聚合消融(TDN、LSTM、池化、观测窗口大小)、粒子图Transformer消融(关键点数量N*、邻居数kG)、训练策略消融(预测窗口ϵ)。
关键结果与论文证据
- 在Spring-Gaus合成数据集上,DyG2T的CD均值0.039、EMD均值0.019、PSNR均值15.587、SSIM均值0.889、LPIPS均值0.171,全面优于Spring-Gaus和GS-Dynamics(第8页)。
- 在Spring-Gaus真实世界子集上,DyG2T在Burger场景取得PSNR最高30.645、LPIPS最低0.012(第8页)。
- 在Unity3D-H上,DyG2T取得PSNR 31.768、SSIM 0.990、LPIPS 0.015,优于所有基线(第8页)。
- 在Heterogeneous Torus上,DyG2T取得CD 0.015、EMD 0.000、PSNR 14.080、SSIM 0.893、LPIPS 0.129,优于Spring-Gaus、GS-Dynamics、PAC-NeRF和GIC(第8页)。
- 物理一致性评估:DyG2T的LSE 0.225、SPC 0.089、ACE 0.016,优于GS-Dynamics的LSE 0.499、SPC -0.248、ACE 0.017(第8页)。
- 模块消融:完整DyG2T的CD 0.055,w/o spatial为0.354,w/o temporal为0.227,w/o transformer为0.197,三个模块均有显著贡献(第9页)。
- TDN消融可视化(图7):经过TDN后,相邻帧关键点特征的t-SNE分布明显分离,余弦相似度热图从高度相似变为明显差异,直接验证了时间解耦的有效性(第11页)。
- 碰撞帧分析:碰撞帧PSNR 18.410、SSIM 0.927、LPIPS 0.109,非碰撞帧PSNR 17.687、SSIM 0.916、LPIPS 0.128,DyG2T在碰撞帧上表现更优(第11页)。
阅读时需要注意
- 观测窗口固定为3帧,更长窗口(5帧)会导致跨帧分布差异增大、解耦不稳定。
- 预测窗口ϵ=8时性能急剧下降(CD 4.844),长时域预测能力有限。
- 关键点数量N*和邻居数kG需针对不同数据集手动调整(合成子集N*=100/kG=5,真实世界和Unity3D-H为N*=120/kG=7)。
- Unity3D-H上性能增益相对较小,因该数据集运动更干净、时间坍缩较弱。
- 表VIII中5帧观测窗口的CD值(0.018)低于3帧窗口(0.055),但PSNR/SSIM/LPIPS均更差,存在指标不一致,需谨慎解读。
关联工作
- Spring-Gaus:基于弹簧-质量模型的动力学建模基线,同时提供合成与真实世界数据集,是DyG2T的主要对比对象之一。
- GS-Dynamics:结合Dyn3DGS与GNN的可微网络动力学建模基线,代表了'关键点+局部消息传递'的典型范式,DyG2T正是针对这一范式的缺陷进行改进。
- PAC-NeRF和GIC:基于NeRF和连续介质力学的强物理先验方法,在异质材料场景下与DyG2T对比,说明纯数据驱动方法在特定条件下可以超越物理先验方法。
- Dyn3DGS:3DGS的动态扩展,DyG2T的动态重建模块基于此方法,为后续所有操作提供可追踪的粒子表示。